

É possível usar enriquecimentos de objetos para gerar automaticamente metadados estruturados sem criar pipelines de machine learning personalizados. Os enriquecimentos de objetos aplicam os modelos de machine learning pré-treinados do Google diretamente aos objetos armazenados para ajudar você a pesquisar, selecionar e controlar seus dados não estruturados em grande escala.
Para começar a gerar metadados para seus objetos, consulte Configurar enriquecimentos de objetos.
Como funciona
Para usar os enriquecimentos de objetos, você trabalha com as seguintes partes do sistema:
- Configuração de recursos (
FeatureConfig): crie uma configuração de recursos para especificar quais buckets ou projetos o Cloud Storage monitora. - Modelos de machine learning: na configuração, você escolhe os modelos que quer aplicar, como modelos que detectam objetos, rotulam imagens, analisam rostos ou categorizam documentos PDF.
- Enriquecimento de objetos (metadados): o Cloud Storage verifica seus objetos de forma assíncrona e avalia os objetos qualificados com os modelos selecionados. Em seguida, o Cloud Storage anexa os metadados resultantes diretamente aos objetos como contextos de objeto.
Depois que o Cloud Storage anexar os metadados de enriquecimento aos objetos, eles estarão prontos para uso. É possível inspecionar enriquecimentos de objetos individuais ou usar conjuntos de dados do Storage Insights para analisar metadados em milhões de objetos usando SQL no BigQuery.
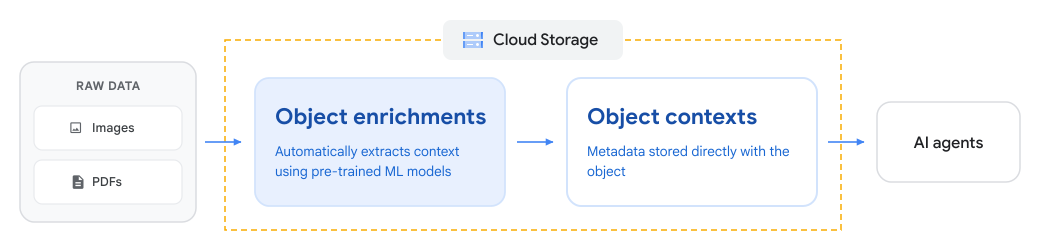
O diagrama a seguir mostra como o Cloud Storage usa enriquecimentos de objetos para extrair contexto de dados não estruturados e armazená-los como contextos de objetos para fluxos de trabalho de IA e análise downstream:
Modelos compatíveis
Ao criar uma configuração de recurso, você seleciona os modelos de machine learning
que melhor se adaptam aos seus dados e objetivos de análise. O Cloud Storage avalia
os objetos qualificados usando os modelos escolhidos e gera metadados estruturados
em contexts.custom.
A tabela de modelos compatíveis lista cada modelo, o que ele detecta e dados de saída de amostra. Para definições detalhadas de esquemas e chaves de contexto, consulte Modelos e esquemas compatíveis.
| Modelo | Descrição | Exemplo de dados de saída |
|---|---|---|
| Detecção de objetos | Detecta vários objetos em uma imagem e fornece as posições e os limites retangulares deles. | Produto, animal, pessoa |
| Rotulagem de imagens | Detecta e extrai informações sobre entidades em uma imagem em um amplo grupo de categorias, como objetos, locais e atividades. | Paisagem, urbano, noite |
| Detecção facial | Detecta rostos em imagens, incluindo polígonos delimitadores, pontos de referência faciais (olhos, nariz, boca), ângulos de orientação e probabilidades de expressão. | Contagem de rostos, ângulo de rotação e inclinação |
| Detecção de conteúdo explícito | Avalia imagens em busca de conteúdo sensível ou inadequado, incluindo material adulto ou violento. | Classificações de probabilidade de conteúdo adulto e violento |
| Classificação de PDF | Classifica documentos PDF em categorias padrão de negócios e setores com base no conteúdo. | Finanças, tributos, faturas (categorias e pontuações) |
Casos de uso
É possível usar os enriquecimentos de objetos para simplificar o gerenciamento de dados não estruturados e preparar objetos para os seguintes fluxos de trabalho de análise e IA:
- Organizar e catalogar objetos não organizados: classifique automaticamente coleções de documentos PDF (como faturas, extratos bancários e declarações fiscais) e imagens. Use essas classificações para criar catálogos de dados pesquisáveis em todos os buckets sem escrever código personalizado.
- Embasar agentes de IA e melhorar a pesquisa: transforme repositórios de documentos desorganizados em bases de conhecimento estruturadas. É possível usar categorias de documentos e rótulos de imagens para melhorar a recuperação durante a geração aumentada por recuperação (RAG) e fundamentar seus aplicativos de IA generativa.
- Amostragem e preparação de dados para IA generativa: diferencie os tipos de documentos para realizar amostragem estratificada antes de encaminhar o conteúdo para modelos de linguagem grandes (LLMs) ou revisão humana.
- Organizar conjuntos de dados de treinamento de machine learning: filtre e segmente imagens e documentos por taxonomia ou rótulos visuais para montar conjuntos de dados de treinamento específicos do domínio para o ajuste de modelos.
- Verificar conteúdo sensível ou explícito: inspecione automaticamente as imagens enviadas em busca de material inadequado para apoiar suas políticas de moderação de conteúdo e segurança.
- Melhorar comandos multimodais: transmita metadados estruturados, como caixas delimitadoras e categorias de documentos, como contexto ao enviar comandos para modelos multimodais, como o Gemini.
- Simplifique as arquiteturas de dados: elimine pipelines de ingestão personalizados e infraestrutura de computação gerando metadados diretamente no Cloud Storage.
Consultar e analisar seus metadados
O Cloud Storage anexa enriquecimentos de objetos diretamente aos seus objetos como contextos de objeto. Dependendo da escala e do fluxo de trabalho, é possível acessar e analisar esses metadados das seguintes maneiras:
- Inspecionar objetos individuais: use o console do Cloud de Confiance ou as APIs do Cloud Storage para inspecionar as melhorias de objetos específicos. Para instruções, consulte Gerenciar enriquecimentos de objetos.
- Análise em escala com SQL: use conjuntos de dados do Storage Insights para exportar
metadados de milhões ou bilhões de objetos diretamente para o
BigQuery. Depois que o Storage Insights exportar os metadados, será possível
consultar a visualização
object_contexts_catalog_viewusando o SQL padrão. Por exemplo, é possível pesquisar rótulos, filtrar por categoria ou encontrar objetos com pontuações de alta confiança.
Para começar a usar consultas SQL e receitas de amostra, consulte Analisar enriquecimentos de objetos no BigQuery.
Considerações e limitações
Antes de configurar os enriquecimentos de objetos, leia as seguintes considerações operacionais:
Local de processamento
Os enriquecimentos de objetos processam dados em três localizações geográficas:
us, eu e asia. Ao selecionar um local de processamento, considere o seguinte:
- Conformidade: verifique se o local de processamento escolhido atende aos requisitos regulatórios e de soberania de dados.
- Desempenho: escolha o local de processamento mais próximo da região de armazenamento do bucket.
- Custo: para evitar cobranças duplicadas, configure apenas um local de processamento para cada bucket e modelo. Se você configurar vários locais para o mesmo bucket e modelo, o Cloud Storage vai processar seus objetos em cada local e cobrar por cada execução.
Processamento e desempenho
Confira as seguintes restrições sobre tipos de conteúdo, tamanhos de objetos e cronogramas de processamento:
Processamento assíncrono: o Cloud Storage processa objetos de maneira assíncrona.
Limite de tamanho do objeto: os objetos (imagens e PDFs) precisam ter 20 MiB ou menos.
Tipos de conteúdo compatíveis: o Cloud Storage usa o campo de metadados
Content-Typedefinido em um objeto para determinar se ele deve ser avaliado. Se um objeto tiver umContent-Typeinválido ou ausente, o Cloud Storage não o processará, mesmo que os dados subjacentes sejam uma imagem ou um PDF válido. Para garantir que o Cloud Storage processe o objeto, atualize os metadadosContent-Typepara um dos seguintes tipos compatíveis:- Imagens: BMP, GIF, ICO, JPEG, PNG, TIFF e WEBP.
- Documentos: PDF (
application/pdf).
Recursos não suportados
Os enriquecimentos de objetos são incompatíveis com os seguintes tipos de bucket e operações:
- Realocação de bucket: o enriquecimento de objetos é incompatível com a realocação de bucket. Remova o bucket das configurações de recursos antes de realocá-lo.
- Tipos de bucket não compatíveis: não é possível ativar o enriquecimento de objetos em buckets rápidos ou buckets com o namespace hierárquico ativado.
Gerenciamento de configuração e escopo
Ao definir e manter buckets de destino nas configurações de recursos, os seguintes requisitos se aplicam:
- Escopo do bucket: especifique os nomes exatos dos buckets na configuração do recurso. O Cloud Storage não é compatível com expressões regulares ou padrões de caracteres curinga.
- Ciclo de vida do bucket: o Cloud Storage não adiciona automaticamente buckets recém-criados, recriados ou realocados às configurações atuais. Atualize a configuração do recurso para incluir esses buckets.
Custos e segurança
Confira os seguintes detalhes operacionais sobre chaves de criptografia e cobranças de acesso a dados:
- Chaves fornecidas pelo cliente (CSEK): os enriquecimentos de objetos não oferecem suporte a objetos criptografados com chaves de criptografia fornecidas pelo cliente.
- Acesso ao armazenamento e classe automática: para gerar metadados, os enriquecimentos de objetos leem os dados do objeto. Essas operações de leitura geram cobranças padrão de acesso a dados. Além disso, se o bucket tiver a classe automática ativada, essas leituras vão acionar transições de classe de armazenamento.
Preços
O uso de enriquecimentos de objetos gera cobranças por inferência de modelo, armazenamento de metadados, operações de acesso a dados e rede. Para saber mais informações, consulte Preços.
Monitorar e solucionar problemas
Para acompanhar o progresso da geração de metadados e resolver problemas ao configurar enriquecimentos de objetos, use os seguintes recursos:
- Monitorar operações: para acompanhar objetos pendentes, contagens de execução de modelos e status de processamento no Cloud Monitoring, consulte Monitorar métricas de enriquecimento de objetos.
- Resolver problemas: se as melhorias estiverem ausentes ou se você encontrar erros de permissão, consulte Solução de problemas de enriquecimento de objetos.