

É possível usar o enriquecimento de objetos para gerar metadados estruturados automaticamente sem criar pipelines personalizados de machine learning. O enriquecimento de objetos aplica os modelos de machine learning pré-treinados do Google diretamente aos objetos armazenados para ajudar você a pesquisar, organizar e governar seus dados não estruturados em escala.
Para começar a gerar metadados para seus objetos, consulte Configurar o enriquecimento de objetos.
Como funciona
Para usar o enriquecimento de objetos, trabalhe com estas partes do sistema:
- Configuração de recursos (
FeatureConfig): crie uma configuração de recursos para especificar quais buckets ou projetos o Cloud Storage monitora. - Modelos de machine learning: na configuração, escolha os modelos que você quer aplicar, como modelos que detectam objetos, rotulam imagens, analisam rostos ou categorizam documentos PDF.
- Enriquecimento de objetos (metadados): o Cloud Storage verifica seus objetos de forma assíncrona e avalia os objetos qualificados com os modelos selecionados. Em seguida, o Cloud Storage anexa os metadados resultantes diretamente aos objetos como contextos de objetos.
Depois que o Cloud Storage anexa os metadados de enriquecimento aos objetos, eles ficam prontos para uso. É possível inspecionar enriquecimentos de objetos individuais ou usar conjuntos de dados do Storage Insights para analisar metadados em milhões de objetos usando SQL no BigQuery.
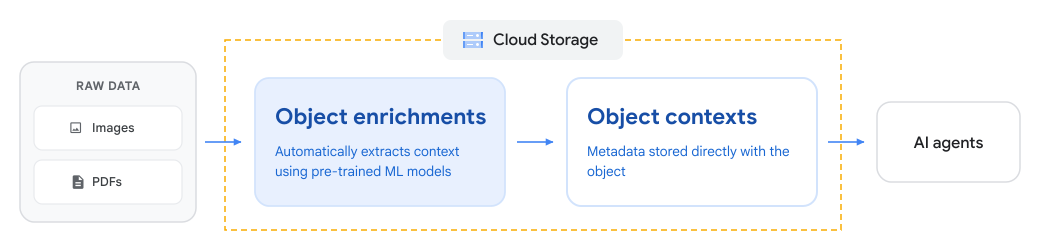
O diagrama a seguir mostra como o Cloud Storage usa o enriquecimento de objetos para extrair contexto de dados não estruturados e armazená-los como contextos de objetos para fluxos de trabalho de análise e IA downstream:
Modelos compatíveis
Ao criar uma configuração de recursos, selecione os modelos de machine learning que melhor se adequam aos seus dados e metas de análise. O Cloud Storage avalia os objetos qualificados usando os modelos escolhidos e gera metadados estruturados em contexts.custom.
A tabela de modelos compatíveis lista cada modelo, o que ele detecta e dados de saída de amostra. Para definições de esquema detalhadas e chaves de contexto, consulte Modelos e esquemas compatíveis.
| Modelo | Descrição | Dados de saída de amostra |
|---|---|---|
| Detecção de objetos | Detecta vários objetos em uma imagem e fornece as posições e os limites retangulares deles. | Produto, Animal, Pessoa |
| Rotulagem de imagens | Detecta e extrai informações sobre entidades em uma imagem em um amplo grupo de categorias, como objetos, locais e atividades. | Paisagem, Urbano, Noite |
| Detecção facial | Detecta rostos em imagens, incluindo polígonos delimitadores, pontos de referência faciais (olhos, nariz, boca), ângulos de orientação e probabilidades de expressão. | Contagem de rostos, ângulo de rotação e inclinação |
| Detecção de conteúdo explícito | Avalia imagens em busca de conteúdo sensível ou inadequado, incluindo material adulto ou violento. | Classificações de probabilidade de conteúdo adulto e violento |
| Classificação de PDF | Classifica documentos PDF em categorias padrão de negócios e setores com base no conteúdo deles. | Finanças, Impostos, Fatura (categorias e pontuações) |
Casos de uso
É possível usar o enriquecimento de objetos para simplificar o gerenciamento de dados não estruturados e preparar objetos para os seguintes fluxos de trabalho de análise e IA downstream:
- Organizar e catalogar objetos não organizados: classifique automaticamente coleções de documentos PDF (como faturas, extratos bancários e formulários fiscais) e imagens. É possível usar essas classificações para criar catálogos de dados pesquisáveis em buckets sem escrever código personalizado.
- Agentes de IA de base e pesquisa aprimorada: transforme repositórios de documentos desorganizados em bases de conhecimento estruturadas. É possível usar categorias de documentos e rótulos de imagens para melhorar a recuperação durante a geração aumentada por recuperação (RAG) e fundamentar seus aplicativos de IA generativa.
- Amostrar e preparar dados para IA generativa: diferencie entre tipos de documentos para realizar amostragem estratificada antes de encaminhar conteúdo para modelos de linguagem grandes (LLMs) ou revisão humana.
- Organizar conjuntos de dados de treinamento de machine learning: filtre e segmente imagens e documentos por taxonomia ou rótulos visuais para montar conjuntos de dados de treinamento específicos do domínio para ajuste fino do modelo.
- Verificar conteúdo sensível ou explícito: inspecione automaticamente as imagens enviadas em busca de material inadequado para oferecer suporte às políticas de moderação de conteúdo e segurança.
- Melhorar comandos multimodais: transmita metadados estruturados, como caixas delimitadoras e categorias de documentos, como contexto ao solicitar modelos multimodais como o Gemini.
- Simplificar arquiteturas de dados: elimine pipelines de ingestão personalizados e infraestrutura de computação gerando metadados diretamente em Cloud Storage.
Consultar e analisar seus metadados
O Cloud Storage anexa o enriquecimento de objetos diretamente aos objetos como contextos de objetos. Dependendo da sua escala e fluxo de trabalho, é possível acessar e analisar esses metadados destas maneiras:
- Inspecionar objetos individuais: use o Cloud de Confiance console ou as APIs do Cloud Storage para inspecionar enriquecimentos de objetos específicos. Para instruções, consulte Gerenciar o enriquecimento de objetos.
- Analisar em escala com SQL: use conjuntos de dados do Storage Insights para exportar
metadados em milhões ou bilhões de objetos diretamente para o
BigQuery. Depois que o Storage Insights exporta os metadados, é possível
consultar a
object_contexts_catalog_viewvisualização usando SQL padrão. Por exemplo, é possível pesquisar rótulos, filtrar por categoria ou encontrar objetos que tenham pontuações de confiança altas.
Para começar a usar consultas SQL e exemplos de receitas, consulte Analisar o enriquecimento de objetos no BigQuery.
Considerações e limitações
Antes de configurar o enriquecimento de objetos, revise as seguintes considerações operacionais:
Local de processamento
O enriquecimento de objetos processa dados em três localizações geográficas: us, eu e asia. Ao selecionar um local de processamento, tenha em mente as seguintes considerações:
- Conformidade: verifique se o local de processamento escolhido atende aos seus requisitos regulatórios e de soberania de dados.
- Desempenho: escolha o local de processamento mais próximo da região de armazenamento do bucket.
- Custo: para evitar cobranças duplicadas, configure apenas um local de processamento para cada bucket e modelo. Se você configurar vários locais para o mesmo bucket e modelo, o Cloud Storage processará seus objetos em cada local e cobrará por cada execução.
Processamento e performance
Revise as seguintes restrições sobre tipos de conteúdo, tamanhos de objetos e cronogramas de processamento:
Processamento assíncrono: o Cloud Storage processa objetos de forma assíncrona.
Limite de tamanho do objeto: os objetos (imagens e PDFs) precisam ter 20 MiB ou menos.
Tipos de conteúdo compatíveis: o Cloud Storage usa o
Content-Typecampo de metadados definido em um objeto para determinar se ele será avaliado. Se um objeto tiver umContent-Typeinválido ou ausente, o Cloud Storage não processará o objeto, mesmo que os dados subjacentes sejam uma imagem ou PDF válido. Para garantir que o Cloud Storage processe o objeto, atualize os metadadosContent-Typepara um destes tipos compatíveis:- Imagens: BMP, GIF, ICO, JPEG, PNG, TIFF e WEBP.
- Documentos: PDF (
application/pdf).
Recursos não suportados
O enriquecimento de objetos é incompatível com os seguintes tipos e operações de bucket:
- Realocação de buckets: o enriquecimento de objetos é incompatível com a realocação de buckets. Remova o bucket das configurações de recursos antes de realocá-lo.
- Tipos de bucket não suportados: não é possível ativar o enriquecimento de objetos em buckets rápidos ou buckets que tenham o namespace hierárquico ativado.
Gerenciamento de configuração e escopo
Ao definir e manter buckets de destino nas configurações de recursos, os seguintes requisitos se aplicam:
- Escopo do bucket: especifique os nomes exatos dos buckets na configuração de recursos. O Cloud Storage não oferece suporte a expressões regulares ou padrões de caracteres curinga.
- Ciclo de vida do bucket: o Cloud Storage não adiciona automaticamente buckets recém- criados, recriados ou realocados às configurações atuais. É necessário atualizar a configuração de recursos para incluir esses buckets.
Custos e segurança
Revise os seguintes detalhes operacionais sobre chaves de criptografia e cobranças de acesso a dados:
- Chaves fornecidas pelo cliente (CSEK): o enriquecimento de objetos não oferece suporte a objetos criptografados com chaves de criptografia fornecidas pelo cliente.
- Acesso ao armazenamento e classe automática: para gerar metadados, o enriquecimento de objetos lê os dados do objeto. Essas operações de leitura geram cobranças padrão de acesso a dados. Além disso, se o bucket tiver a classe automática ativada, essas leituras vão acionar transições de classe de armazenamento.
Preços
O uso do enriquecimento de objetos gera cobranças para inferência de modelo, armazenamento de metadados, operações de acesso a dados e rede. Para saber mais informações, consulte Preços.
Monitorar e solucionar problemas
Para acompanhar o progresso da geração de metadados e resolver problemas ao configurar o enriquecimento de objetos, use estes recursos:
- Monitorar operações: para acompanhar objetos pendentes, contagens de execução de modelos, e status de processamento no Cloud Monitoring, consulte Monitorar métricas de enriquecimento de objetos.
- Resolver problemas: se os enriquecimentos estiverem ausentes ou você encontrar erros de permissão, consulte Solução de problemas de enriquecimento de objetos.