

Penting: Tetapkan description korpus saat membuat korpus RAG. description tidak dapat diedit setelah dibuat. Deskripsi berkualitas tinggi sangat penting untuk pengambilan lintas-korpus yang efektif, karena sistem mengandalkannya untuk memilih korpus yang sesuai untuk kueri Anda.
Halaman ini menjelaskan dua API, AsyncRetrieveContexts dan AskContexts, yang mendukung Pengambilan Cross Corpus RAG, yang didukung oleh Pengambilan Agentik di backend.
AsyncRetrieveContexts API: Ini adalah API asinkron yang memungkinkan pengguna mengambil konteks yang relevan dari beberapa korpus yang dikelola RAG. Ini adalah API yang berjalan lama. Pengguna dapat menggunakan ID operasi untuk mendapatkan status kueri dan hasilnya.
AskContexts API: Ini adalah API sinkron yang secara langsung menghasilkan jawaban atas kueri dengan menelusuri beberapa korpus yang dikelola RAG.
Penting: Untuk menggunakan fitur ini, Anda harus memberikan peran Vertex AI User di project Anda ke akun layanan RAG Engine: service-[Your project's automatically generated project number]@gcp-sa-vertex-rag.iam.gserviceaccount.com.
Penting: Fitur ini hanya tersedia di us-central1.
Arsitektur Sistem dan Pemilihan Korpus
Bagian ini menjelaskan arsitektur sistem Pengambilan Cross Corpus RAG dan cara sistem ini memilih korpus yang sesuai untuk pengambilan.
Arsitektur Sistem
Sistem Cross Corpus Retrieval menggunakan pendekatan berbasis agen untuk mengatur pengambilan di beberapa korpus. Ringkasan tingkat tinggi arsitektur mencakup komponen berikut:
- Pengelola/Router: Menerima kueri pengguna dan mengoordinasikan proses pengambilan.
- Agen Perencanaan: Menganalisis kueri dan menentukan korpora mana yang paling relevan berdasarkan
descriptions-nya. - Mesin Pengambilan: Melakukan penelusuran semantik pada korpora RAG yang dipilih.
- Agen Penalaran: Mengevaluasi apakah konteks yang diambil sudah cukup untuk menjawab kueri. Jika tidak cukup, agen ini akan menghasilkan masukan untuk memicu loop pengambilan lain berdasarkan Kesadaran Konteks yang Memadai (SCA). Untuk mengetahui detail selengkapnya, lihat postingan blog SCA dan makalah penelitian.
- Generator LLM (untuk
AskContexts): Mensintesis konteks yang diambil untuk menghasilkan jawaban akhir.
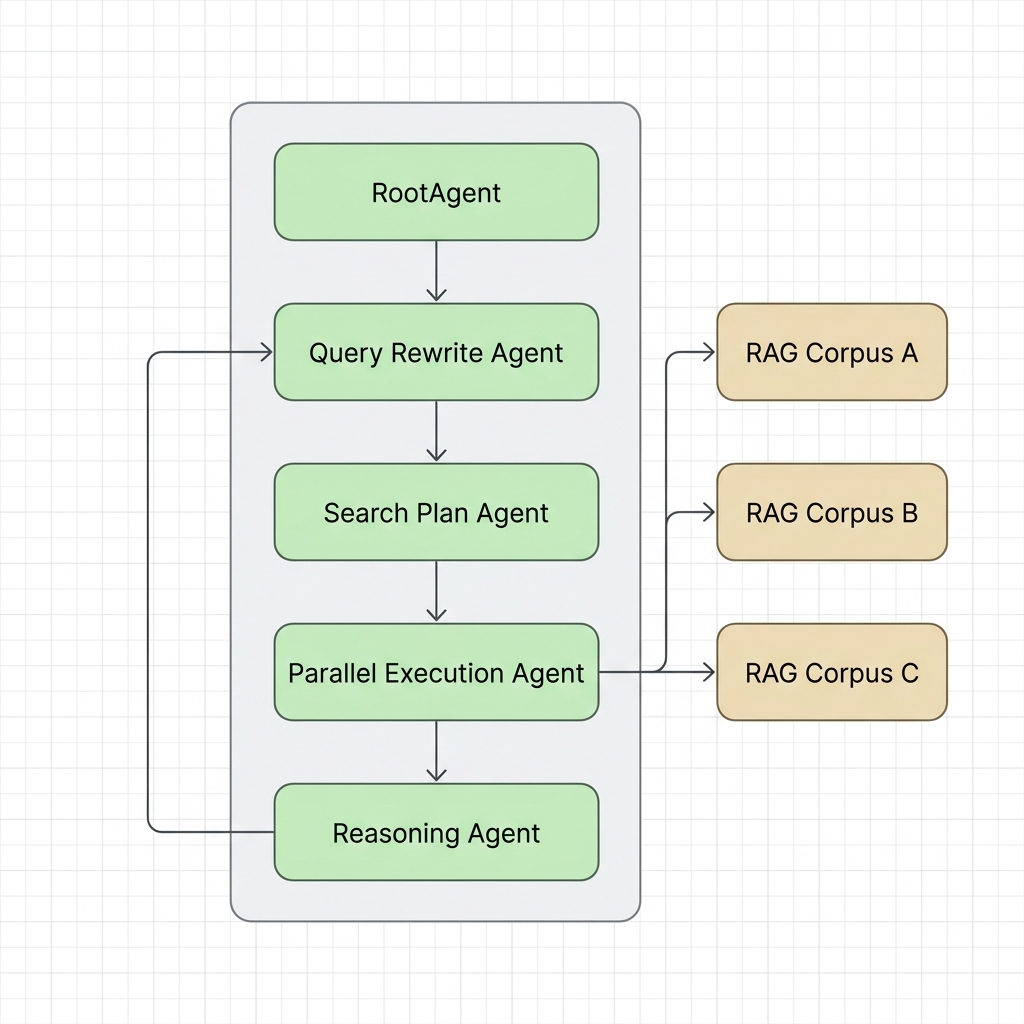
Cara Pemilihan Kumpulan Data
Saat kueri dijalankan di beberapa korpora yang dikelola RAG, sistem harus menentukan korpus mana yang berisi informasi yang diperlukan untuk menjawab kueri. Hal ini dicapai melalui Pengambilan Agentik (Agentic Retrieval):
- Pemetaan Kumpulan Data: Sistem ini mempertahankan peta kumpulan data RAG yang tersedia beserta deskripsi teknisnya (ditentukan di kolom
descriptionpada kumpulan data RAG). - Pencocokan Semantik: Agen perencanaan strategis (yang didukung oleh model Gemini) mengevaluasi kueri pengguna terhadap
descriptionsdari korpora yang tersedia. - Perutean Bertarget: Perencana membuat rencana pengambilan yang memetakan bagian tertentu dari kueri ke korpora yang paling relevan, sehingga memastikan pengambilan difokuskan dan efisien, bukan menelusuri semua korpora secara naif.
Contoh Kode
Contoh kode berikut menunjukkan cara menggunakan RAG Cross Corpus Retrieval API.
AsyncRetrieveContexts API
Contoh kode ini menunjukkan cara mengambil konteks dari beberapa korpus RAG secara asinkron.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Async retrieve contexts from multiple corpora
# This can be run in an environment like a Colab notebook.
response = await rag.async_retrieve_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:asyncRetrieveContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Mendapatkan Hasil Operasi
Karena AsyncRetrieveContexts adalah operasi yang berjalan lama, Anda dapat menggunakan API GetOperations untuk melakukan polling hasil menggunakan ID operasi.
Python
from google.cloud import aiplatform_v1beta1

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
OPERATION_ID = "OPERATION_ID"

client = aiplatform_v1beta1.VertexRagServiceClient(
    client_options={"api_endpoint": f"{LOCATION}-aiplatform.googleapis.com"}
)

operation = client.get_operation(
    request={"name": f"projects/{PROJECT_ID}/locations/{LOCATION}/operations/{OPERATION_ID}"}
)

if operation.done:
    print(operation.response)
else:
    print("Operation is still running")
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
OPERATION_ID="OPERATION_ID"

curl -X GET \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}/operations/${OPERATION_ID}"
AskContexts API
Contoh kode ini menunjukkan cara membuat jawaban secara langsung dengan menelusuri beberapa korpus RAG secara serentak.
Python
from vertexai.preview import rag
import vertexai

PROJECT_ID = "PROJECT_ID"
LOCATION = "LOCATION"
RAG_CORPUS_1_ID = "RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID = "RAG_CORPUS_2_ID"

# Initialize API once per session
vertexai.init(project=PROJECT_ID, location=LOCATION)

# Ask contexts from multiple corpora
response = rag.ask_contexts(
    text="Why is the sky blue?",
    rag_resources=[
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_1_ID}",
        ),
        rag.RagResource(
            rag_corpus=f"projects/{PROJECT_ID}/locations/{LOCATION}/ragCorpora/{RAG_CORPUS_2_ID}",
        ),
    ],
)
print(response)
REST
PROJECT_ID="PROJECT_ID"
LOCATION="LOCATION"
RAG_CORPUS_1_ID="RAG_CORPUS_1_ID"
RAG_CORPUS_2_ID="RAG_CORPUS_2_ID"
QUERY="Why is the sky blue?"

curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1beta1/projects/${PROJECT_ID}/locations/${LOCATION}:askContexts" \
  -d '{
    "query": {
      "text": "'"$QUERY"'"
    },
    "tools": {
      "retrieval": {
        "disable_attribution": false,
        "vertex_rag_store": {
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_1_ID}"'"
          },
          "rag_resources": {
            "rag_corpus": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/ragCorpora/'"${RAG_CORPUS_2_ID}"'"
          }
        }
      }
    }
  }'
Langkah berikutnya
- Untuk mempelajari RAG API lebih lanjut, lihat RAG Engine API.
- Untuk mempelajari lebih lanjut respons dari RAG, lihat Output Pengambilan dan Pembuatan Mesin RAG.
- Untuk mempelajari RAG Engine, lihat Ringkasan RAG Engine.