

このドキュメントでは、メモリー生成の仕組み、トピックを使用してメモリー抽出をカスタマイズする方法、メモリー生成リクエストをトリガーする方法について説明します。
環境の設定については、Memory Bank のセットアップをご覧ください。
メモリ生成について
Memory Bank は、ソースデータからメモリを抽出し、特定のメモリのコレクション(scope で定義)のメモリを、時間の経過とともにメモリを追加、更新、削除することで自己キュレーションします。
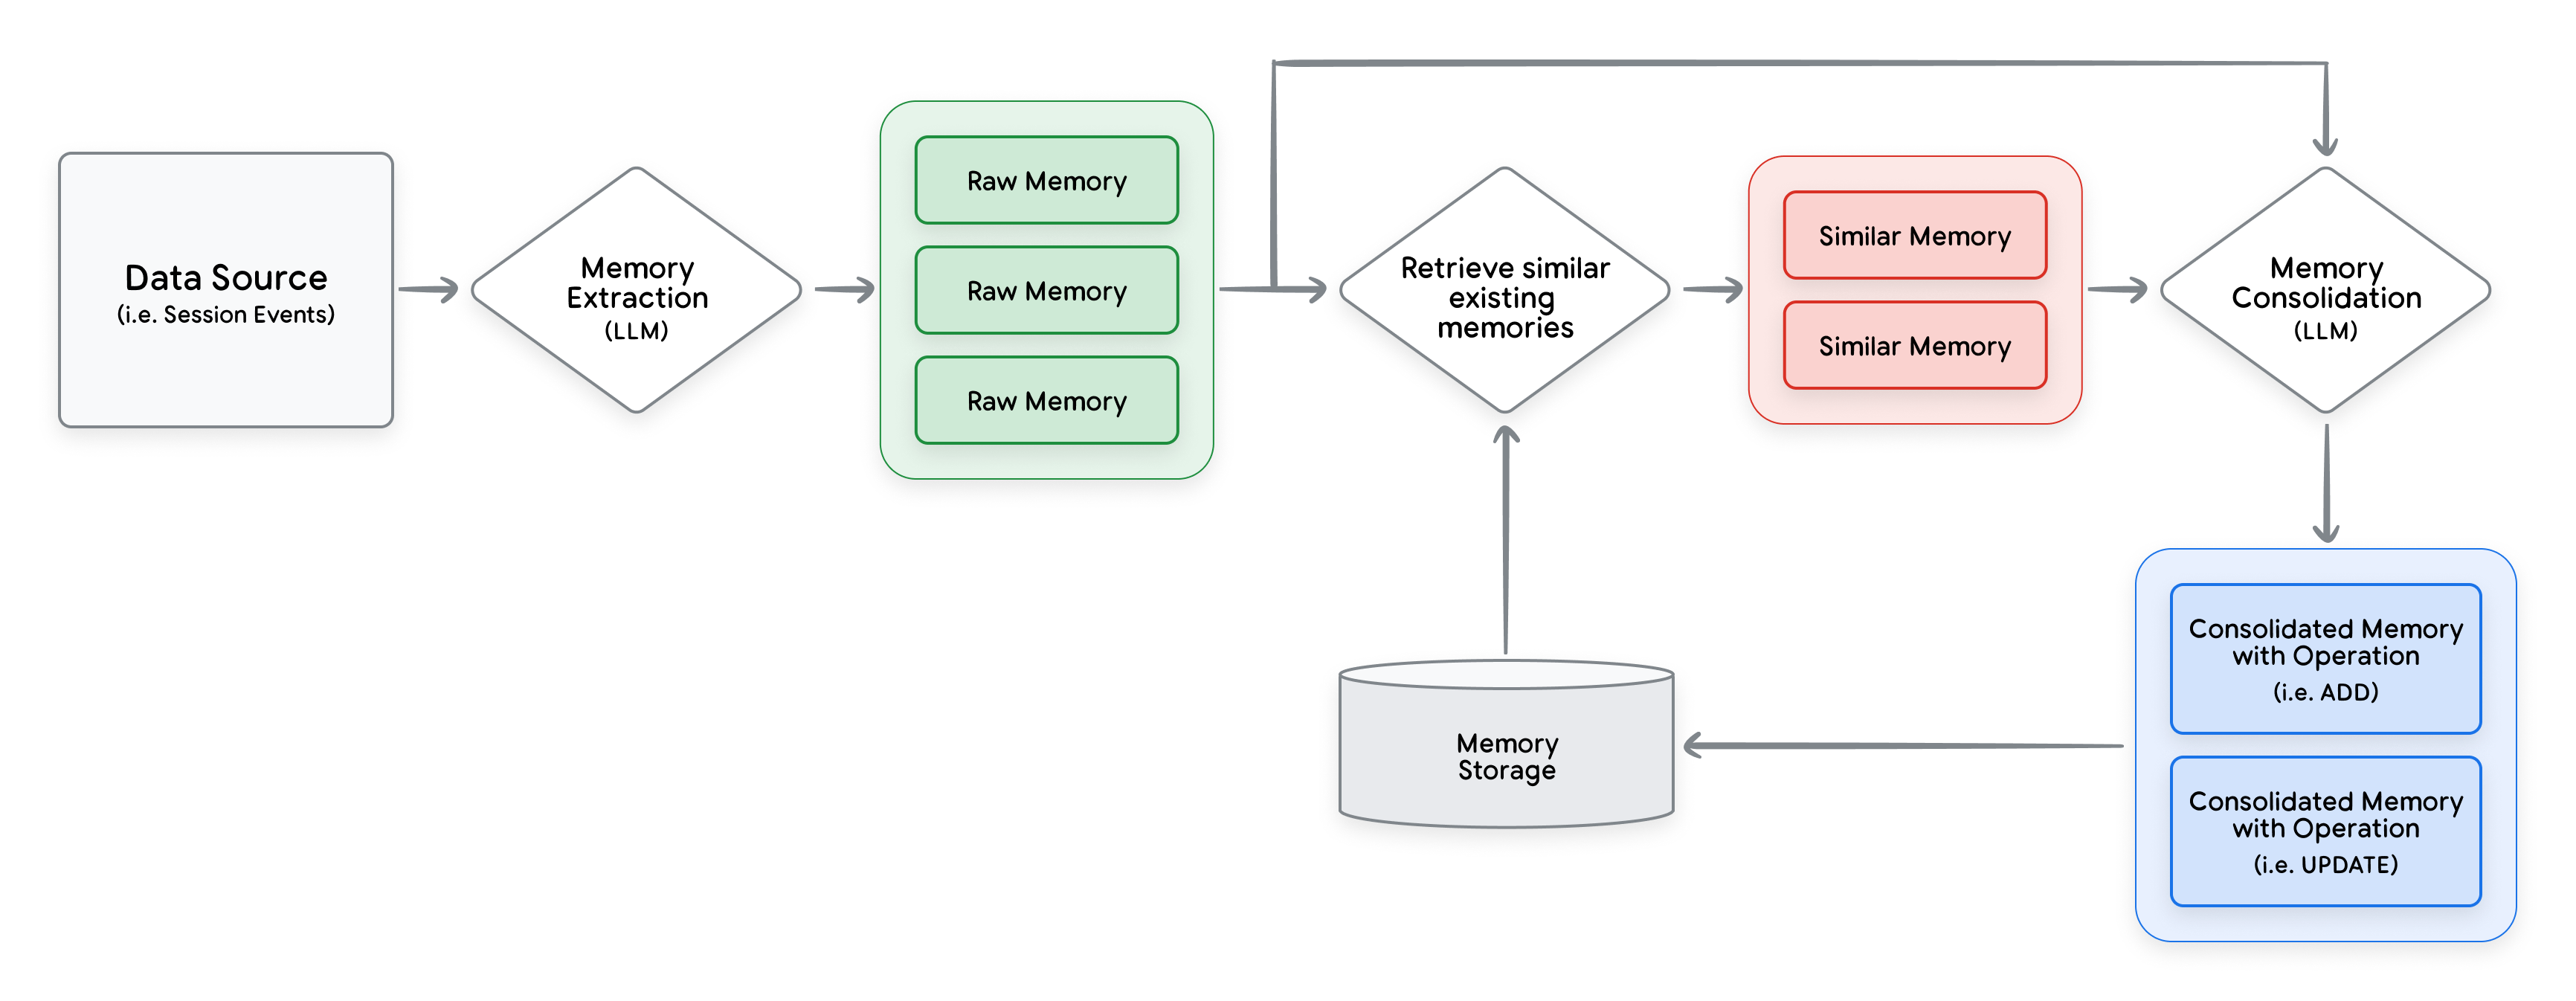
メモリ生成をトリガーすると、Memory Bank は次のオペレーションを実行します。
抽出: エージェントとの会話からユーザーに関する情報を抽出します。インスタンスのメモリトピックの少なくとも 1 つに一致する情報のみが保持されます。
統合: 抽出された情報に基づいて、同じスコープの既存のメモリを削除または更新するかどうかを特定します。Memory Bank は、新しいメモリーが重複していないか、矛盾していないかを確認してから、既存の記憶と統合します。既存のメモリが新しい情報と重複しない場合は、新しいメモリが作成されます。
デフォルトでは、Memory Bank は統合時に同じスコープの既存のメモリをすべて考慮します。メタデータを使用して統合の対象となるメモリをより細かく制限する場合は、
REQUIRE_EXACT_MATCHメタデータ マージ戦略を使用します。デフォルトでは、メモリの最新のリビジョンのみが比較に使用されます。長期的な傾向をより正確に特定し、データを裏付けるには、Agent Platform インスタンスの作成時に
revisions_per_candidate_countを増やして、統合ロジックに過去のリビジョンをより多く含めます。
メモリ リビジョンを使用すると、メモリ生成の中間ステップを検査し、複数のリクエストでメモリがどのように変化するかを確認できます。各リビジョンには、各メモリー生成リクエストの抽出ステップ(extracted_memories)と最終統合ステップ(fact)の中間出力が含まれます。
list(client.memory_banks.memories.revisions.list(
  name="projects/.../locations/.../reasoningEngines/.../memories/.../revisions/..."))

"""
[
  MemoryRevision(
    name="projects/123/locations/us-central1/reasoningEngines/456/memories/789/revision/456",
    fact="This is my updated fact",
    extracted_memories=[
      IntermediateExtractedMemory(
        fact='This is the output of extraction for a single request.'
      ),
    ],
    ...
  ),
  MemoryRevision(
    name="projects/123/locations/us-central1/reasoningEngines/456/memories/789/revision/123",
    fact="This is my original fact",
    extracted_memories=[
      IntermediateExtractedMemory(
        fact='This is my original fact.'
      ),
    ],
    ...
  )
]
"""
メモリトピック
「メモリトピック」は、Memory Bank が有意義と判断し、生成されたメモリとして保持すべきと判断した情報を特定します。Memory Bank は、次の 2 種類の記憶のトピックをサポートしています。
管理対象トピック: ラベルと手順は Memory Bank によって定義されます。指定する必要があるのは、マネージド トピックの名前だけです。次に例を示します。
辞書
memory_topic = {
    "managed_memory_topic": {
        "managed_topic_enum": "USER_PERSONAL_INFO"
    }
}
クラスベース
from agentplatform.types import ManagedTopicEnum
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicManagedMemoryTopic as ManagedMemoryTopic

memory_topic = MemoryTopic(
    managed_memory_topic=ManagedMemoryTopic(
        managed_topic_enum=ManagedTopicEnum.USER_PERSONAL_INFO
    )
)
カスタム トピック: メモリバンク インスタンスの設定時に、ラベルと手順を定義します。これらは、Memory Bank の抽出ステップのプロンプトで使用されます。次に例を示します。
辞書
memory_topic = {
    "custom_memory_topic": {
        "label": "business_feedback",
        "description": """Specific user feedback about their experience
        at the coffee shop. This includes opinions on drinks, food,
        pastries, ambiance, staff friendliness, service speed,
        cleanliness, and any suggestions for improvement."""
    }
}
クラスベース
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicCustomMemoryTopic as CustomMemoryTopic

memory_topic = MemoryTopic(
    custom_memory_topic=CustomMemoryTopic(
        label="business_feedback",
        description="""Specific user feedback about their experience at
        the coffee shop. This includes opinions on drinks, food,
        pastries, ambiance, staff friendliness, service speed,
        cleanliness, and any suggestions for improvement."""
    )
)
カスタム トピックを使用する場合は、会話からメモリーを抽出する方法を示す少数ショットの例も指定することをおすすめします。
デフォルトでは、Memory Bank は次のすべてのマネージド トピックを保持します。
ユーザー情報(
USER_PERSONAL_INFO): ユーザーに関する重要な情報(名前、関係、趣味、重要な日付など)。たとえば、「私は Google で働いています」、「結婚記念日は 12 月 31 日です」などです。ユーザーの好み(
USER_PREFERENCES): 明示的または暗黙的な好み、嫌いなもの、好みのスタイル、パターン。たとえば、「真ん中の席がいいです」と入力します。会話の重要なイベントとタスクの結果(
KEY_CONVERSATION_DETAILS): 会話内の重要なマイルストーンまたは結論。たとえば、「JFK と SFO 間の往復航空券を予約しました。2025 年 6 月 1 日に出発し、2025 年 6 月 7 日に帰ります。」明示的な記憶 / 忘却の指示(
EXPLICIT_INSTRUCTIONS): エージェントに記憶または忘却を明示的に指示する情報。たとえば、ユーザーが「私は主に Python を使用していることを覚えておいて」と言うと、Memory Bank は「私は主に Python を使用している」という記憶を生成します。
これは、次のマネージド メモリトピックのセットを使用するのと同等です。
辞書
  memory_topics = [
      {"managed_memory_topic": {"managed_topic_enum": "USER_PERSONAL_INFO"}},
      {"managed_memory_topic": {"managed_topic_enum": "USER_PREFERENCES"}},
      {"managed_memory_topic": {"managed_topic_enum": "KEY_CONVERSATION_DETAILS"}},
      {"managed_memory_topic": {"managed_topic_enum": "EXPLICIT_INSTRUCTIONS"}},
  ]
クラスベース
from agentplatform.types import ManagedTopicEnum
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopic as MemoryTopic
from agentplatform.types import MemoryBankCustomizationConfigMemoryTopicManagedMemoryTopic as ManagedMemoryTopic

memory_topics = [
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.USER_PERSONAL_INFO)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.USER_PREFERENCES)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.KEY_CONVERSATION_DETAILS)),
  MemoryTopic(
      managed_memory_topic=ManagedMemoryTopic(
          managed_topic_enum=ManagedTopicEnum.EXPLICIT_INSTRUCTIONS)),
]
Memory Bank で保持するトピックをカスタマイズする場合は、Memory Bank の設定時にカスタマイズ構成でメモリトピックを設定します。
統合時のメタデータの使用
生成されたメモリにメタデータを添付できます。メタデータを使用すると、構造化された情報(文字列、倍精度浮動小数点数、ブール値、タイムスタンプ)をメモリファクトとともに保存できます。これは、メモリーのフィルタリングやライフサイクルの管理に役立ちます。
辞書
import datetime

client.memory_banks.memories.generate(
    ...,
    config={
        "metadata": {
            "my_string_key": {"string_value": "my_string_value"},
            "my_double_key": {"double_value": 123.456},
            "my_boolean_key": {"bool_value": True},
            "my_timestamp_key": {
                "timestamp_value": datetime.datetime(
                    2027, 1, 1, 12, 30, 00, tzinfo=datetime.timezone.utc
                )
            }
        },
        "metadata_merge_strategy": "MERGE"
    },
)
クラスベース
import datetime

from agentplatform import types

client.memory_banks.memories.generate(
    ...,
    config=types.GenerateMemoriesConfig(
        metadata={
            "my_string_key": types.MemoryMetadataValue(string_value="my_string_value"),
            "my_double_key": types.MemoryMetadataValue(double_value=123.456),
            "my_boolean_key": types.MemoryMetadataValue(bool_value=True),
            "my_timestamp_key": types.MemoryMetadataValue(
                timestamp_value=datetime.datetime(
                    2027, 1, 1, 12, 30, 00, tzinfo=datetime.timezone.utc
                )
            ),
        },
        metadata_merge_strategy=types.MemoryMetadataMergeStrategy.MERGE,
    )
)
metadata_merge_strategy を使用すると、統合中に新しいメタデータが既存のメモリとどのように相互作用するかを制御できます。
MERGE:(デフォルト)新しいメタデータを既存のメタデータと結合します。キーがすでに存在する場合は、新しい値で古い値が上書きされます。OVERWRITE: 更新されたメモリのメタデータを新しいメタデータに置き換えます。REQUIRE_EXACT_MATCH: リクエストとまったく同じメタデータを持つメモリに統合を制限します。メモリのメタデータが同じでない場合、統合の対象にはならず、更新もされません。
トピックのサブセットのメモリを生成する
デフォルトでは、Memory Bank インスタンスの設定時に構成したすべてのメモリトピックのデータがメモリ生成によって抽出されます。特定の GenerateMemories リクエストでは、抽出を構成済みのトピックのサブセットに制限できます。許可されるトピックを構成するには、allowed_topics フィールドを使用します。
辞書
client.memory_banks.memories.generate(
    ...,
    config={
        "allowed_topics": [
            {"managed_memory_topic": "USER_PERSONAL_INFO"},
            {"custom_memory_topic_label": "business_feedback"}
        ]
    },
)
クラスベース
from agentplatform import types

client.memory_banks.memories.generate(
    ...,
    config=types.GenerateMemoriesConfig(
        allowed_topics=[
            types.MemoryTopicId(
                managed_memory_topic=types.ManagedTopicEnum.USER_PERSONAL_INFO
            ),
            types.MemoryTopicId(
                custom_memory_topic_label="business_feedback"
            )
        ]
    )
)
メモリーの生成をトリガーする
メモリ生成は、次のいずれかの方法でトリガーできます。
GenerateMemories: データを Memory Bank に取り込み、メモリ生成を直ちにトリガーします。このメソッドは、セッションの終了時やセッション内の定期的な間隔など、特定の時点でメモリを生成する場合に便利です。IngestEvents: データを Memory Bank に継続的に取り込み、トリガー条件が満たされたときに Memory Bank で処理します。この方法は、イベントの連続ストリームがあり、Memory Bank でバッファリングを自動的に処理し、量または時間に基づいてメモリ生成をトリガーする場合に便利です。詳細については、イベントを取り込むをご覧ください。
メモリ生成では、ソースの会話から重要なコンテキストを抽出し、同じスコープの既存のメモリと組み合わせます。たとえば、{"user_id": "123",
"session_id": "456"} などのスコープを使用してセッション レベルのメモリを作成できます。同じスコープのメモリは統合して、まとめて取得できます。
GenerateMemories は長時間実行オペレーションです。オペレーションが完了すると、GenerateMemoriesOperation に生成されたメモリのリストが含まれます(生成された場合)。
GenerateMemoriesOperation(
  name="projects/.../locations/.../reasoningEngines/.../operations/...",
  done=True,
  response=GenerateMemoriesResponse(
    generatedMemories=[
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="CREATED",
      ),
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="UPDATED",
      ),
      GenerateMemoriesResponseGeneratedMemory(
        memory=Memory(
          "name": "projects/.../locations/.../reasoningEngines/.../memories/..."
        ),
        action="DELETED",
      ),
    ]
  )
)
生成された各メモリには、そのメモリで実行された action が含まれます。
CREATED: 新しいメモリが追加されたことを示します。これは、既存のメモリでは捉えられなかった新しいコンセプトを表します。UPDATED: 既存のメモリが更新されたことを示します。これは、メモリが新しく抽出された情報と同様のコンセプトをカバーしている場合に発生します。メモリの事実は新しい情報で更新されることもあれば、そのままの場合もあります。DELETED: 会話から抽出された新しい情報と矛盾する情報が含まれていたため、既存のメモリが削除されたことを示します。
CREATED または UPDATED メモリの場合、GetMemories を使用してメモリのコンテンツ全体を取得できます。DELETED のメモリを取得すると、404 エラーが発生します。
バックグラウンドでメモリを生成する
GenerateMemories は長時間実行オペレーションです。デフォルトでは、client.memory_banks.memories.generate はオペレーションが完了するまでオペレーションをポーリングするブロッキング関数です。生成されたメモリを手動で確認する場合や、生成されたメモリについてエンドユーザーに通知する場合は、メモリ生成をブロック オペレーションとして実行すると便利です。
ただし、本番環境のエージェントでは、通常、メモリ生成を非同期プロセスとしてバックグラウンドで実行します。ほとんどの場合、クライアントは現在の実行の出力を使用する必要がないため、レスポンスを待つために追加のレイテンシが発生する必要はありません。メモリ生成をバックグラウンドで実行する場合は、wait_for_completion を False に設定します。
client.memory_banks.memories.generate(
    ...,
    config={
        "wait_for_completion": False
    }
)
GenerateMemories を非同期で呼び出す代わりに、IngestEvents を使用できます。これにより、イベントの取り込みがメモリ生成から切り離され、デフォルトでバックグラウンドでイベントが処理されます。
データソース
メモリーの生成にソースデータを提供する方法は複数あります。
事前抽出された事実を提供することで、同じスコープの既存のメモリと統合します。
ペイロードでイベントを直接指定するか、セッションを使用すると、会話から情報が抽出され、既存のメモリーと統合されます。これらのデータソースからのみ情報を抽出する場合は、統合を無効にできます。
client.memory_banks.memories.generate(
    ...
    config={
        "disable_consolidation": True
    }
)
ペイロード内のイベントをデータソースとして使用する
ペイロードで直接提供されるイベントを使用してメモリを生成する場合は、direct_contents_source を使用します。これらのイベントから有意な情報が抽出され、同じスコープの既存の情報と統合されます。この方法は、Agent Platform Sessions とは異なるセッション ストレージを使用している場合に使用できます。
辞書
イベントには Content 辞書を含める必要があります。
events =  [
  {
    "content": {
      "role": "user",
      "parts": [
        {"text": "I work with LLM agents!"}
      ]
    }
  }
]

client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_contents_source={
      "events": EVENTS
    },
    # For example, `scope={"user_id": "123"}`.
    scope=SCOPE,
    config={
        "wait_for_completion": True
    }
)
次のように置き換えます。
SCOPE: 生成されたメモリのスコープを表す辞書。例:{"session_id": "MY_SESSION"}統合の対象となるのは、同じスコープのメモリのみです。
クラスベース
イベントには Content オブジェクトを含める必要があります。
from google import genai
from agentplatform import types

events = [
  types.GenerateMemoriesRequestDirectContentsSourceEvent(
    content=genai.types.Content(
      role="user",
      parts=[
        genai.types.Part.from_text(text="I work with LLM agents!")
      ]
    )
  )
]

client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_contents_source={
      "events": events
    },
    # For example, `scope={"user_id": "123"}`.
    scope=SCOPE,
    config={
        "wait_for_completion": True
    }
)
次のように置き換えます。
SCOPE: 生成されたメモリのスコープを表す辞書。例:{"session_id": "MY_SESSION"}統合の対象となるのは、同じスコープのメモリのみです。
Agent Platform セッションをデータソースとして使用する
Sessions を使用すると、Memory Bank はセッション イベントをメモリ生成のソース会話として使用します。
生成されたメモリの範囲を設定するため、Memory Bank はデフォルトでセッションからユーザー ID を抽出して使用します。たとえば、セッションの user_id が「123」の場合、メモリのスコープは {"user_id": "123"} として保存されます。scope を直接指定することもできます。この場合、セッションの user_id をスコープとして使用する設定はオーバーライドされます。
辞書
client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source={
      # For example, projects/.../locations/.../reasoningEngines/.../sessions/...
      "session": "SESSION_NAME"
  },
  # Optional when using Sessions. Defaults to {"user_id": session.user_id}.
  scope=SCOPE,
  config={
      "wait_for_completion": True
  }
)
次のように置き換えます。
SESSION_NAME: 完全修飾セッション名。(省略可)
SCOPE: 生成されたメモリのスコープを表す辞書。例:{"session_id": "MY_SESSION"}統合の対象となるのは、同じスコープのメモリのみです。指定しない場合、{"user_id": session.user_id}が使用されます。
クラスベース
from agentplatform import types

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source=types.GenerateMemoriesRequestVertexSessionSource(
      # For example, projects/.../locations/.../reasoningEngines/.../sessions/...
      session="SESSION_NAME"
  ),
  # Optional when using Sessions. Defaults to {"user_id": session.user_id}.
  scope=SCOPE,
  config={
      "wait_for_completion": True
  }
)
必要に応じて、セッションに含めるイベントを示す期間を指定できます。指定しない場合、セッション内のすべてのイベントが対象となります。
辞書
import datetime

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source={
      "session": "SESSION_NAME",
      # Extract memories from the last hour of events.
      "start_time": datetime.datetime.now(tz=datetime.timezone.utc) - datetime.timedelta(seconds=24 * 60),
      "end_time": datetime.datetime.now(tz=datetime.timezone.utc)
  },
  scope=SCOPE
)
クラスベース
import datetime

from agentplatform import types

client.memory_banks.memories.generate(
  name=memory_bank.name,
  vertex_session_source=types.GenerateMemoriesRequestVertexSessionSource(
      session="SESSION_NAME",
      # Extract memories from the last hour of events.
      start_time=datetime.datetime.now(tz=datetime.timezone.utc) - datetime.timedelta(seconds=24 * 60),
      end_time=datetime.datetime.now(tz=datetime.timezone.utc)
  ),
  scope=SCOPE
)
事前に抽出されたメモリを統合する
Memory Bank の自動抽出プロセスを使用する代わりに、事前に抽出したメモリを直接指定することもできます。直接ソースのメモリは、同じスコープの既存のメモリと統合されます。これは、エージェントまたは人間参加型がメモリの抽出を担当し、Memory Bank の統合を利用して重複や矛盾するメモリがないようにしたい場合に便利です。
client.memory_banks.memories.generate(
    name=memory_bank.name,
    direct_memories_source={"direct_memories": [{"fact": "FACT"}]},
    scope=SCOPE
)
次のように置き換えます。
FACT: 既存のメモリと統合する必要がある事前抽出された事実。次のようなリストで、最大 5 個の事前抽出された事実を指定できます。{"direct_memories": [{"fact": "fact 1"}, {"fact": "fact 2"}]}SCOPE: 生成されたメモリのスコープを表す辞書。例:{"session_id": "MY_SESSION"}統合の対象となるのは、同じスコープのメモリのみです。
マルチモーダル入力の使用
マルチモーダル入力から記憶を抽出できます。ただし、メモリはソース コンテンツのテキスト、インライン ファイル、ファイルデータからのみ抽出されます。関数呼び出しやレスポンスなど、他のすべてのコンテンツは、メモリの生成時に無視されます。
メモリは、ユーザーが提供した画像、動画、音声から抽出できます。マルチモーダル入力によって提供されたコンテキストが、Memory Bank によって今後のやり取りに有益であると判断された場合、入力から抽出された情報を含むテキストメモリが作成されることがあります。たとえば、ユーザーが「これは私の犬です」というテキストとともにゴールデン レトリバーの画像を提供すると、Memory Bank は「私の犬はゴールデン レトリバーです」などのメモリを生成します。
たとえば、ペイロードで画像とそのコンテキストを指定できます。
辞書
with open(file_name, "rb") as f:
    inline_data = f.read()

events =  [
  {
    "content": {
      "role": "user",
      "parts": [
        {"text": "This is my dog"},
        {
          "inline_data": {
            "mime_type": "image/jpeg",
            "data": inline_data
          }
        },
        {
          "file_data": {
            "file_uri": "gs://cloud-samples-data/generative-ai/image/dog.jpg",
            "mime_type": "image/jpeg"
          }
        },
      ]
    }
  }
]
クラスベース
from google import genai
from agentplatform import types

with open(file_name, "rb") as f:
    inline_data = f.read()

events = [
  types.GenerateMemoriesRequestDirectContentsSourceEvent(
    content=genai.types.Content(
      role="user",
      parts=[
        genai.types.Part.from_text(text="This is my dog"),
        genai.types.Part.from_bytes(
          data=inline_data,
          mime_type="image/jpeg",
        ),
        genai.types.Part.from_uri(
          file_uri="gs://cloud-samples-data/generative-ai/image/dog.jpg",
          mime_type="image/jpeg",
        )
      ]
    )
  )
]