

Wenn Sie Managed Service for Apache Spark verwenden, um Cluster zu erstellen und Jobs in Ihren Clustern auszuführen, richtet der Dienst die erforderlichen Managed Service for Apache Spark-Rollen und -Berechtigungen in Ihrem Projekt ein, um auf die Cloud de Confiance by S3NS -Ressourcen zuzugreifen und sie zu verwenden, die für diese Aufgaben erforderlich sind. Wenn Sie jedoch projektübergreifend arbeiten, um beispielsweise auf Daten in einem anderen Projekt zuzugreifen, müssen Sie die erforderlichen Rollen und Berechtigungen für den Zugriff auf projektübergreifende Ressourcen einrichten.
Damit Sie projektübergreifend arbeiten können, werden in diesem Dokument die verschiedenen Hauptkonten aufgeführt, die Managed Service for Apache Spark verwenden, sowie die Rollen, die die erforderlichen Berechtigungen für diese Hauptkonten enthalten, um auf Cloud de Confiance -Ressourcen zuzugreifen und diese zu verwenden.
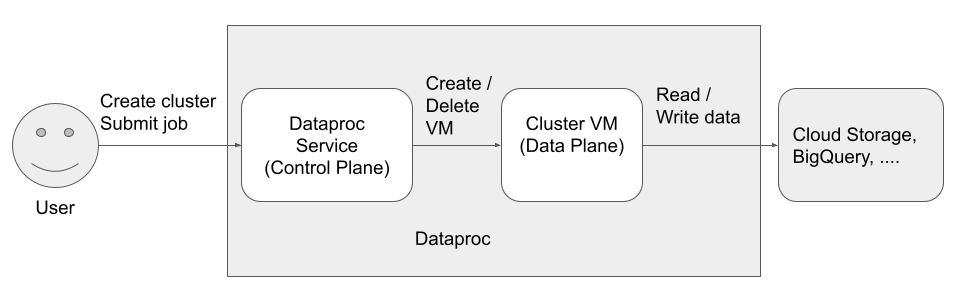
Es gibt drei Hauptkonten (Identitäten), die auf Managed Service for Apache Spark zugreifen und ihn verwenden:
- Nutzeridentität
- Identität der Steuerungsebene
Identität der Datenebene
Dataproc API-Nutzer (Nutzeridentität)
Beispiel: username@example.com
Dies ist der Nutzer, der Managed Service for Apache Spark aufruft, um Cluster zu erstellen, Jobs einzureichen und andere Anfragen an den Dienst zu senden. Der Nutzer ist in der Regel eine Einzelperson, kann aber auch ein Dienstkonto sein, wenn Managed Service for Apache Spark über einen API-Client oder einen anderenCloud de Confiance by S3NS -Dienst wie Compute Engine, Cloud Run Functions oder Managed Service for Apache Airflow aufgerufen wird.
Zugehörige Rollen
Hinweise
- Von Dataproc API gesendete Jobs werden unter Linux als
rootausgeführt. Managed Service for Apache Spark-Cluster übernehmen projektweite Compute Engine-SSH-Metadaten, sofern sie nicht explizit durch Festlegen von
--metadata=block-project-ssh-keys=truebeim Erstellen des Clusters blockiert werden (siehe Clustermetadaten).HDFS-Nutzerverzeichnisse werden für jeden SSH-Nutzer auf Projektebene erstellt. Diese HDFS-Verzeichnisse werden bei der Clusterbereitstellung erstellt und ein neuer SSH-Nutzer (nach der Bereitstellung) erhält kein HDFS-Verzeichnis in vorhandenen Clustern.
Managed Service for Apache Spark-Dienst-Agent (Identität der Steuerungsebene)
Beispiel: service-project-number@dataproc-accounts.s3ns-system.iam.gserviceaccount.com
Das Dienstkonto des Managed Service for Apache Spark-Dienst-Agents wird verwendet, um eine Vielzahl von Systemvorgängen für Ressourcen auszuführen, die sich in dem Projekt befinden, in dem ein Managed Service for Apache Spark-Cluster erstellt wird. Dazu gehören:
- Erstellen von Compute Engine-Ressourcen, einschließlich VM-Instanzen, Instanzgruppen und Instanzvorlagen
get- undlist-Vorgänge, um die Konfiguration von Ressourcen wie Images, Firewalls, Initialisierungsaktionen für Managed Service for Apache Spark und Cloud Storage-Buckets zu bestätigen- Automatisches Erstellen der Staging- und temporären Buckets von Managed Service for Apache Spark, wenn der Staging- oder temporäre Bucket nicht vom Nutzer angegeben wird
- Schreiben von Metadaten der Clusterkonfiguration in den Staging-Bucket
- Zugriff auf VPC-Netzwerke in einem Hostprojekt
Zugehörige Rollen
VM-Dienstkonto für Managed Service for Apache Spark (Datenebenenidentität)
Beispiel: project-number-compute@developer.s3ns-system.iam.gserviceaccount.com
Ihr Anwendungscode wird als VM-Dienstkonto auf Managed Service for Apache Spark-VMs ausgeführt. Nutzerjobs werden die Rollen (mit den zugehörigen Berechtigungen) dieses Dienstkontos zugewiesen.
Das VM-Dienstkonto führt folgende Aufgaben aus:
- Kommuniziert mit der Managed Service for Apache Spark-Steuerungsebene.
- Liest Daten aus den Staging- und temporären Buckets von Managed Service for Apache Spark und schreibt Daten in diese.
- Liest und schreibt Daten aus und in Cloud Storage, BigQuery, Cloud Logging und andere Cloud de Confiance by S3NS -Ressourcen, wie es für Ihre Managed Service for Apache Spark-Jobs erforderlich ist.
Zugehörige Rollen
Nächste Schritte
- Weitere Informationen zu Rollen und Berechtigungen für Managed Service for Apache Spark
- Weitere Informationen zu Dienstkonten für Managed Service for Apache Spark
- Weitere Informationen finden Sie unter BigQuery-Zugriffssteuerung.
- Weitere Informationen finden Sie unter Optionen für die Zugriffssteuerung in Cloud Storage.