

Quando utilizzi Managed Service for Apache Spark per creare cluster ed eseguire job sui tuoi cluster, il servizio configura i ruoli e le autorizzazioni di Managed Service for Apache Spark necessari nel tuo progetto per accedere e utilizzare le risorse Cloud de Confiance by S3NS di cui ha bisogno per svolgere queste attività. Tuttavia, se esegui un lavoro tra progetti, ad esempio per accedere ai dati in un altro progetto, devi configurare i ruoli e le autorizzazioni necessari per accedere alle risorse tra progetti.
Per aiutarti a svolgere correttamente il lavoro tra progetti, questo documento elenca le diverse entità che utilizzano Managed Service for Apache Spark e i ruoli che contengono le autorizzazioni necessarie per consentire a queste entità di accedere e utilizzare le risorse Cloud de Confiance .
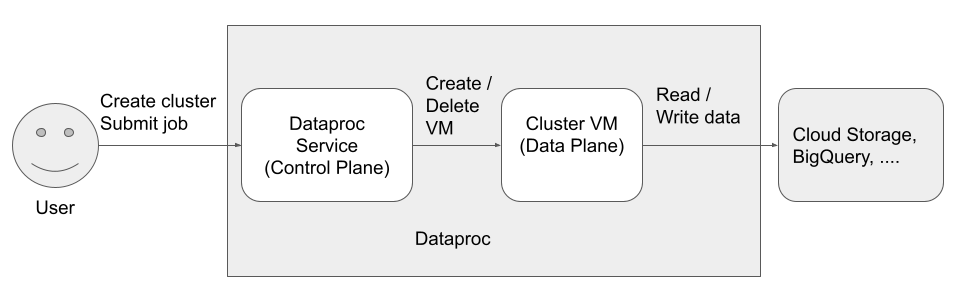
Esistono tre entità (identità) che accedono e utilizzano Managed Service for Apache Spark:
- Identità utente
- Identità del control plane
Identità del piano dati
Utente API Dataproc (identità utente)
Esempio: username@example.com
Questo è l'utente che chiama Managed Service for Apache Spark per creare cluster, inviare job ed effettuare altre richieste al servizio. L'utente è solitamente un privato, ma può anche essere un service account se Managed Service for Apache Spark viene richiamato tramite un client API o da un altro servizioCloud de Confiance by S3NS come Compute Engine, Cloud Run Functions o Managed Service for Apache Airflow.
Ruoli correlati
Note
- I job inviati tramite l'API Dataproc vengono eseguiti come
rootsu Linux. I cluster Managed Service for Apache Spark ereditano i metadati SSH di Compute Engine a livello di progetto, a meno che non vengano bloccati esplicitamente impostando
--metadata=block-project-ssh-keys=truequando crei il cluster (vedi Metadati del cluster).Le directory utente HDFS vengono create per ogni utente SSH a livello di progetto. Queste directory HDFS vengono create al momento del deployment del cluster e a un nuovo utente SSH (post-deployment) non viene assegnata una directory HDFS sui cluster esistenti.
Agente di servizio Managed Service for Apache Spark (identità del control plane)
Esempio: service-project-number@dataproc-accounts.s3ns-system.iam.gserviceaccount.com
Il service account Managed Service for Apache Spark Service Agent viene utilizzato per eseguire un ampio insieme di operazioni di sistema sulle risorse situate nel progetto in cui viene creato un cluster Managed Service for Apache Spark, tra cui:
- Creazione di risorse Compute Engine, tra cui istanze VM, gruppi di istanze e template di istanza
- Operazioni
getelistper confermare la configurazione di risorse come immagini, firewall, azioni di inizializzazione di Managed Service for Apache Spark e bucket Cloud Storage - Creazione automatica dei bucket temporanei e di staging di Managed Service for Apache Spark se il bucket gestione temporanea o di staging non è specificato dall'utente
- Scrittura dei metadati di configurazione del cluster nel bucket di gestione temporanea
- Accesso alle reti VPC in un progetto host
Ruoli correlati
Account di servizio VM di Managed Service for Apache Spark (identità del piano dati)
Esempio: project-number-compute@developer.s3ns-system.iam.gserviceaccount.com
Il codice dell'applicazione viene eseguito come service account VM sulle VM di Managed Service for Apache Spark. Ai job utente vengono concessi i ruoli (con le relative autorizzazioni associate) di questo account di servizio.
Il account di servizio della VM esegue le seguenti operazioni:
- Comunica con il control plane di Managed Service for Apache Spark.
- Legge e scrive dati da e verso i bucket temporanei e di staging di Managed Service for Apache Spark.
- In base alle esigenze dei job di Managed Service for Apache Spark, legge e scrive dati da e in Cloud Storage, BigQuery, Cloud Logging e altre risorse Cloud de Confiance by S3NS .
Ruoli correlati
Passaggi successivi
- Scopri di più su ruoli e autorizzazioni di Managed Service for Apache Spark.
- Scopri di più sugli account di servizio Managed Service for Apache Spark.
- Consulta Controllo degli accessi di BigQuery.
- Consulta le opzioni di controllo dell'accesso di Cloud Storage.