

Der spark-bigquery-connector wird mit Apache Spark verwendet, um Daten aus BigQuery zu lesen und zu schreiben. Der Connector nutzt die BigQuery Storage API, wenn Daten aus BigQuery gelesen werden.
In dieser Anleitung finden Sie Informationen zur Verfügbarkeit des vorinstallierten Connectors und erfahren, wie Sie eine bestimmte Connector-Version für Spark-Jobs verfügbar machen. Der Beispielcode zeigt, wie Sie den Spark BigQuery-Connector in einer Spark-Anwendung verwenden.
Vorinstallierten Connector verwenden
Der Spark BigQuery-Connector ist vorinstalliert und für Spark-Jobs verfügbar, die auf Managed Service for Apache Spark-Clustern ausgeführt werden, die mit Image-Versionen ab 2.1 erstellt wurden. Die vorinstallierte Connector-Version ist auf den Release-Seiten der Image-Version aufgeführt.
Bestimmte Connector-Version für Spark-Jobs verfügbar machen
Wenn Sie eine Connector-Version verwenden möchten, die sich von einer vorinstallierten Version auf einem Cluster mit der Image-Version 2.1 oder höher unterscheidet, oder wenn Sie den Connector auf einem Cluster mit einer Image-Version vor 2.1 installieren möchten, folgen Sie der Anleitung in diesem Abschnitt.
Wichtig: Die spark-bigquery-connector-Version muss mit der Image-Version des Managed Service for Apache Spark-Clusters kompatibel sein. Weitere Informationen finden Sie in der Kompatibilitätsmatrix für Connector für Managed Service for Apache Spark-Images.
Cluster mit Image-Version 2.1 und höher
Wenn Sie einen Managed Service for Apache Spark-Cluster mit der Image-Version 2.1 oder höher erstellen, geben Sie die Connector-Version als Cluster-Metadaten an.
Beispiel für die gcloud CLI:
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --image-version=2.2 \
    --metadata=SPARK_BQ_CONNECTOR_VERSION or SPARK_BQ_CONNECTOR_URL\
    other flags
Hinweise:
SPARK_BQ_CONNECTOR_VERSION: Geben Sie eine Connector-Version an. Spark-BigQuery-Connector-Versionen sind auf der GitHub-Seite spark-bigquery-connector/releases aufgeführt.
Beispiel:
--metadata=SPARK_BQ_CONNECTOR_VERSION=0.42.1
SPARK_BQ_CONNECTOR_URL: Geben Sie eine URL an, die auf die JAR-Datei in Cloud Storage verweist. Sie können die URL eines Connectors angeben, der in der Spalte Link unter Connector herunterladen und verwenden in GitHub aufgeführt ist, oder den Pfad zu einem Cloud Storage-Speicherort, an dem Sie eine benutzerdefinierte Connector-JAR-Datei abgelegt haben.
Beispiele:
--metadata=SPARK_BQ_CONNECTOR_URL=gs://spark-lib/bigquery/spark-3.5-bigquery-0.42.1.jar
--metadata=SPARK_BQ_CONNECTOR_URL=gs://PATH_TO_CUSTOM_JAR
Cluster mit Image-Version 2.0 und früher
Sie können den Spark BigQuery-Connector auf eine der folgenden Arten für Ihre Anwendung verfügbar machen:
Installieren Sie den spark-bigquery-connector im Spark-JAR-Verzeichnis jedes Knotens, indem Sie beim Erstellen des Clusters die Initialisierungsaktion für Managed Service for Apache Spark-Connectors verwenden.
Geben Sie die Connector-JAR-URL an, wenn Sie Ihren Job über die Cloud de Confiance Console, die gcloud CLI oder die Managed Service for Apache Spark API an den Cluster senden.
Console
Verwenden Sie das Element JAR-Dateien des Spark-Jobs auf der Seite Job senden von Managed Service for Apache Spark.
gcloud
Verwenden Sie das Flag
gcloud dataproc jobs submit spark --jars.API
Verwenden Sie das Feld
SparkJob.jarFileUris.Connector-JAR-Datei beim Ausführen von Spark-Jobs in Clustern mit Image-Versionen vor 2.0 angeben
- Geben Sie die Connector-JAR-Datei an, indem Sie die Scala- und Connector-Versionsinformationen im folgenden URI-String ersetzen:
gs://spark-lib/bigquery/spark-bigquery-with-dependencies_SCALA_VERSION-CONNECTOR_VERSION.jar
- Scala
2.12mit Managed Service for Apache Spark-Image-Versionen1.5+verwendengs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.12-0.23.2.jar \
    -- job args
- Verwenden Sie Scala
2.11mit Managed Service for Apache Spark-Image-Versionen1.4und früher:gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-CONNECTOR_VERSION.jar
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/bigquery/spark-bigquery-with-dependencies_2.11-0.23.2.jar \
    -- job-args
- Geben Sie die Connector-JAR-Datei an, indem Sie die Scala- und Connector-Versionsinformationen im folgenden URI-String ersetzen:
Fügen Sie die Connector-JAR-Datei als Abhängigkeit in Ihre Scala- oder Java-Spark-Anwendung ein (siehe Mit dem Connector kompilieren).
Kosten berechnen
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Cloud de Confiance by S3NS:
- Managed Service for Apache Spark
- BigQuery
- Cloud Storage
Daten aus BigQuery lesen und in BigQuery schreiben
In diesem Beispiel werden Daten aus BigQuery in einen Spark-DataFrame eingelesen und dann mit der Standard-Datenquellen-API einer Wortzählung unterzogen.
Der Connector liest Daten aus BigQuery mithilfe der BigQuery Storage Read API, die direkt und verteilt aus den Datendateien der Tabelle liest.
Der Connector schreibt die Daten in einem von zwei Modi in BigQuery: DIRECT oder INDIRECT.
- DIRECT: Verwendet die BigQuery Storage Write API. Jeder Executor schreibt seine Daten und der Treiber schreibt alle ausstehenden Daten in die Tabelle.
- INDIRECT: Die Daten werden in einer temporären Cloud Storage-Tabelle zwischengespeichert. Anschließend wird ein BigQuery-Ladejob ausgelöst, um die Daten in einem Vorgang nach BigQuery zu kopieren.
Im INDIRECT-Modus versucht der Connector, die temporären Dateien zu löschen, sobald der BigQuery-Ladevorgang erfolgreich war und noch einmal, wenn die Spark-Anwendung beendet wird. Wenn der Job fehlschlägt, entfernen Sie alle verbleibenden temporären Cloud Storage-Dateien manuell. In der Regel befinden sich temporäre BigQuery-Dateien in gs://[bucket]/.spark-bigquery-[jobid]-[UUID].
Abrechnung konfigurieren
Standardmäßig wird die API-Nutzung dem Projekt in Rechnung gestellt, das mit den Anmeldedaten oder dem Dienstkonto verknüpft ist. Wenn Sie ein anderes Projekt in Rechnung stellen möchten, legen Sie die folgende Konfiguration fest: spark.conf.set("parentProject", "<BILLED-GCP-PROJECT>").
Sie kann auch einem Lese- oder Schreibvorgang hinzugefügt werden: .option("parentProject", "<BILLED-GCP-PROJECT>").
Code ausführen
Erstellen Sie vor dem Ausführen dieses Beispiels ein Dataset mit dem Namen „wordcount_dataset“ oder ändern Sie das Ausgabe-Dataset im Code in ein vorhandenes BigQuery-Dataset in IhremCloud de Confiance by S3NS -Projekt.
Verwenden Sie den bq-Befehl zum Erstellen des wordcount_dataset:
bq mk wordcount_dataset
Verwenden Sie den Google Cloud CLI-Befehl, um einen Cloud Storage-Bucket zu erstellen, der für den Export nach BigQuery verwendet wird:
gcloud storage buckets create gs://[bucket]
Scala
- Sehen Sie sich den Code an und ersetzen Sie den Platzhalter [bucket] durch den zuvor erstellten Cloud Storage-Bucket.
/*
 * Remove comment if you are not running in spark-shell.
 *
import org.apache.spark.sql.SparkSession
val spark = SparkSession.builder()
  .appName("spark-bigquery-demo")
  .getOrCreate()
*/

// Use the Cloud Storage bucket for temporary BigQuery export data used
// by the connector.
val bucket = "[bucket]"
spark.conf.set("temporaryGcsBucket", bucket)
// Enable reading from BigQuery views and materializing query results.
spark.conf.set("viewsEnabled", "true")
spark.conf.set("materializationDataset", "wordcount_dataset")

// Load data in from BigQuery. See
// https://github.com/GoogleCloudDataproc/spark-bigquery-connector#properties
// for option information.
val wordsDF =
  spark.read.bigquery("bigquery-public-data:samples.shakespeare")
  .cache()

wordsDF.createOrReplaceTempView("words")

// Perform word count.
val wordCountDF = spark.sql(
  "SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word")
wordCountDF.show()
wordCountDF.printSchema()

// Saving the data to BigQuery.
(wordCountDF.write.format("bigquery")
  .save("wordcount_dataset.wordcount_output"))
- Code in einem Cluster ausführen
- Stellen Sie über SSH eine Verbindung zum Masterknoten des Managed Service for Apache Spark-Clusters her.
- Rufen Sie in der Cloud de Confiance Console die Seite Managed Service for Apache Spark Cluster auf und klicken Sie auf den Namen Ihres Clusters
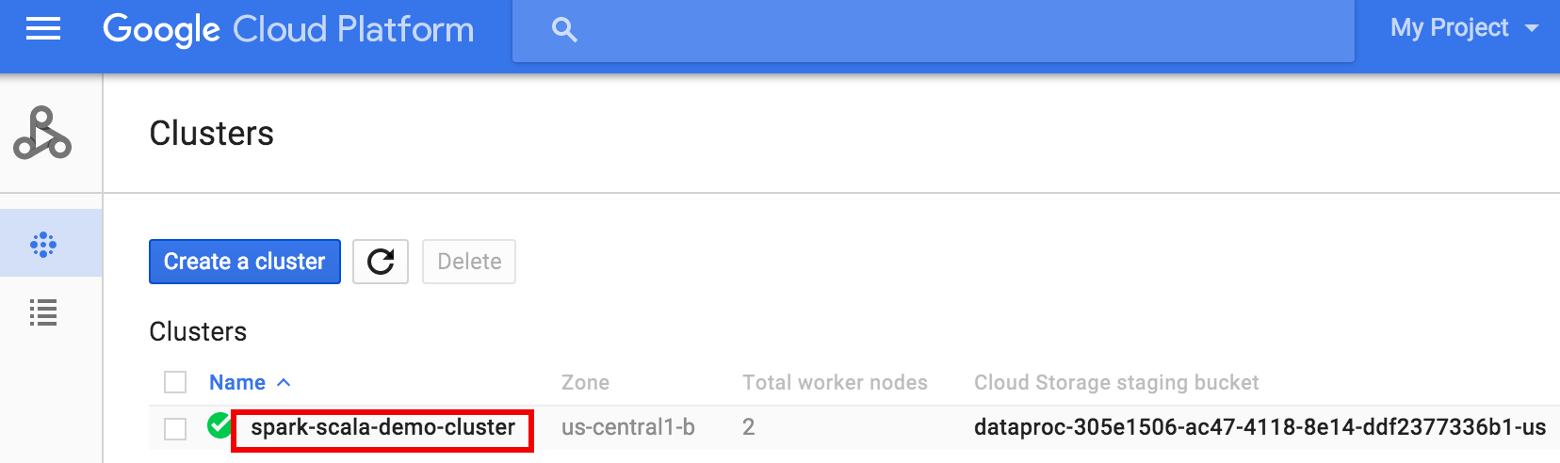 .
- Wählen Sie auf der Seite Clusterdetails den Tab „VM-Instanzen“ aus. Klicken Sie dann rechts neben dem Namen des Clustermasterknotens auf
SSH>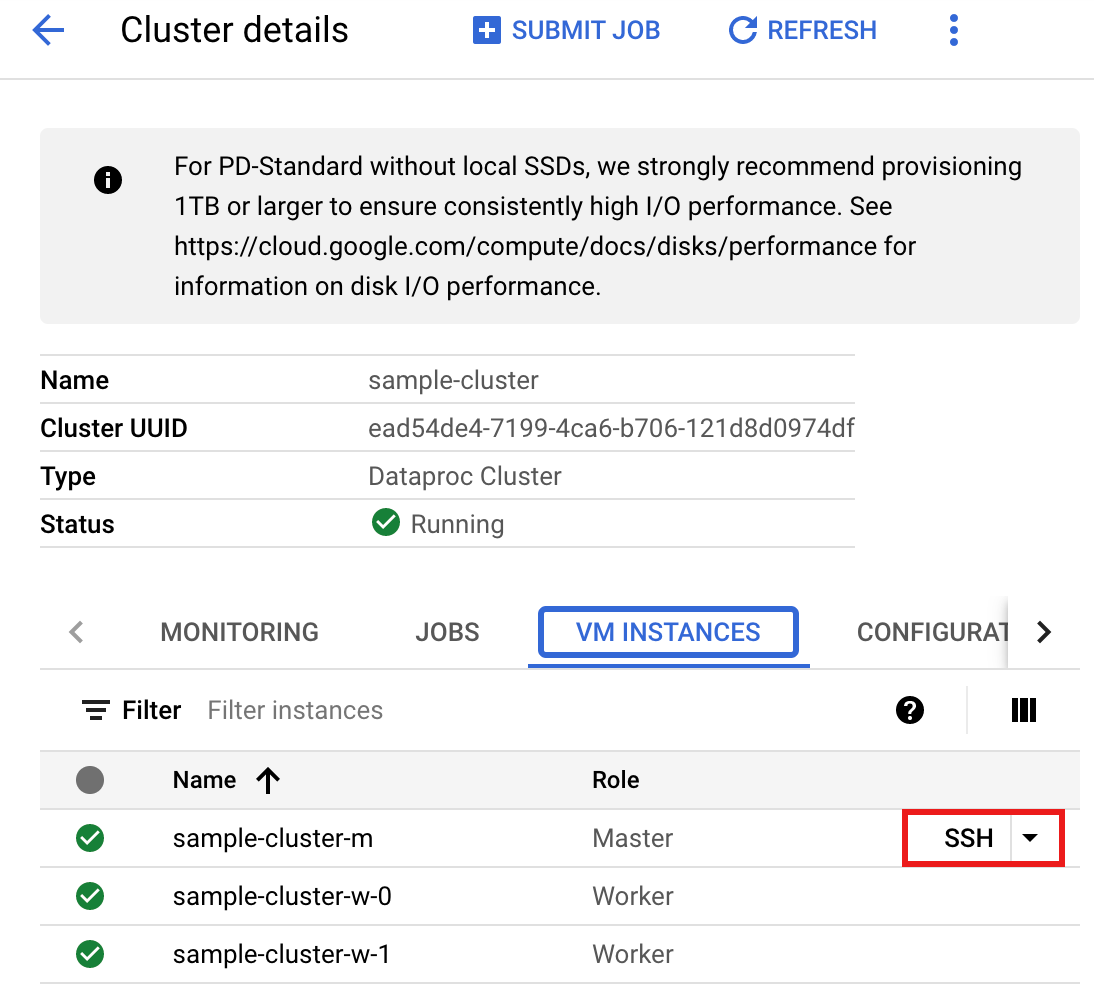 .
Ein Browserfenster wird in Ihrem Basisverzeichnis auf dem Masterknoten geöffnet.Connected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- Rufen Sie in der Cloud de Confiance Console die Seite Managed Service for Apache Spark Cluster auf und klicken Sie auf den Namen Ihres Clusters
- Erstellen Sie
wordcount.scalamit dem vorinstallierten Texteditorvi,vimodernanound fügen Sie dann den Scala-Code aus der Scala-Code-Liste ein.nano wordcount.scala
- Starten Sie die
spark-shell-REPL.$ spark-shell --jars=gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar ... Using Scala version ... Type in expressions to have them evaluated. Type :help for more information. ... Spark context available as sc. ... SQL context available as sqlContext. scala>
- Führen Sie wordcount.scala mit dem
:load wordcount.scala-Befehl aus, um die BigQuery-wordcount_output-Tabelle zu erstellen. Die Ausgabeliste zeigt 20 Zeilen von der Wordcount-Ausgabe an.:load wordcount.scala ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
Wenn Sie sich eine Vorschau der Ausgabetabelle ansehen möchten, öffnen Sie die SeiteBigQuery, wählen Sie die Tabellewordcount_outputaus und klicken Sie dann auf Vorschau.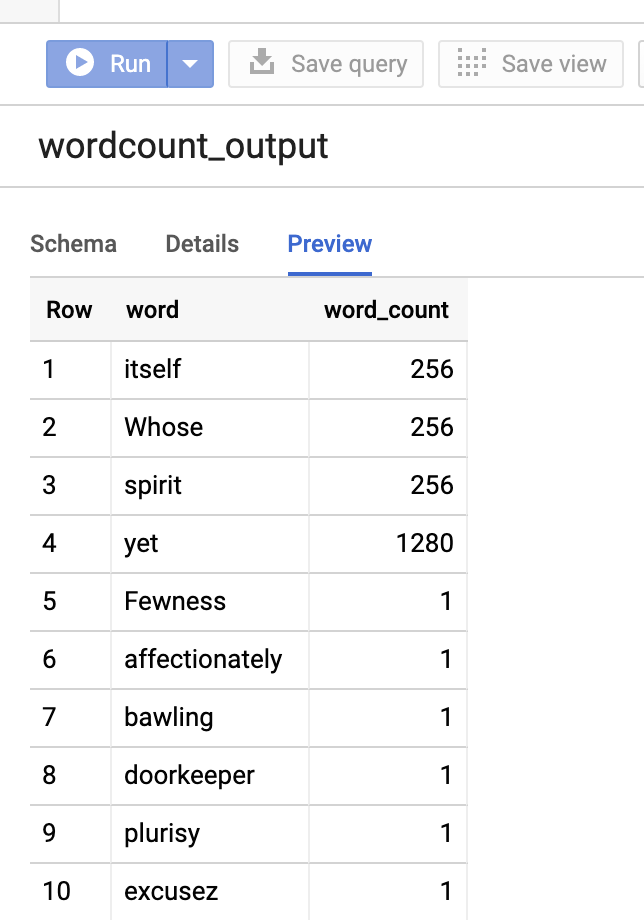
- Stellen Sie über SSH eine Verbindung zum Masterknoten des Managed Service for Apache Spark-Clusters her.
PySpark
- Sehen Sie sich den Code an und ersetzen Sie den Platzhalter [bucket] durch den zuvor erstellten Cloud Storage-Bucket.
#!/usr/bin/env python

"""BigQuery I/O PySpark example."""

from pyspark.sql import SparkSession

spark = SparkSession \
  .builder \
  .master('yarn') \
  .appName('spark-bigquery-demo') \
  .getOrCreate()

# Use the Cloud Storage bucket for temporary BigQuery export data used
# by the connector.
bucket = "[bucket]"
spark.conf.set('temporaryGcsBucket', bucket)
# Enable reading from BigQuery views and materializing query results.
spark.conf.set('viewsEnabled', 'true')
spark.conf.set('materializationDataset', 'wordcount_dataset')

# Load data from BigQuery.
words = spark.read.format('bigquery') \
  .load('bigquery-public-data:samples.shakespeare')
words.createOrReplaceTempView('words')

# Perform word count.
word_count = spark.sql(
    'SELECT word, SUM(word_count) AS word_count FROM words GROUP BY word')
word_count.show()
word_count.printSchema()

# Save the data to BigQuery
word_count.write.format('bigquery') \
  .save('wordcount_dataset.wordcount_output')
- Code auf dem Cluster ausführen
- Stellen Sie über SSH eine Verbindung zum Masterknoten des Managed Service for Apache Spark-Clusters her.
- Rufen Sie in der Cloud de Confiance Console die Seite Managed Service for Apache Spark Cluster auf und klicken Sie auf den Namen Ihres Clusters .
- Wählen Sie auf der Seite Clusterdetails den Tab „VM-Instanzen“ aus. Klicken Sie dann rechts neben dem Namen des Clustermasterknotens auf
SSH.
Ein Browserfenster wird in Ihrem Basisverzeichnis auf dem Masterknoten geöffnet.Connected, host fingerprint: ssh-rsa 2048 ... ... user@clusterName-m:~$
- Rufen Sie in der Cloud de Confiance Console die Seite Managed Service for Apache Spark Cluster auf und klicken Sie auf den Namen Ihres Clusters
- Erstellen Sie
wordcount.pymit dem vorinstallierten Texteditorvi,vimodernanound fügen Sie dann den PySpark-Code aus der PySpark-Codeliste ein.nano wordcount.py
- Führen Sie Wordcount mit
spark-submitaus, um die BigQuery-wordcount_output-Tabelle zu erstellen. Die Ausgabeliste zeigt 20 Zeilen von der Wordcount-Ausgabe an.spark-submit --jars gs://spark-lib/bigquery/spark-bigquery-latest_2.12.jar wordcount.py ... +---------+----------+ | word|word_count| +---------+----------+ | XVII| 2| | spoil| 28| | Drink| 7| |forgetful| 5| | Cannot| 46| | cures| 10| | harder| 13| | tresses| 3| | few| 62| | steel'd| 5| | tripping| 7| | travel| 35| | ransom| 55| | hope| 366| | By| 816| | some| 1169| | those| 508| | still| 567| | art| 893| | feign| 10| +---------+----------+ only showing top 20 rows root |-- word: string (nullable = false) |-- word_count: long (nullable = true)
Wenn Sie sich eine Vorschau der Ausgabetabelle ansehen möchten, öffnen Sie die SeiteBigQuery, wählen Sie die Tabellewordcount_outputaus und klicken Sie dann auf Vorschau.
- Stellen Sie über SSH eine Verbindung zum Masterknoten des Managed Service for Apache Spark-Clusters her.
Tipps zur Fehlerbehebung
Sie können Joblogs in Cloud Logging und im BigQuery-Job-Explorer prüfen, um Fehler bei Spark-Jobs zu beheben, die den BigQuery-Connector verwenden.
Managed Service for Apache Spark-Treiberlogs enthalten einen
BigQueryClient-Eintrag mit BigQuery-Metadaten, die diejobIdenthalten:ClassNotFoundException
INFO BigQueryClient:.. jobId: JobId{project=PROJECT_ID, job=JOB_ID, location=LOCATION} BigQuery-Jobs enthalten die Labels
Managed Service for Apache Spark_job_idundManaged Service for Apache Spark_job_uuid:- Logging:
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_id="JOB_ID"
protoPayload.serviceData.jobCompletedEvent.job.jobConfiguration.labels.dataproc_job_uuid="JOB_UUID"
protoPayload.serviceData.jobCompletedEvent.job.jobName.jobId="JOB_NAME"
- BigQuery-Job-Explorer: Klicken Sie auf eine Job-ID, um die Jobdetails unter Labels in Jobinformationen aufzurufen.
- Logging:
Nächste Schritte
- Weitere Informationen finden Sie unter BigQuery Storage und Spark SQL – Python.
- Tabellendefinitionsdatei für eine externe Datenquelle erstellen
- Extern partitionierte Daten abfragen
- Weitere Informationen finden Sie unter Tipps zur Optimierung von Spark-Jobs.