

Auf dieser Seite erfahren Sie, wie Sie einen Managed Service for Apache Spark-Cluster erstellen, der den Spark Spanner-Connector verwendet, um mit Apache Spark Daten aus Spanner zu lesen und in Spanner zu schreiben.
Der Spanner-Connector funktioniert mit Spark, um Daten aus der Spanner-Datenbank zu lesen und in die Spanner-Datenbank zu schreiben. Dazu wird die Spanner-Java-Bibliothek verwendet. Der Spanner-Connector unterstützt das Lesen von Spanner-Tabellen und Diagrammen in Spark-DataFrames und GraphFrames sowie das Schreiben von DataFrame-Daten in Spanner-Tabellen.
Kosten
In diesem Dokument verwenden Sie die folgenden kostenpflichtigen Komponenten von Cloud de Confiance by S3NS:
- Managed Service for Apache Spark
- Spanner
- Cloud Storage
Hinweis
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
Enable the Spanner, Managed Service for Apache Spark, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.- Erforderliche Rollen zuweisen
- Managed Service for Apache Spark-Cluster einrichten
- Spanner-Instanz mit einer Datenbanktabelle „Singers“ einrichten
Erforderliche Rollen zuweisen
Für die Ausführung der Beispiele auf dieser Seite sind bestimmte IAM-Rollen erforderlich. Je nach Organisationsrichtlinien wurden diese Rollen möglicherweise bereits gewährt. Informationen zum Prüfen von Rollenzuweisungen finden Sie unter Müssen Sie Rollen zuweisen?.
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Bitten Sie Ihren Administrator, dem Compute Engine-Standarddienstkonto die folgenden IAM-Rollen für das Projekt zuzuweisen, damit das Compute Engine-Standarddienstkonto die erforderlichen Berechtigungen zum Erstellen eines Managed Service for Apache Spark-Clusters hat:
- Dataproc-Worker (
roles/dataproc.worker) - Cloud Spanner-Datenbank-Nutzer (
roles/spanner.databaseUser) - Cloud Spanner-Datenbankleser mit DataBoost (
roles/spanner.databaseReaderWithDataBoost)
Managed Service for Apache Spark-Cluster einrichten
Erstellen Sie einen Managed Service for Apache Spark-Cluster oder verwenden Sie einen vorhandenen Managed Service for Apache Spark-Cluster, der mit dem 2.1- oder einem neueren Managed Service for Apache Spark-Image erstellt wurde. Wenn der Cluster mit dem 2.0- oder einem älteren Image erstellt wurde, muss er mit der auf cloud-platform-Bereich festgelegten scope-Property erstellt worden sein.
Spanner-Instanz mit einer Datenbanktabelle „Singers“ einrichten
Spanner-Instanz erstellen mit einer Datenbank, die eine Singers-Tabelle enthält. Notieren Sie sich die Spanner-Instanz-ID und die Datenbank-ID.
Spanner-Connector mit Spark verwenden
Der Spanner-Connector ist für Spark-Versionen 3.1+ verfügbar. Sie geben die Connector-Version als Teil der JAR-Datei-Spezifikation des Cloud Storage-Connectors an, wenn Sie einen Job an einen Managed Service for Apache Spark-Cluster senden.
Beispiel: gcloud CLI-Befehl zum Senden eines Spark-Jobs mit dem Spanner-Connector.
gcloud dataproc jobs submit spark \
    --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar \
    ... [other job submission flags]
Ersetzen Sie Folgendes:
CONNECTOR_VERSION: Version des Spanner-Connectors.
Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository GoogleCloudDataproc/spark-spanner-connector aus.
Spanner-Tabellen lesen
Sie können mit Python oder Scala Spanner-Tabellendaten in einen Spark-DataFrame einlesen. Verwenden Sie dazu die Spark-Datenquellen-API.
PySpark
Sie können den Beispiel-PySpark-Code in diesem Abschnitt in Ihrem Cluster ausführen, indem Sie den Job an Managed Service for Apache Spark senden oder den Job über die spark-submit-REPL auf dem Masterknoten des Clusters ausführen.
Managed Service for Apache Spark-Job
- Erstellen Sie eine
singers.py-Datei mit einem lokalen Texteditor oder in Cloud Shell mit dem vorinstallierten Texteditorvi,vimodernano. - Fügen Sie den folgenden Code in die Datei
singers.pyein, nachdem Sie die Platzhaltervariablen ausgefüllt haben. Das Spanner-Feature Data Boost ist aktiviert, was sich kaum auf die Haupt-Spanner-Instanz auswirkt.#!/usr/bin/env python """Spanner PySpark read example.""" from pyspark.sql import SparkSession spark = SparkSession \ .builder \ .master('yarn') \ .appName('spark-spanner-demo') \ .getOrCreate() # Load data from Spanner. singers = spark.read.format('cloud-spanner') \ .option("projectId", "PROJECT_ID") \ .option("instanceId", "INSTANCE_ID") \ .option("databaseId", "DATABASE_ID") \ .option("table", "TABLE_NAME") \ .option("enableDataBoost", "true") \ .load() singers.createOrReplaceTempView('Singers') # Read from Singers result = spark.sql('SELECT * FROM Singers') result.show() result.printSchema()
Ersetzen Sie Folgendes:
- PROJECT_ID: Ihre Cloud de Confiance by S3NS Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Cloud de Confiance Console aufgeführt.
- INSTANCE_ID, DATABASE_ID und TABLE_NAME : Weitere Informationen finden Sie unter Spanner-Instanz mit der Datenbanktabelle
Singerseinrichten.
- Speichern Sie die Datei
singers.py. - Job an Managed Service for Apache Spark senden: Verwenden Sie dazu die Cloud de Confiance Console, die gcloud CLI oder die REST API.
Beispiel:Job mit dem Spanner-Connector über die gcloud CLI einreichen.
gcloud dataproc jobs submit pyspark singers.py \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar
Ersetzen Sie Folgendes:
- CLUSTER_NAME: Der Name des neuen Clusters.
- REGION: Eine verfügbare Compute Engine-Region zum Ausführen des Arbeitslast.
- CONNECTOR_VERSION: Version des Spanner-Connectors.
Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository
GoogleCloudDataproc/spark-spanner-connectoraus.
spark-submit-Job
- Stellen Sie über SSH eine Verbindung zum Clustermaster des Managed Service for Apache Spark-Clusters her.
- Rufen Sie in der Cloud de Confiance Console die Seite Cluster für Managed Service for Apache Spark auf und klicken Sie auf den Namen Ihres Clusters.
- Wählen Sie auf der Seite Clusterdetails den Tab „VM-Instanzen“ aus. Klicken Sie dann rechts neben dem Namen des Clustermasterknotens auf
SSH.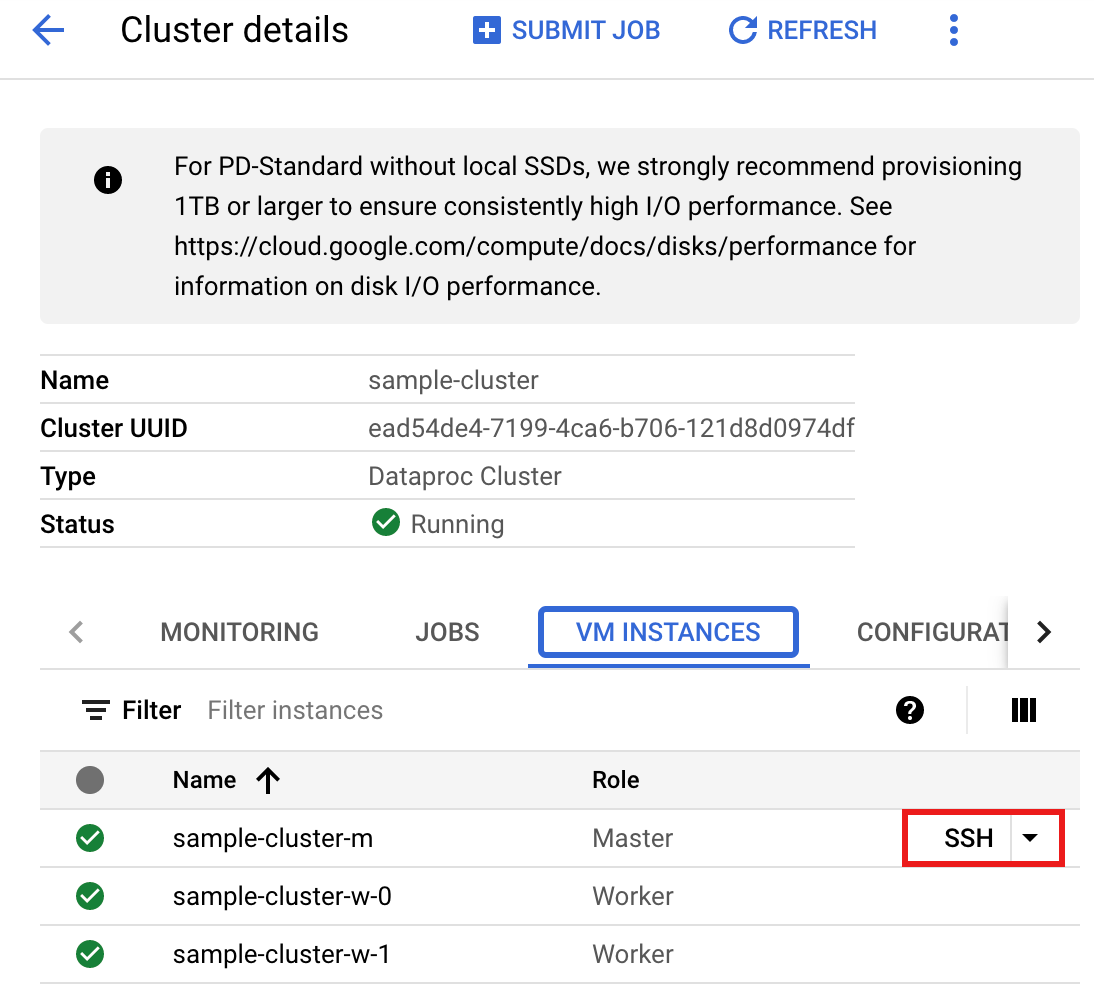
Im Stammverzeichnis des Master-Knotens wird ein Browserfenster geöffnet.
    Connected, host fingerprint: ssh-rsa 2048 ...
    ...
    user@clusterName-m:~$
- Erstellen Sie auf dem Masterknoten eine
singers.py-Datei mit dem vorinstallierten Texteditorvi,vimodernano.- Fügen Sie den folgenden Code in die Datei
singers.pyein, nachdem Sie die Platzhaltervariablen in der Dateisingers.pyausgefüllt haben. Das Spanner-Feature Data Boost ist aktiviert. Es hat praktisch keine Auswirkungen auf die Haupt-Spanner-Instanz.#!/usr/bin/env python """Spanner PySpark read example.""" from pyspark.sql import SparkSession spark = SparkSession \ .builder \ .master('yarn') \ .appName('spark-spanner-demo') \ .getOrCreate() # Load data from Spanner. singers = spark.read.format('cloud-spanner') \ .option("projectId", "PROJECT_ID") \ .option("instanceId", "INSTANCE_ID") \ .option("databaseId", "DATABASE_ID") \ .option("table", "TABLE_NAME") \ .option("enableDataBoost", "true") \ .load() singers.createOrReplaceTempView('Singers') # Read from Singers result = spark.sql('SELECT * FROM Singers') result.show() result.printSchema()
Ersetzen Sie Folgendes:
- PROJECT_ID: Ihre Cloud de Confiance by S3NS Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Cloud de Confiance Console aufgeführt.
- INSTANCE_ID, DATABASE_ID und TABLE_NAME : Weitere Informationen finden Sie unter Spanner-Instanz mit der Datenbanktabelle
Singerseinrichten.
- Speichern Sie die Datei
singers.py.
- Fügen Sie den folgenden Code in die Datei
- Führen Sie
singers.pymitspark-submitaus, um die Spanner-TabelleSingerszu erstellen.spark-submit --jars gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar singers.py
Ersetzen Sie Folgendes:
- CONNECTOR_VERSION: Version des Spanner-Connectors.
Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository
GoogleCloudDataproc/spark-spanner-connectoraus.
Die Ausgabe sieht so aus:
...
+--------+---------+--------+---------+-----------+
|SingerId|FirstName|LastName|BirthDate|LastUpdated|
+--------+---------+--------+---------+-----------+
|       1|     Marc|Richards|     null|       null|
|       2| Catalina|   Smith|     null|       null|
|       3|    Alice| Trentor|     null|       null|
+--------+---------+--------+---------+-----------+

root
 |-- SingerId: long (nullable = false)
 |-- FirstName: string (nullable = true)
 |-- LastName: string (nullable = true)
 |-- BirthDate: date (nullable = true)
 |-- LastUpdated: timestamp (nullable = true)
only showing top 20 rows
- CONNECTOR_VERSION: Version des Spanner-Connectors.
Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository
Scala
Führen Sie die folgenden Schritte aus, um den Beispiel-Scala-Code in Ihrem Cluster auszuführen:
- Stellen Sie über SSH eine Verbindung zum Clustermaster des Managed Service for Apache Spark-Clusters her.
- Rufen Sie in der Cloud de Confiance Console die Seite Cluster für Managed Service for Apache Spark auf und klicken Sie auf den Namen Ihres Clusters.
- Wählen Sie auf der Seite Clusterdetails den Tab „VM-Instanzen“ aus. Klicken Sie dann rechts neben dem Namen des Clustermasterknotens auf
SSH.
Im Stammverzeichnis des Master-Knotens wird ein Browserfenster geöffnet.
    Connected, host fingerprint: ssh-rsa 2048 ...
    ...
    user@clusterName-m:~$
- Erstellen Sie auf dem Masterknoten eine
singers.scala-Datei mit dem vorinstallierten Texteditorvi,vimodernano.- Fügen Sie den folgenden Code in die Datei
singers.scalaein. Das Spanner-Feature Data Boost ist aktiviert. Es hat praktisch keine Auswirkungen auf die Haupt-Spanner-Instanz.object singers { def main(): Unit = { /* * Uncomment (use the following code) if you are not running in spark-shell. * import org.apache.spark.sql.SparkSession val spark = SparkSession.builder() .appName("spark-spanner-demo") .getOrCreate() */ // Load data in from Spanner. See // https://github.com/GoogleCloudDataproc/spark-spanner-connector/blob/main/README.md#properties // for option information. val singersDF = (spark.read.format("cloud-spanner") .option("projectId", "PROJECT_ID") .option("instanceId", "INSTANCE_ID") .option("databaseId", "DATABASE_ID") .option("table", "TABLE_NAME") .option("enableDataBoost", true) .load() .cache()) singersDF.createOrReplaceTempView("Singers") // Load the Singers table. val result = spark.sql("SELECT * FROM Singers") result.show() result.printSchema() } }
Ersetzen Sie Folgendes:
- PROJECT_ID: Ihre Cloud de Confiance by S3NS Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Cloud de Confiance Console aufgeführt.
- INSTANCE_ID, DATABASE_ID und TABLE_NAME : Weitere Informationen finden Sie unter Spanner-Instanz mit der Datenbanktabelle
Singerseinrichten.
- Speichern Sie die Datei
singers.scala.
- Fügen Sie den folgenden Code in die Datei
- Starten Sie die
spark-shell-REPL.$ spark-shell --jars=gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar
Ersetzen Sie Folgendes:
CONNECTOR_VERSION: Version des Spanner-Connectors. Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository
GoogleCloudDataproc/spark-spanner-connectoraus. - Führen Sie
singers.scalamit dem Befehl:load singers.scalaaus, um die Spanner-TabelleSingerszu erstellen. Die Ausgabeliste enthält Beispiele aus der Ausgabe von Singers.> :load singers.scala Loading singers.scala... defined object singers > singers.main() ... +--------+---------+--------+---------+-----------+ |SingerId|FirstName|LastName|BirthDate|LastUpdated| +--------+---------+--------+---------+-----------+ | 1| Marc|Richards| null| null| | 2| Catalina| Smith| null| null| | 3| Alice| Trentor| null| null| +--------+---------+--------+---------+-----------+ root |-- SingerId: long (nullable = false) |-- FirstName: string (nullable = true) |-- LastName: string (nullable = true) |-- BirthDate: date (nullable = true) |-- LastUpdated: timestamp (nullable = true)
Spanner-Diagramme lesen
Der Spanner-Connector unterstützt den Export des Graphen in separate Knoten- und Kanten-DataFrames sowie den direkten Export in GraphFrames.
Im folgenden Beispiel wird eine Spanner-Instanz in eine GraphFrame exportiert. Dazu wird die Python-Klasse SpannerGraphConnector verwendet, die in der JAR-Datei des Spanner-Connectors enthalten ist, um den Spanner Graph zu lesen.
from pyspark.sql import SparkSession

connector_jar = "gs://spark-lib/spanner/spark-3.1-spanner-CONNECTOR_VERSION.jar"

spark = (SparkSession.builder.appName("spanner-graphframe-graphx-example")
         .config("spark.jars.packages", "graphframes:graphframes:0.8.4-spark3.5-s_2.12")
         .config("spark.jars", connector_jar)
         .getOrCreate())
spark.sparkContext.addPyFile(connector_jar)

from spannergraph import SpannerGraphConnector

connector = (SpannerGraphConnector()
             .spark(spark)
             .project("PROJECT_ID")
             .instance("INSTANCE_ID")
             .database("DATABASE_ID")
             .graph("GRAPH_ID"))

g = connector.load_graph()
g.vertices.show()
g.edges.show()
Ersetzen Sie Folgendes:
- CONNECTOR_VERSION: Version des Spanner-Connectors.
Wählen Sie die Spanner-Connector-Version aus der Versionsliste im GitHub-Repository
GoogleCloudDataproc/spark-spanner-connectoraus. - PROJECT_ID: Ihre Cloud de Confiance by S3NS Projekt-ID Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Cloud de Confiance Console aufgeführt.
- INSTANCE_ID, DATABASE_ID und TABLE_NAME: Fügen Sie die Instanz-, Datenbank- und Diagramm-IDs ein.
Wenn Sie Knoten und Kanten DataFrames anstelle von GraphFrames exportieren möchten, verwenden Sie stattdessen load_dfs:
df_vertices, df_edges, df_id_map = connector.load_dfs()
Spanner-Tabellen schreiben
Der Spanner-Connector unterstützt das Schreiben eines Spark-DataFrames in eine Spanner-Tabelle mithilfe der Spark-Datenquellen-API.
Beispiel für das Schreiben eines DataFrames in eine Spanner-Tabelle
Füllen Sie die Variablen aus, bevor Sie den Code speichern und ausführen.
"""Spanner PySpark write example."""
from pyspark.sql import SparkSession

spark = SparkSession.builder.appName('Spanner Write App').getOrCreate()

columns = ['id', 'name', 'email']
data = [(1, 'John Doe', 'john.doe@example.com'), (2, 'Jane Doe', 'jane.doe@example.com')]
df = spark.createDataFrame(data, columns)

df.write.format('cloud-spanner') \
    .option("projectId", "PROJECT_ID")
    .option("instanceId", "INSTANCE_ID")
    .option("databaseId", "DATABASE_ID")
    .option("table", "TABLE_NAME")
    .mode("append") \
    .save()
Ersetzen Sie Folgendes.
- PROJECT_ID: Die Cloud de Confiance by S3NS Projekt-ID. Projekt-IDs werden im Bereich Projektinformationen im Dashboard der Cloud de Confiance Console aufgeführt.
- INSTANCE_ID, DATABASE_ID und TABLE_NAME: Fügen Sie die Instanz-, Datenbank- und Tabellen-IDs ein.
Bereinigen
Damit Ihrem Cloud de Confiance by S3NS -Konto keine laufenden Gebühren in Rechnung gestellt werden, können Sie Ihren Managed Service for Apache Spark-Cluster beenden oder löschen und Ihre Spanner-Instanz löschen.
Nächste Schritte
pyspark.sql.DataFrame-Beispiele- Informationen zur Sprachunterstützung für Spark DataFrames finden Sie unter:
- Weitere Informationen finden Sie im Spark Spanner Connector-Repository auf GitHub.
- Tipps zur Feinabstimmung von Spark-Jobs