

Mit Objektkontext-Anreicherungen können Sie automatisch strukturierte Metadaten generieren, ohne benutzerdefinierte Pipelines für maschinelles Lernen erstellen zu müssen. Bei der Objektkontext-Anreicherung werden die vortrainierten Machine-Learning-Modelle von Google direkt auf Ihre gespeicherten Objekte angewendet. So können Sie Ihre unstrukturierten Daten in großem Umfang suchen, kuratieren und verwalten.
Informationen zum Generieren von Metadaten für Ihre Objekte finden Sie unter Objektkontext-Anreicherungen konfigurieren.
Funktionsweise
Wenn Sie die Objektkontext-Anreicherung verwenden möchten, arbeiten Sie mit den folgenden Teilen des Systems:
- Featurekonfiguration (
FeatureConfig): Sie erstellen eine Featurekonfiguration, um anzugeben, welche Buckets oder Projekte von Cloud Storage überwacht werden. - Modelle für maschinelles Lernen: In Ihrer Konfiguration wählen Sie die Modelle aus, die Sie anwenden möchten, z. B. Modelle, die Objekte erkennen, Bilder mit Labels versehen, Gesichter analysieren oder PDF-Dokumente kategorisieren.
- Objektkontext-Anreicherung (Metadaten): Cloud Storage scannt Ihre Objekte asynchron und wertet geeignete Objekte mit den von Ihnen ausgewählten Modellen aus. Cloud Storage hängt die resultierenden Metadaten dann als Objektkontexte direkt an Ihre Objekte an.
Nachdem Cloud Storage die Anreicherungsmetadaten an Ihre Objekte angehängt hat, können die Metadaten verwendet werden. Sie können einzelne Objektkontext-Anreicherungen prüfen oder Storage Insights-Datasets verwenden, um Metadaten für Millionen von Objekten mit SQL in BigQuery zu analysieren.
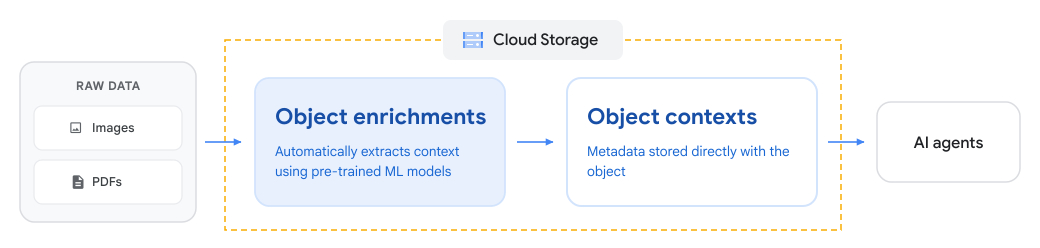
Das folgende Diagramm zeigt, wie Cloud Storage Objektkontext-Anreicherungen verwendet, um Kontext aus unstrukturierten Daten zu extrahieren und als Objektkontexte für nachgelagerte KI- und Analyse-Workflows zu speichern:
Unterstützte Modelle
Wenn Sie eine Featurekonfiguration erstellen, wählen Sie die Machine-Learning-Modelle aus, die am besten zu Ihren Daten und Analysezielen passen. Cloud Storage wertet geeignete Objekte mithilfe der von Ihnen ausgewählten Modelle aus und generiert strukturierte Metadaten unter contexts.custom.
In der Tabelle der unterstützten Modelle sind die einzelnen Modelle, die erkannten Elemente und Beispielausgabedaten aufgeführt. Detaillierte Schemadefinitionen und Kontextschlüssel finden Sie unter Unterstützte Modelle und Schemas.
| Modell | Beschreibung | Beispielausgabedaten |
|---|---|---|
| Objekterkennung | Erkennt mehrere Objekte in einem Bild und liefert ihre Positionen und rechteckigen Begrenzungen. | Produkt, Tier, Person |
| Bild-Labeling | Erkennt und extrahiert Informationen zu Entitäten in einem Bild aus einer Vielzahl von Kategorien, z. B. Objekte, Orte und Aktivitäten. | Landschaft, Stadt, Nacht |
| Gesichtserkennung | Erkennt Gesichter in Bildern, einschließlich Begrenzungspolygonen, Gesichtsmerkmalen (Augen, Nase, Mund), Ausrichtungswinkeln und Wahrscheinlichkeiten für Gesichtsausdrücke. | Anzahl der Gesichter, Roll- und Neigungswinkel |
| Erkennung anstößiger Inhalte | Bewertet Bilder auf sensible oder unangemessene Inhalte, einschließlich nicht jugendfreier oder gewaltverherrlichender Inhalte. | Wahrscheinlichkeitsbewertungen für Inhalte nur für Erwachsene und gewaltverherrlichende Inhalte |
| PDF-Klassifizierung | Klassifiziert PDF-Dokumente anhand ihres Inhalts in Standardgeschäfts- und Branchenkategorien. | Finanzen, Steuern, Rechnung (Kategorien und Punktzahlen) |
Anwendungsfälle
Mit der Objektkontext-Anreicherung können Sie die Verwaltung unstrukturierter Daten optimieren und Objekte für die folgenden nachgelagerten Analyse- und KI-Workflows vorbereiten:
- Unorganisierte Objekte organisieren und katalogisieren: Sammlungen von PDF-Dokumenten (z. B. Rechnungen, Kontoauszüge und Steuerformulare) und Bildern automatisch klassifizieren. Sie können diese Klassifizierungen verwenden, um durchsuchbare Data Catalogs für Ihre Buckets zu erstellen, ohne benutzerdefinierten Code schreiben zu müssen.
- KI-Agenten fundieren und die Suche verbessern: Unorganisierte Dokument-Repositories in strukturierte Wissensdatenbanken umwandeln. Sie können Dokumentkategorien und Bildlabels verwenden, um den Abruf während der Retrieval-Augmented Generation (RAG) zu verbessern und Ihre generativen KI-Anwendungen zu fundieren.
- Daten für generative KI stichprobenartig erfassen und vorbereiten: Unterscheiden Sie zwischen Dokumenttypen, um eine geschichtete Stichprobenerhebung durchzuführen, bevor Sie Inhalte an Large Language Models (LLMs) oder zur manuellen Überprüfung weiterleiten.
- Trainings-Datasets für maschinelles Lernen kuratieren: Filtern und segmentieren Sie Bilder und Dokumente nach Taxonomie oder visuellen Labels, um domänenspezifische Trainings-Datasets für die Feinabstimmung von Modellen zusammenzustellen.
- Auf sensible oder anstößige Inhalte prüfen: Hochgeladene Bilder werden automatisch auf unangemessene Inhalte geprüft, um Ihre Richtlinien zur Inhaltsmoderation und Sicherheit zu unterstützen.
- Multimodale Prompts verbessern: Übergeben Sie strukturierte Metadaten wie Begrenzungsrahmen und Dokumentkategorien als Kontext, wenn Sie multimodale Modelle wie Gemini prompten.
- Datenarchitekturen vereinfachen: Benutzerdefinierte Aufnahme-Pipelines und Computing-Infrastruktur eliminieren, indem Metadaten direkt in Cloud Storage generiert werden.
Metadaten abfragen und analysieren
Cloud Storage hängt Objektkontext-Anreicherungen direkt als Objektkontexte an Ihre Objekte an. Je nach Umfang und Workflow können Sie auf diese Metadaten so zugreifen und sie analysieren:
- Einzelne Objekte prüfen: Verwenden Sie die Cloud de Confiance Console oder die Cloud Storage APIs, um Anreicherungen für bestimmte Objekte zu prüfen. Eine Anleitung finden Sie unter Objektkontext-Anreicherungen verwalten.
- Mit SQL im großen Maßstab analysieren: Verwenden Sie Storage Insights-Datasets, um Metadaten von Millionen oder Milliarden von Objekten direkt in BigQuery zu exportieren. Nachdem Storage Insights die Metadaten exportiert hat, können Sie die Ansicht
object_contexts_catalog_viewmit Standard-SQL abfragen. Sie können beispielsweise nach Labels suchen, nach Kategorie filtern oder Objekte mit hohen Konfidenzwerten finden.
Informationen zu SQL-Abfragen und Beispielrezepten finden Sie unter Objektkontext-Anreicherungen in BigQuery analysieren.
Überlegungen und Einschränkungen
Bevor Sie die Objektkontext-Anreicherung konfigurieren, sollten Sie die folgenden betrieblichen Aspekte berücksichtigen:
Verarbeitungsstandort
Bei der Objektkontext-Anreicherung werden Daten an drei geografischen Standorten verarbeitet: us, eu und asia. Beachten Sie bei der Auswahl eines Verarbeitungsstandorts Folgendes:
- Compliance: Achten Sie darauf, dass der ausgewählte Verarbeitungsstandort Ihren regulatorischen Anforderungen und Anforderungen an die Datenhoheit entspricht.
- Leistung: Wählen Sie den Verarbeitungsstandort aus, der der Speicherregion Ihres Buckets am nächsten liegt.
- Kosten: Konfigurieren Sie für jeden Bucket und jedes Modell nur einen Verarbeitungsstandort, um doppelte Gebühren zu vermeiden. Wenn Sie mehrere Standorte für denselben Bucket und dasselbe Modell konfigurieren, verarbeitet Cloud Storage Ihre Objekte an jedem Standort und stellt Ihnen jeden Durchlauf in Rechnung.
Verarbeitung und Leistung
Beachten Sie die folgenden Einschränkungen für Inhaltstypen, Objektgrößen und Verarbeitungszeiten:
Asynchrone Verarbeitung: Cloud Storage verarbeitet Objekte asynchron.
Maximale Objektgröße: Objekte (sowohl Bilder als auch PDFs) dürfen maximal 20 MiB groß sein.
Unterstützte Inhaltstypen: Cloud Storage verwendet das Metadatenfeld
Content-Type, das für ein Objekt festgelegt ist, um zu bestimmen, ob es ausgewertet werden soll. Wenn ein Objekt einen ungültigen oder fehlendenContent-Type-Wert hat, verarbeitet Cloud Storage das Objekt nicht, auch wenn die zugrunde liegenden Daten ein gültiges Bild oder eine gültige PDF-Datei sind. Damit Cloud Storage das Objekt verarbeitet, aktualisieren Sie dieContent-Type-Metadaten auf einen der folgenden unterstützten Typen:- Bilder: BMP, GIF, ICO, JPEG, PNG, TIFF und WEBP.
- Dokumente: PDF (
application/pdf).
Nicht unterstützte Funktionen
Die Objektkontext-Anreicherung ist mit den folgenden Bucket-Typen und -Vorgängen nicht kompatibel:
- Verschieben von Buckets: Objektkontext-Anreicherungen sind nicht mit dem Verschieben von Buckets kompatibel. Entfernen Sie den Bucket aus Ihren Featurekonfigurationen, bevor Sie ihn verschieben.
- Nicht unterstützte Bucket-Typen: Sie können die Objektkontext-Anreicherung nicht für Rapid-Buckets oder Buckets mit aktiviertem hierarchischen Namespace aktivieren.
Konfigurations- und Bereichsverwaltung
Wenn Sie Ziel-Buckets in Ihren Featurekonfigurationen definieren und verwalten, gelten die folgenden Anforderungen:
- Bucket-Bereich: Geben Sie in der Featurekonfiguration genaue Bucket-Namen an. Cloud Storage unterstützt keine regulären Ausdrücke oder Platzhaltermuster.
- Bucket-Lebenszyklus: Cloud Storage fügt neu erstellte, neu erstellte oder verschobene Buckets nicht automatisch vorhandenen Konfigurationen hinzu. Sie müssen Ihre Featurekonfiguration aktualisieren, um diese Buckets einzuschließen.
Kosten und Sicherheit
Beachten Sie die folgenden betrieblichen Details zu Verschlüsselungsschlüsseln und Gebühren für den Datenzugriff:
- Vom Kunden bereitgestellte Schlüssel (CSEK): Die Objektkontext-Anreicherung unterstützt keine Objekte, die mit vom Kunden bereitgestellten Verschlüsselungsschlüsseln verschlüsselt wurden.
- Speicherzugriff und Autoclass: Zum Generieren von Metadaten werden Ihre Objektdaten von der Objektkontext-Anreicherung gelesen. Für diese Lesevorgänge fallen die Standardgebühren für den Datenzugriff an. Wenn Autoclass für Ihren Bucket aktiviert ist, lösen diese Lesevorgänge außerdem Speicherklassenübergänge aus.
Preise
Für die Verwendung von Objektkontext-Anreicherungen fallen Gebühren für Modellinferenz, Metadatenspeicherung, Datenzugriffsvorgänge und Netzwerknutzung an. Weitere Informationen finden Sie unter Preise.
Überwachen und Fehler beheben
Verwenden Sie die folgenden Ressourcen, um den Fortschritt der Metadatengenerierung zu verfolgen und Probleme bei der Konfiguration von Objektkontext-Anreicherungen zu beheben:
- Vorgänge überwachen: Informationen zum Verfolgen ausstehender Objekte, der Anzahl der Modellausführungen und des Verarbeitungsstatus in Cloud Monitoring finden Sie unter Messwerte zur Objektkontext-Anreicherung überwachen.
- Probleme beheben: Wenn Anreicherungen fehlen oder Berechtigungsfehler auftreten, finden Sie weitere Informationen unter Fehlerbehebung bei Objektkontext-Anreicherungen.