

חיזוי סדרות זמנים היררכיות באמצעות מודל ARIMA_PLUS עם משתנה יחיד
במדריך הזה תלמדו איך להשתמש במודל סדרת זמנים עם משתנה יחיד של ARIMA_PLUS כדי לחזות סדרת זמנים היררכית. היא חוזה את הערך העתידי של עמודה נתונה, על סמך הערכים ההיסטוריים של אותה עמודה, וגם מחשבת ערכים מסוכמים של אותה עמודה למאפיין אחד או יותר.
ערכי החיזוי מחושבים לכל נקודת זמן, לכל ערך בעמודה אחת או יותר שמציינות את המאפיינים הרלוונטיים. לדוגמה, אם רוצים לחזות אירועי תנועה יומיים ומציינים עמודת מאפיין שמכילה נתוני מדינה, נתוני החיזוי יכילו ערכים לכל יום במדינה א', ערכים לכל יום במדינה ב' וכן הלאה. אם אתם רוצים לחזות אירועי תנועה יומיים וציינתם עמודות של מאפיינים שמכילות נתונים של מדינה ועיר, נתוני החיזוי יכילו ערכים לכל יום במדינה א' ובעיר א', ואז ערכים לכל יום במדינה א' ובעיר ב' וכן הלאה. במודלים של סדרות זמן היררכיות, התאמה היררכית משמשת כדי לצבור ולהתאים כל סדרת זמן צאצא עם ההורה שלה. לדוגמה, סכום הערכים החזויים של כל הערים במדינה א' חייב להיות שווה לערך החזוי של מדינה א'.
במדריך הזה תיצרו שני מודלים של סדרות זמנים על אותם נתונים, אחד שמשתמש בתחזיות היררכיות ואחד שלא. כך אפשר להשוות בין התוצאות שהמודלים מחזירים.
במדריך הזה משתמשים בנתונים מהטבלה הציבורית bigquery-public-data.iowa_liquor.sales.sales. הטבלה הזו מכילה מידע על יותר ממיליון מוצרי אלכוהול בחנויות שונות, על סמך נתוני מכירות ציבוריים של אלכוהול באיווה.
לפני שקוראים את המדריך הזה, מומלץ מאוד לקרוא את המאמר חיזוי של כמה סדרות זמנים באמצעות מודל חד-משתני.
ההרשאות הנדרשות
כדי ליצור את קבוצת הנתונים, אתם צריכים את ההרשאה
bigquery.datasets.createב-IAM.כדי ליצור את המודל, צריך את ההרשאות הבאות:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateData
כדי להריץ הסקה, צריך את ההרשאות הבאות:
bigquery.models.getDatabigquery.jobs.create
במאמר מבוא ל-IAM תוכלו לקרוא מידע נוסף על התפקידים וההרשאות של IAM ב-BigQuery.
מטרות
במדריך הזה תשתמשו בכלים הבאים:
- יצירת מודל של סדרת זמנים מרובה ומודל של סדרת זמנים היררכית מרובה כדי לחזות את ערכי המכירות של בקבוקים באמצעות ההצהרה
CREATE MODEL. - אחזור ערכי התחזית של מכירות הבקבוקים מהמודלים באמצעות הפונקציה
ML.FORECAST.
עלויות
במדריך הזה משתמשים ברכיבים של Cloud de Confiance by S3NSשהשימוש בהם כרוך בתשלום, כולל:
- BigQuery
- BigQuery ML
למידע נוסף על העלויות של BigQuery, קראו את הדף תמחור ב-BigQuery.
כאן תוכלו לקרוא מידע נוסף על העלויות של BigQuery ML.
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
- BigQuery מופעל באופן אוטומטי בפרויקטים חדשים.
כדי להפעיל את BigQuery בפרויקט קיים, עוברים אל
מפעילים את BigQuery API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם אתם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, אתם יכולים לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים?
יצירת קבוצת נתונים
כדי ליצור מערך נתונים ב-BigQuery, בוחרים אחת מהאפשרויות הבאות:
המסוף
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בחלונית הימנית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על Expand left pane כדי לפתוח אותה.
ב-Explorer, מרחיבים את הפרויקט ולוחצים על Datasets.
בדף Datasets, לוחצים על Create dataset.
בחלונית Create dataset:
בשדה Dataset ID, מזינים
bqml_tutorial.בקטע Data location (מיקום הנתונים), בוחרים באפשרות US (ארה"ב).
משאירים את שאר הגדרות ברירת המחדל כמו שהן.
לוחצים על Create dataset.
BQ
כדי ליצור קבוצת נתונים חדשה, משתמשים בפקודה bq mk --dataset.
יוצרים מערך נתונים בשם
bqml_tutorialומגדירים את מיקום הנתונים ל-US:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
מוודאים שמערך הנתונים נוצר:
bq ls
API
מפעילים את השיטה datasets.insert עם משאב של מערך נתונים מוגדר:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
יצירת מודל של סדרת זמנים
יצירת מודל של סדרת זמנים באמצעות נתוני המכירות של משקאות חריפים באיווה.
שאילתת GoogleSQL הבאה יוצרת מודל שחוזה את המספר הכולל של בקבוקים שנמכרו ביום בשנת 2015 במחוזות פולק, לין וסקוט.
בשאילתה הבאה, הסעיף OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...) מציין שאתם יוצרים מודל של סדרת זמנים שמבוסס על ARIMA. משתמשים באפשרות TIME_SERIES_ID של ההצהרה CREATE MODEL כדי לציין עמודה אחת או יותר בנתוני הקלט שעבורם רוצים לקבל תחזיות. האפשרות auto_arima_max_order של ההצהרה CREATE MODEL קובעת את מרחב החיפוש לכוונון של היפר-פרמטרים באלגוריתם auto.ARIMA. האפשרות decompose_time_series של ההצהרה CREATE MODEL מוגדרת כברירת מחדל ל-TRUE, כך שמידע על נתוני סדרת הזמנים מוחזר כשמעריכים את המודל בשלב הבא.
הסעיף OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...) מציין שאתם יוצרים מודל של סדרת זמנים שמבוסס על ARIMA. כברירת מחדל,
auto_arima=TRUE,
כך שהאלגוריתם של auto.ARIMA מכוונן באופן אוטומטי את ההיפר-פרמטרים במודלים של
ARIMA_PLUS. האלגוריתם מתאים עשרות מודלים מועמדים ובוחר את המודל הטוב ביותר, שהוא המודל עם קריטריון המידע של אקאיקה (AIC) הנמוך ביותר.
אם יש דפוסים של חגים בארה"ב בסדרת הזמן, הגדרת US באפשרות holiday_region מאפשרת ליצור מודל מדויק יותר בנקודות הזמן של החגים האלה.
כדי ליצור את המודל:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
השאילתה מסתיימת תוך כ-37 שניות, ואז אפשר לגשת למודל
liquor_forecast. בגלל שהשאילתה משתמשת בהצהרהCREATE MODELכדי ליצור מודל, אין תוצאות לשאילתה.
שימוש במודל לחיזוי נתונים
חיזוי ערכים עתידיים של סדרות זמנים באמצעות הפונקציה ML.FORECAST.
בשאילתה הבאה, הסעיף STRUCT(20 AS horizon, 0.8 AS confidence_level) מציין שהשאילתה חוזה 20 נקודות זמן עתידיות, ויוצרת מרווח חיזוי עם רמת סמך של 80%.
כדי לחזות נתונים באמצעות המודל, פועלים לפי השלבים הבאים:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast`,
    STRUCT(20 AS horizon, 0.8 AS confidence_level))
ORDER BY store_number, county, city, zip_code, forecast_timestamp;
התוצאות אמורות להיראות כך:
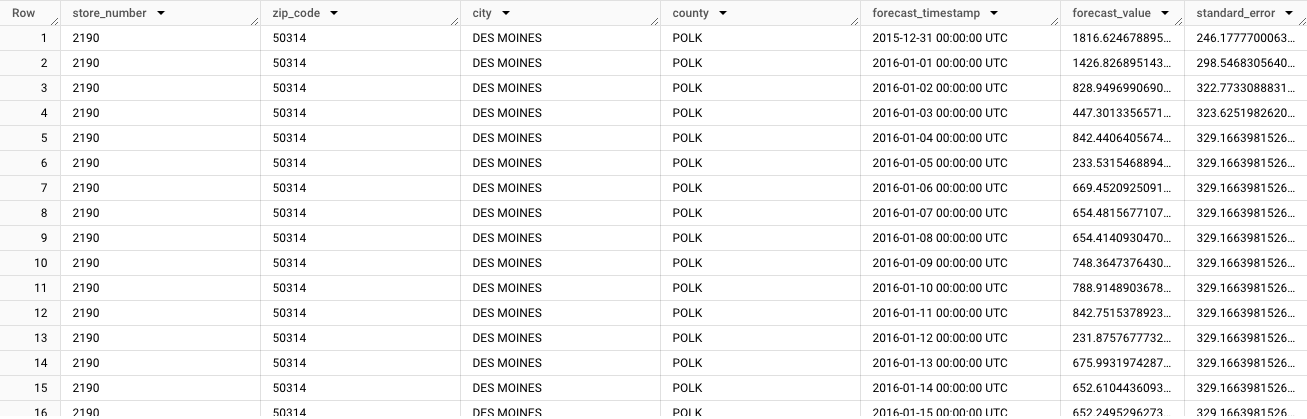
הפלט מתחיל בנתוני התחזית של סדרת הזמנים הראשונה:
store_number=2190,zip_code=50314,city=DES MOINES,county=POLK. כשגוללים בנתונים, רואים את התחזיות לכל סדרה ייחודית של עמודות זמן. כדי ליצור תחזיות שמצטברות לסכומים כוללים של מאפיינים שונים, כמו תחזיות למחוז ספציפי, צריך ליצור תחזית היררכית.
יצירת מודל היררכי של סדרת זמנים
יצירת תחזית היררכית של סדרת זמנים, באמצעות נתוני המכירות של משקאות חריפים באיווה.
שאילתת GoogleSQL הבאה יוצרת מודל שמפיק תחזיות היררכיות למספר הכולל של בקבוקים שנמכרו ביום בשנת 2015 במחוזות פולק, לין וסקוט.
בשאילתה הבאה, האפשרות HIERARCHICAL_TIME_SERIES_COLS בהצהרה CREATE MODEL מציינת שאתם יוצרים תחזית היררכית על סמך קבוצת עמודות שאתם מציינים. כל אחת מהעמודות האלה מסוכמת ומצטברת. לדוגמה, בשאילתה הקודמת, המשמעות היא שהערך בעמודה store_number נאסף כדי להציג תחזיות לכל ערך של county, city ו-zip_code. בנפרד, הערכים של zip_code ו-store_number נאספים גם כדי להציג תחזיות לכל ערך של county ו-city.
סדר העמודות חשוב כי הוא מגדיר את מבנה ההיררכיה.
כדי ליצור את המודל:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast_hierarchical`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HIERARCHICAL_TIME_SERIES_COLS = ['zip_code', 'store_number'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
השאילתה מסתיימת תוך כ-45 שניות, ואז אפשר לגשת למודל
bqml_tutorial.liquor_forecast_hierarchicalבחלונית Explorer. בגלל שהשאילתה משתמשת בהצהרתCREATE MODELכדי ליצור מודל, אין תוצאות לשאילתה.
שימוש במודל היררכיה כדי לחזות נתונים
אחזור של נתוני התחזית ההיררכית מהמודל באמצעות הפונקציה ML.FORECAST.
כדי לחזות נתונים באמצעות המודל, פועלים לפי השלבים הבאים:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מדביקים את השאילתה הבאה ולוחצים על Run:
SELECT
  *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast_hierarchical`,
    STRUCT(30 AS horizon, 0.8 AS confidence_level))
WHERE city = 'LECLAIRE'
ORDER BY county, city, zip_code, store_number, forecast_timestamp;
התוצאות אמורות להיראות כך:
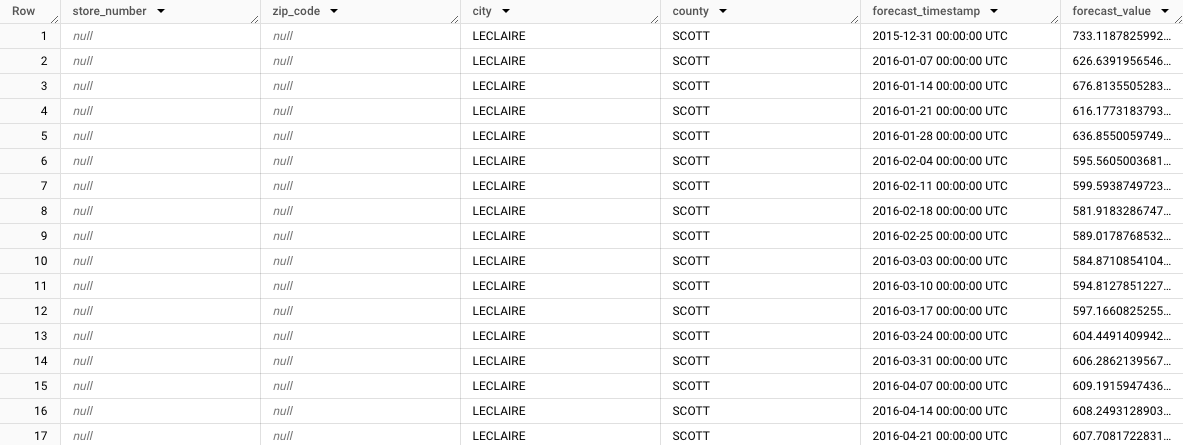
שימו לב איך התחזית המצטברת מוצגת לעיר LeClaire,
store_number=NULL,zip_code=NULL,city=LECLAIRE,county=SCOTT. כשמסתכלים על שאר השורות, אפשר לראות את התחזיות של קבוצות המשנה האחרות. לדוגמה, בתמונה הבאה מוצגות התחזיות המצטברות למיקוד52753,store_number=NULL,zip_code=52753,city=LECLAIRE,county=SCOTT:
הסרת המשאבים
כדי להימנע מצבירת חיובים בחשבון Cloud de Confiance by S3NS על המשאבים שבהם השתמשתם במדריך הזה, אתם יכולים למחוק את הפרויקט שמכיל את המשאבים, או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
- אתם יכולים למחוק את הפרויקט שיצרתם.
- אפשר גם להשאיר את הפרויקט ולמחוק את מערך הנתונים.
מחיקת מערך הנתונים
מחיקת הפרויקט תסיר את כל מערכי הנתונים ואת כל הטבלאות בפרויקט. אם אתם מעדיפים להשתמש שוב בפרויקט, אתם יכולים למחוק את קבוצת הנתונים שיצרתם במדריך הזה:
אם צריך, פותחים את הדף של BigQuery במסוףCloud de Confiance .
בניווט, לוחצים על מערך הנתונים bqml_tutorial שיצרתם.
לוחצים על מחיקת מערך הנתונים בצד שמאל של החלון. הפעולה הזו מוחקת את מערך הנתונים, את הטבלה ואת כל הנתונים.
בתיבת הדו-שיח Delete dataset, מאשרים את פקודת המחיקה על ידי הקלדת שם מערך הנתונים (
bqml_tutorial) ולוחצים על Delete.
מחיקת הפרויקט
כדי למחוק את הפרויקט:
- במסוף Cloud de Confiance , נכנסים לדף Manage resources.
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
המאמרים הבאים
- איך יוצרים תחזית של סדרת זמנים אחת באמצעות מודל חד-משתני
- איך יוצרים תחזית של כמה סדרות זמנים באמצעות מודל חד-משתני
- איך משנים את קנה המידה של מודל חד-משתני כשיוצרים תחזית של כמה סדרות זמנים על פני שורות רבות
- איך יוצרים תחזית של סדרת זמנים אחת באמצעות מודל רב-משתני
- לסקירה כללית על BigQuery ML, קראו את המאמר מבוא ל-AI ול-ML ב-BigQuery.