

分群資料表簡介
BigQuery 中的分群資料表會根據使用者定義的分群資料欄中的值,排序儲存區塊中的資料。分群可提升查詢效能並降低成本,因為依分群資料欄篩選或匯總的查詢只會掃描相關區塊,而非整個資料表或分區。
由於要掃描的區塊數量在查詢執行前未知,因此您在執行前無法取得準確的費用估算。分群也不保證能減少查詢資料表所需的運算單元。
分群法運作方式
在 BigQuery 中,「分群資料欄」是使用者定義的資料表屬性,可根據分群資料欄中的值,排序儲存區塊。儲存區塊會根據資料表大小調整。共置發生在儲存區塊層級,而非個別資料列層級。如要進一步瞭解此情境中的共置,請參閱「叢集」。
分群資料表會在每次修改作業中,維持排序屬性。如果查詢依分群資料欄篩選或匯總,則只會根據分群資料欄掃描相關區塊,而非整個資料表或資料表分區。因此,BigQuery 可能無法準確估算查詢要處理的位元組數或查詢費用,但會嘗試減少執行時的總位元組數。
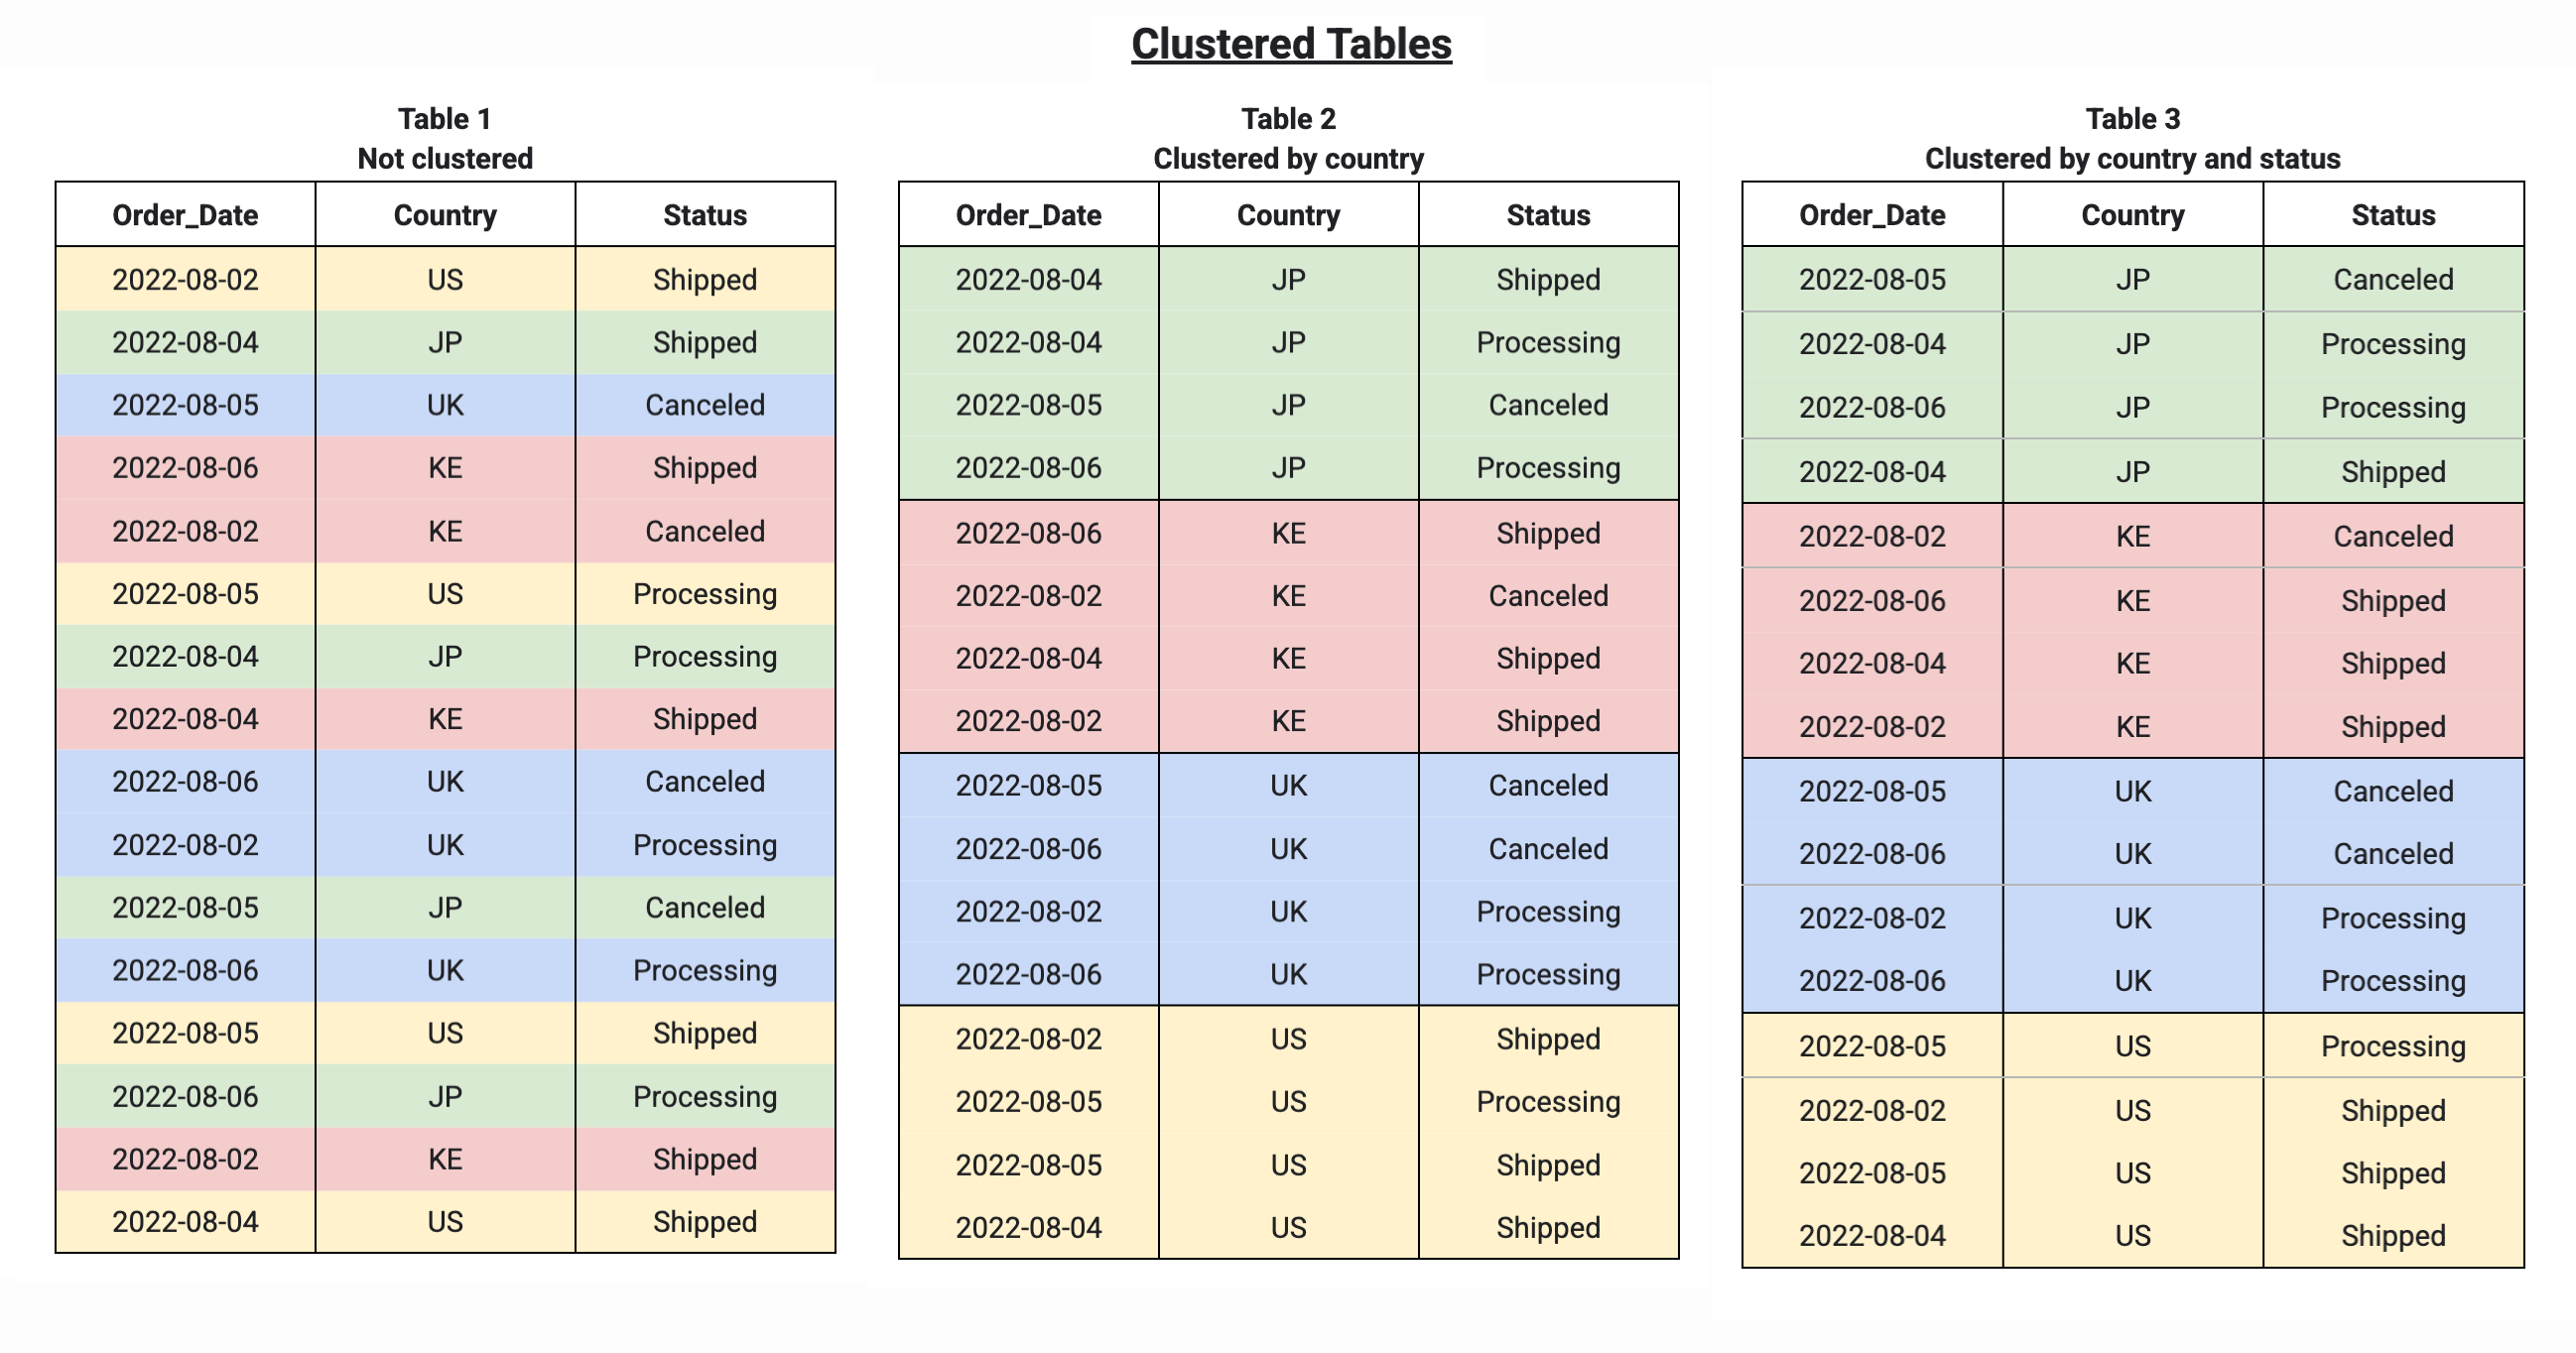
使用多個資料欄將資料表分群時,資料欄順序會決定 BigQuery 將資料排序並分組至儲存區塊時,哪些資料欄優先,如以下範例所示。表 1 顯示非叢集資料表的邏輯儲存區塊版面配置。相較之下,資料表 2 僅依 Country 資料欄分群,而資料表 3 則依多個資料欄 (Country 和 Status) 分群。
使用叢集處理的時機
分群會影響資料表的儲存方式,因此通常是提升查詢效能的首選。因此,請務必考量叢集功能,因為這項功能具有下列優點:
- 如果未分區資料表大於 64 MB,叢集可能會有幫助。同樣地,大於 64 MB 的資料表分區也可能受益於分群。雖然可以對較小的資料表或分區進行分群,但效能提升通常微不足道。
- 如果查詢通常會篩選特定資料欄,叢集會加快查詢速度,因為查詢只會掃描符合篩選條件的區塊。
- 如果查詢篩選的資料欄有許多不同的值 (高基數),分群功能會提供 BigQuery 詳細的中繼資料,指出輸入資料的來源,進而加快查詢速度。
- 分群功能可讓資料表的基礎儲存空間區塊,根據資料表的大小自動調整大小。
除了分群之外,您也可以考慮分區資料表。在這個方法中,您會先將資料分割成多個分區,然後依據分群欄將每個分區中的資料分群。在下列情況下,建議您採用這個方法:
- 執行查詢前,您需要嚴格的查詢費用估算。分群資料表的查詢費用只能在查詢執行後決定。分區功能可讓您在執行查詢前,取得精細的查詢費用估算值。
- 資料表分區後,每個分區的平均大小至少為 10 GB。建立許多小型分區會增加資料表的中繼資料,並可能影響查詢資料表時的中繼資料存取時間。
- 您需要持續更新資料表,但仍想享有長期儲存價格優惠。分區可讓每個分區分別考量是否符合長期定價資格。如果資料表未分區,則必須連續 90 天未編輯整個資料表,才能適用長期定價。
詳情請參閱「合併分群和分區資料表」。
叢集資料欄類型和排序
本節說明資料欄類型,以及資料欄順序在資料表分群中的運作方式。
叢集資料欄類型
叢集資料欄必須是頂層、非重複的資料欄,且屬於下列其中一種類型:
BIGNUMERICBOOLDATEDATETIMEGEOGRAPHYINT64NUMERICRANGESTRINGTIMESTAMP
如要進一步瞭解資料類型,請參閱「GoogleSQL 資料類型」。
叢集資料欄排序
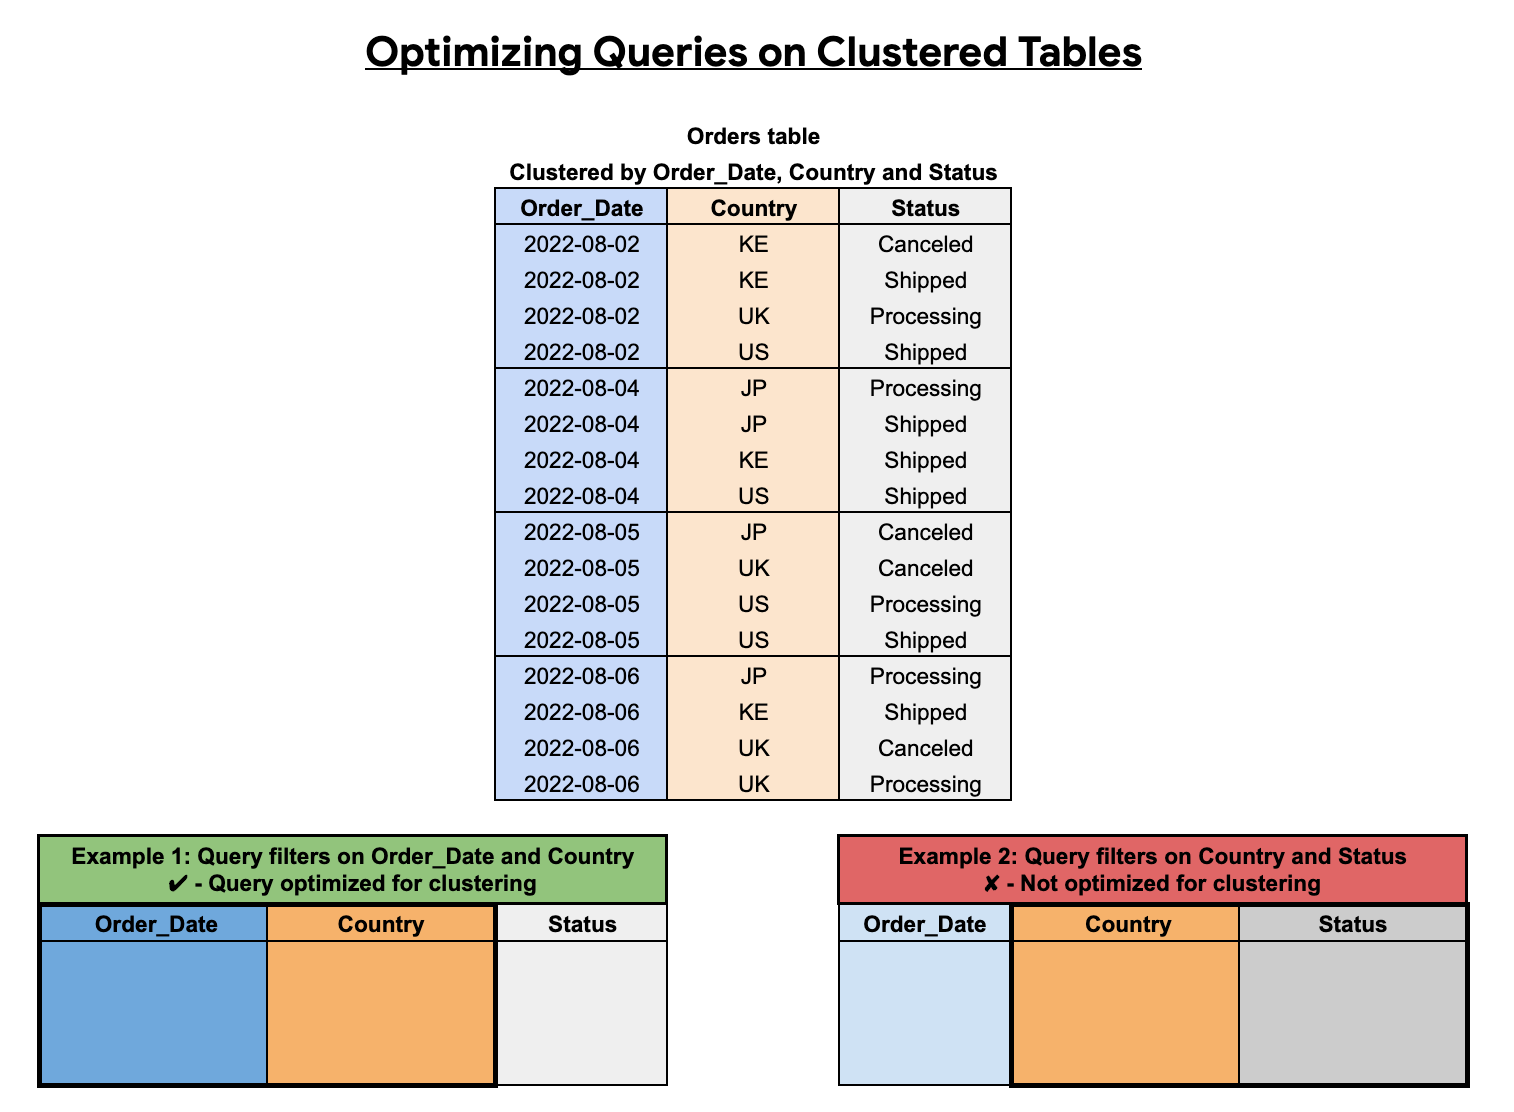
分群資料欄的順序會影響查詢效能。在以下範例中,Orders 資料表是使用 Order_Date、Country 和 Status 的資料欄排序順序進行分群。本範例中的第一個分群資料欄是 Order_Date,因此篩選 Order_Date 和 Country 的查詢會針對分群進行最佳化,而僅篩選 Country 和 Status 的查詢則不會進行最佳化。
區塊修剪
分群資料表可修剪資料,避免查詢處理這些資料,進而降低查詢成本。這個程序稱為區塊修剪。BigQuery 會根據分群資料欄中的值,將分群資料表中的資料排序,並整理成區塊。
對分群資料表執行查詢時,如果查詢包含分群資料欄的篩選器,BigQuery 會使用篩選運算式和區塊中繼資料,刪減查詢掃描的區塊。這樣一來,BigQuery 就只會掃描相關區塊。
系統不會掃描修剪掉的區塊,系統只會使用掃描的區塊,計算查詢處理的資料位元組數。對分群資料表執行查詢時,處理的位元組數等於查詢在掃描區塊中參照的各個資料欄讀取的位元組總和。
如果分群資料表在採用多個篩選條件的查詢中多次參照,BigQuery 會針對掃描各個篩選條件中適當區塊的資料欄收取費用。如需區塊剪除運作方式的範例,請參閱「範例」。
合併分群和分區資料表
您可以結合資料表分群和資料表分區,進行精細排序,進一步最佳化查詢。
在分區資料表中,資料會儲存在實體區塊,每個區塊都包含一個資料分區。每個分區資料表都會維護各種中繼資料,記錄所有修改作業的排序屬性。中繼資料可讓 BigQuery 在執行查詢前,更準確地估算查詢費用。不過,與未分區資料表相比,分區需要 BigQuery 維護更多中繼資料。隨著分區數量增加,需要維護的中繼資料量也會增加。
建立分群和分區資料表時,您可以進行更精細的排序,如下圖所示:

範例
您有一個名為 ClusteredSalesData 的分群資料表。資料表會依 timestamp 資料欄進行分區,並由 customer_id 資料欄建為叢集。資料會按以下這組區塊分類:
| 分區 ID | 區塊 ID | 區塊中 customer_id 的下限 | 區塊中 customer_id 的上限 |
|---|---|---|---|
| 20160501 | B1 | 10000 | 19999 |
| 20160501 | B2 | 20000 | 24999 |
| 20160502 | B3 | 15000 | 17999 |
| 20160501 | B4 | 22000 | 27999 |
您對該資料表進行以下的查詢。查詢包含了 customer_id 資料欄的篩選器。
SELECT
  SUM(totalSale)
FROM
  `mydataset.ClusteredSalesData`
WHERE
  customer_id BETWEEN 20000
  AND 23000
  AND DATE(timestamp) = "2016-05-01"
上述查詢包含下列步驟:
- 掃描 B2 和 B4 區塊中
timestamp、customer_id和totalSale資料欄。 DATE(timestamp) = "2016-05-01"篩選器述語針對timestamp分區資料欄,因此修剪 B3 區塊。customer_id BETWEEN 20000 AND 23000篩選器述語針對customer_id叢集資料欄,因此修剪 B1 區塊。
自動重新分群
資料新增至分群資料表時,新資料會整理成區塊,這可能會建立新的儲存區塊或更新現有區塊。新資料可能不會與具有相同叢集值的現有資料分組,因此必須進行區塊最佳化,才能達到最佳查詢和儲存效能。
為維持分群資料表的效能特性,BigQuery 會在背景自動重新分群。如果是分區資料表,則會針對每個分區範圍內的資料維護分群。
限制
- 只有 GoogleSQL 支援查詢分群資料表,以及將查詢結果寫入分群資料表。
- 最多只能指定四個分群欄。如需更多資料欄,建議您結合分群和分區。
- 使用
STRING已指定類型和格式的欄進行分群時,BigQuery 只會使用前 1,024 個字元來分群資料。資料欄中的值本身可以超過 1,024 個字元。 - 如果將現有的非分群資料表變更為分群資料表,現有資料不會自動分群。只有使用叢集資料欄儲存的新資料,才會自動重新叢集。如要進一步瞭解如何使用
UPDATE陳述式重新分群現有資料,請參閱「修改分群規格」。
分群資料表配額和限制
BigQuery 會透過配額和限制,限制共用 Cloud de Confiance by S3NS 資源的使用,包括特定資料表作業或一天內執行的工作數量。
搭配分區資料表使用分群資料表功能時,須遵守分區資料表的限制。
配額和限制也適用於可對分群資料表執行的不同類型工作。如要瞭解資料表適用的工作配額,請參閱「配額與限制」中的「工作」一節。
分群資料表定價
在 BigQuery 建立及使用分群資料表時,費用取決於資料表儲存的資料量,以及對資料執行的查詢。詳情請參閱儲存空間定價和查詢定價。
與其他 BigQuery 資料表作業一樣,分群資料表作業也享有 BigQuery 免費作業的優勢,例如批次載入、資料表複製、自動重新分群和資料匯出。這些作業受 BigQuery 配額和限制規範。如要瞭解免費作業,請參閱「免費作業」。
如需詳細的分群資料表定價範例,請參閱「估算儲存空間和查詢費用」。
資料表安全性
如要控管 BigQuery 資料表的存取權,請參閱「使用 IAM 控管資源存取權」。
後續步驟
- 如要瞭解如何建立及使用分群資料表,請參閱「建立及使用分群資料表」。
- 如要瞭解如何查詢分群資料表,請參閱「查詢分群資料表」。