

從 Cloud Storage 載入 ORC 資料
BigQuery 可讓您將 Cloud Storage 中的 ORC 資料載入新的資料表或分區,或附加至現有資料表或分區,或覆寫現有資料表或分區。ORC 是開放原始碼的欄導向資料格式,廣泛用於 Hadoop 生態系統。在擷取期間,BigQuery 會將資料轉換為 Capacitor (BigQuery 的儲存格式) 的資料欄格式,以便查詢和分析。
如要瞭解如何從本機檔案載入 ORC 資料,請參閱「從本機資料來源將資料載入 BigQuery」。
限制
從 Cloud Storage bucket 將資料載入 BigQuery 時,須遵守下列限制:
- BigQuery 不保證外部資料來源的資料一致性。如果基礎資料在查詢執行期間遭到變更,可能會導致非預期的行為。
- BigQuery 不支援 Cloud Storage 物件版本管理。如果您在 Cloud Storage URI 中加入世代編號,載入工作就會失敗。
事前準備
授予 Identity and Access Management (IAM) 角色,讓使用者具備必要權限,可執行本文件中的各項工作,並建立資料集來儲存資料。
所需權限
如要將資料載入 BigQuery,您必須具備 IAM 權限,才能執行載入工作,並將資料載入 BigQuery 資料表和分區。如果您是從 Cloud Storage 載入資料,也需要 IAM 權限,才能存取含有資料的 bucket。
將資料載入 BigQuery 的權限
如要將資料載入新的 BigQuery 資料表或分區,或附加或覆寫現有資料表或分區,您必須具備下列 IAM 權限:
bigquery.tables.createbigquery.tables.updateDatabigquery.tables.updatebigquery.jobs.create
下列各項預先定義的 IAM 角色,都包含將資料載入 BigQuery 資料表或分區所需的權限:
roles/bigquery.dataEditorroles/bigquery.dataOwnerroles/bigquery.admin(包含bigquery.jobs.create權限)bigquery.user(包含bigquery.jobs.create權限)bigquery.jobUser(包含bigquery.jobs.create權限)
此外,如果您具備 bigquery.datasets.create 權限,則可在建立的資料集中,使用載入工作建立及更新資料表。
如要進一步瞭解 BigQuery 的 IAM 角色和權限,請參閱「預先定義的角色和權限」。
從 Cloud Storage 載入資料的權限
如要取得從 Cloud Storage bucket 載入資料所需的權限,請要求管理員授予您 bucket 的儲存空間管理員 (roles/storage.admin) IAM 角色。如要進一步瞭解如何授予角色,請參閱「管理專案、資料夾和組織的存取權」。
這個預先定義的角色具備從 Cloud Storage bucket 載入資料所需的權限。如要查看確切的必要權限,請展開「Required permissions」(必要權限) 部分:
所需權限
您必須具備下列權限,才能從 Cloud Storage bucket 載入資料:
-
storage.buckets.get -
storage.objects.get -
storage.objects.list (required if you are using a URI wildcard)
建立資料集
建立 BigQuery 資料集來儲存資料。
ORC 結構定義
您將 ORC 檔案載入至 BigQuery 時,系統會透過自述式來源資料自動擷取資料表結構定義。當 BigQuery 從來源資料擷取結構定義時,會按照字母順序使用最後一個檔案。
舉例來說,Cloud Storage 中有下列 ORC 檔案:
gs://mybucket/00/
  a.orc
  z.orc
gs://mybucket/01/
  b.orc
在 bq 指令列工具中執行這項指令,會載入所有檔案 (以逗號分隔的清單),並從 mybucket/01/b.orc 衍生結構定義:
bq load \
--source_format=ORC \
dataset.table \
"gs://mybucket/00/*.orc","gs://mybucket/01/*.orc"
BigQuery 偵測到結構定義時,會將部分 ORC 資料類型轉換為 BigQuery 資料類型,以便與 GoogleSQL 語法相容。在偵測到的結構定義中,所有欄位均為 NULLABLE。詳情請參閱 ORC 轉換一節。
載入具有不同結構定義的多個 ORC 檔案時,多個結構定義中所指定的相同欄位 (具有相同名稱與相同巢狀層級) 必須對應至各個結構定義中相同的已轉換 BigQuery 資料類型。
如要提供資料表結構定義來建立外部資料表,請將 BigQuery API 中的referenceFileSchemaUri 屬性或 bq 指令列工具中的 --reference_file_schema_uri 參數設為參考檔案的網址。例如 --reference_file_schema_uri="gs://mybucket/schema.orc"。
ORC 壓縮
BigQuery 支援下列 ORC 檔案內容壓縮轉碼器:
ZlibSnappyLZOLZ4ZSTD
ORC 檔案中的資料上傳至 BigQuery 後,不會保持壓縮狀態。資料儲存空間會以邏輯位元組或實體位元組回報,具體取決於資料集儲存空間計費模式。如要取得儲存空間用量資訊,請查詢 INFORMATION_SCHEMA.TABLE_STORAGE 檢視表。
將 ORC 資料載入至新的資料表
您可以透過以下方式將 ORC 資料載入至新的資料表:
- 使用 Cloud de Confiance 控制台
- 使用 bq 指令列工具的
bq load指令 - 呼叫
jobs.insertAPI 方法並設定load工作 - 使用用戶端程式庫
如要將 ORC 資料從 Google Cloud Storage 載入至新的 BigQuery 資料表:
控制台
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
- 點選左側窗格中的 「Explorer」。
- 在「Explorer」窗格中展開專案,點選「資料集」,然後選取資料集。
- 在「資料集資訊」部分,點選 「建立資料表」。
- 在「建立資料表」窗格中,指定下列詳細資料:
- 在「Source」(來源) 部分,從「Create table from」(建立資料表來源) 清單中選取「Google Cloud Storage」。接著,按照下列步驟操作:
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Cloud de Confiance 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
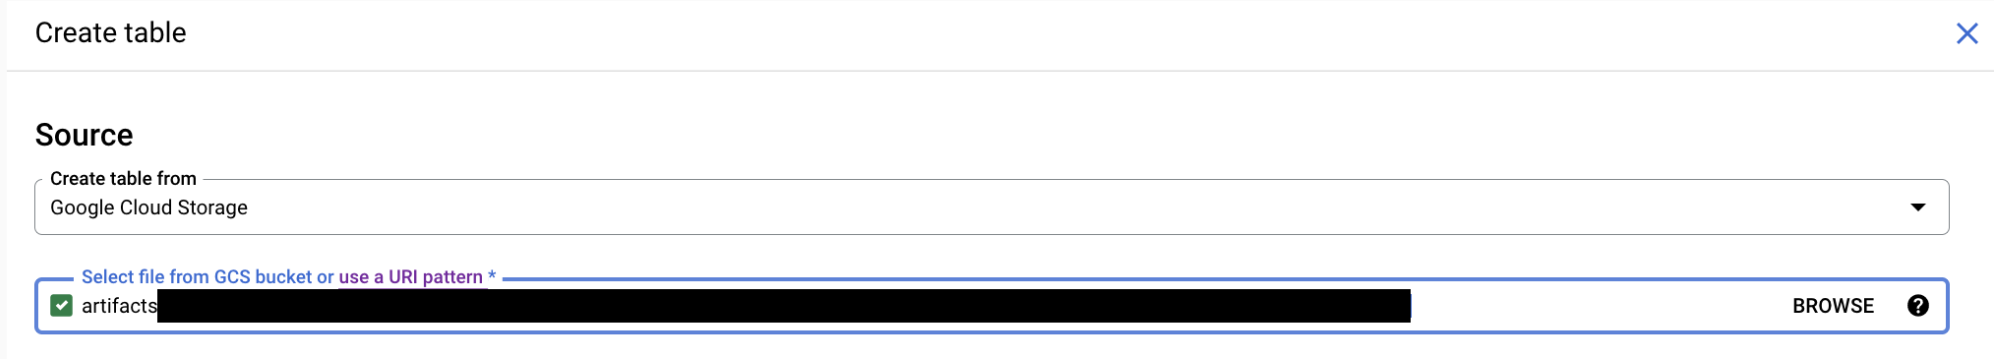
- 在「File format」(檔案格式) 選取「ORC」。
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Cloud de Confiance 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
- 在「Destination」(目的地) 部分,指定下列詳細資料:
- 在「Dataset」(資料集) 部分,選取要在其中建立資料表的資料集。
- 在「Table」(資料表) 欄位中,輸入要建立的資料表名稱。
- 確認「資料表類型」欄位設為「原生資料表」。
- 在「Schema」(結構定義) 區段中,無需採取任何行動。結構定義在 ORC 檔案中會自行描述。
- 選用:指定分區和叢集設定。詳情請參閱「建立分區資料表」和「建立及使用分群資料表」。
- 按一下「進階選項」,然後執行下列操作:
- 讓「Write preference」(寫入偏好設定) 的 [Write if empty] (空白時寫入) 選項維持在已選取狀態。這個選項會建立新資料表,並將資料載入其中。
- 如要忽略資料列中未出現在資料表結構定義的值,請選取「Unknown values」(不明的值)。
- 在「Encryption」(加密) 部分,按一下「Customer-managed key」(客戶自行管理的金鑰),即可使用 Cloud Key Management Service 金鑰。如果保留 Google Cloud-powered key 設定,BigQuery 會加密靜態資料。
- 點選「建立資料表」。
SQL
使用 LOAD DATA DDL 陳述式。以下範例會將 ORC 檔案載入新資料表 mytable:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中輸入下列陳述式:
LOAD DATA OVERWRITE mydataset.mytable
FROM FILES (
  format = 'ORC',
  uris = ['gs://bucket/path/file.orc']);
按一下「 執行」。
如要進一步瞭解如何執行查詢,請參閱「執行互動式查詢」。
bq
使用 bq load 指令將 ORC 指定為 source_format,並加入 Cloud Storage URI。
您可以加入單一 URI、以逗號分隔的 URI 清單,或包含萬用字元的 URI。
(選用) 提供 --location 旗標,並將值設為您的位置。
其他選用標記包括:
--time_partitioning_type:針對資料表啟用時間分區並設定分區類型。可能的值為HOUR、DAY、MONTH和YEAR。建立依DATE、DATETIME或TIMESTAMP資料欄分區的資料表時,可以選擇是否使用這個旗標。時間分區的預設分區類型為DAY。您無法變更現有資料表的分區規格。--time_partitioning_expiration:這是一個整數,用來指定系統應在何時刪除時間分區 (以秒為單位)。到期時間為分區的世界標準時間日期加上整數值。--time_partitioning_field:用於建立分區資料表的DATE或TIMESTAMP欄。如果啟用時間分區,但未提供這個值,系統會建立擷取時間分區資料表。--require_partition_filter:這個選項啟用後,系統會要求使用者加入WHERE子句,以指定要查詢的分區。使用分區篩選器可以降低成本並提升效能。詳情請參閱「在查詢中要求分區篩選器」。--clustering_fields:以半形逗號分隔的清單,最多列出四個用於建立分群資料表的資料欄名稱。--destination_kms_key:用於加密資料表資料的 Cloud KMS 金鑰。如要進一步瞭解分區資料表,請參閱:
如要進一步瞭解分群資料表,請參閱:
如要進一步瞭解資料表加密,請參閱:
如要將 ORC 資料載入 BigQuery,請輸入下列指令:
bq --location=location load \
--source_format=format \
dataset.table \
path_to_source
其中:
- location 是您的位置。
--location是選用旗標。舉例來說,如果您在東京地區使用 BigQuery,就可以將該旗標的值設定為asia-northeast1。您可以使用 .bigqueryrc 檔案設定位置的預設值。 - format為
ORC。 - dataset 是現有資料集。
- table 是您正在載入資料的資料表名稱。
- path_to_source 是完整的 Cloud Storage URI,或以半形逗號分隔的 URI 清單。您也可以使用萬用字元。
範例:
下列指令會將資料從 gs://mybucket/mydata.orc 載入到 mydataset 中名為 mytable 的資料表。
    bq load \
    --source_format=ORC \
    mydataset.mytable \
    gs://mybucket/mydata.orc
下列指令會將 gs://mybucket/mydata.orc 中的資料,載入 mydataset 中名為 mytable 的新擷取時間分區資料表。
    bq load \
    --source_format=ORC \
    --time_partitioning_type=DAY \
    mydataset.mytable \
    gs://mybucket/mydata.orc
下列指令會將資料從 gs://mybucket/mydata.orc 載入到 mydataset 中名為 mytable 的分區資料表。資料表會依 mytimestamp 資料欄進行分區。
    bq load \
    --source_format=ORC \
    --time_partitioning_field mytimestamp \
    mydataset.mytable \
    gs://mybucket/mydata.orc
下列指令會將 gs://mybucket/ 中多個檔案的資料載入到 mydataset 中名為 mytable 的資料表。指令中的 Cloud Storage URI 使用萬用字元。
    bq load \
    --source_format=ORC \
    mydataset.mytable \
    gs://mybucket/mydata*.orc
下列指令會將 gs://mybucket/ 中多個檔案的資料載入到 mydataset 中名為 mytable 的資料表。指令包含以逗號分隔且帶有萬用字元的 Cloud Storage URI 清單。
    bq load --autodetect \
    --source_format=ORC \
    mydataset.mytable \
    "gs://mybucket/00/*.orc","gs://mybucket/01/*.orc"
API
建立指向 Cloud Storage 中來源資料的
load工作。source URIs屬性必須是完整的,且必須符合下列格式:gs://bucket/object。每個 URI 都可以包含一個「*」萬用字元。將
sourceFormat屬性設為ORC,以指定 ORC 資料格式。如要檢查工作狀態,請呼叫
jobs.get(job_id*),其中 job_id 是初始要求傳回的工作 ID。- 如果是
status.state = DONE,代表工作已順利完成。 - 如果出現
status.errorResult屬性,表示要求失敗,且該物件會包含說明錯誤原因的資訊。如果要求執行失敗,系統就不會建立任何資料表,也不會載入任何資料。 - 如果未出現
status.errorResult,代表工作順利完成,但可能有一些不嚴重的錯誤,例如少數資料列在匯入時發生問題。不嚴重的錯誤都會列在已傳回工作物件的status.errors屬性中。
- 如果是
API 附註:
載入工作不可部分完成,且資料狀態具一致性。如果載入工作失敗,所有資料都無法使用;如果載入工作成功,則所有資料都可以使用。
最佳做法是產生專屬 ID,並在呼叫
jobs.insert建立載入工作時,將該 ID 做為jobReference.jobId傳遞。這個方法較不受網路故障問題的影響,因為用戶端可使用已知的工作 ID 進行輪詢或重試。對指定的工作 ID 呼叫
jobs.insert是一種冪等作業。您可以對同一個工作 ID 重試任意次數,但最多只有一項作業會成功。
C#
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 C# 設定操作說明進行操作。詳情請參閱 BigQuery C# API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Go
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Go 設定操作說明進行操作。詳情請參閱 BigQuery Go API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Java
Node.js
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Node.js 設定操作說明進行操作。詳情請參閱 BigQuery Node.js API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
PHP
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 PHP 設定操作說明進行操作。詳情請參閱 BigQuery PHP API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Ruby
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Ruby 設定操作說明進行操作。詳情請參閱 BigQuery Ruby API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
使用 ORC 資料附加或覆寫資料表
如要將其他資料載入資料表,您可以指定來源檔案或附加查詢結果。
在 Cloud de Confiance 控制台中,使用「Write preference」(寫入偏好設定) 選項,指定從來源檔案或查詢結果載入資料時要採取的動作。
將額外資料載入資料表時,可以選擇下列選項:
| 主控台選項 | bq 工具旗標 | BigQuery API 屬性 | 說明 |
|---|---|---|---|
| 空白時寫入 | 不支援 | WRITE_EMPTY |
資料表空白時才會寫入資料。 |
| 附加到資料表 | --noreplace 或 --replace=false;如果未指定 --[no]replace,則預設動作為附加 |
WRITE_APPEND |
(預設) 將資料附加至資料表結尾。 |
| 覆寫資料表 | --replace或--replace=true |
WRITE_TRUNCATE |
在寫入新資料前,清除資料表中的所有現有資料。 這項操作也會刪除資料表結構定義、資料列層級安全性,並移除所有 Cloud KMS 金鑰。 |
如果您將資料載入現有資料表,該載入工作可附加資料,或覆寫資料表。
您可以透過下列方式來對資料表進行附加或覆寫作業:
- 使用 Cloud de Confiance 控制台
- 使用 bq 指令列工具的
bq load指令 - 呼叫
jobs.insertAPI 方法並設定load工作 - 使用用戶端程式庫
使用 ORC 資料附加或覆寫資料表的方式如下:
控制台
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
- 點選左側窗格中的 「Explorer」。
- 在「Explorer」窗格中展開專案,點選「資料集」,然後選取資料集。
- 在「資料集資訊」部分,點選 「建立資料表」。
- 在「建立資料表」窗格中,指定下列詳細資料:
- 在「Source」(來源) 部分,從「Create table from」(建立資料表來源) 清單中選取「Google Cloud Storage」。接著,按照下列步驟操作:
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Cloud de Confiance 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
- 在「File format」(檔案格式) 選取「ORC」。
- 從 Cloud Storage bucket 選取檔案,或輸入 Cloud Storage URI。您無法在 Cloud de Confiance 控制台中加入多個 URI,但可以使用萬用字元。Cloud Storage bucket 必須與資料集位於相同位置,且該資料集包含您要建立、附加或覆寫的資料表。
- 在「Destination」(目的地) 部分,指定下列詳細資料:
- 在「Dataset」(資料集) 部分,選取要在其中建立資料表的資料集。
- 在「Table」(資料表) 欄位中,輸入要建立的資料表名稱。
- 確認「資料表類型」欄位設為「原生資料表」。
- 在「Schema」(結構定義) 區段中,無需採取任何行動。結構定義在 ORC 檔案中會自行描述。
- 選用:指定分區和叢集設定。詳情請參閱「建立分區資料表」和「建立及使用分群資料表」。您無法透過附加或覆寫資料表,將資料表轉換為分區或分群資料表。 Cloud de Confiance 控制台不支援在載入工作中附加或覆寫分區或分群資料表。
- 按一下「進階選項」,然後執行下列操作:
- 在「Write preference」(寫入偏好設定) 部分,選擇「Append to table」(附加至資料表) 或「Overwrite table」(覆寫資料表)。
- 如要忽略資料列中未出現在資料表結構定義的值,請選取「Unknown values」(不明的值)。
- 在「Encryption」(加密) 部分,按一下「Customer-managed key」(客戶自行管理的金鑰),即可使用 Cloud Key Management Service 金鑰。如果保留 Google Cloud-powered key 設定,BigQuery 會加密靜態資料。
- 點選「建立資料表」。
SQL
使用 LOAD DATA DDL 陳述式。以下範例會將 ORC 檔案附加至資料表 mytable:
前往 Cloud de Confiance 控制台的「BigQuery」頁面。
在查詢編輯器中輸入下列陳述式:
LOAD DATA INTO mydataset.mytable
FROM FILES (
  format = 'ORC',
  uris = ['gs://bucket/path/file.orc']);
按一下「 執行」。
如要進一步瞭解如何執行查詢,請參閱「執行互動式查詢」。
bq
如要覆寫資料表,請輸入 bq load 指令並加上 --replace 旗標。如要附加資料至資料表,使用 --noreplace 旗標。若未指定任何旗標,預設動作為附加資料。提供 --source_format 旗標,並將其設為 ORC。由於 ORC 結構定義會自動從自我描述來源資料中擷取,因此您不需要提供結構定義定義。
(選用) 提供 --location 旗標,並將值設為您的位置。
其他選用標記包括:
--destination_kms_key:用於加密資料表資料的 Cloud KMS 金鑰。
bq --location=location load \
--[no]replace \
--source_format=format \
dataset.table \
path_to_source
其中:
- location是你的位置。
--location是選用旗標。您可以使用 .bigqueryrc 檔案來設定位置的預設值。 - format為
ORC。 - dataset 是現有資料集。
- table 是您正在載入資料的資料表名稱。
- path_to_source 是完整的 Cloud Storage URI,或以半形逗號分隔的 URI 清單。您也可以使用萬用字元。
範例:
下列指令會從 gs://mybucket/mydata.orc 載入資料,並覆寫 mydataset 中名為 mytable 的資料表。
    bq load \
    --replace \
    --source_format=ORC \
    mydataset.mytable \
    gs://mybucket/mydata.orc
下列指令會從 gs://mybucket/mydata.orc 載入資料,並將資料附加至 mydataset 中名為 mytable 的資料表。
    bq load \
    --noreplace \
    --source_format=ORC \
    mydataset.mytable \
    gs://mybucket/mydata.orc
如要瞭解如何使用 bq 指令列工具附加及覆寫分區資料表,請參閱「附加及覆寫分區資料表資料」。
API
建立指向 Cloud Storage 中來源資料的
load工作。source URIs屬性必須是完整的,且必須符合下列格式:gs://bucket/object。您可以使用逗號分隔清單的形式加入多個 URI。請注意,系統也支援使用萬用字元。藉由將
configuration.load.sourceFormat屬性設為ORC,以指定資料格式。藉由將
configuration.load.writeDisposition屬性設為WRITE_TRUNCATE或WRITE_APPEND,以指定寫入偏好設定。
C#
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 C# 設定操作說明進行操作。詳情請參閱 BigQuery C# API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Go
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Go 設定操作說明進行操作。詳情請參閱 BigQuery Go API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Java
Node.js
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Node.js 設定操作說明進行操作。詳情請參閱 BigQuery Node.js API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
PHP
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 PHP 設定操作說明進行操作。詳情請參閱 BigQuery PHP API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Python
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Python 設定操作說明進行操作。詳情請參閱 BigQuery Python API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
Ruby
在試用這個範例之前,請先按照「使用用戶端程式庫的 BigQuery 快速入門導覽課程」中的 Ruby 設定操作說明進行操作。詳情請參閱 BigQuery Ruby API 參考文件。
如要向 BigQuery 進行驗證,請設定應用程式預設憑證。詳情請參閱「設定用戶端程式庫的驗證機制」。
執行程式碼範例前,請將 GOOGLE_CLOUD_UNIVERSE_DOMAIN 環境變數設為 s3nsapis.fr。
載入 Hive 分區 ORC 資料
BigQuery 支援載入儲存在 Cloud Storage 的 Hive 分區 ORC 資料,並將 Hive 分區資料欄填入目的地 BigQuery 代管資料表的資料欄。詳情請參閱「載入外部分區資料」。
ORC 轉換
BigQuery 會將 ORC 資料類型轉換為下列 BigQuery 資料類型:
原始類型
| BigQuery 資料類型 | 附註 | |
|---|---|---|
| boolean | BOOLEAN | |
| byte | INTEGER | |
| short | INTEGER | |
| int | INTEGER | |
| long | INTEGER | |
| float | FLOAT | |
| double | FLOAT | |
| string | STRING | 僅限 UTF-8 |
| varchar | STRING | 僅限 UTF-8 |
| char | STRING | 僅限 UTF-8 |
| binary | BYTES | |
| date | DATE | 如果嘗試轉換 ORC 資料中任何小於 -719162 天或大於 2932896 天的值,系統會傳回 invalid date
value 錯誤。如果這對您造成影響,請與支援團隊聯絡,將不支援的值轉換為 BigQuery 最小值 0001-01-01 或最大值 9999-12-31 (視情況而定)。 |
| 時間戳記 | TIMESTAMP |
ORC 支援奈秒精確度,但 BigQuery 會在讀取資料時,將微秒以下的值轉換為微秒。 如果嘗試轉換 ORC 資料中任何小於 -719162 天或大於 2932896 天的值,系統會傳回 |
| decimal | NUMERIC、BIGNUMERIC 或 STRING | 請參閱「Decimal 類型」。 |
十進位類型
Decimal 邏輯類型可轉換為 NUMERIC、BIGNUMERIC 或 STRING 類型。轉換後的類型取決於 decimal 邏輯類型的有效位數和小數位數參數,以及指定的小數目標類型。請按照下列方式指定十進位指定類型:
- 如要使用
jobs.insertAPI 執行載入工作,請使用JobConfigurationLoad.decimalTargetTypes欄位。 - 如要使用 bq 指令列工具中的
bq load指令執行載入工作,請使用--decimal_target_types旗標。 - 如要查詢具有外部來源的資料表,請使用
ExternalDataConfiguration.decimalTargetTypes欄位。 - 如果是使用 DDL 建立的永久外部資料表:請使用
decimal_target_types選項。
複合類型
| BigQuery 資料類型 | 附註 | |
|---|---|---|
| struct | RECORD |
|
| map<K,V> | RECORD | ORC map<K,V> 欄位會轉換為重複的 RECORD,其中包含兩個欄位:相同資料類型的鍵為 K,以及相同資料類型的值為 V。這兩個欄位都是 NULLABLE。 |
| list | 重複欄位 | 不支援巢狀清單與對應清單。 |
| union | RECORD |
|
欄名稱
資料欄名稱可以包含英文字母 (a-z、A-Z)、數字 (0-9) 或底線 (_),且開頭必須是英文字母或底線。如果使用彈性資料欄名稱,BigQuery 支援以數字開頭的資料欄名稱。如果資料欄名稱開頭為數字,請務必謹慎,因為搭配使用 BigQuery Storage Read API 或 BigQuery Storage Write API (gRPC) 時,需要特別處理彈性資料欄名稱。如要進一步瞭解彈性資料欄名稱支援,請參閱「彈性資料欄名稱」。
資料欄名稱長度上限為 300 個半形字元。資料欄名稱不得使用下列任何前置字元:
_TABLE__FILE__PARTITION_ROW_TIMESTAMP__ROOT___COLIDENTIFIER_CHANGE_SEQUENCE_NUMBER_CHANGE_TYPE_CHANGE_TIMESTAMP
資料欄名稱不得重複,即使大小寫不同也是如此。舉例來說,名為 Column1 的資料欄會視為與名為 column1 的資料欄相同。如要進一步瞭解資料欄命名規則,請參閱 GoogleSQL 參考資料中的「資料欄名稱」。
如果資料表名稱 (例如 test) 與其中一個資料欄名稱 (例如 test) 相同,SELECT 運算式會將 test 資料欄解讀為包含所有其他資料表資料欄的 STRUCT。如要避免這種衝突,請使用下列其中一種方法:
避免為資料表和資料欄使用相同名稱。
請勿使用
_field_做為資料欄名稱前置字串。系統保留的前置字串會在查詢期間自動重新命名。舉例來說,SELECT _field_ FROM project1.dataset.test查詢會傳回名為_field_1的資料欄。如要查詢這個名稱的資料欄,請使用別名控制輸出內容。為資料表指派其他別名。舉例來說,下列查詢會將資料表別名
t指派給資料表project1.dataset.test:SELECT test FROM project1.dataset.test AS t;參照資料欄時,請一併提供資料表名稱。例如:
SELECT test.test FROM project1.dataset.test;
彈性設定資料欄名稱
您可以更靈活地命名資料欄,包括使用更多非英文字元和其他符號。如果彈性資料欄名稱是引號 ID,請務必使用倒引號 (`) 字元括住。
彈性資料欄名稱支援下列字元:
- 任何語言的任何字母,以 Unicode 規則運算式
\p{L}表示。 - 任何語言中的任何數字字元,以 Unicode 規則運算式
\p{N}表示。 - 任何連接標點符號字元,包括底線,以 Unicode 規則運算式
\p{Pc}表示。 - 以 Unicode 規則運算式
\p{Pd}表示的連字號或破折號。 - 任何用於搭配其他字元的標記,以 Unicode 規則運算式
\p{M}表示。例如重音符號、變音符號或外框。 - 下列特殊字元:
- 以 Unicode 規則運算式
\u0026表示的 & 符號 (&)。 - 百分比符號 (
%),以 Unicode 規則運算式\u0025表示。 - 等號 (
=),以 Unicode 規則運算式\u003D表示。 - 加號 (
+),以 Unicode 規則運算式\u002B表示。 - 冒號 (
:),以 Unicode 規則運算式\u003A表示。 - 縮寫符號 (
'),以 Unicode 規則運算式\u0027表示。 - 小於符號 (
<),以 Unicode 規則運算式\u003C表示。 - 大於符號 (
>),以 Unicode 規則運算式\u003E表示。 - 以 Unicode 規則運算式
\u0023表示的數字符號 (#)。 - 垂直線 (
|),以 Unicode 規則運算式\u007c表示。 - 空格字元。
- 以 Unicode 規則運算式
彈性資料欄名稱不支援下列特殊字元:
- 驚嘆號 (
!),以 Unicode 規則運算式\u0021表示。 - 引號 (
"),以 Unicode 規則運算式\u0022表示。 - 錢幣符號 (
$),以 Unicode 規則運算式\u0024表示。 - 左括號 (
(),以 Unicode 規則運算式\u0028表示。 - 右括號 (
)),以 Unicode 規則運算式\u0029表示。 - 星號 (
*),以 Unicode 規則運算式\u002A表示。 - 以 Unicode 規則運算式
\u002C表示的半形逗號 (,)。 - 句號 (
.),以 Unicode 規則運算式\u002E表示。使用資料欄名稱字元對應時,Parquet 檔案資料欄名稱中的句號不會替換為底線。詳情請參閱「彈性資料欄限制」。 - 斜線 (
/),以 Unicode 規則運算式\u002F表示。 - 分號 (
;),以 Unicode 規則運算式\u003B表示。 - 問號 (
?),以 Unicode 規則運算式\u003F表示。 - 以 Unicode 規則運算式
\u0040表示的小老鼠符號 (@)。 - 左方括號 (
[),以 Unicode 規則運算式\u005B表示。 - 反斜線 (
\),以 Unicode 規則運算式\u005C表示。 - 右方括號 (
]),以 Unicode 規則運算式\u005D表示。 - 揚抑符號 (
^),以 Unicode 規則運算式\u005E表示。 - 重音符號 (
`),以 Unicode 規則運算式\u0060表示。 - 左大括號 {
{),以 Unicode 規則運算式\u007B表示。 - 右大括號 (
}),以 Unicode 規則運算式\u007D表示。 - 波浪號 (
~),以 Unicode 規則運算式\u007E表示。
如需其他規範,請參閱「資料欄名稱」。
BigQuery Storage Read API 和 BigQuery Storage Write API (gRPC) 都支援擴充的資料欄字元。如要搭配 BigQuery Storage Read API 使用擴充的 Unicode 字元清單,您必須設定旗標。您可以使用 displayName 屬性擷取資料欄名稱。以下範例說明如何使用 Python 用戶端設定旗標:
from google.cloud.bigquery_storage import types
requested_session = types.ReadSession()

#set avro serialization options for flexible column.
options = types.AvroSerializationOptions()
options.enable_display_name_attribute = True
requested_session.read_options.avro_serialization_options = options
如要透過 BigQuery Storage Write API (gRPC) 使用擴充的 Unicode 字元清單,除非您使用 JsonStreamWriter 寫入器物件,否則必須提供含有 column_name 標記法的結構定義。以下範例說明如何提供結構定義:
syntax = "proto2";
package mypackage;
// Source protos located in github.com/googleapis/googleapis
import "google/cloud/bigquery/storage/v1/annotations.proto";

message FlexibleSchema {
  optional string item_name_column = 1
  [(.google.cloud.bigquery.storage.v1.column_name) = "name-列"];
  optional string item_description_column = 2
  [(.google.cloud.bigquery.storage.v1.column_name) = "description-列"];
}
在這個範例中,item_name_column 和 item_description_column 是預留位置名稱,必須符合通訊協定緩衝區命名慣例。請注意,column_name 註解一律優先於預留位置名稱。
限制
- Iceberg 代管資料表、Iceberg 外部資料表,以及由 Lakehouse 執行階段目錄代管的 Apache Iceberg 資料表,預設支援彈性資料欄名稱。其他外部資料表 (例如 Parquet、ORC、Avro、CSV 或 Delta Lake) 預設不會啟用彈性資料欄名稱。如要申請專案層級啟用,請與 Cloud Customer Care 聯絡。
- 如果是 Delta Lake 資料表,您也必須在
id或name模式中啟用資料欄對應。
- 如果是 Delta Lake 資料表,您也必須在
- 將具有彈性資料欄名稱的外部資料表匯出為開放檔案格式 (例如使用
EXPORT DATA或擷取工作的 Parquet 或 Avro) 時,系統會將不支援的資料欄名稱對應至產生的內部雜湊名稱 (col_...),因為第三方格式不含 BigQuery 顯示名稱中繼資料。 - 舊版 SQL 不支援彈性資料欄名稱。您必須使用 GoogleSQL。
NULL 個值
請注意,對於載入工作,BigQuery 會忽略 list 複合類型的 NULL 元素,否則會被轉換為 NULL ARRAY 元素且不能保存到資料表中 (詳情請參閱資料類型)。
如要進一步瞭解 ORC 資料類型,請參閱 Apache ORC™ 規格 v1。