

במדריך הזה תשתמשו במודל רגרסיה לוגיסטית בינארי ב-BigQuery ML כדי לחזות את טווח ההכנסה של אנשים על סמך הנתונים הדמוגרפיים שלהם. מודל רגרסיה לוגיסטית בינארית חוזה אם ערך מסוים שייך לאחת משתי קטגוריות. במקרה הזה, אם ההכנסה השנתית של אדם מסוים היא מעל או מתחת ל-50,000$.
במדריך הזה משתמשים במערך הנתונים bigquery-public-data.ml_datasets.census_adult_income. קבוצת נתונים זו מכילה מידע דמוגרפי ומידע על הכנסות של תושבי ארה"ב מהשנים 2000 ו-2010.
מטרות
במדריך הזה תבצעו את המשימות הבאות:- יוצרים מודל רגרסיה לוגיסטית.
- הערכת המודל.
- ליצור חיזויים באמצעות המודל.
- הסבר על התוצאות שהמודל הפיק.
עלויות
במדריך הזה משתמשים ברכיבים של Cloud de Confiance by S3NS, והשימוש בהם כרוך בתשלום, כולל:
- BigQuery
- BigQuery ML
למידע נוסף על העלויות של BigQuery, קראו את הדף תמחור ב-BigQuery.
למידע נוסף על העלויות של BigQuery ML, קראו את המאמר תמחור ב-BigQuery ML.
לפני שמתחילים
-
בדף לבחירת הפרויקט במסוף Cloud de Confiance , בוחרים פרויקט ב- Cloud de Confiance או יוצרים אותו.
התפקידים שנדרשים כדי לבחור או ליצור פרויקט
- בחירת פרויקט: כדי לבחור פרויקט לא נדרש תפקיד IAM ספציפי – אתם יכולים לבחור כל פרויקט שקיבלתם בו תפקיד.
-
יצירת פרויקט: כדי ליצור פרויקט, צריך את התפקיד "יצירת פרויקטים" (
roles/resourcemanager.projectCreator), שכולל את ההרשאהresourcemanager.projects.create. איך מקצים תפקידים?
-
מפעילים את BigQuery API, אם הוא עדיין לא מופעל.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה
serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים
ההרשאות הנדרשות
כדי ליצור את המודל באמצעות BigQuery ML, אתם צריכים את הרשאות ה-IAM הבאות:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateDatabigquery.models.updateMetadata
כדי להריץ הסקה, צריך את ההרשאות הבאות:
-
bigquery.models.getDataבמודל bigquery.jobs.create
מבוא
משימה נפוצה בלמידת מכונה היא לסווג נתונים לאחד משני סוגים, שנקראים תוויות. לדוגמה, קמעונאי יכול לחזות אם לקוח מסוים ירכוש מוצר חדש, על סמך מידע אחר על אותו לקוח. במקרה כזה, שתי התוויות יכולות להיות will buy ו-won't buy. הקמעונאי יכול ליצור קבוצת נתונים שבה עמודה אחת מייצגת את שתי התוויות, ומכילה גם את נתוני הלקוח, כמו המיקום שלו, הרכישות הקודמות שלו וההעדפות שהוא דיווח עליהן. לאחר מכן, הקמעונאי יכול להשתמש במודל רגרסיה לוגיסטית בינארית שמשתמש בנתוני הלקוחות האלה כדי לחזות איזו תווית מייצגת בצורה הטובה ביותר כל לקוח.
במדריך הזה תיצרו מודל רגרסיה לוגיסטית בינארית, שחוזה אם ההכנסה של משיב לסקר של מפקד האוכלוסין בארה"ב נכללת באחד משני טווחים, על סמך המאפיינים הדמוגרפיים של המשיב.
יצירת מערך נתונים
יוצרים מערך נתונים ב-BigQuery כדי לאחסן את המודל:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בחלונית השמאלית, לוחצים על Explorer:
אם החלונית הימנית לא מוצגת, לוחצים על הרחבת החלונית הימנית כדי לפתוח אותה.
בחלונית Explorer, לוחצים על שם הפרויקט.
לוחצים על View actions > Create dataset.
בדף Create dataset, מבצעים את הפעולות הבאות:
בשדה Dataset ID, מזינים
census.ב-Location type, בוחרים באפשרות מספר אזורים ואז בוחרים באפשרות US (multiple regions in United States).
מערכי הנתונים שזמינים לכולם מאוחסנים במספר אזורים ב-
US. כדי לפשט את התהליך, כדאי לשמור את מערך הנתונים באותו מיקום.משאירים את שאר הגדרות ברירת המחדל כמו שהן ולוחצים על Create dataset.
בדיקת הנתונים
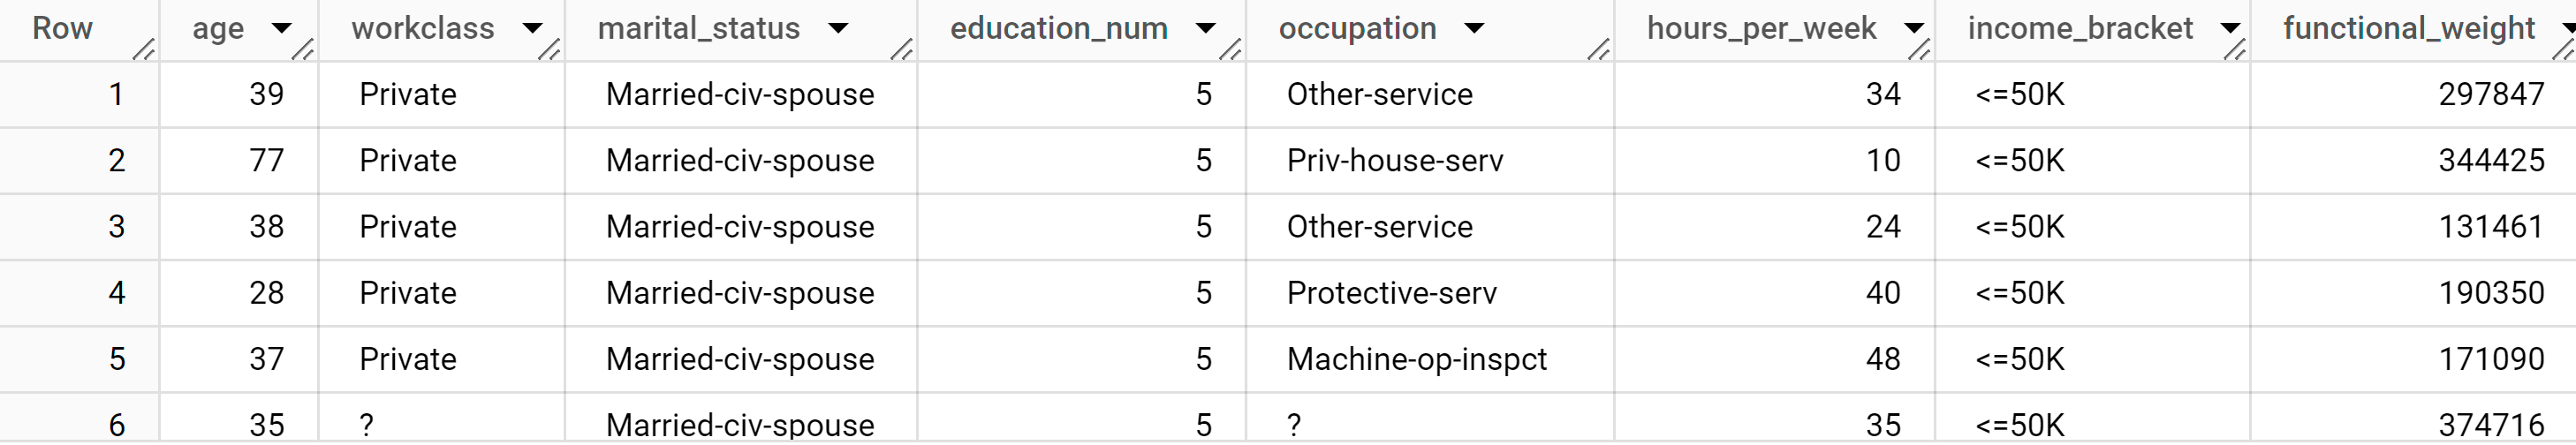
בודקים את מערך הנתונים ומזהים אילו עמודות ישמשו כנתוני אימון למודל הרגרסיה הלוגיסטית. בוחרים 100 שורות מהטבלה census_adult_income:
SQL
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את שאילתת GoogleSQL הבאה:
SELECT
age,
workclass,
marital_status,
education_num,
occupation,
hours_per_week,
income_bracket,
functional_weight
FROM
`bigquery-public-data.ml_datasets.census_adult_income`
LIMIT
100;
התוצאות אמורות להיראות כך:
BigQuery DataFrames
לפני שתנסו את הדוגמה הזו, בצעו את הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה של BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
בתוצאות השאילתה אפשר לראות שבעמודה income_bracket בטבלה census_adult_income יש רק אחד משני הערכים: <=50K או >50K.
הכנת הנתונים לדוגמה
במדריך הזה, אתם חוזים את ההכנסה של המשיבים במפקד האוכלוסין על סמך הערכים של העמודות הבאות בטבלה census_adult_income:
-
age: הגיל של המשיב. -
workclass: סוג העבודה שבוצעה. לדוגמה, ממשל מקומי, פרטי או עצמאי. marital_status-
education_num: רמת ההשכלה הגבוהה ביותר של המשיב. occupation-
hours_per_week: שעות עבודה בשבוע.
אתם מחריגים עמודות שמשכפלות נתונים. לדוגמה, העמודה education, כי הערכים בעמודות education ו-education_num מבטאים את אותם נתונים בפורמטים שונים.
העמודה functional_weight מייצגת את מספר האנשים שארגון המפקד מאמין ששורה מסוימת מייצגת. מכיוון שהערך של העמודה הזו לא קשור לערך של income_bracket בכל שורה נתונה, אתם משתמשים בערך שבעמודה הזו כדי להפריד את הנתונים לקבוצות אימון, הערכה וחיזוי, על ידי יצירת עמודה חדשה של dataframe שנגזרת מהעמודה functional_weight. אתם מתייגים 80% מהנתונים לאימון המודל, 10% מהנתונים להערכה ו-10% מהנתונים לחיזוי.
SQL
יוצרים תצוגה עם הנתונים לדוגמה.
התצוגה הזו משמשת את ההצהרה CREATE MODEL בהמשך המדריך.
מריצים את השאילתה שמכינה את הנתונים לדוגמה:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה:
CREATE OR REPLACE VIEW
`census.input_data` AS
SELECT
age,
workclass,
marital_status,
education_num,
occupation,
hours_per_week,
income_bracket,
CASE
  WHEN MOD(functional_weight, 10) < 8 THEN 'training'
  WHEN MOD(functional_weight, 10) = 8 THEN 'evaluation'
  WHEN MOD(functional_weight, 10) = 9 THEN 'prediction'
END AS dataframe
FROM
`bigquery-public-data.ml_datasets.census_adult_income`;
צפייה בנתונים לדוגמה:
SELECT * FROM `census.input_data`;
BigQuery DataFrames
יוצרים DataFrame בשם input_data. בהמשך המדריך תשתמשו ב-input_data כדי לאמן את המודל, להעריך אותו וליצור תחזיות.
לפני שתנסו את הדוגמה הזו, בצעו את הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה של BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
יצירת מודל רגרסיה לוגיסטית
יוצרים מודל רגרסיה לוגיסטית באמצעות נתוני האימון שתייגתם בקטע הקודם.
SQL
משתמשים בהצהרה CREATE MODEL ומציינים את הערך LOGISTIC_REG לסוג המודל.
הנה כמה דברים שכדאי לדעת על ההצהרה CREATE MODEL:
האפשרות
input_label_colsמציינת באיזו עמודה בהצהרתSELECTלהשתמש כעמודת התווית. כאן, עמודת התווית היאincome_bracket, כך שהמודל לומד איזה משני הערכים שלincome_bracketהוא הסביר ביותר לשורה נתונה, על סמך הערכים האחרים שקיימים באותה שורה.לא צריך לציין אם מודל הרגרסיה הלוגיסטית הוא בינארי או מרובה-מחלקות. BigQuery ML קובע איזה סוג מודל לאמן על סמך מספר הערכים הייחודיים בעמודת התווית.
האפשרות
auto_class_weightsמוגדרת כ-TRUEכדי לאזן את תוויות הסיווג בנתוני האימון. כברירת מחדל, נתוני האימון לא משוקללים. אם התוויות בנתוני האימון לא מאוזנות, המודל עשוי ללמוד לחזות את סוג התוויות הפופולרי ביותר בצורה משמעותית יותר. במקרה הזה, רוב המשיבים בקבוצת הנתונים נמצאים בקבוצת ההכנסה הנמוכה יותר. זה עלול להוביל למודל שחוזה את קבוצת ההכנסה הנמוכה יותר באופן מוגזם. משקלי המחלקות מאזנים את תוויות המחלקות על ידי חישוב המשקלים של כל מחלקה ביחס הפוך לתדירות של אותה מחלקה.האפשרות
enable_global_explainמוגדרת כ-TRUEכדי לאפשר לכם להשתמש בפונקציהML.GLOBAL_EXPLAINבמודל בהמשך המדריך.ההצהרה
SELECTשולחת שאילתה לתצוגהinput_dataשמכילה את הנתונים לדוגמה. הסעיףWHEREמסנן את השורות כך שרק השורות שמתויגות כנתוני אימון משמשות לאימון המודל.
מריצים את השאילתה שיוצרת את מודל הרגרסיה הלוגיסטית:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה:
CREATE OR REPLACE MODEL
`census.census_model`
OPTIONS
( model_type='LOGISTIC_REG',
  auto_class_weights=TRUE,
  enable_global_explain=TRUE,
  data_split_method='NO_SPLIT',
  input_label_cols=['income_bracket'],
  max_iterations=15) AS
SELECT * EXCEPT(dataframe)
FROM
`census.input_data`
WHERE
dataframe = 'training'
בחלונית השמאלית, לוחצים על Explorer:
בחלונית Explorer, לוחצים על Datasets.
בחלונית Datasets, לוחצים על
census.לוחצים על הכרטיסייה Models.
לחץ על
census_model.בכרטיסייה Details מפורטים המאפיינים שבהם BigQuery ML השתמש כדי לבצע רגרסיה לוגיסטית.
BigQuery DataFrames
משתמשים בפונקציה bigframes.bigquery.ml.create_model כדי לאמן את המודל ולשמור אותו במערך הנתונים.
לפני שתנסו את הדוגמה הזו, בצעו את הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה של BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
הערכת הביצועים של המודל
אחרי שיוצרים את המודל, בודקים את הביצועים שלו בהשוואה לנתוני ההערכה.
SQL
הפונקציה ML.EVALUATE מעריכה את הערכים החזויים שנוצרו על ידי המודל ביחס לנתוני ההערכה.
כקלט, הפונקציה ML.EVALUATE מקבלת את המודל המאומן ואת השורות מהתצוגה input_data שבהן הערך של העמודה dataframe הוא evaluation. הפונקציה מחזירה שורה אחת של נתונים סטטיסטיים על המודל.
מריצים את השאילתה ML.EVALUATE:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה:
SELECT
*
FROM
ML.EVALUATE (MODEL `census.census_model`,
  (
  SELECT
    *
  FROM
    `census.input_data`
  WHERE
    dataframe = 'evaluation'
  )
);
התוצאות אמורות להיראות כך:

BigQuery DataFrames
משתמשים בפונקציה bigframes.bigquery.ml.evaluate כדי להעריך את המודל ביחס לנתונים בפועל.
לפני שתנסו את הדוגמה הזו, בצעו את הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה של BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
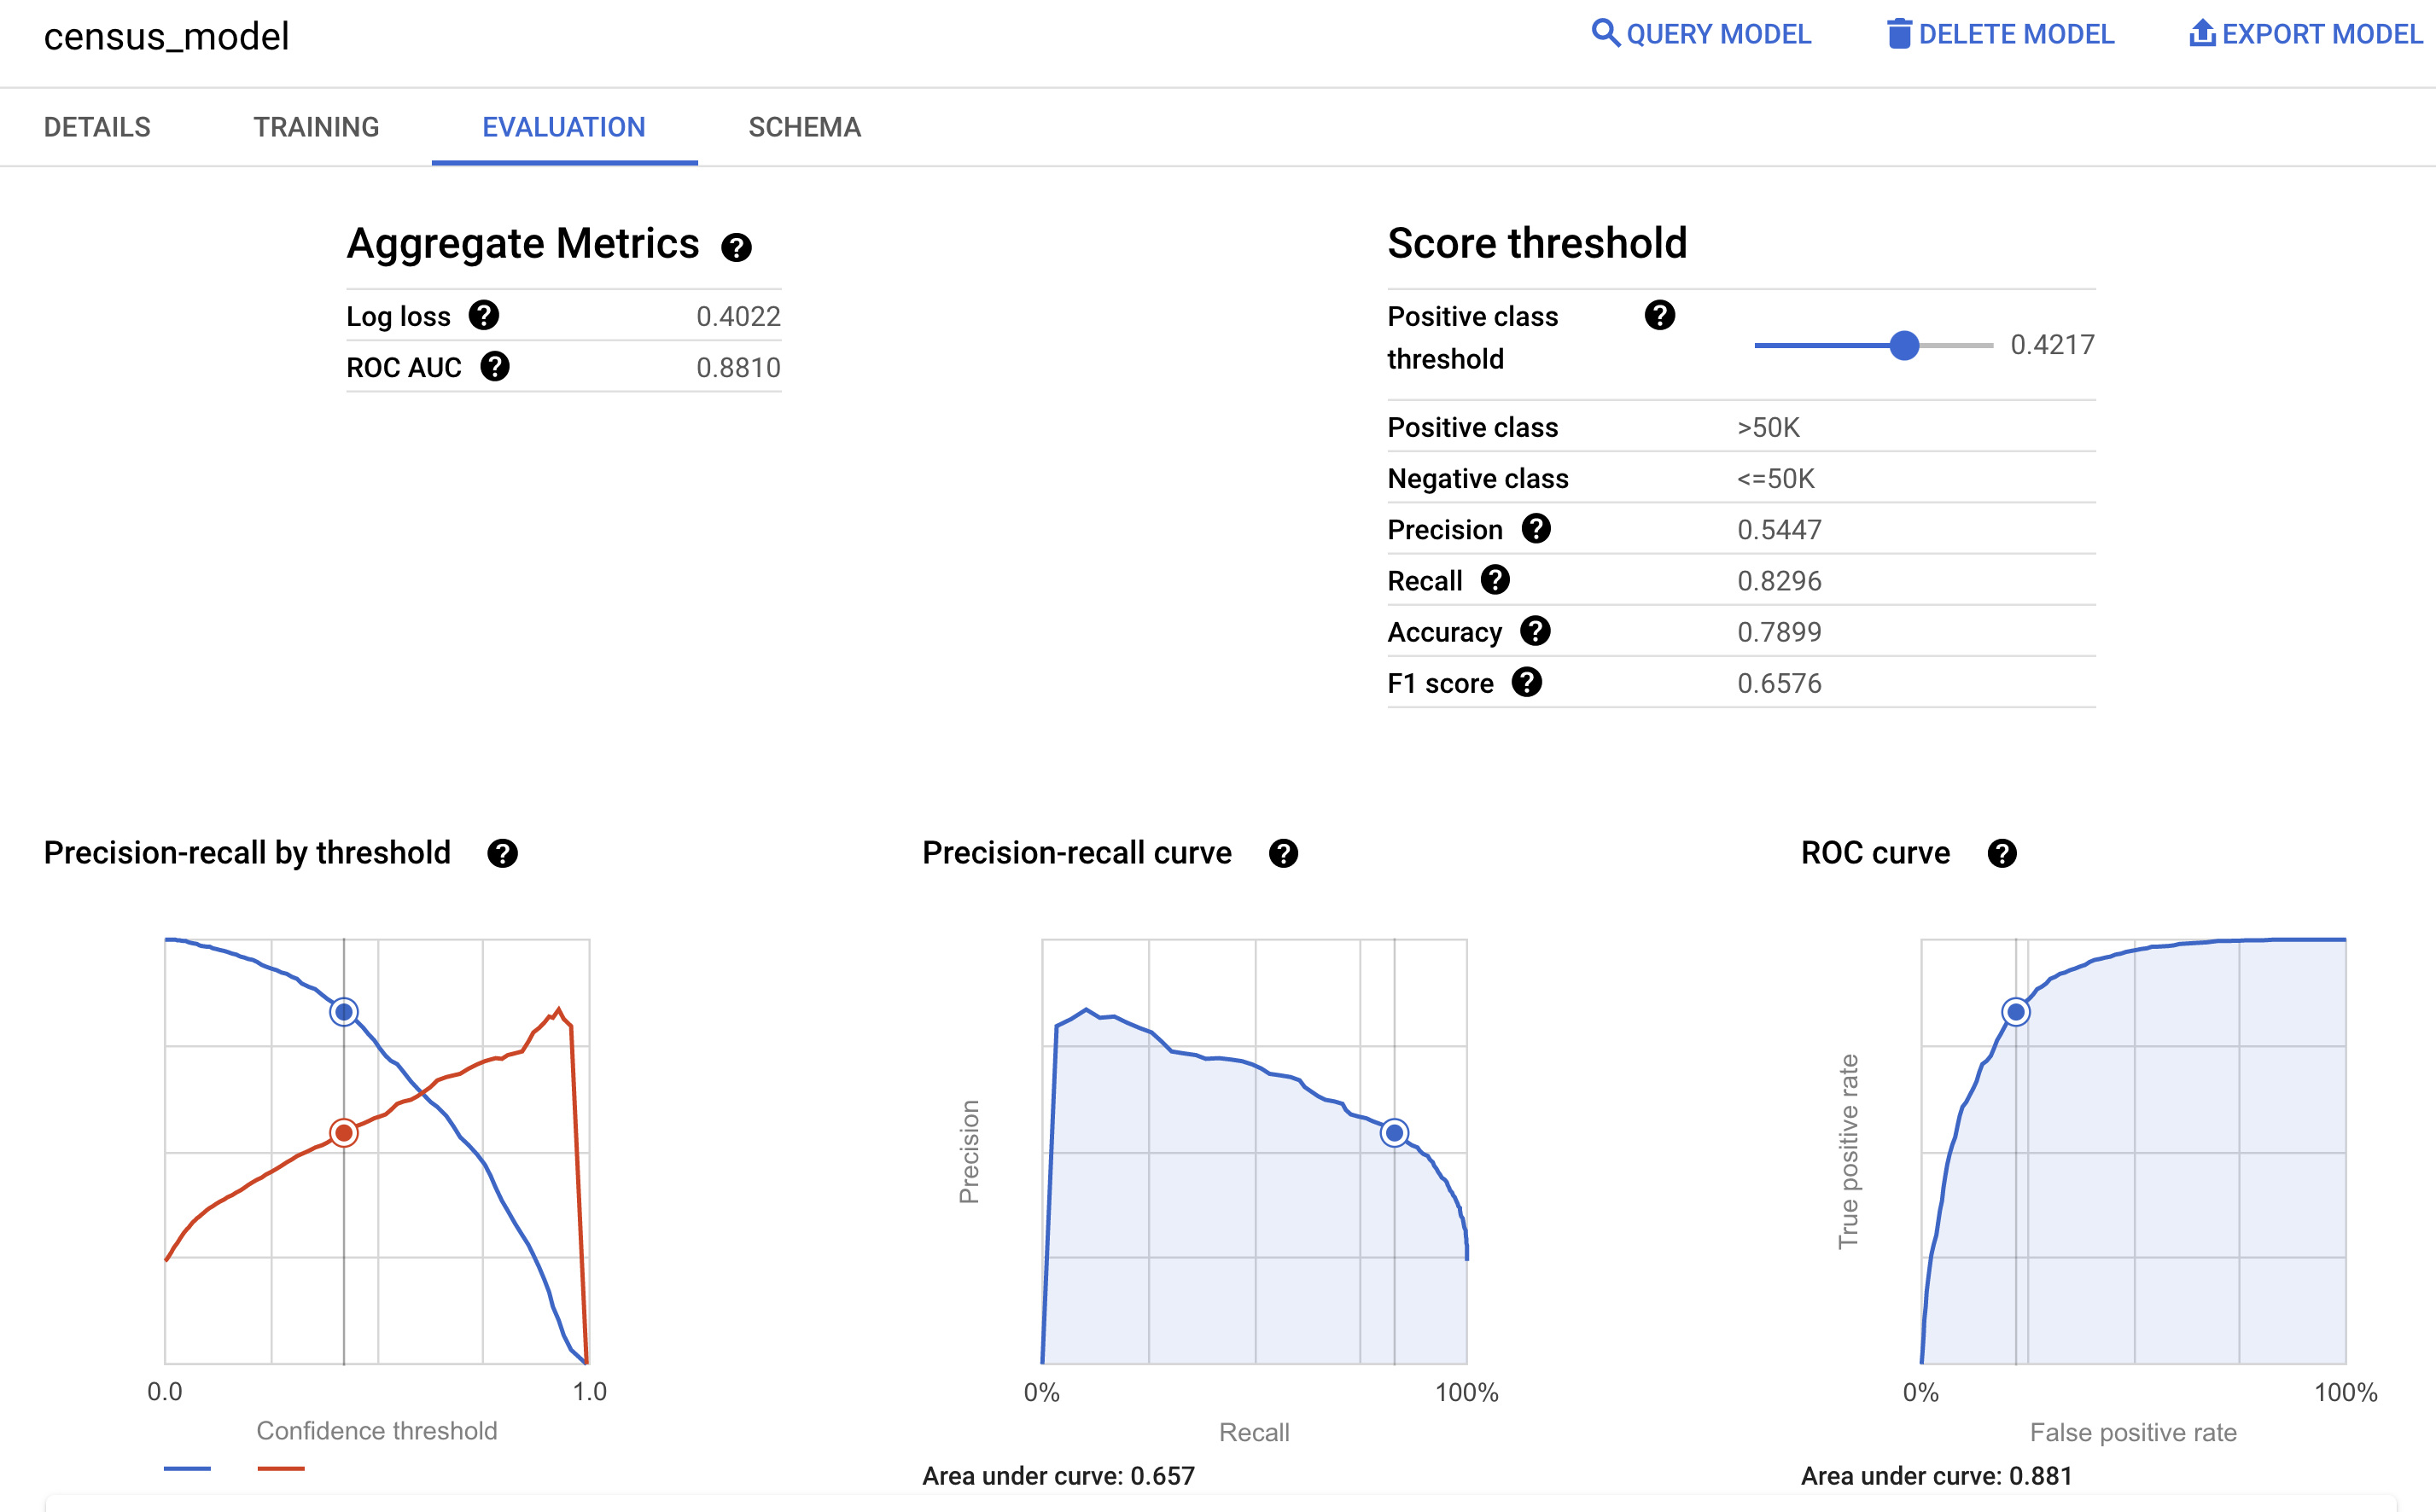
אפשר גם להסתכל בחלונית Evaluation של המודל במסוף Cloud de Confiance כדי לראות את מדדי ההערכה שחושבו במהלך האימון:
חיזוי קבוצת ההכנסה
משתמשים במודל כדי לחזות את קבוצת ההכנסה הסבירה ביותר לכל משיב.
SQL
משתמשים בפונקציה ML.PREDICT כדי לחזות את קבוצת ההכנסה הסבירה. כקלט, הפונקציה ML.PREDICT מקבלת את המודל המאומן ואת השורות מהתצוגה input_data שבהן הערך של העמודה dataframe הוא prediction.
מריצים את השאילתה ML.PREDICT:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה:
SELECT
*
FROM
ML.PREDICT (MODEL `census.census_model`,
  (
  SELECT
    *
  FROM
    `census.input_data`
  WHERE
    dataframe = 'prediction'
  )
);
התוצאות אמורות להיראות כך:
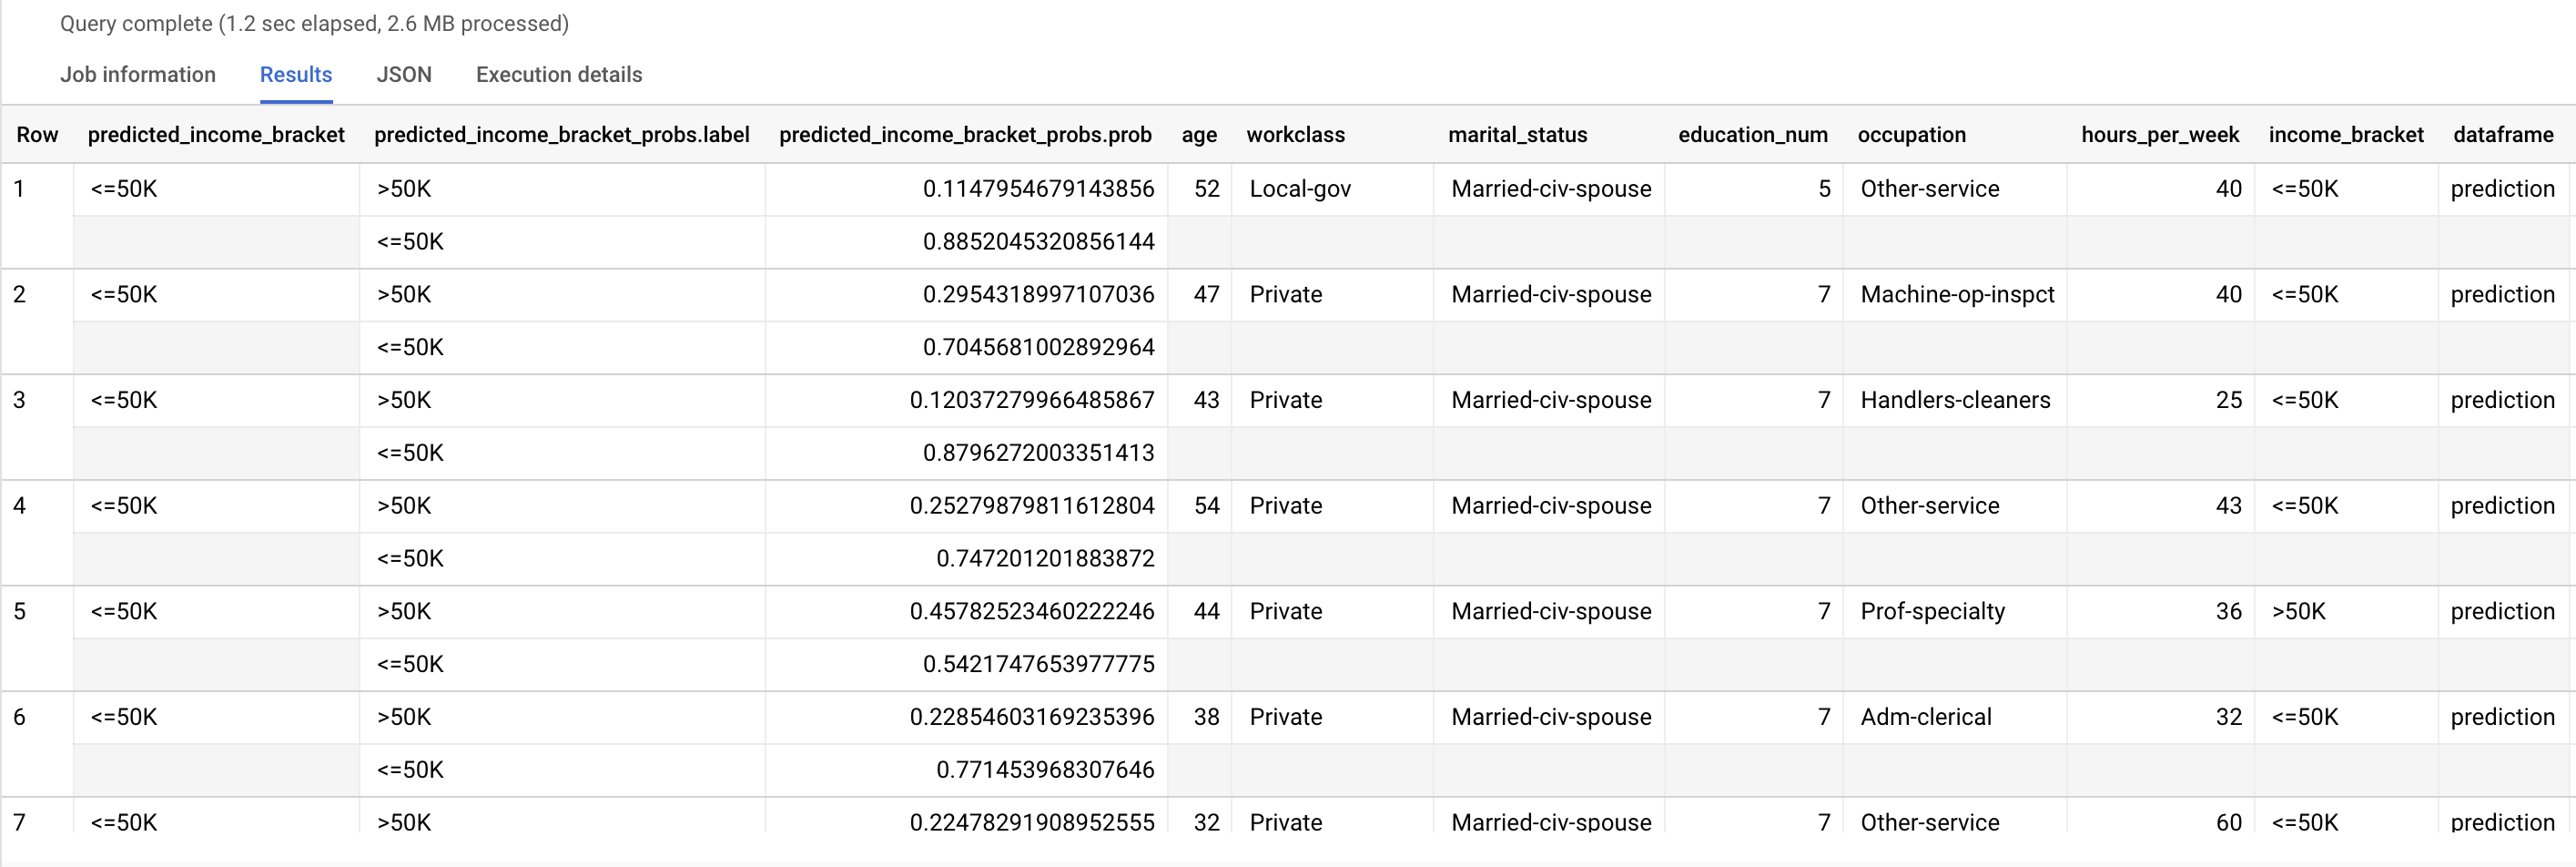
בעמודה predicted_income_bracket מופיעה קבוצת ההכנסה החזויה של המשיב.
BigQuery DataFrames
משתמשים בפונקציה bigframes.bigquery.ml.predict כדי לחזות את קבוצת ההכנסה הסבירה.
לפני שתנסו את הדוגמה הזו, בצעו את הוראות ההגדרה של BigQuery DataFrames שמפורטות במאמר התחלה מהירה של BigQuery באמצעות BigQuery DataFrames. מידע נוסף זמין במאמרי העזרה של BigQuery DataFrames.
כדי לבצע אימות ב-BigQuery, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת ADC לסביבת פיתוח מקומית.
הסבר על תוצאות החיזוי
כדי להבין למה המודל יוצר את תוצאות החיזוי האלה, אתם יכולים להשתמש בפונקציה ML.EXPLAIN_PREDICT.
הפונקציה ML.EXPLAIN_PREDICT היא גרסה מורחבת של הפונקציה ML.PREDICT.
הפונקציה ML.EXPLAIN_PREDICT לא רק מפיקה תוצאות חיזוי, אלא גם מפיקה עמודות נוספות שמסבירות את תוצאות החיזוי. למידע נוסף על יכולת ההסבר, קראו את סקירת AI ניתן להסברה ב-BigQuery ML.
מריצים את השאילתה ML.EXPLAIN_PREDICT:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה:
SELECT
*
FROM
ML.EXPLAIN_PREDICT(MODEL `census.census_model`,
  (
  SELECT
    *
  FROM
    `census.input_data`
  WHERE
    dataframe = 'evaluation'),
  STRUCT(3 as top_k_features));
התוצאות אמורות להיראות כך:
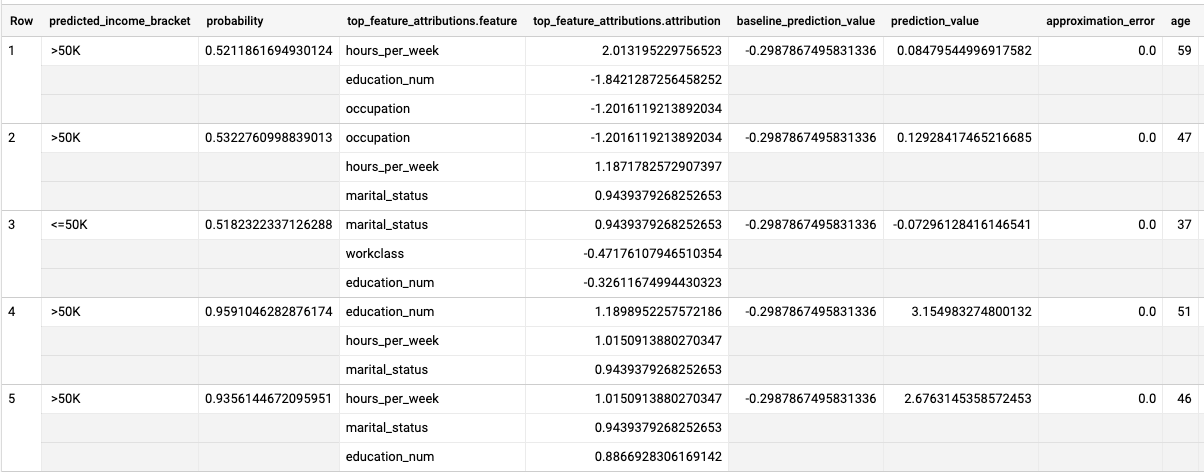
במודלים של רגרסיה לוגיסטית, ערכי Shapley משמשים לקביעת שיוך התכונות היחסי לכל תכונה במודל. מכיוון שהאפשרות top_k_features הוגדרה ל-3 בשאילתה, ML.EXPLAIN_PREDICT מפיק את שלושת שיוכי התכונות המובילים לכל שורה בתצוגה input_data. השיוכים האלה מוצגים בסדר יורד לפי הערך המוחלט של השיוך.
הסבר גלובלי על המודל
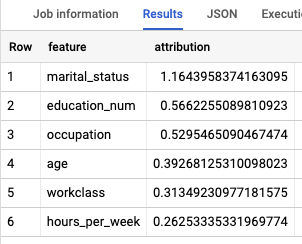
כדי לדעת אילו תכונות הכי חשובות לקביעת קבוצת ההכנסה, משתמשים בפונקציה ML.GLOBAL_EXPLAIN.
קבלת הסברים גלובליים למודל:
נכנסים לדף BigQuery במסוף Cloud de Confiance .
בעורך השאילתות, מריצים את השאילתה הבאה כדי לקבל הסברים גלובליים:
SELECT
  *
FROM
  ML.GLOBAL_EXPLAIN(MODEL `census.census_model`)
התוצאות אמורות להיראות כך:
הסרת המשאבים
כדי להימנע מחיובים בחשבון Google Cloud בגלל השימוש במשאבים שנעשה במסגרת המדריך הזה, אפשר למחוק את הפרויקט שמכיל את המשאבים או להשאיר את הפרויקט ולמחוק את המשאבים הנפרדים.
מחיקת מערך הנתונים
מחיקת הפרויקט תסיר את כל מערכי הנתונים ואת כל הטבלאות בפרויקט. אם אתם מעדיפים להשתמש שוב בפרויקט, אתם יכולים למחוק את מערך הנתונים שיצרתם במדריך הזה:
אם צריך, פותחים את הדף של BigQuery במסוףCloud de Confiance .
בתפריט הניווט, לוחצים על מערך הנתונים census שיצרתם.
לוחצים על מחיקת מערך הנתונים בצד שמאל של החלון. הפעולה הזו מוחקת את מערך הנתונים ואת המודל.
בתיבת הדו-שיח Delete dataset, מאשרים את פקודת המחיקה על ידי הקלדת שם מערך הנתונים (
census) ולוחצים על Delete.
מחיקת הפרויקט
כדי למחוק את הפרויקט:
- נכנסים לדף Manage resources במסוף Cloud de Confiance .
- ברשימת הפרויקטים, בוחרים את הפרויקט שרוצים למחוק ולוחצים על Delete.
- כדי למחוק את הפרויקט, כותבים את מזהה הפרויקט בתיבת הדו-שיח ולוחצים על Shut down.
המאמרים הבאים
- לסקירה כללית על BigQuery ML, קראו את המאמר מבוא ל-BigQuery ML.
- למידע על יצירת מודלים, קראו את דף התחביר של
CREATE MODEL.