

Im Rahmen von Abfragejobs enthält BigQuery einen Diagnoseabfrageplan und Zeitinformationen. Dies ähnelt den Informationen, die von Anweisungen wie EXPLAIN in anderen Datenbank- und Analysesystemen bereitgestellt werden. Diese Informationen können aus den API-Antworten von Methoden wie jobs.get abgerufen werden.
Bei Abfragen mit langer Ausführungszeit aktualisiert BigQuery diese Statistiken regelmäßig. Diese Aktualisierungen erfolgen unabhängig von der Häufigkeit, mit der der Jobstatus abgefragt wird, aber in der Regel nicht häufiger als alle 30 Sekunden. Abfragejobs, die keine Ausführungsressourcen verwenden (zum Beispiel Probelaufanfragen oder Ergebnisse, die mithilfe von im Cache gespeicherten Ergebnissen bereitgestellt werden können), enthalten diese zusätzlichen Diagnoseinformationen nicht. Andere Statistiken können jedoch vorhanden sein.
Hintergrund
Wenn BigQuery eine Abfrage ausführt, wird die SQL-Anweisung in einen Ausführungsgraphen umgewandelt, der aus Phasen besteht. Phasen bestehen aus Schritten, den grundlegenden Vorgängen, die die Logik der Abfrage ausführen. BigQuery nutzt eine stark verteilte parallele Architektur, die Phasen parallel ausführt, um die Latenz zu reduzieren. Die Phasen kommunizieren über Shuffle, eine schnelle verteilte Speicherarchitektur, miteinander.
Im Abfrageplan werden die Begriffe Arbeitseinheiten und Worker verwendet, um die Parallelisierung von Phasen zu beschreiben. An anderer Stelle in BigQuery kann der Begriff Slot vorkommen, bei dem es sich um eine abstrahierte Darstellung mehrerer Aspekte der Abfrageausführung handelt, einschließlich Rechen-, Speicher- und E/A-Ressourcen. Slots führen die einzelnen Arbeitseinheiten einer Phase parallel aus. Jobstatistiken der obersten Ebene liefern die Kosten einzelner Abfragen. Dafür wird totalSlotMs auf Grundlage dieser abstrahierten Ressourcenerfassung genutzt.
Ein weiteres wichtiges Merkmal der Abfrageausführung ist, dass BigQuery den Abfrageplan während der Ausführung einer Abfrage ändern kann. BigQuery führt beispielsweise Repartition-Phasen ein, um die Datenverteilung zwischen den Workern der Abfrage zu verbessern. Dadurch wird die Parallelität verbessert und die Abfragelatenz verringert.
Neben dem Abfrageplan stellen Abfragejobs auch eine Zeitachse für die Ausführung bereit, in der die abgeschlossenen, ausstehenden und aktiven Arbeitseinheiten aufgeführt sind. Eine Abfrage kann sich gleichzeitig in mehreren Phasen mit aktiven Workern befinden. Die Zeitachse dient dazu, den Gesamtfortschritt der Abfrage anzuzeigen.
Ausführungsgrafik in der Cloud de Confiance Console ansehen
In der Cloud de Confiance Console können Sie Details zum Abfrageplan für eine abgeschlossene Abfrage anzeigen lassen. Klicken Sie hierzu auf den Button Ausführungsdetails.
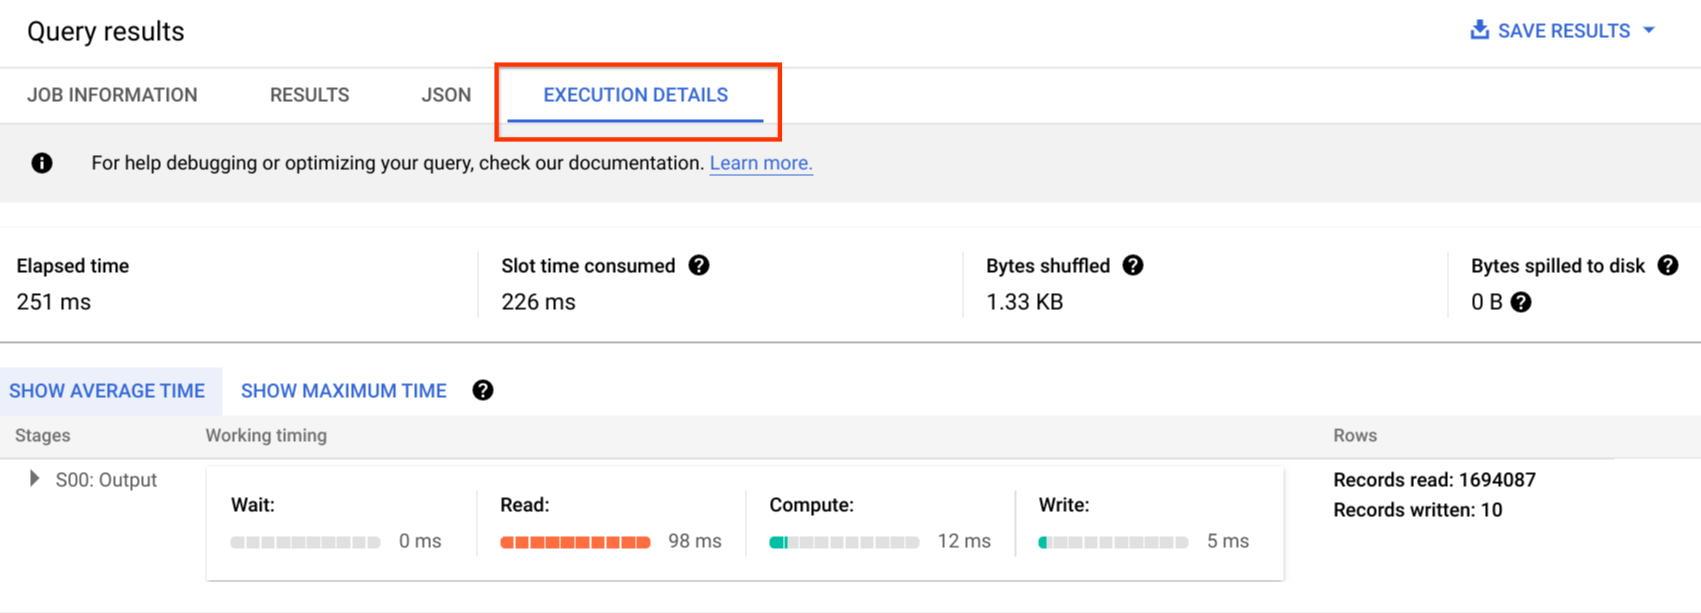
Informationen des Abfrageplans
Innerhalb der API-Antwort werden Abfragepläne als Liste von Abfragephasen dargestellt. Jedes Element in der Liste enthält eine Übersichtsstatistik pro Phase, detaillierte Informationen zu jedem Schritt und zeitliche Klassifizierungen der Phasen. In der Cloud de Confiance Console werden nicht alle Details gerendert, können aber in den API-Antworten enthalten sein.
Ausführungsgrafik verstehen
In der Cloud de Confiance Console können Sie die Details des Abfrageplans aufrufen, indem Sie auf den Tab Ausführungsgrafik klicken.
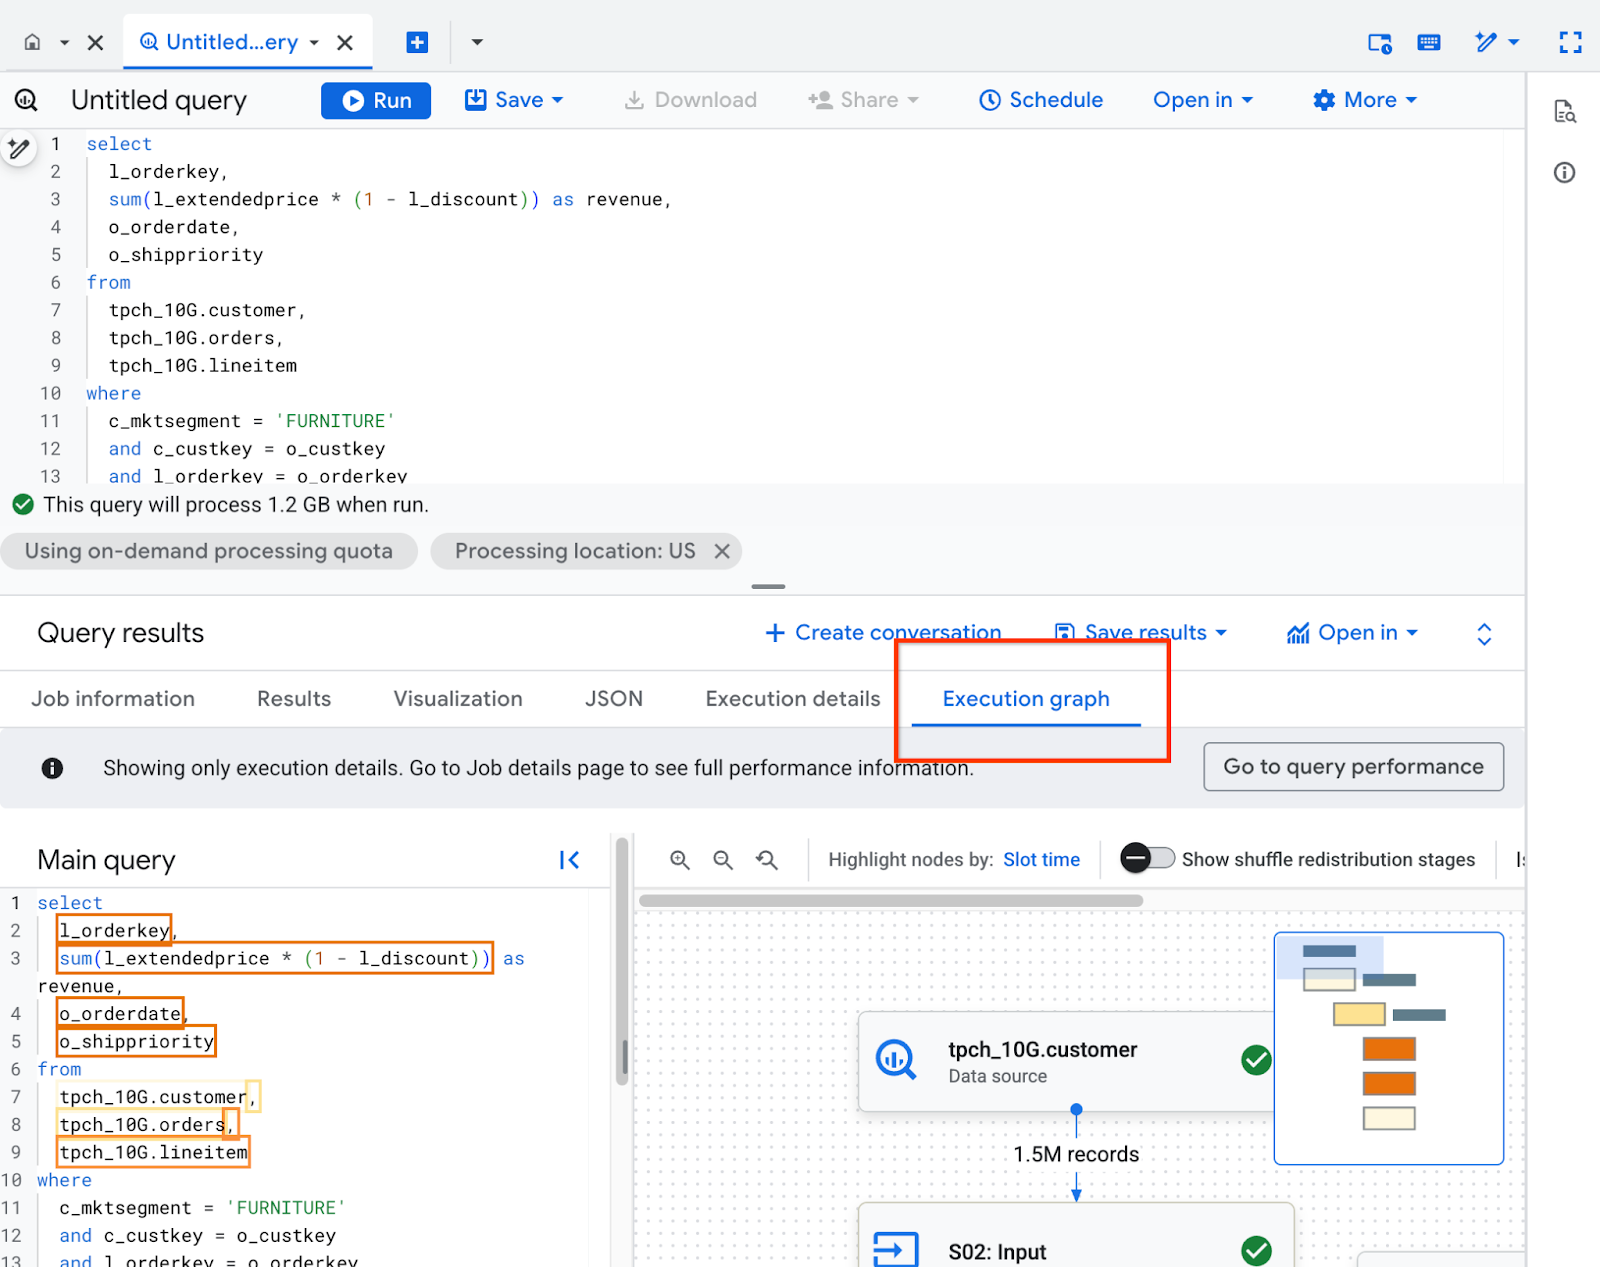
Das Steuerfeld Ausführungsgrafik ist so aufgebaut:
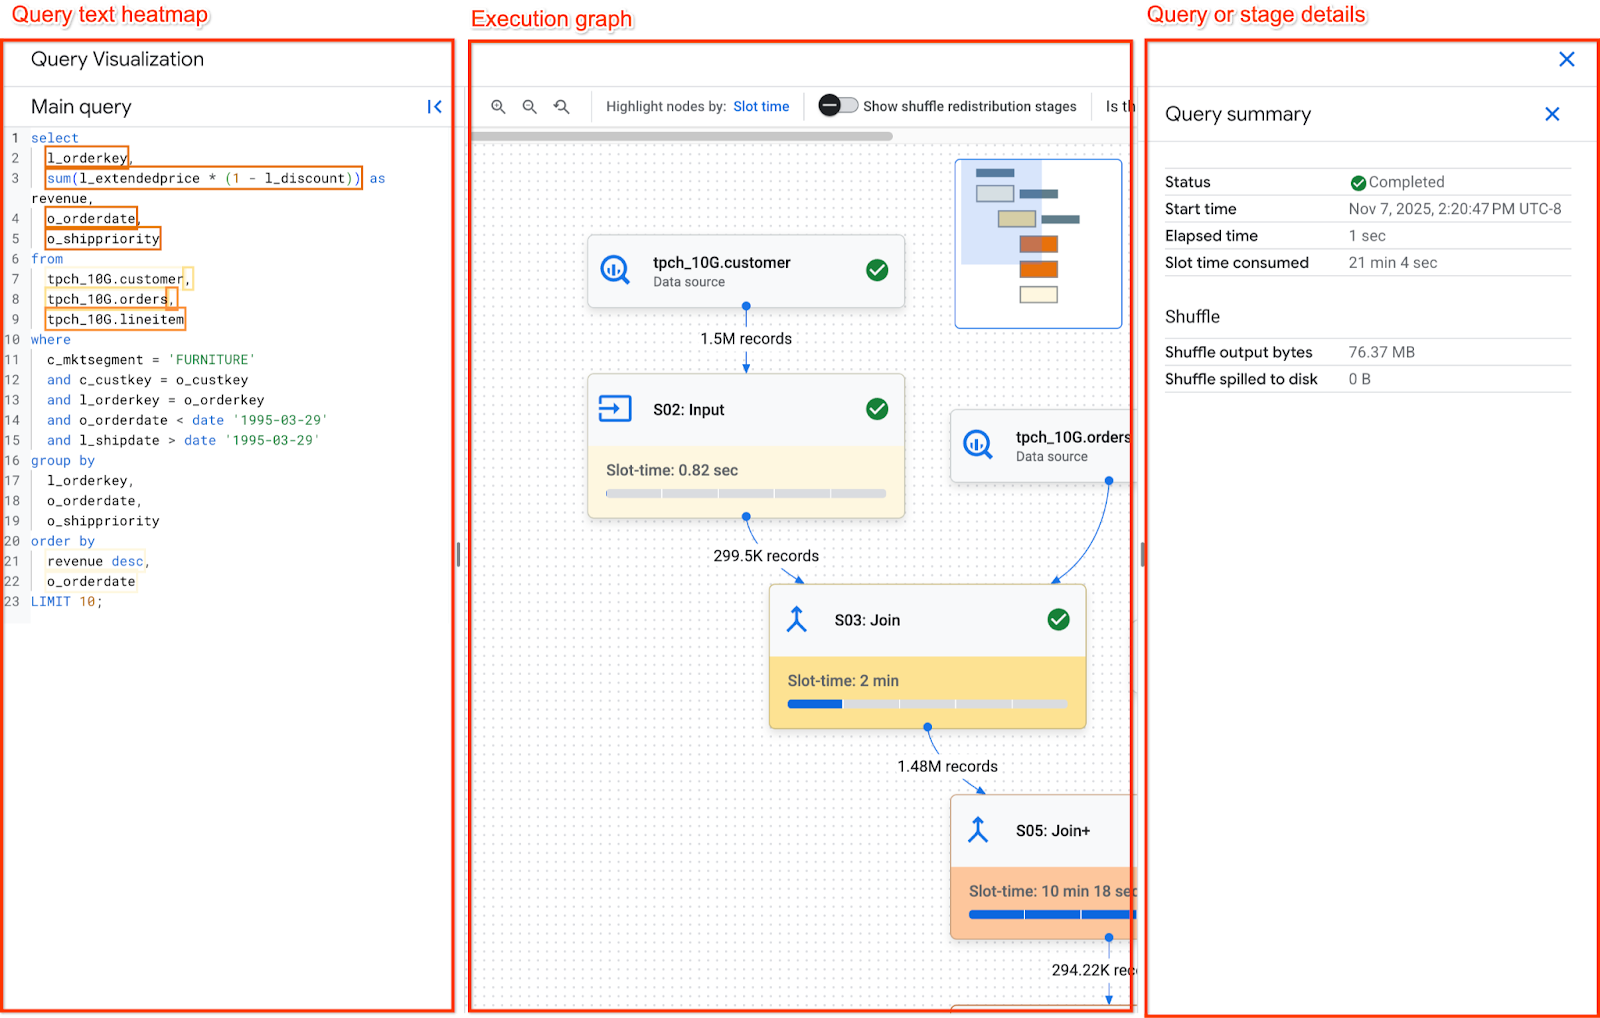
- In der Mitte befindet sich die Ausführungsgrafik. Phasen werden als Knoten und der zwischen den Phasen ausgetauschte Shuffle-Arbeitsspeicher als Kanten angezeigt.
- Im linken Bereich befindet sich die Heatmap für den Abfragetext. Es wird der Hauptabfragetext angezeigt, der von der Abfrage ausgeführt wurde, sowie alle referenzierten Ansichten.
- Im rechten Bereich finden Sie die Abfrage- oder Phasendetails.
In der Ausführungsgrafik navigieren
Im Ausführungsgraphen wird ein Farbschema auf die Knoten im Graphen angewendet, das auf der Slotzeit basiert. Knoten mit einem dunkleren Rot nehmen im Vergleich zu den anderen Phasen im Graphen mehr Slotzeit in Anspruch.
So können Sie sich in der Ausführungsgrafik bewegen:
- Klicken Sie auf den Hintergrund des Diagramms und halten Sie die Maustaste gedrückt, um zu anderen Bereichen des Diagramms zu schwenken.
- Mit dem Scrollrad der Maus können Sie in der Grafik heran- und herauszoomen.
- Klicken Sie oben rechts auf die Minikarte und halten Sie die Maustaste gedrückt, um zu verschiedenen Bereichen des Diagramms zu schwenken.
Wenn Sie auf eine Phase in der Grafik klicken, werden die Details der ausgewählten Phase angezeigt. Die Phasendetails enthalten:
- Statistiken. Weitere Informationen zu den Statistiken finden Sie unter Phasenübersicht.
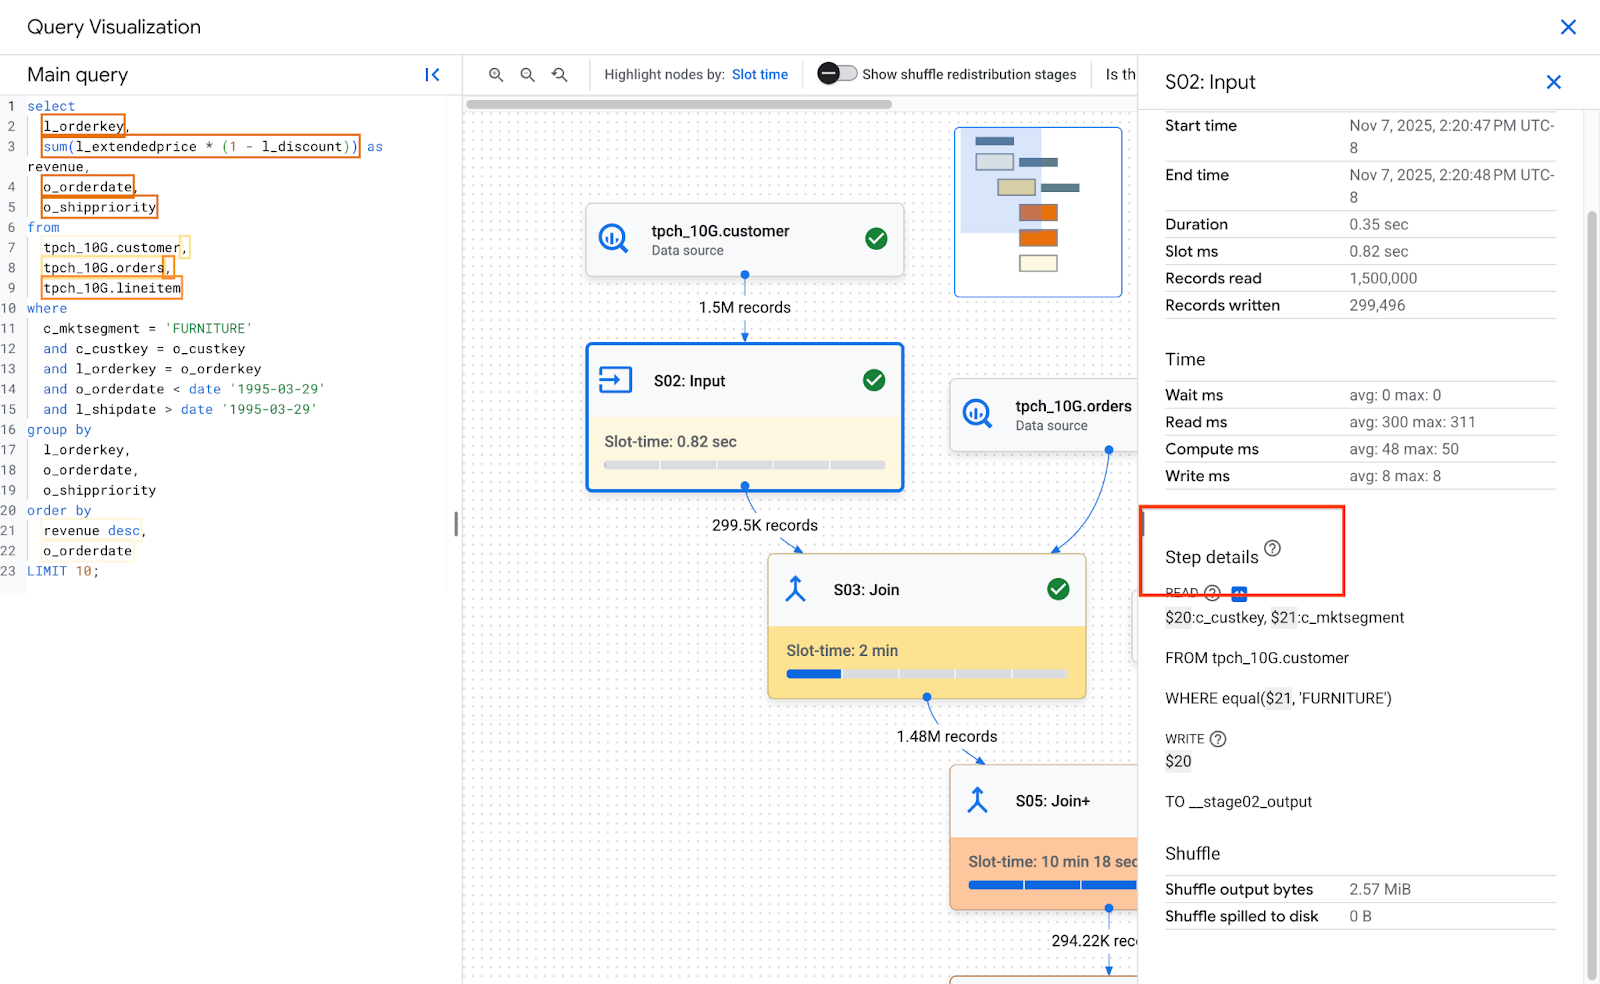
- Details zum Schritt. Schritte beschreiben die einzelnen Vorgänge, die die Logik der Abfrage ausführen.
Details zum Schritt
Phasen bestehen aus Schritten, den einzelnen Vorgängen, die die Logik der Abfrage ausführen. Schritte haben Unterschritte, die beschreiben, was der Schritt im Pseudocode getan hat. In Unterschritten werden Variablen verwendet, um Beziehungen zwischen Schritten zu beschreiben. Variablen beginnen mit einem Dollarzeichen, gefolgt von einer eindeutigen Zahl. Variablenwerte werden nicht zwischen Phasen geteilt.
Die folgende Abbildung zeigt die Schritte einer Phase:
Hier ein Beispiel für die Schritte einer Phase:
  READ
  $30:l_orderkey, $31:l_quantity
  FROM lineitem

  AGGREGATE
  GROUP BY $100 := $30
  $70 := SUM($31)

  WRITE
  $100, $70
  TO __stage00_output
  BY HASH($100)
In den Schritten des Beispiels wird Folgendes beschrieben:
- In der Phase wurden die Spalten „l_orderkey“ und „l_quantity“ aus der Tabelle „lineitem“ gelesen und die Werte in den Variablen $30 bzw. $31 gespeichert.
- In der Phase wurden die Variablen $30 und $31 aggregiert und die Aggregationen in den Variablen $100 bzw. $70 gespeichert.
- In der Phase wurden die Ergebnisse der Variablen $100 und $70 in den Shuffle geschrieben. In der Phase wurden die Ergebnisse im Shuffle-Speicher basierend auf $100 sortiert.
Ausführliche Informationen zu den Arten von Schritten und zu ihrer Optimierung finden Sie unter Schritte interpretieren und optimieren.
BigQuery kürzt Teilschritte möglicherweise, wenn der Ausführungsgraph der Abfrage so komplex war, dass die Bereitstellung vollständiger Teilschritte beim Abrufen von Abfrageinformationen zu Problemen mit der Nutzlastgröße führen würde.
Heatmap des Abfragetexts
BigQuery kann einige Phasenschritte Teilen des Abfragetexts zuordnen. In der Heatmap des Abfragetexts wird der gesamte entsprechende Abfragetext mit Phasenschritten angezeigt. Der Abfragetext wird basierend auf der gesamten Slotzeit der Phasen hervorgehoben, deren Schritte zugeordneten Abfragetext haben.
In der folgenden Abbildung ist der hervorgehobene Abfragetext zu sehen:
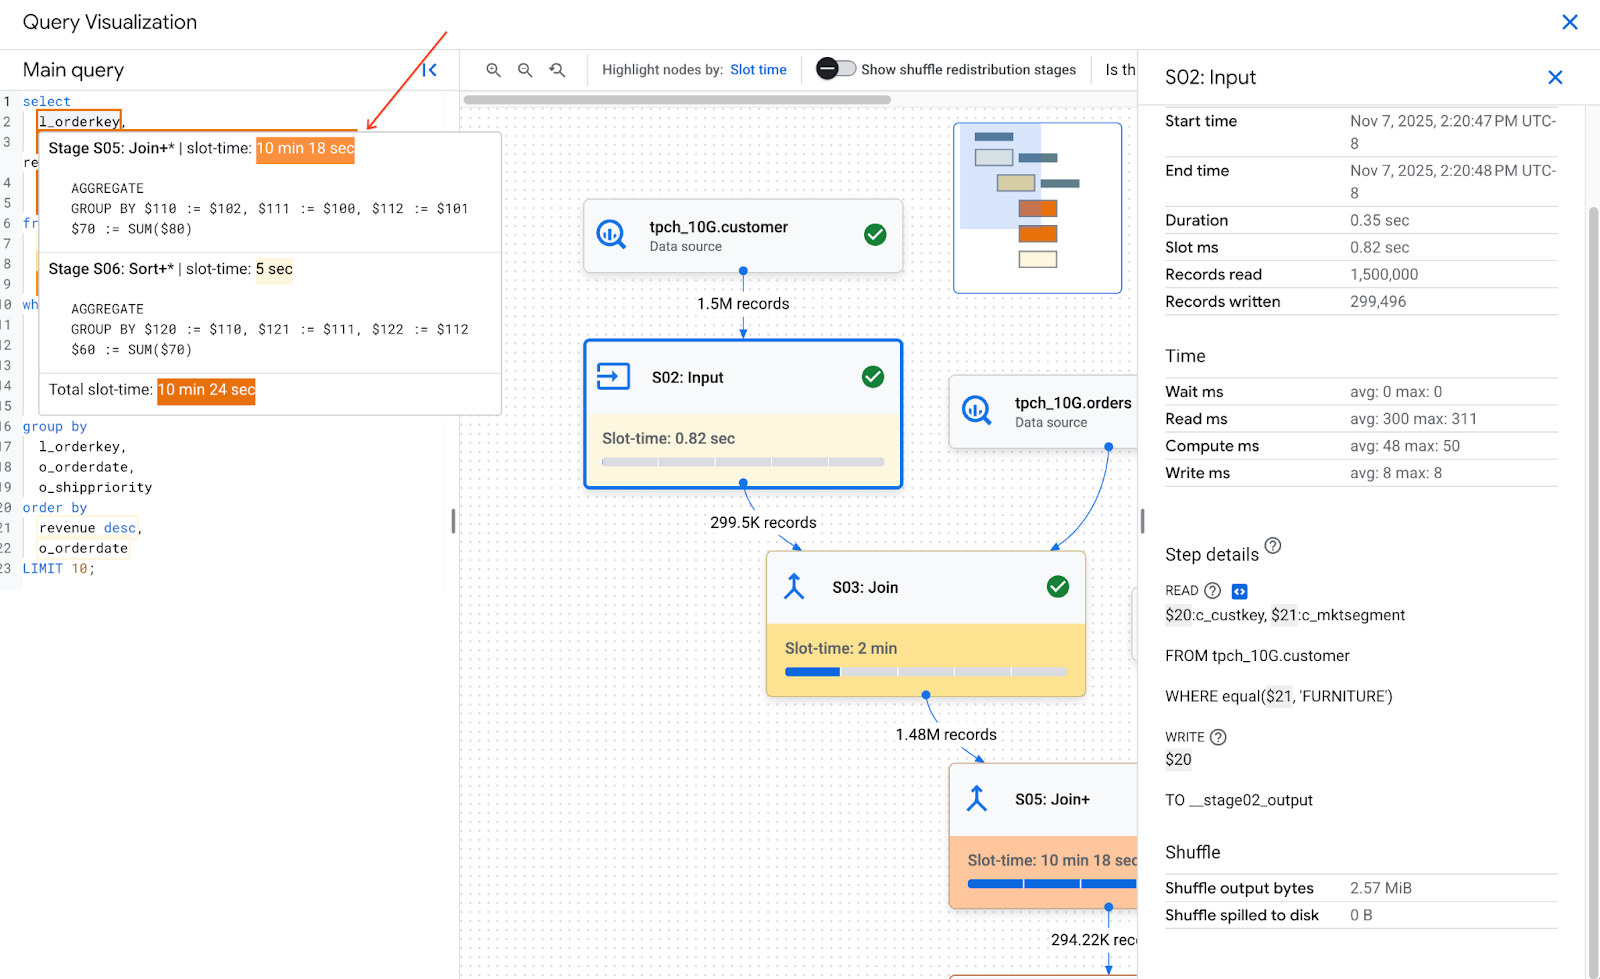
Wenn Sie den Mauszeiger auf einen zugeordneten Teil des Abfragetexts bewegen, wird eine Kurzinfo mit allen Phasenschritten angezeigt, die dem Abfragetext zugeordnet sind, sowie die Slotzeit der Phase. Wenn Sie auf einen zugeordneten Abfragetext klicken, wird die Phase im Ausführungsgraphen ausgewählt und die Phasendetails werden im rechten Bereich geöffnet.
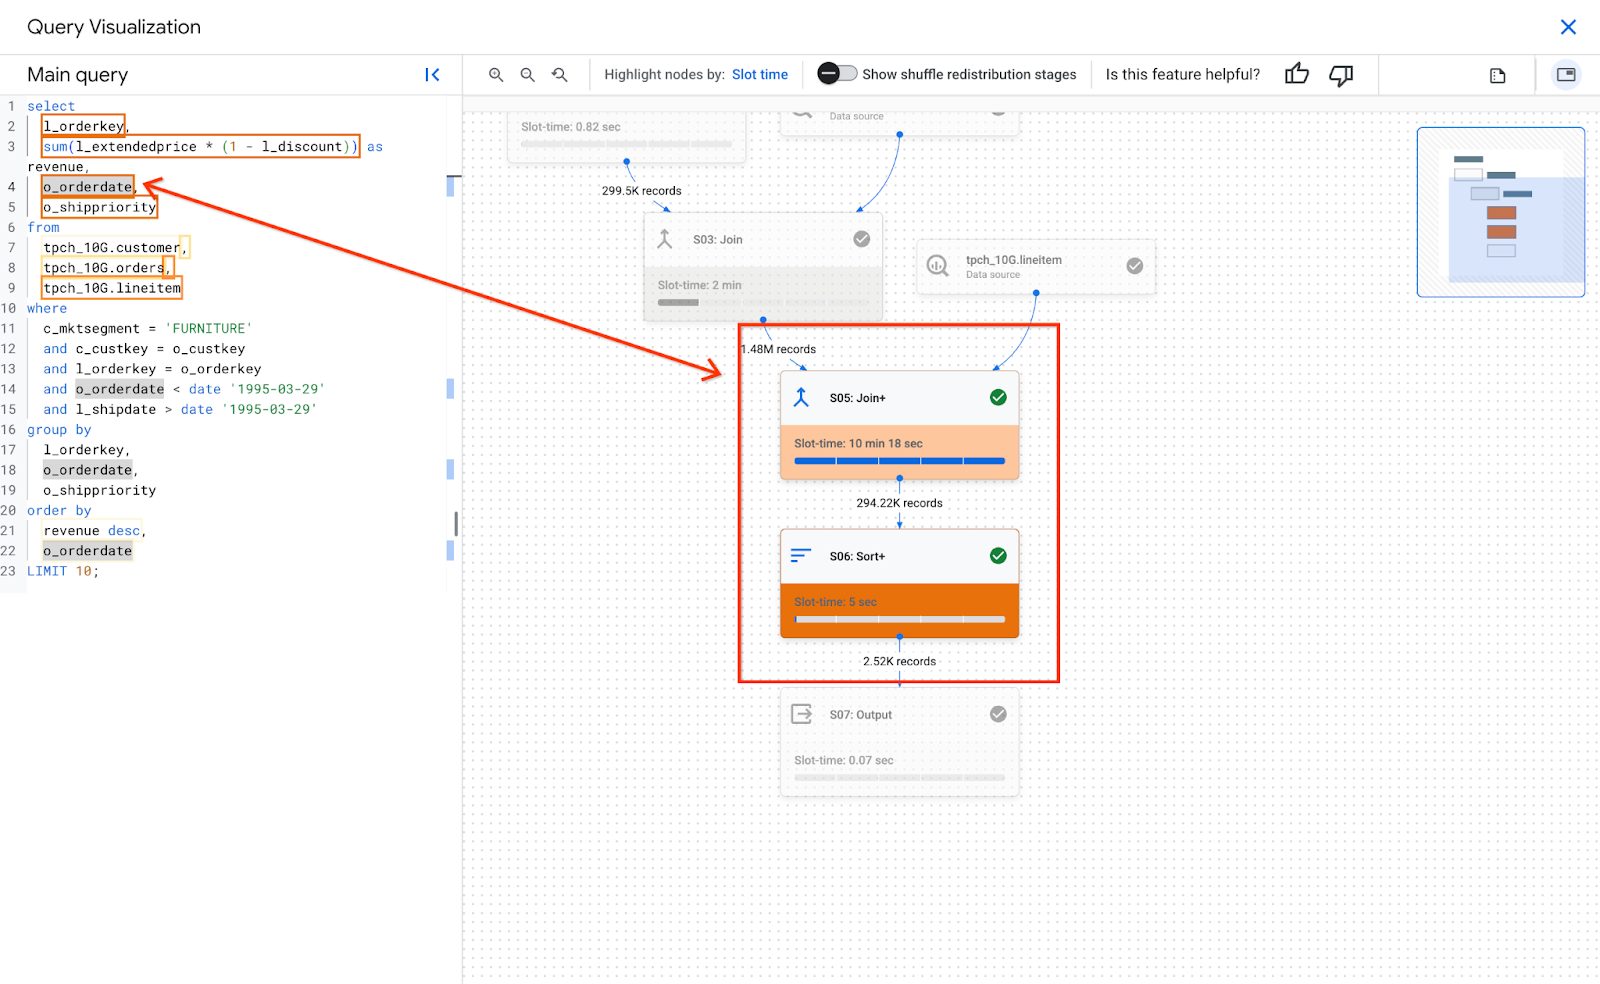
Ein einzelner Teil des Abfragetextes kann mehreren Phasen zugeordnet werden. In der Kurzinfo werden die einzelnen zugeordneten Phasen und die jeweilige Slot-Zeit aufgeführt. Wenn Sie auf den Abfragetext klicken, werden die entsprechenden Phasen hervorgehoben und der Rest des Diagramms wird ausgegraut. Wenn Sie anschließend auf eine bestimmte Phase klicken, werden die zugehörigen Details angezeigt.
Die folgende Abbildung zeigt, wie der Abfragetext mit den Schrittdetails zusammenhängt:
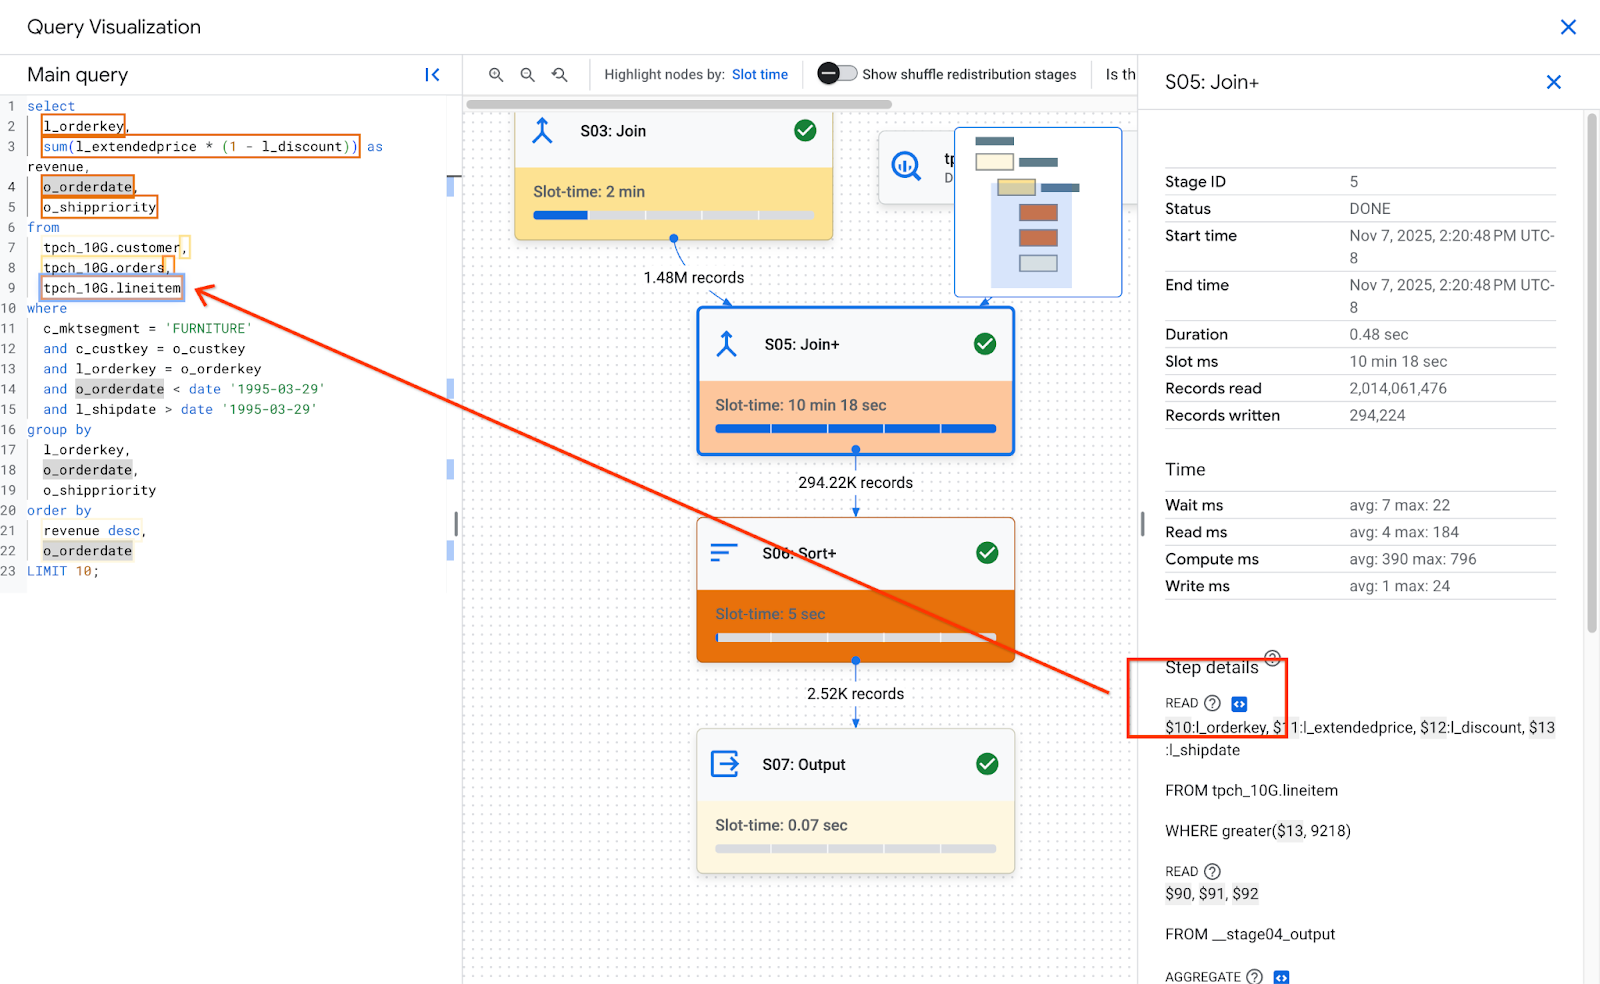
Wenn ein Schritt im Abschnitt Schrittdetails einer Phase einem Abfragetext zugeordnet ist, hat der Schritt ein Codesymbol. Wenn Sie auf das Codesymbol klicken, wird der zugeordnete Teil des Abfragetexts links hervorgehoben.
Beachten Sie, dass die Heatmap-Farbe auf der Slot-Zeit der gesamten Phase basiert. Da BigQuery die Slot-Zeit von Schritten nicht misst, stellt die Heatmap nicht die tatsächliche Slot-Zeit für diesen bestimmten Teil des zugeordneten Abfragetexts dar. In den meisten Fällen wird in einer Phase nur ein einziger komplexer Schritt ausgeführt, z. B. ein Join oder eine Aggregation. Die Farbe der Heatmap ist also angemessen. Wenn eine Phase jedoch aus Schritten besteht, die mehrere komplexe Vorgänge ausführen, kann die Heatmap-Farbe die tatsächliche Slotzeit in der Heatmap überrepräsentieren. In solchen Fällen ist es wichtig, die anderen Schritte zu verstehen, aus denen die Phase besteht, um ein vollständigeres Verständnis der Abfrageleistung zu erhalten.
Wenn in einer Abfrage Ansichten verwendet werden und die Schritte der Phase Zuordnungen zum Abfragetext einer Ansicht haben, werden in der Heatmap für den Abfragetext der Name der Ansicht und der Abfragetext der Ansicht mit ihren Zuordnungen angezeigt. Wenn die Ansicht jedoch gelöscht wird oder Sie die bigquery.tables.get IAM-Berechtigung für die Ansicht verlieren, werden in der Heatmap des Abfragetexts die Zuordnungen der Phasen für die Ansicht nicht angezeigt.
Phasenübersicht
Die Übersichtsfelder für jede Phase können Folgendes enthalten:
| API-Feld | Beschreibung |
|---|---|
id |
Eindeutige numerische ID für die Phase. |
name |
Einfacher zusammenfassender Name für die Phase. Die steps innerhalb der Phase liefern zusätzliche Details zu den Ausführungsschritten. |
status |
Ausführungsstatus der Phase. Folgende Status sind möglich: PENDING, RUNNING, COMPLETE, FAILED und CANCELLED. |
inputStages |
Eine Liste der IDs, die die Abhängigkeitsgrafik der Phase bilden. Eine JOIN-Phase benötigt zum Beispiel oft zwei abhängige Phasen, die die Daten auf der linken und rechten Seite der JOIN-Beziehung vorbereiten. |
startMs |
Zeitstempel in Millisekunden der Epoche, der angibt, wann der erste Worker in der Phase mit der Ausführung begonnen hat. |
endMs |
Zeitstempel in Millisekunden der Epoche, der angibt, wann der letzte Worker die Ausführung abgeschlossen hat. |
steps |
Detaillierte Liste der Ausführungsschritte innerhalb der Phase. Weitere Informationen finden Sie im nächsten Abschnitt. |
recordsRead |
Eingabegröße der Phase als Anzahl der Datensätze aller Worker der Phase. |
recordsWritten |
Ausgabegröße der Phase als Anzahl der Datensätze aller Worker der Phase. |
parallelInputs |
Anzahl der parallelisierbaren Arbeitseinheiten für die Phase. Je nach Phase und Abfrage kann hiermit die Anzahl der Spaltensegmente innerhalb einer Tabelle oder die Anzahl der Partitionen innerhalb eines Zwischen-Shuffles dargestellt sein. |
completedParallelInputs |
Anzahl der Arbeitseinheiten innerhalb der Phase, die abgeschlossen wurden. Bei einigen Abfragen müssen nicht alle Eingaben in einer Phase abgeschlossen sein, damit die Phase abgeschlossen werden kann. |
shuffleOutputBytes |
Stellt die Gesamtzahl der Byte dar, die in allen Workern in einer Abfragephase geschrieben wurden. |
shuffleOutputBytesSpilled |
Abfragen, die erhebliche Datenmengen zwischen Phasen übertragen, müssen möglicherweise auf eine laufwerkbasierte Übertragung zurückgreifen. Die Statistik zur Menge der übergebenen Byte informiert darüber, wie viele Daten an das Laufwerk übergeben wurden. Hängt von einem Optimierungsalgorithmus ab und ist daher für eine bestimmte Abfrage nicht deterministisch. |
Zeitliche Klassifizierung pro Phase
Die Abfragephasen ermöglichen auch eine zeitliche Klassifizierung, sowohl in absoluter als auch relativer Form. Da jede Ausführungsphase Aktivitäten von einem oder mehreren unabhängigen Workern beinhaltet, werden sowohl die durchschnittliche als auch die längste Zeitdauer angegeben. Diese Werte geben die durchschnittliche Leistung aller Worker einer Phase sowie die Leistung des langsamsten Workers einer bestimmten Klassifizierung wieder. Die durchschnittliche und maximale Zeitdauer wird darüber hinaus absolut und relativ dargestellt. Bei den verhältnisbasierten Statistiken werden die Daten als Anteil der längsten Zeit geliefert, die ein Worker in einem Segment verbracht hat.
In der Cloud de Confiance Console werden die zeitlichen Informationen der Phasen mithilfe relativer Zeitdarstellungen angegeben.
Die zeitlichen Informationen der Phasen werden folgendermaßen dargestellt:
| Relative Zeitdauer | Absolute Zeitdauer | Verhältniszähler |
|---|---|---|
waitRatioAvg |
waitMsAvg |
Zeit, die der durchschnittliche Worker auf die Planung gewartet hat. |
waitRatioMax |
waitMsMax |
Zeit, die der langsamste Worker auf die Planung gewartet hat. |
readRatioAvg |
readMsAvg |
Zeit, die der durchschnittliche Worker mit dem Lesen von Eingabedaten verbracht hat. |
readRatioMax |
readMsMax |
Zeit, die der langsamste Worker mit dem Lesen von Eingabedaten verbracht hat. |
computeRatioAvg |
computeMsAvg |
Zeit, die der durchschnittliche Worker CPU-gebunden verbracht hat. |
computeRatioMax |
computeMsMax |
Zeit, die der langsamste Worker CPU-gebunden verbracht hat. |
writeRatioAvg |
writeMsAvg |
Zeit, die der durchschnittliche Worker mit dem Schreiben von Ausgabedaten verbracht hat. |
writeRatioMax |
writeMsMax |
Zeit, die der langsamste Worker mit dem Schreiben von Ausgabedaten verbracht hat. |
Schrittübersicht
Schritte enthalten die Vorgänge, die jeder Worker innerhalb einer Phase ausführt, dargestellt als sortierte Liste von Vorgängen. Jeder Schrittvorgang hat eine Kategorie, wobei einige Vorgänge detailliertere Informationen liefern. Der Abfrageplan enthält die folgenden Vorgangskategorien:
| Schrittkategorie | Beschreibung |
|---|---|
READ |
Ein Lesevorgang von einer oder mehreren Spalten aus einer Eingabetabelle oder einem Zwischen-Shuffle. In den Schrittdetails werden nur die ersten sechzehn Spalten, die gelesen werden, zurückgegeben. |
WRITE |
Ein Schreibvorgang von einer oder mehreren Spalten in eine Ausgabetabelle oder ein Zwischen-Shuffle. Bei HASH-partitionierten Ausgaben aus einer Phase umfasst dies auch die Spalten, die als Partitionsschlüssel verwendet werden. |
COMPUTE |
Auswertung von Ausdrücken und SQL-Funktionen. |
FILTER |
Wird von den Klauseln WHERE, OMIT IF und HAVING verwendet. |
SORT |
ORDER BY-Vorgang, der die Spaltenschlüssel und die Sortierreihenfolge enthält. |
AGGREGATE |
Implementiert Aggregationen für Klauseln wie GROUP BY oder COUNT. |
LIMIT |
Implementiert die LIMIT-Klausel. |
JOIN |
Implementiert Joins für Klauseln wie JOIN und enthält den Join-Typ und möglicherweise die Join-Bedingungen. |
ANALYTIC_FUNCTION |
Ein Aufruf einer Fensterfunktion (auch als "Analysefunktion" bezeichnet). |
USER_DEFINED_FUNCTION |
Ein Aufruf einer benutzerdefinierten Funktion. |
UPDATE |
Ändert vorhandene Zeilen in einer Zieltabelle für eine UPDATE-Anweisung. Enthält die geänderten Spalten und die Zieltabelle. |
DELETE |
Entfernt Zeilen aus einer Zieltabelle für eine DELETE-Anweisung; enthält die referenzierten Spalten und die Zieltabelle. |
MERGE |
Ändert Zeilen in einer Zieltabelle für eine MERGE-Anweisung. Enthält die geänderten Spalten und die Zieltabelle. |
EXPORT |
Schreibt Ausgabespalten in eine Zieltabelle für Anweisungen der Datenbearbeitungssprache (DML) oder Abfrageergebnisexporte. |
Schritte interpretieren und optimieren
In den folgenden Abschnitten wird erläutert, wie Sie die Schritte in einem Abfrageplan interpretieren und wie Sie Ihre Abfragen optimieren können.
Schritt READ
Der Schritt READ bedeutet, dass eine Phase auf Daten zur Verarbeitung zugreift. Daten können direkt aus den in einer Abfrage referenzierten Tabellen oder aus dem Shuffle-Speicher gelesen werden.
Wenn Daten aus einer vorherigen Phase gelesen werden, liest BigQuery Daten aus dem Shuffle-Speicher. Die Menge der gescannten Daten wirkt sich auf die Kosten aus, wenn On-Demand-Slots verwendet werden, und auf die Leistung, wenn Reservierungen verwendet werden.
Potenzielle Leistungsprobleme
- Großer Scan einer nicht partitionierten Tabelle: Wenn für die Abfrage nur ein kleiner Teil der Daten erforderlich ist, kann dies darauf hindeuten, dass ein Tabellenscan ineffizient ist. Partitionierung könnte eine gute Optimierungsstrategie sein.
- Scannen einer großen Tabelle mit einem kleinen Filterverhältnis: Dies deutet darauf hin, dass der Filter die gescannten Daten nicht effektiv reduziert. Überprüfen Sie gegebenenfalls die Filterbedingungen.
- Auf das Laufwerk übertragene Shuffle-Byte: Dies deutet darauf hin, dass die Daten nicht effektiv mit Optimierungstechniken wie Clustering gespeichert werden, bei denen ähnliche Daten in Clustern gespeichert werden könnten.
Optimieren
- Gezieltes Filtern: Verwenden Sie
WHERE-Klauseln strategisch, um irrelevante Daten so früh wie möglich in der Abfrage herauszufiltern. Dadurch wird die Datenmenge reduziert, die von der Abfrage verarbeitet werden muss. - Partitionierung und Clustering: BigQuery verwendet Tabellenpartitionierung und Clustering, um bestimmte Datensegmente effizient zu finden.
Achten Sie darauf, dass Ihre Tabellen basierend auf Ihren typischen Abfragemustern partitioniert und geclustert sind, um die während der
READ-Schritte gescannten Daten zu minimieren. - Relevante Spalten auswählen: Vermeiden Sie
SELECT *-Anweisungen. Wählen Sie stattdessen bestimmte Spalten aus oder verwenden SieSELECT * EXCEPT, um das Lesen unnötiger Daten zu vermeiden. - Materialisierte Ansichten: Materialisierte Ansichten können häufig verwendete Aggregationen vorab berechnen und speichern. Dadurch kann die Notwendigkeit, Basistabellen während der
READ-Schritte für Abfragen zu lesen, die diese Ansichten verwenden, reduziert werden.
Schritt COMPUTE
Im Schritt COMPUTE führt BigQuery die folgenden Aktionen für Ihre Daten aus:
- Wertet Ausdrücke in den Klauseln
SELECT,WHERE,HAVINGund anderen Klauseln der Abfrage aus, einschließlich Berechnungen, Vergleichen und logischen Vorgängen. - Führt integrierte SQL-Funktionen und benutzerdefinierte Funktionen aus.
- Filtert Datenzeilen basierend auf Bedingungen in der Abfrage.
Optimieren
Der Abfrageplan kann Engpässe im Schritt COMPUTE aufzeigen. Suchen Sie nach Phasen mit umfangreichen Berechnungen oder einer hohen Anzahl verarbeiteter Zeilen.
- Korrelieren Sie den Schritt
COMPUTEmit dem Datenvolumen: Wenn eine Phase eine erhebliche Rechenleistung aufweist und ein großes Datenvolumen verarbeitet, ist sie möglicherweise ein guter Kandidat für die Optimierung. - Verzerrte Daten: Wenn in einer Phase der maximale Rechenaufwand deutlich höher ist als der durchschnittliche Rechenaufwand, bedeutet das, dass in dieser Phase unverhältnismäßig viel Zeit für die Verarbeitung einiger weniger Datensegmente aufgewendet wurde. Sehen Sie sich die Verteilung der Daten an, um festzustellen, ob eine Datenverzerrung vorliegt.
- Datentypen berücksichtigen:Verwenden Sie geeignete Datentypen für Ihre Spalten. Beispielsweise kann die Verwendung von Ganzzahlen, Datums-/Uhrzeitwerten und Zeitstempeln anstelle von Strings die Leistung verbessern.
Schritt WRITE
WRITE-Schritte werden für Zwischendaten und die endgültige Ausgabe ausgeführt.
- In den Shuffle-Speicher schreiben: In einer mehrstufigen Abfrage umfasst der Schritt
WRITEhäufig das Senden der verarbeiteten Daten an eine andere Stufe zur weiteren Verarbeitung. Das ist typisch für Shuffle-Speicher, in dem Daten aus mehreren Quellen kombiniert oder aggregiert werden. Die in dieser Phase geschriebenen Daten sind in der Regel ein Zwischenergebnis, nicht die endgültige Ausgabe. - Endgültige Ausgabe: Das Abfrageergebnis wird entweder in die Ziel- oder in eine temporäre Tabelle geschrieben.
Hash-Partitionierung
Wenn eine Phase im Abfrageplan Daten in eine Hash-partitionierte Ausgabe schreibt, schreibt BigQuery die in der Ausgabe enthaltenen Spalten und die als Partitionsschlüssel ausgewählte Spalte.
Optimieren
Der Schritt WRITE selbst kann zwar nicht direkt optimiert werden, aber wenn Sie seine Rolle verstehen, können Sie potenzielle Engpässe in früheren Phasen erkennen:
- Geschriebene Daten minimieren: Konzentrieren Sie sich auf die Optimierung der vorherigen Phasen mit Filterung und Aggregation, um die Menge der in diesem Schritt geschriebenen Daten zu reduzieren.
Partitionierung: Das Schreiben profitiert stark von der Tabellenpartitionierung. Wenn die von Ihnen geschriebenen Daten auf bestimmte Partitionen beschränkt sind, kann BigQuery Schreibvorgänge schneller ausführen.
Wenn die DML-Anweisung eine
WHERE-Klausel mit einer statischen Bedingung für eine Tabellenpartitionsspalte enthält, ändert BigQuery nur die relevanten Tabellenpartitionen.Kompromisse bei der Denormalisierung: Die Denormalisierung kann manchmal zu kleineren Ergebnismengen im Zwischenschritt
WRITEführen. Es gibt jedoch auch Nachteile, z. B. eine höhere Speichernutzung und Probleme mit der Datenkonsistenz.
Schritt JOIN
Im Schritt JOIN kombiniert BigQuery Daten aus zwei Datenquellen.
Joins können Join-Bedingungen enthalten. Joins sind ressourcenintensiv. Beim Zusammenführen großer Datenmengen in BigQuery werden die Join-Schlüssel unabhängig voneinander sortiert, um sie auf demselben Slot auszurichten, sodass der Join lokal auf jedem Slot ausgeführt wird.
Der Abfrageplan für den Schritt JOIN enthält in der Regel die folgenden Details:
- Join-Muster: Gibt den verwendeten Join-Typ an. Jeder Typ definiert, wie viele Zeilen aus den zusammengeführten Tabellen in der Ergebnismenge enthalten sind.
- Join-Spalten: Diese Spalten werden verwendet, um Zeilen zwischen den Datenquellen abzugleichen. Die Auswahl der Spalten ist entscheidend für die Join-Leistung.
Join-Muster
- Broadcast-Join: Wenn eine Tabelle, in der Regel die kleinere, in den Arbeitsspeicher eines einzelnen Worker-Knotens oder Slots passt, kann BigQuery sie an alle anderen Knoten senden, um den Join effizient auszuführen. Suchen Sie in den Schrittdetails nach
JOIN EACH WITH ALL. - Hash-Join: Wenn Tabellen groß sind oder ein Broadcast-Join nicht geeignet ist, kann ein Hash-Join verwendet werden. BigQuery verwendet Hash- und Shuffle-Vorgänge, um die linke und rechte Tabelle so zu mischen, dass die übereinstimmenden Schlüssel im selben Slot landen, um einen lokalen Join auszuführen. Hash-Joins sind ein aufwendiger Vorgang, da die Daten verschoben werden müssen. Sie ermöglichen jedoch einen effizienten Abgleich von Zeilen über Hashes hinweg. Suchen Sie in den Schrittdetails nach
JOIN EACH WITH EACH. - Self Join: Ein SQL-Anti-Pattern, bei dem eine Tabelle mit sich selbst zusammengeführt wird.
- Cross Join: Ein SQL-Antimuster, das erhebliche Leistungsprobleme verursachen kann, da es größere Ausgabedaten als die Eingaben generiert.
- Verzerrter Join: Die Datenverteilung über den Join-Schlüssel in einer Tabelle ist sehr verzerrt und kann zu Leistungsproblemen führen. Suchen Sie nach Fällen, in denen die maximale Rechenzeit im Abfrageplan viel größer als die durchschnittliche Rechenzeit ist. Weitere Informationen finden Sie unter Join mit hoher Kardinalität und Partitionsverzerrung.
Debugging
- Großes Datenvolumen: Wenn der Abfrageplan zeigt, dass im Schritt
JOINeine erhebliche Datenmenge verarbeitet wird, untersuchen Sie die Join-Bedingung und die Join-Schlüssel. Filtern Sie die Daten oder verwenden Sie selektivere Join-Schlüssel. - Verzerrte Datenverteilung: Analysieren Sie die Datenverteilung von Join-Schlüsseln. Wenn eine Tabelle sehr ungleichmäßig verteilt ist, sollten Sie Strategien wie das Aufteilen der Abfrage oder das Vorfiltern in Betracht ziehen.
- Joins mit hoher Kardinalität: Joins, die deutlich mehr Zeilen erzeugen als die Anzahl der linken und rechten Eingabezeilen, können die Abfrageleistung drastisch reduzieren. Vermeiden Sie Joins, die eine sehr große Anzahl von Zeilen erzeugen.
- Falsche Reihenfolge der Tabelle: Achten Sie darauf, dass Sie den richtigen Join-Typ ausgewählt haben, z. B.
INNERoderLEFT, und dass die Tabellen gemäß den Anforderungen Ihrer Abfrage von der größten zur kleinsten sortiert sind.
Optimieren
- Selektive Join-Schlüssel: Verwenden Sie für Join-Schlüssel nach Möglichkeit
INT64anstelle vonSTRING.STRING-Vergleiche sind langsamer alsINT64-Vergleiche, da jedes Zeichen in einem String verglichen wird. Ganzzahlen erfordern nur einen einzigen Vergleich. - Vor dem Join filtern: Wenden Sie vor dem Join
WHERE-Klauselfilter auf einzelne Tabellen an. Dadurch wird die Datenmenge reduziert, die am Join-Vorgang beteiligt ist. - Funktionen für Join-Spalten vermeiden: Vermeiden Sie den Aufruf von Funktionen für Join-Spalten. Standardisieren Sie stattdessen Ihre Tabellendaten während der Aufnahme oder nach der Aufnahme mithilfe von ELT-SQL-Pipelines. Dadurch müssen Join-Spalten nicht mehr dynamisch geändert werden, was effizientere Joins ermöglicht, ohne die Datenintegrität zu beeinträchtigen.
- Self Joins vermeiden: Self Joins werden üblicherweise eingesetzt, um zeilenabhängige Beziehungen zu berechnen. Self Joins können jedoch die Anzahl der Ausgabezeilen vervierfachen, was zu Leistungsproblemen führen kann. Anstatt sich auf Self Joins zu verlassen, sollten Sie (analytische) Fensterfunktionen verwenden.
- Große Tabellen zuerst: Auch wenn das Tool zur Optimierung von SQL-Abfrage festlegen kann, welche Tabelle auf welcher Seite des Joins stehen sollte, sollten Sie die verknüpften Tabellen entsprechend sortieren. Als Best Practice sollten Sie die größte Tabelle zuerst platzieren, gefolgt von der kleinsten und dann nach absteigender Größe.
- Denormalisierung: In einigen Fällen können Joins durch strategisches Denormalisieren von Tabellen (Hinzufügen redundanter Daten) vollständig vermieden werden. Dieser Ansatz ist jedoch mit Kompromissen bei der Speicher- und Datenkonsistenz verbunden.
- Partitionierung und Clustering: Durch das Partitionieren von Tabellen basierend auf Join-Schlüsseln und das Clustern von am selben Ort gespeicherten Daten können Joins erheblich beschleunigt werden, da BigQuery relevante Datenpartitionen gezielt ansprechen kann.
- Verzerrte Joins optimieren: Um Leistungsprobleme im Zusammenhang mit verzerrten Joins zu vermeiden, filtern Sie Daten aus der Tabelle so früh wie möglich vorab oder teilen Sie die Abfrage in zwei oder mehr Abfragen auf.
Schritt AGGREGATE
Im Schritt AGGREGATE werden die Daten von BigQuery aggregiert und gruppiert.
Debugging
- Phasendetails: Prüfen Sie die Anzahl der Eingabezeilen für die Aggregation und der Ausgabezeilen aus der Aggregation sowie die Shuffle-Größe, um festzustellen, wie stark die Datenmenge durch den Aggregationsschritt reduziert wurde und ob Daten-Shuffling beteiligt war.
- Shuffle-Größe: Eine große Shuffle-Größe kann darauf hindeuten, dass während der Aggregation eine erhebliche Datenmenge zwischen Worker-Knoten verschoben wurde.
- Datenverteilung prüfen: Achten Sie darauf, dass die Daten gleichmäßig auf die Partitionen verteilt sind. Eine ungleichmäßige Datenverteilung kann zu unausgewogenen Arbeitslasten im Aggregationsschritt führen.
- Aggregationen prüfen: Analysieren Sie die Aggregationsklauseln, um zu bestätigen, dass sie notwendig und effizient sind.
Optimieren
- Clustering: Clustern Sie Ihre Tabellen nach Spalten, die häufig in
GROUP BY-,COUNT- oder anderen Aggregationsklauseln verwendet werden. - Partitionierung: Wählen Sie eine Partitionierungsstrategie aus, die zu Ihren Abfragemustern passt. Verwenden Sie nach Aufnahmezeit partitionierte Tabellen, um die Menge der während der Aggregation gescannten Daten zu reduzieren.
- Früher aggregieren: Führen Sie Aggregationen nach Möglichkeit früher in der Abfragepipeline durch. Dadurch kann die Datenmenge reduziert werden, die während der Aggregation verarbeitet werden muss.
- Shuffling-Optimierung: Wenn das Shuffling ein Engpass ist, sollten Sie nach Möglichkeiten suchen, es zu minimieren. Sie können beispielsweise Tabellen denormalisieren oder Clustering verwenden, um relevante Daten zusammenzustellen.
Sonderfälle
- DISTINCT-Aggregate: Abfragen mit
DISTINCT-Aggregaten können rechenintensiv sein, insbesondere bei großen Datasets. Ziehen Sie Alternativen wieAPPROX_COUNT_DISTINCTfür ungefähre Ergebnisse in Betracht. - Große Anzahl von Gruppen: Wenn die Abfrage eine große Anzahl von Gruppen erzeugt, kann dies eine erhebliche Menge an Arbeitsspeicher verbrauchen. In solchen Fällen sollten Sie die Anzahl der Gruppen begrenzen oder eine andere Aggregationsstrategie verwenden.
Schritt REPARTITION
Sowohl REPARTITION als auch COALESCE sind Optimierungstechniken, die BigQuery direkt auf die gemischten Daten in der Abfrage anwendet.
REPARTITION: Mit diesem Vorgang soll die Datenverteilung auf die Worker-Knoten neu ausgeglichen werden. Angenommen, nach dem Shuffling hat ein Worker-Knoten eine unverhältnismäßig große Datenmenge. Im SchrittREPARTITIONwerden die Daten gleichmäßiger verteilt, sodass kein einzelner Worker zu einem Engpass wird. Dies ist besonders wichtig für rechenintensive Vorgänge wie Joins.COALESCE: Dieser Schritt erfolgt, wenn Sie nach dem Shuffling viele kleine Daten-Buckets haben. Im SchrittCOALESCEwerden diese Buckets zu größeren Buckets zusammengefasst, wodurch der Verwaltungsaufwand für zahlreiche kleine Datenmengen reduziert wird. Dies kann besonders vorteilhaft sein, wenn Sie mit sehr kleinen Zwischenergebnissen arbeiten.
Wenn Sie in Ihrem Abfrageplan die Schritte REPARTITION oder COALESCE sehen, bedeutet das nicht unbedingt, dass ein Problem mit Ihrer Abfrage vorliegt. Das ist oft ein Zeichen dafür, dass BigQuery die Datenverteilung proaktiv optimiert, um die Leistung zu verbessern. Wenn diese Vorgänge jedoch wiederholt auftreten, kann dies darauf hindeuten, dass Ihre Daten von Natur aus verzerrt sind oder dass Ihre Abfrage zu übermäßigem Datenshuffling führt.
Optimieren
So reduzieren Sie die Anzahl der REPARTITION-Schritte:
- Datenverteilung: Achten Sie darauf, dass Ihre Tabellen effektiv partitioniert und geclustert sind. Gut verteilte Daten verringern die Wahrscheinlichkeit erheblicher Ungleichgewichte nach dem Shuffling.
- Abfragestruktur: Analysieren Sie die Abfrage auf potenzielle Quellen für Datenverzerrungen. Gibt es beispielsweise hochselektive Filter oder Joins, die dazu führen, dass eine kleine Teilmenge von Daten auf einem einzelnen Worker verarbeitet wird?
- Join-Strategien: Experimentieren Sie mit verschiedenen Join-Strategien, um zu sehen, ob sie zu einer ausgewogeneren Datenverteilung führen.
So reduzieren Sie die Anzahl der COALESCE-Schritte:
- Aggregationsstrategien: Erwägen Sie, Aggregationen früher in der Abfragepipeline durchzuführen. So lässt sich die Anzahl kleiner Zwischenergebnissätze reduzieren, die zu
COALESCE-Schritten führen können. - Datenvolumen: Wenn Sie mit sehr kleinen Datasets arbeiten, ist
COALESCEmöglicherweise kein großes Problem.
Nicht überoptimieren. Eine vorzeitige Optimierung kann Ihre Abfragen komplexer machen, ohne dass sich daraus nennenswerte Vorteile ergeben.
UPDATE, DELETE und MERGE Schritte
Die Schritte UPDATE, DELETE und MERGE werden in Phasen angezeigt, in denen DML-Anweisungen (Datenbearbeitungssprache) für eine Zieltabelle ausgeführt werden.
Die Schrittdetails umfassen in der Regel die folgenden Unterschritte:
- Spalten: Die Spalten, die aus der Zieltabelle gelesen oder in diese geschrieben werden.
- Zieltabelle (
FROModerINTO): Die Zieltabelle, die durch die Anweisung geändert wird. Dabei wirdFROMfür die SchritteUPDATEundDELETEundINTOfür die SchritteMERGEverwendet.
Schritt EXPORT
Im Schritt EXPORT werden Ausgabedaten in eine Zieltabelle geschrieben. Dieser Schritt wird häufig in den letzten Phasen von DML-Anweisungen wie INSERT, UPDATE, DELETE und MERGE sowie in Abfragen angezeigt, die Ergebnisse in einer Zieltabelle materialisieren.
Die Schrittdetails umfassen in der Regel die folgenden Unterschritte:
- Ausgabespalten: Die Liste der Variablen, die in die Zieltabelle geschrieben werden.
- Zieltabelle (
TO): Die Zieltabelle, in die die exportierten Zeilen eingefügt werden.
Erläuterung zu föderierten Abfragen
Mit föderierten Abfragen können Sie eine Abfrageanweisung mit der EXTERNAL_QUERY-Funktion an eine externe Datenquelle senden.
Föderierte Abfragen unterliegen der Optimierungstechnik, die als SQL-Pushdowns bezeichnet wird. Im Abfrageplan werden Vorgänge angezeigt, die gegebenenfalls an die externe Datenquelle weitergeleitet wurden. Wenn Sie beispielsweise die folgende Abfrage ausführen:
SELECT id, name
FROM EXTERNAL_QUERY("<connection>", "SELECT * FROM company")
WHERE country_code IN ('ee', 'hu') AND name like '%TV%'
Der Abfrageplan zeigt die folgenden Phasenschritte an:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, country_code
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
  WHERE in(country_code, 'ee', 'hu')
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
In diesem Plan steht table_for_external_query_$_0(...) für die Funktion EXTERNAL_QUERY. In den Klammern sehen Sie die Abfrage, die von der externen Datenquelle ausgeführt wird. Daraus lässt sich Folgendes ableiten:
- Eine externe Datenquelle gibt nur drei ausgewählte Spalten zurück.
- Eine externe Datenquelle gibt nur Zeilen zurück, für die
country_codeentweder'ee'oder'hu'ist. - Der Operator
LIKEwird nicht per Push übertragen und wird aber von BigQuery ausgewertet.
Wenn keine Push-downs vorhanden sind, zeigt der Abfrageplan die folgenden Phasenschritte an:
$1:id, $2:name, $3:country_code
FROM table_for_external_query_$_0(
  SELECT id, name, description, country_code, primary_address, secondary address
  FROM (
    /*native_query*/
    SELECT * FROM company
  )
)
WHERE and(in($3, 'ee', 'hu'), like($2, '%TV%'))
$1, $2
TO __stage00_output
Dieses Mal gibt eine externe Datenquelle alle Spalten und alle Zeilen aus der Tabelle company zurück und BigQuery führt die Filterung durch.
Metadaten der Zeitachse
Die Abfragezeitachse zeigt den Fortschritt zu bestimmten Zeitpunkten und bietet aktuelle Ansichten des gesamten Abfragefortschritts. Die Zeitachse wird als eine Reihe von Stichproben dargestellt, die folgende Details enthalten:
| Feld | Beschreibung |
|---|---|
elapsedMs |
Seit Beginn der Abfrageausführung verstrichene Millisekunden. |
totalSlotMs |
Eine kumulative Darstellung der von der Abfrage verwendeten Slot-Millisekunden. |
pendingUnits |
Gesamtzahl der geplanten Arbeitseinheiten, die auf Ausführung warten. |
activeUnits |
Gesamtzahl der aktiven Arbeitseinheiten, die derzeit von den Workern verarbeitet werden. |
completedUnits |
Gesamtzahl der Arbeitseinheiten, die während der Ausführung dieser Abfrage abgeschlossen wurden. |
Beispielabfrage
Die folgende Abfrage zählt die Anzahl der Zeilen im öffentlichen Shakespeare-Dataset und hat eine zweite bedingte Zählung, deren Ergebnisse auf Zeilen beschränkt sind, die auf „Hamlet“ verweisen:
SELECT
  COUNT(1) as rowcount,
  COUNTIF(corpus = 'hamlet') as rowcount_hamlet
FROM `publicdata.samples.shakespeare`
Klicken Sie auf Ausführungsdetails, um den Abfrageplan anzuzeigen:

Die Farbindikatoren zeigen die relative Zeitdauer für alle Schritte in allen Phasen an.
Um mehr über die Schritte der Ausführungsphasen zu erfahren, klicken Sie auf das , woraufhin die Details für die Phase maximiert werden:
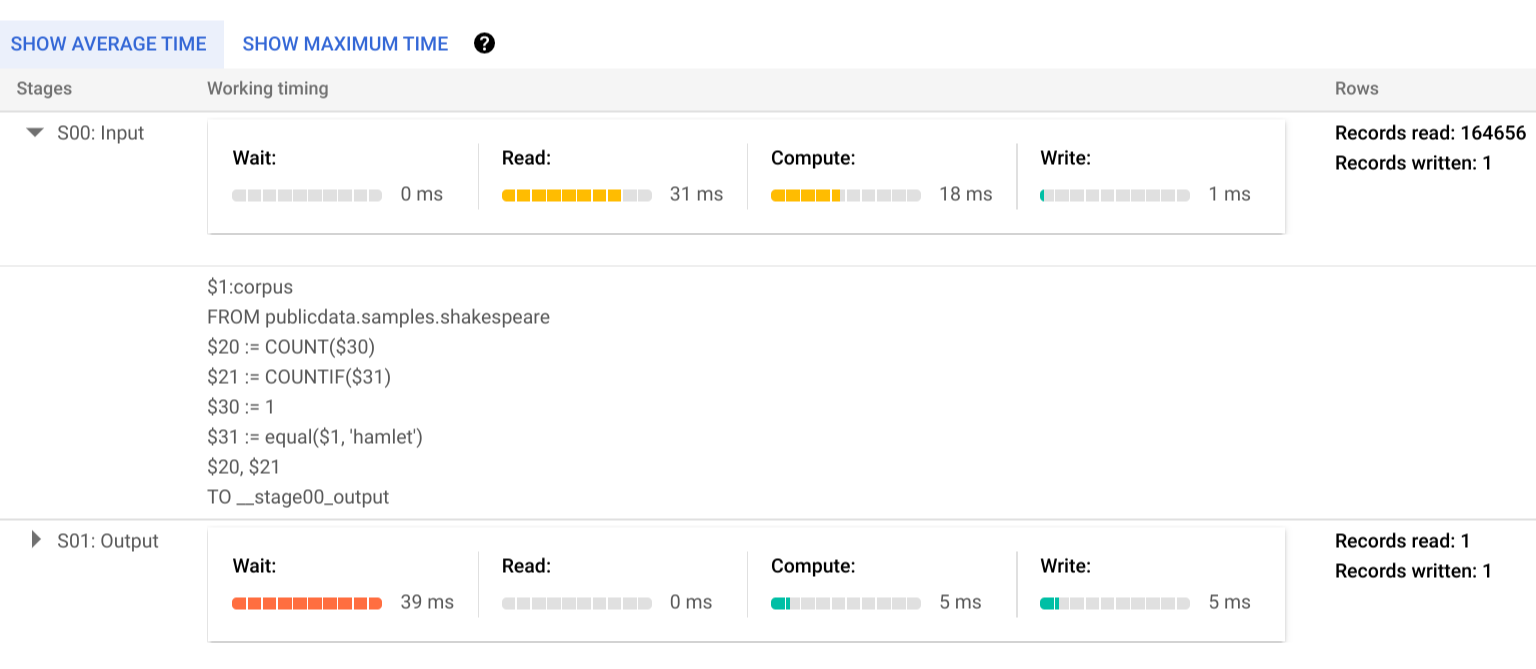
In diesem Beispiel war die längste Zeit in einem Segment die Zeit, die der einzelne Worker in Phase 01 auf den Abschluss von Phase 00 gewartet hat. Dies liegt daran, dass Phase 01 von der Eingabe der Phase 00 abhängig war und erst gestartet werden konnte, nachdem die Ausgabedaten der ersten Phase in den Zwischen-Shuffle geschrieben wurden.
Error Reporting
Abfragejobs können während der Ausführung fehlschlagen. Da die Informationen des Abfrageplans regelmäßig aktualisiert werden, können Sie sehen, an welcher Stelle innerhalb der Ausführungsgrafik der Fehler aufgetreten ist. In der Cloud de Confiance Console wird durch ein Häkchen bzw. ein Ausrufezeichen neben den Phasennamen angezeigt, ob eine Phase erfolgreich war oder fehlgeschlagen ist.
Weitere Informationen zum Interpretieren und Beheben von Fehlern finden Sie in der Anleitung zur Fehlerbehebung.
API-Beispieldarstellung
Informationen zum Abfrageplan sind in den Jobantwortinformationen eingebettet und können durch Aufrufen von jobs.get abgerufen werden.
Der folgende Auszug einer JSON-Antwort für einen Job, der die Beispielabfrage „hamlet“ zurückgibt, zeigt beispielsweise sowohl den Abfrageplan als auch die Zeitachseninformationen.
"statistics": {
  "creationTime": "1576544129234",
  "startTime": "1576544129348",
  "endTime": "1576544129681",
  "totalBytesProcessed": "2464625",
  "query": {
    "queryPlan": [
      {
        "name": "S00: Input",
        "id": "0",
        "startMs": "1576544129436",
        "endMs": "1576544129465",
        "waitRatioAvg": 0.04,
        "waitMsAvg": "1",
        "waitRatioMax": 0.04,
        "waitMsMax": "1",
        "readRatioAvg": 0.32,
        "readMsAvg": "8",
        "readRatioMax": 0.32,
        "readMsMax": "8",
        "computeRatioAvg": 1,
        "computeMsAvg": "25",
        "computeRatioMax": 1,
        "computeMsMax": "25",
        "writeRatioAvg": 0.08,
        "writeMsAvg": "2",
        "writeRatioMax": 0.08,
        "writeMsMax": "2",
        "shuffleOutputBytes": "18",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "164656",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$1:corpus",
              "FROM publicdata.samples.shakespeare"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$20 := COUNT($30)",
              "$21 := COUNTIF($31)"
            ]
          },
          {
            "kind": "COMPUTE",
            "substeps": [
              "$30 := 1",
              "$31 := equal($1, 'hamlet')"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$20, $21",
              "TO __stage00_output"
            ]
          }
        ]
      },
      {
        "name": "S01: Output",
        "id": "1",
        "startMs": "1576544129465",
        "endMs": "1576544129480",
        "inputStages": [
          "0"
        ],
        "waitRatioAvg": 0.44,
        "waitMsAvg": "11",
        "waitRatioMax": 0.44,
        "waitMsMax": "11",
        "readRatioAvg": 0,
        "readMsAvg": "0",
        "readRatioMax": 0,
        "readMsMax": "0",
        "computeRatioAvg": 0.2,
        "computeMsAvg": "5",
        "computeRatioMax": 0.2,
        "computeMsMax": "5",
        "writeRatioAvg": 0.16,
        "writeMsAvg": "4",
        "writeRatioMax": 0.16,
        "writeMsMax": "4",
        "shuffleOutputBytes": "17",
        "shuffleOutputBytesSpilled": "0",
        "recordsRead": "1",
        "recordsWritten": "1",
        "parallelInputs": "1",
        "completedParallelInputs": "1",
        "status": "COMPLETE",
        "steps": [
          {
            "kind": "READ",
            "substeps": [
              "$20, $21",
              "FROM __stage00_output"
            ]
          },
          {
            "kind": "AGGREGATE",
            "substeps": [
              "$10 := SUM_OF_COUNTS($20)",
              "$11 := SUM_OF_COUNTS($21)"
            ]
          },
          {
            "kind": "WRITE",
            "substeps": [
              "$10, $11",
              "TO __stage01_output"
            ]
          }
        ]
      }
    ],
    "estimatedBytesProcessed": "2464625",
    "timeline": [
      {
        "elapsedMs": "304",
        "totalSlotMs": "50",
        "pendingUnits": "0",
        "completedUnits": "2"
      }
    ],
    "totalPartitionsProcessed": "0",
    "totalBytesProcessed": "2464625",
    "totalBytesBilled": "10485760",
    "billingTier": 1,
    "totalSlotMs": "50",
    "cacheHit": false,
    "referencedTables": [
      {
        "projectId": "publicdata",
        "datasetId": "samples",
        "tableId": "shakespeare"
      }
    ],
    "statementType": "SELECT"
  },
  "totalSlotMs": "50"
},
Ausführungsinformationen verwenden
BigQuery-Abfragepläne enthalten Informationen dazu, wie der Dienst Abfragen ausführt. Da es sich um einen verwalteten Dienst handelt, sind allerdings die Möglichkeiten für die direkte Umsetzung einiger Details begrenzt. Viele Optimierungen erfolgen automatisch, wenn Sie den Dienst verwenden. Dies kann sich von anderen Umgebungen unterscheiden, in denen für die Abstimmung, Bereitstellung und das Monitoring dedizierte, sachkundige Mitarbeiter erforderlich sind.
Spezifische Techniken zur Verbesserung der Ausführung und Leistung von Abfragen finden Sie in der Dokumentation zu Best Practices. Anhand des Abfrageplans und der Zeitachsenstatistiken können Sie nachvollziehen, ob die Ressourcenauslastung in bestimmten Phasen besonders hoch ist. Eine JOIN-Phase, in der weit mehr Ausgabezeilen als Eingabezeilen generiert werden, könnte zum Beispiel darauf hindeuten, dass früher in der Abfrage gefiltert werden sollte.
Darüber hinaus können Sie mithilfe der Informationen der Zeitachse feststellen, ob eine bestimmte Abfrage langsam ist, weil sie isoliert ausgeführt wird oder weil sie mit anderen Abfragen um dieselben Ressourcen konkurriert. Wenn die Anzahl der aktiven Einheiten während der gesamten Lebensdauer der Abfrage begrenzt ist, die Menge der in der Warteschlange enthaltenen Arbeitseinheiten jedoch hoch bleibt, spricht dies möglicherweise dafür, dass durch Reduzierung der Anzahl gleichzeitiger Abfragen die Ausführungszeit für bestimmte Abfragen erheblich verkürzt werden kann.