

Les fichiers PDF, tels que les documents financiers, peuvent être difficiles à utiliser dans les pipelines RAG en raison de leur structure complexe et de leur mélange de texte, de chiffres et de tableaux. Ce tutoriel vous explique comment utiliser la fonction AI.CHUNK_DOCUMENT pour créer un pipeline RAG basé sur les informations clés extraites d'un fichier PDF.
Objectifs
Ce tutoriel couvre les tâches suivantes :- Créer un bucket Cloud Storage et importer un exemple de fichier PDF
- Utilisez la fonction
AI.CHUNK_DOCUMENTpour analyser le contenu du PDF en fragments, puis écrivez ce contenu dans une table BigQuery. - Générer des embeddings à partir du contenu PDF fragmenté, puis écrire ces embeddings dans une table BigQuery. Les embeddings sont des représentations numériques du contenu du PDF qui vous permettent d'effectuer des recherches sémantiques et de récupérer des informations dans le contenu du PDF.
- Utilisez la fonction
VECTOR_SEARCHsur les embeddings pour identifier du contenu PDF sémantiquement similaire. - Effectuer une génération augmentée par récupération (RAG) en utilisant la fonction
AI.GENERATEpour générer du texte, en utilisant les résultats de recherche vectorielle pour augmenter la saisie de la requête et améliorer les résultats.
Coûts
Dans ce document, vous utilisez les composants facturables suivants de Cloud de Confiance by S3NS :
- BigQuery: You incur costs for the data that you process in BigQuery.
- Gemini Enterprise Agent Platform: You incur costs for calls to Agent Platform models.
- Document AI: You incur costs for calls to the Document AI API.
- Cloud Storage: You incur costs for object storage in Cloud Storage.
Une fois que vous avez terminé les tâches décrites dans ce document, supprimez les ressources que vous avez créées pour éviter que des frais vous soient facturés. Pour en savoir plus, consultez la section Effectuer un nettoyage.
Avant de commencer
Console
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
Enable the BigQuery, BigQuery Connection, Vertex AI, Document AI, and Cloud Storage APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
Assurez-vous de disposer du ou des rôles suivants sur le projet : Administrateur de l'espace de stockage, Éditeur Document AI, Administrateur BigQuery, Administrateur IAM du projet
Vérifier les rôles
-
Dans la console Cloud de Confiance , accédez à la page IAM.
Accéder à IAM - Sélectionnez le projet.
-
Dans la colonne Compte principal, recherchez toutes les lignes qui vous identifient ou identifient un groupe dont vous faites partie. Pour savoir à quels groupes vous appartenez, contactez votre administrateur.
- Pour toutes les lignes qui vous spécifient ou vous incluent, consultez la colonne Rôle pour vous assurer que la liste inclut les rôles requis.
Attribuer les rôles
-
Dans la console Cloud de Confiance , accédez à la page IAM.
Accéder à IAM - Sélectionnez le projet.
- Cliquez sur Accorder l'accès.
-
Dans le champ Nouveaux comptes principaux, saisissez votre identifiant utilisateur. Il s'agit généralement de l'identifiant associé à un utilisateur dans un pool d'identités de personnel. Pour en savoir plus, consultez Représenter les utilisateurs de pools de personnel dans les stratégies IAM ou contactez votre administrateur.
- Cliquez sur Sélectionner un rôle, puis recherchez le rôle.
- Pour attribuer des rôles supplémentaires, cliquez sur Ajouter un autre rôle et ajoutez tous les rôles supplémentaires.
- Cliquez sur Enregistrer.
-
gcloud
-
Installez la Google Cloud CLI.
-
Configurez la gcloud CLI afin d'utiliser votre identité fédérée.
Pour en savoir plus, consultez Se connecter à la gcloud CLI avec votre identité fédérée.
-
Pour initialiser la gcloud CLI, exécutez la commande suivante :
gcloud init -
Créez ou sélectionnez un projet Cloud de Confiance .
Rôles requis pour sélectionner ou créer un projet
- Sélectionner un projet : la sélection d'un projet ne nécessite pas de rôle IAM spécifique. Vous pouvez sélectionner n'importe quel projet pour lequel un rôle vous a été attribué.
-
Créer un projet : pour créer un projet, vous devez disposer du rôle "Créateur de projet" (
roles/resourcemanager.projectCreator), qui contient l'autorisationresourcemanager.projects.create. Découvrez comment attribuer des rôles.
-
Créez un projet Cloud de Confiance :
gcloud projects create PROJECT_ID
Remplacez
PROJECT_IDpar le nom du projet Cloud de Confiance que vous créez. -
Sélectionnez le projet Cloud de Confiance que vous avez créé :
gcloud config set project PROJECT_ID
Remplacez
PROJECT_IDpar le nom de votre projet Cloud de Confiance .
-
Vérifiez que la facturation est activée pour votre projet Cloud de Confiance .
Activez les API BigQuery, BigQuery Connection, Vertex AI, Document AI et Cloud Storage, si elles ne le sont pas déjà :
Rôles requis pour activer les API
Pour activer des API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation via le rôle Propriétaire (roles/owner). Sinon, vous pouvez l'obtenir via le rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.gcloud services enable bigquery.googleapis.com
bigqueryconnection.googleapis.com aiplatform.googleapis.com documentai.googleapis.com storage.googleapis.com -
Attribuez des rôles à votre compte utilisateur. Exécutez la commande suivante une fois pour chacun des rôles IAM suivants :
  roles/storage.admin,
  roles/documentai.editor,
  roles/bigquery.admin,
  roles/resourcemanager.projectIamAdmin
gcloud projects add-iam-policy-binding PROJECT_ID --member="user:USER_IDENTIFIER" --role=ROLE
Remplacez les éléments suivants :
PROJECT_ID: ID du projet.USER_IDENTIFIER: identifiant de votre compte utilisateur . Pour obtenir des exemples, consultez Représenter les utilisateurs de pools de personnel dans les stratégies IAM.ROLE: rôle IAM que vous attribuez à votre compte utilisateur.
Créer un ensemble de données
Pour créer un ensemble de données BigQuery, sélectionnez l'une des options suivantes :
Console
Dans la console Cloud de Confiance , accédez à la page BigQuery.
Dans le volet de gauche, cliquez sur Explorateur :
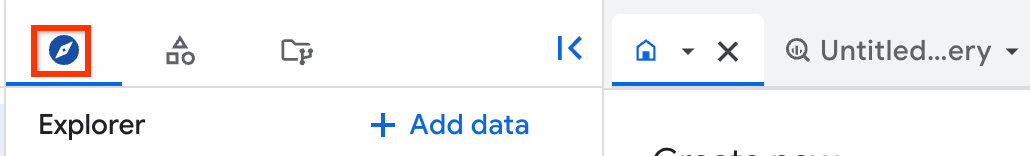
Si le volet de gauche ne s'affiche pas, cliquez sur Développer le volet de gauche pour l'ouvrir.
Dans Explorateur, développez votre projet, puis cliquez sur Ensembles de données.
Sur la page Ensembles de données, cliquez sur Créer un ensemble de données.
Dans le volet Créer un ensemble de données, procédez comme suit :
Dans le champ ID de l'ensemble de données, saisissez
bqml_tutorial.Pour Emplacement des données, sélectionnez US.
Ne modifiez pas les autres paramètres par défaut.
Cliquez sur Créer un ensemble de données.
bq
Pour créer un ensemble de données, utilisez la commande bq mk --dataset.
Créez un ensemble de données nommé
bqml_tutorialavec l'emplacement des données défini surUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Vérifiez que l'ensemble de données a bien été créé :
bq ls
API
Appelez la méthode datasets.insert avec une ressource d'ensemble de données définie :
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Importer l'exemple de document PDF dans Cloud Storage
Pour importer l'exemple de PDF dans Cloud Storage, procédez comme suit :
- Téléchargez l'exemple de PDF
scf23.pdfen accédant à https://www.federalreserve.gov/publications/files/scf23.pdf et en cliquant sur "Télécharger" . - Créez un bucket Cloud Storage.
- Importez le fichier
scf23.pdfdans le bucket.
Analyser le fichier PDF en fragments
Utilisez le processeur de documents avec la fonction AI.CHUNK_DOCUMENT pour analyser le fichier PDF en fragments, puis écrivez ce contenu dans une table :
Dans la console Cloud de Confiance , accédez à la page BigQuery.
Dans l'éditeur de requête, exécutez l'instruction suivante :
CREATE or REPLACE TABLE bqml_tutorial.chunked_pdf AS (
  SELECT *
  FROM AI.CHUNK_DOCUMENT('gs://BUCKET_NAME/scf23.pdf', chunk_size => 250)
);
Dans l'éditeur de requête, exécutez la requête suivante pour afficher un sous-ensemble du contenu PDF analysé :
SELECT
  chunk_id,
  start_page,
  end_page,
  content
FROM `bqml_tutorial.chunked_pdf`
ORDER BY chunk_id
LIMIT 3;
Le résultat ressemble à ce qui suit :
+----------+------------+----------+-------------------------------------------+
| chunk_id | start_page | end_page | content                                   |
+----------+------------+----------+-------------------------------------------+
| 1        | 1          | 1        | OF NORS. • BOARD OF GOVERNO FEDERAL       |
|          |            |          | RESERVE SYSTEM RESEARCH & ANALYSIS        |
| 2        | 1          | 7        | # Changes in U.S. Family Finances from    |
|          |            |          | 2019 to 2022                              |
|          |            |          |                                           |
|          |            |          | Evidence from the Survey of Consumer...   |
| 3        | 3          | 5        | # Changes in U.S. Family Finances from    |
|          |            |          | 2019 to 2022                              |
|          |            |          |                                           |
|          |            |          | ## Contents...                            |
+----------+------------+----------+-------------------------------------------+
Générer des embeddings
Générez des embeddings pour le contenu PDF analysé, puis écrivez-les dans une table :
Dans la console Cloud de Confiance , accédez à la page BigQuery.
Dans l'éditeur de requête, exécutez l'instruction suivante :
CREATE OR REPLACE TABLE `bqml_tutorial.embeddings` AS (
  SELECT *, AI.EMBED(content, endpoint => 'text-embedding-005').result AS embedding
  FROM bqml_tutorial.chunked_pdf
);
Exécuter une recherche vectorielle
Exécuter une recherche vectorielle sur le contenu PDF analysé.
La requête suivante prend une entrée textuelle, crée un embedding pour cette entrée à l'aide de la fonction AI.EMBED, puis utilise la fonction VECTOR_SEARCH pour faire correspondre l'embedding d'entrée avec les embeddings de contenu PDF les plus similaires. Les résultats sont les dix premiers fragments de PDF les plus liés aux variations de la valeur nette des familles.
Accédez à la page BigQuery.
Dans l'éditeur de requête, exécutez l'instruction SQL suivante :
SELECT
  distance,
  base.chunk_id AS chunk_id,
  base.start_page AS start_page,
  base.end_page AS end_page,
  base.content
FROM
  VECTOR_SEARCH(
    TABLE `bqml_tutorial.embeddings`,
    'embedding',
    query_value =>
      AI.EMBED(
        'Did the typical family net worth increase? If so, by how much?',
        endpoint => 'text-embedding-005').result,
    top_k => 3,
    OPTIONS => '{"fraction_lists_to_search": 0.01}')
ORDER BY distance DESC;
Le résultat ressemble à ce qui suit :
+----------+----------+------------+----------+-----------------------------------+
| distance | chunk_id | start_page | end_page | content                           |
+----------+----------+------------+----------+-----------------------------------+
| 0.608587 | 25       | 17         | 18       | # Net Worth                       |
|          |          |            |          |                                   |
|          |          |            |          | 18 Between the first quarter of   |
|          |          |            |          | 2019 and the first quarter of...  |
+----------+----------+------------+----------+-----------------------------------+
| 0.606387 | 29       | 19         | 21       | ## Net Worth                      |
|          |          |            |          |                                   |
|          |          |            |          | ## Net Worth by Family            |
|          |          |            |          | Characteristics...                |
+----------+----------+------------+----------+-----------------------------------+
| 0.599438 | 23       | 17         | 21       | # Net Worth                       |
|          |          |            |          |                                   |
|          |          |            |          | The net improvements in...        |
+----------+----------+------------+----------+-----------------------------------+
Générer du texte augmenté par les résultats de recherche vectorielle
Effectuez une Vector Search sur les embeddings pour identifier un contenu PDF sémantiquement similaire, puis utilisez la fonction AI.GENERATE avec les résultats de recherche vectorielle pour augmenter la saisie du prompt et améliorer les résultats de la génération de texte. Dans ce cas, la requête utilise les informations des fragments du PDF pour répondre à une question sur l'évolution de la valeur nette des familles au cours de la dernière décennie.
Dans la console Cloud de Confiance , accédez à la page BigQuery.
Dans l'éditeur de requête, exécutez l'instruction suivante :
SELECT
  AI.GENERATE(
    CONCAT('Did the typical family net worth change? How does this compare the SCF survey a decade earlier? Be concise and use the following context:',
            STRING_AGG(FORMAT("context: %s", base.content), ',\n')
    )
  ).result AS response
FROM
  VECTOR_SEARCH(
    TABLE `bqml_tutorial.embeddings`,
    'embedding',
    query_value =>
      AI.EMBED(
        'Did the typical family net worth increase? If so, by how much?',
        endpoint => 'text-embedding-005').result,
    top_k => 3,
    OPTIONS => '{"fraction_lists_to_search": 0.01}')
Le résultat ressemble à ce qui suit :
+-------------------------------------------------------------------------+
| response                                                                |
+-------------------------------------------------------------------------+
| Yes, the typical family net worth changed significantly. Between 2019   |
| and 2022, real median net worth surged by 37% to $192,900.              |
|                                                                         |
| This growth contrasts sharply with the period a decade earlier. Between |
| the 2010 and 2013 SCF surveys, real median net worth actually decreased |
| by 2%.                                                                  |
+-------------------------------------------------------------------------+
Effectuer un nettoyage
Pour éviter que les ressources utilisées lors de ce tutoriel soient facturées sur votre compte Google Cloud, supprimez le projet contenant les ressources, ou conservez le projet et supprimez les ressources individuelles.
Supprimer le projet
Supprimer un projet Cloud de Confiance :
gcloud projects delete PROJECT_ID
Étapes suivantes
- En savoir plus sur les embeddings et la recherche vectorielle
- En savoir plus sur la recherche sémantique et le RAG