

Descripción general
Las políticas de administración de tokens te permiten supervisar y atribuir con precisión el uso de tokens de modelos de lenguaje grandes (LLM), y aplicar presupuestos de tokens compartidos en los agentes y las aplicaciones de IA de tu empresa.
Cuando los agentes de IA interactúan con los LLM, la límite de frecuencia de recuento de solicitudes, como las solicitudes por segundo o por minuto, no es suficiente para controlar el gasto o la capacidad. Una sola solicitud HTTP a un LLM puede consumir desde una docena hasta más de 100,000 tokens. Sin una administración a nivel de los tokens, un solo bucle de agente descontrolado puede agotar las cuotas de modelos empresariales compartidos y causar aumentos inesperados en los costos. Para administrar la inversión en IA, las empresas también deben establecer presupuestos de cuotas de modelos para los usuarios y departamentos de toda la organización.
Con las políticas de administración de tokens, puedes hacer lo siguiente:
- Calcular el uso de tokens de entrada, salida y almacenados en caché en todas las interacciones entre el agente y el modelo
- Atribuye el consumo de tokens y el costo estimado a los grupos relevantes para la empresa, las aplicaciones de IA y las identidades de agentes individuales en los modelos alojados en Gemini Enterprise Agent Platform o cualquier otra plataforma de hosting de modelos.
- Aplica presupuestos de tokens compartidos en tiempo real, emite alertas de umbral o
devuelve HTTP
429 Too Many Requestscuando se agota el presupuesto de un grupo de tokens. - Exporta telemetría de observabilidad detallada a Cloud Monitoring y agrega alertas de uso de tokens en Cloud Logging.
Cómo funciona
En la Figura 1, se muestra cómo las políticas de administración de tokens evalúan las solicitudes y respuestas de LLM en la capa de la puerta de enlace.
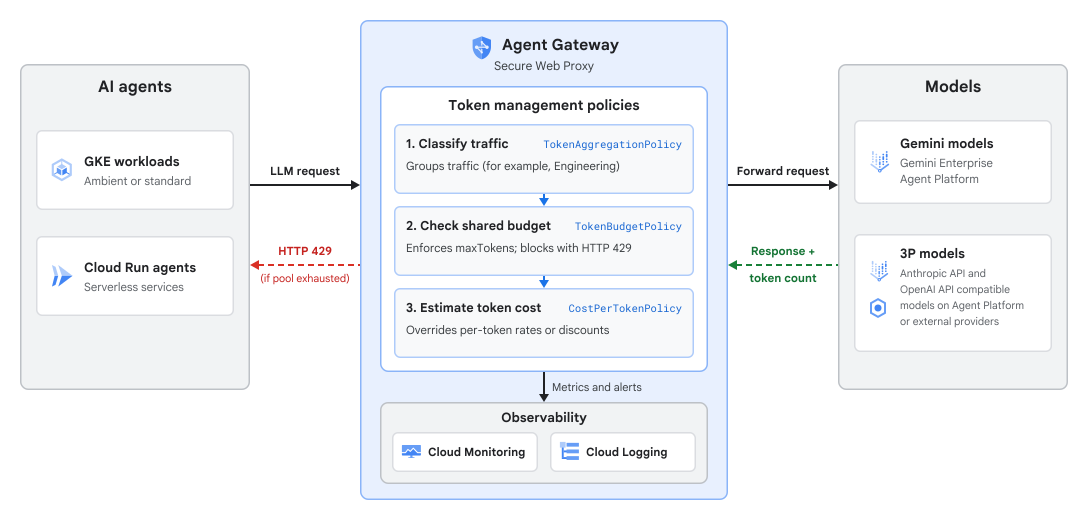
La administración de tokens usa tres recursos de política que funcionan en conjunto para clasificar el tráfico, aplicar presupuestos de tokens y personalizar los cálculos de costos:
- Política de agregación de tokens (
TokenAggregationPolicy): Clasifica las solicitudes entrantes de agente a modelo y agrega su consumo de tokens en grupos de tokens lógicos. Las agrupaciones se pueden basar en la jerarquía de recursos (alcance del proyecto), las aplicaciones de IA, los agentes individuales, los modelos de destino o las etiquetas personalizadas que se pasan en los encabezados de las solicitudes HTTP (incluidas las claves de API). - Política de presupuesto de tokens (
TokenBudgetPolicy): Define los grupos de tokens que aplican cuotas de tokens en uno o más grupos de tokens identificados por tu política de agregación de tokens. Cada grupo de tokens especifica un recuento máximo de tokens, un período de restablecimiento periódico (por hora o por día), una lista opcional de modelos de destino, un umbral de alerta y un modo de aplicación forzosa. - Política de costo por token (
CostPerTokenPolicy): Anula el precio predeterminado por token del modelo que se usa para calcular la métricagcp.token_management.token.estimated_costen Monitoring. Puedes configurar un descuento porcentual en el precio predeterminado del modelo o tarifas personalizadas por token en USD para los tokens de entrada, salida y almacenados en caché.
Dependencia de políticas y orden de creación
La administración de tokens aplica una jerarquía de dependencia estricta en los recursos de política adjuntos al mismo permiso de destino en el siguiente orden:
- Primero, se debe crear
TokenAggregationPolicypara clasificar las solicitudes en grupos de tokens para el permiso de destino. Esta política es el requisito mínimo para obtener observabilidad detallada a nivel del agente sobre el uso de tokens. - (Opcional) Se debe configurar
TokenBudgetPolicypara limitar el uso de tokens en relación con los grupos de tokens identificados enTokenAggregationPolicy. - (Opcional)
CostPerTokenPolicysolo se puede crear después de que exista unTokenBudgetPolicycorrespondiente para el permiso de destino.
Cuando borres políticas, hazlo en orden inverso: primero CostPerTokenPolicy,
luego TokenBudgetPolicy y, por último, TokenAggregationPolicy.
Evaluación de reglas y coincidencia predeterminada
Dentro de un TokenAggregationPolicy, las reglas se evalúan en el orden en
que se enumeran, y gana la primera regla que coincide:
- Tráfico coincidente: Cuando una solicitud de agente coincide con los criterios de origen de una regla
(aplicación de IA o identidad del agente) y los criterios de destino (encabezados HTTP o
extremos del proveedor de modelos), su uso de tokens se asigna al grupo de tokens de esa regla (
tokenGroup). - Regla general: Puedes colocar una regla con un bloque de coincidencia vacío al
final de tu lista de reglas para asignar todo el tráfico restante a un grupo de tokens
predeterminado, como
Default. - Tráfico sin coincidencias: Si no incluyes una regla general y una solicitud
no coincide con ninguna regla de la política, su consumo de tokens se registra
en el grupo del sistema
unmatcheden Monitoring. - Tráfico de grupo indefinido: Si un
TokenPoolen tu política de presupuesto de tokens (TokenBudgetPolicy) restringe la aplicación de políticas a modelos específicos, las solicitudes a modelos fuera de esa lista no se bloquean y se registran con el nombre del grupo establecido enundefineden Monitoring.
Entornos y modelos compatibles
Las políticas de administración de tokens admiten los siguientes Agent Runtime, implementaciones de Agent Gateway y modelos:
| Componente | Opciones admitidas |
|---|---|
| Entornos de ejecución de agentes de IA |
|
| Implementaciones de Agent Gateway | Secure Web Proxy en tu proyecto de Cloud de Confiance by S3NS : Aplica la administración de tokens de salida para todas las solicitudes de agente a modelo. |
| Modelos |
Modelos compatibles con las APIs de Gemini, Anthropic y OpenAI en cualquier proveedor de modelos:
|
| Agrupaciones de agregación |
|
Flujo de aplicación de políticas
Con el límite de frecuencia estándar, cada solicitud cuenta como una unidad antes de llegar al backend. Con las llamadas de LLM, la cantidad total de tokens de entrada y salida se conoce solo después de que el modelo responde. Para controlar esto, Agent Gateway procesa cada solicitud en dos fases:
- Verificación previa del presupuesto (ruta de la solicitud):
- Un agente envía una solicitud de inferencia a un extremo de LLM a través de Agent Gateway.
- La puerta de enlace evalúa la solicitud en función de tu
TokenAggregationPolicypara identificar latokenGroupcoincidente y busca laTokenPoolasociada en tuTokenBudgetPolicy. - Si se agota el presupuesto de tokens del grupo y se habilita la aplicación estricta, la puerta de enlace rechaza la solicitud de inmediato con un código de estado HTTP
429. Si el grupo tiene un presupuesto restante o está configurado para el modo de solo alerta, la puerta de enlace reenvía la solicitud al LLM.
- Conciliación de tokens y telemetría (ruta de respuesta):
- Cuando el extremo del LLM devuelve la respuesta de finalización, la puerta de enlace
extrae los recuentos de tokens reales de
input,outputycachedde la carga útil de la respuesta. - La administración de tokens concilia los tokens consumidos con la cuota de
maxTokensdel grupo. - Si el consumo actualizado supera el umbral de advertencia o alcanza el 100% del presupuesto, la puerta de enlace escribe una advertencia en Logging.
- La puerta de enlace exporta las métricas de consumo de tokens por agente
(
gen_ai.client.token.usage) y de costo estimado de tokens (gcp.token_management.token.estimated_cost) a Monitoring.
- Cuando el extremo del LLM devuelve la respuesta de finalización, la puerta de enlace
extrae los recuentos de tokens reales de
Ten en cuenta que los recuentos de tokens de salida se registran solo después de que se completa una respuesta del LLM. Como resultado, las solicitudes simultáneas admitidas antes de que un grupo alcance
maxTokens pueden superar el límite antes de que se bloqueen las solicitudes posteriores con
HTTP 429. Para evitar limitaciones inesperadas, establece un alertThreshold, como
0.6 o 0.8, para probar políticas nuevas con validateOnly: true antes de
habilitar la aplicación estricta de políticas.
Controles de administración relacionados
En la siguiente tabla, se muestra cómo funcionan las políticas de administración de tokens con otros Cloud de Confiance controles de gobernanza y de la plataforma de agentes:
| Capa de administración | Política o mecanismo | Objetivo |
|---|---|---|
| Control de acceso | Políticas de acceso de Identity and Access Management (IAM) | Controla qué identidades de agentes (IDs de SPIFFE) están autorizadas para conectarse a servidores de MCP, herramientas y extremos de modelos específicos. |
| Intención y reglas empresariales | Políticas de gobernanza semánticas | Evalúa las llamadas a herramientas propuestas en función de las restricciones de lenguaje natural (NLC) y la intención del usuario antes de la ejecución. |
| Seguridad del contenido | Model Armor | Analiza las instrucciones y respuestas en busca de inyección de instrucciones, jailbreaks y datos sensibles. |
| Limitación de frecuencia de recuento de solicitudes | Límite de frecuencia del servicio (RateLimitPolicy) |
Protege los balanceadores de cargas y los proxies de entrada de las inundaciones de solicitudes volumétricas
limitando las solicitudes HTTP por segundo o minuto
(countLimit). |
| Control de costos y tokens de LLM | Políticas de administración de tokens
(TokenAggregationPolicy, TokenBudgetPolicy,
CostPerTokenPolicy) |
Supervisa y atribuye el uso de tokens de LLM, y aplica presupuestos de tokens compartidos (maxTokens) y anulaciones de costos en todos los grupos de agentes
y proveedores de modelos. |
Limitaciones
Las políticas de administración de tokens tienen las siguientes limitaciones:
- Puedes adjuntar como máximo un
TokenAggregationPolicy, unTokenBudgetPolicyy unCostPerTokenPolicya un permiso de destino de proyecto determinado. - Cada
TokenAggregationPolicyadmite hasta 10 reglas de agregación (rules) y cadaTokenBudgetPolicyadmite hasta 10 grupos de tokens. - Los grupos de tokens admiten períodos de restablecimiento de
HOURLYyDAILY. Los presupuestos diarios se restablecen a la medianoche, hora del Pacífico. - Logging genera entradas de registro solo cuando un grupo de tokens cruza
su
alertThresholdconfigurado o alcanza el 100% demaxTokens(token_management_alert_logs).