

Panoramica
Le policy di gestione dei token ti consentono di monitorare e attribuire con precisione l'utilizzo dei token dei modelli linguistici di grandi dimensioni (LLM) e di applicare budget di token condivisi tra gli agenti e le applicazioni AI aziendali.
Quando gli agenti AI interagiscono con gli LLM, la limitazione di frequenza del conteggio delle richieste, ad esempio le richieste al secondo o al minuto, non è sufficiente per controllare la spesa o la capacità. Una singola richiesta HTTP a un LLM può consumare da una dozzina a oltre 100.000 token. Senza una governance a livello di token, un singolo loop dell'agente fuori controllo può esaurire le quote dei modelli aziendali condivisi e causare picchi di costi imprevisti. Per gestire la spesa per l'AI, le aziende devono anche impostare budget per le quote dei modelli per utenti e reparti della loro organizzazione.
Con le policy di gestione dei token puoi:
- Calcola l'utilizzo dei token per input, output e token memorizzati nella cache in tutte le interazioni tra agente e modello.
- Attribuisci il consumo di token e il costo stimato a gruppi pertinenti per l'attività, applicazioni AI e identità di singoli agenti tra i modelli ospitati su Gemini Enterprise Agent Platform o su qualsiasi altra piattaforma di hosting di modelli.
- Applica i budget di token condivisi in tempo reale, emettendo avvisi di soglia o restituendo l'errore HTTP
429 Too Many Requestsquando il budget di un pool di token è esaurito. - Esporta la telemetria di osservabilità granulare in Cloud Monitoring e aggrega gli avvisi sull'utilizzo dei token in Cloud Logging.
Come funziona
La Figura 1 mostra in che modo le policy di gestione dei token valutano le richieste e le risposte LLM a livello di gateway.
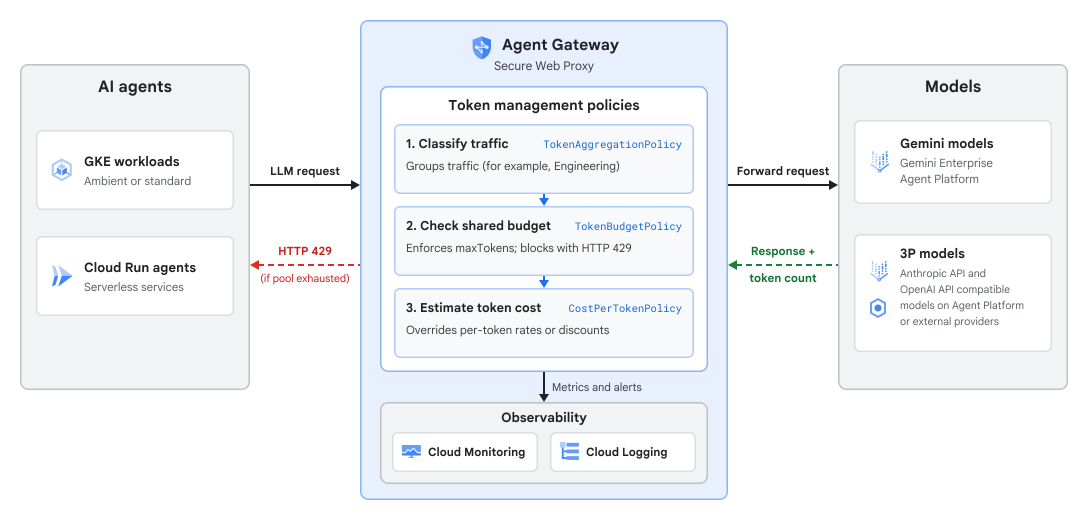
La gestione dei token utilizza tre risorse delle policy che collaborano per classificare il traffico, applicare i budget dei token e personalizzare i calcoli dei costi:
- Policy di aggregazione dei token (
TokenAggregationPolicy): classifica le richieste in entrata dall'agente al modello e aggrega il consumo di token in gruppi di token logici. I raggruppamenti possono essere basati sulla gerarchia delle risorse (ambito del progetto), sulle applicazioni di AI, sui singoli agenti, sui modelli di destinazione o su tag personalizzati passati nelle intestazioni delle richieste HTTP (incluse le chiavi API). - Policy del budget dei token (
TokenBudgetPolicy): definisce i pool di token che applicano le quote di token a uno o più gruppi di token identificati dalla policy di aggregazione dei token. Ogni pool di token specifica un numero massimo di token, una finestra di reimpostazione periodica (oraria o giornaliera), un elenco facoltativo di modelli di destinazione, una soglia di avviso e una modalità di applicazione forzata. - Policy di costo per token (
CostPerTokenPolicy): esegue l'override dei prezzi dei token per modello predefiniti utilizzati per calcolare la metricagcp.token_management.token.estimated_costin Monitoring. Puoi configurare uno sconto percentuale sul prezzo predefinito del modello o tariffe personalizzate per token in USD per i token di input, output e memorizzati nella cache.
Dipendenza delle policy e ordine di creazione
La gestione dei token applica una gerarchia di dipendenza rigorosa tra le risorse delle policy associate allo stesso ambito di destinazione nel seguente ordine:
TokenAggregationPolicydeve essere creato prima per classificare le richieste in gruppi di token per l'ambito di destinazione. Questa policy è il requisito minimo per ottenere un'osservabilità granulare a livello di agente sull'utilizzo dei token.- (Facoltativo)
TokenBudgetPolicydeve essere configurato per limitare l'utilizzo dei token rispetto ai gruppi di token identificati inTokenAggregationPolicy. - (Facoltativo)
CostPerTokenPolicypuò essere creato solo dopo che esiste unTokenBudgetPolicycorrispondente per l'ambito di destinazione.
Quando elimini le policy, fallo in ordine inverso: prima CostPerTokenPolicy, poi TokenBudgetPolicy e infine TokenAggregationPolicy.
Valutazione delle regole e corrispondenza predefinita
All'interno di un TokenAggregationPolicy, le regole vengono valutate nell'ordine in cui sono elencate e vince la prima regola corrispondente:
- Traffico corrispondente: quando una richiesta dell'agente corrisponde ai criteri di origine di una regola (applicazione AI o identità dell'agente) e ai criteri di destinazione (intestazioni HTTP o endpoint del provider del modello), l'utilizzo dei token viene assegnato al gruppo di token della regola (
tokenGroup). - Regola generica: puoi inserire una regola con un blocco di corrispondenza vuoto alla fine dell'elenco di regole per assegnare tutto il traffico rimanente a un gruppo di token predefinito, ad esempio
Default. - Traffico senza corrispondenza: se non includi una regola catch-all e una richiesta non corrisponde a nessuna regola della policy, il consumo di token viene registrato nel gruppo di sistema
unmatchedin Monitoring. - Traffico del pool non definito: se un
TokenPoolnella policy del budget dei token (TokenBudgetPolicy) limita l'applicazione a modelli specifici, le richieste ai modelli al di fuori di quell'elenco non vengono bloccate e vengono registrate con il nome del pool impostato suundefinedin Monitoring.
Ambienti e modelli supportati
Le policy di gestione dei token supportano i seguenti runtime degli agenti, deployment di Agent Gateway e modelli:
| Componente | Opzioni supportate |
|---|---|
| Runtime degli agenti AI |
|
| Deployment di Agent Gateway | Secure Web Proxy nel tuo progetto Cloud de Confiance by S3NS : applica la governance dei token in uscita per tutte le richieste da agente a modello. |
| Modelli |
Modelli compatibili con le API Gemini, Anthropic e OpenAI di qualsiasi provider di modelli:
|
| Raggruppamenti di aggregazione |
|
Flusso di applicazione delle norme
Con la limitazione di frequenza standard, ogni richiesta viene conteggiata come un'unità prima di raggiungere il backend. Con le chiamate LLM, il numero totale di token di input e output è noto solo dopo che il modello ha risposto. Per gestire questa situazione, Agent Gateway elabora ogni richiesta in due fasi:
- Controllo del budget del periodo di pubblicazione pre-flight (percorso della richiesta):
- Un agente invia una richiesta di inferenza a un endpoint LLM tramite Agent Gateway.
- Il gateway valuta la richiesta in base alla tua
TokenAggregationPolicyper identificare latokenGroupcorrispondente e cerca laTokenPoolassociata nella tuaTokenBudgetPolicy. - Se il budget dei token del pool è esaurito e l'applicazione rigorosa è abilitata, il gateway rifiuta immediatamente la richiesta con un codice di stato HTTP
429. Se il pool ha un budget rimanente o è configurato per la modalità di solo avviso, il gateway inoltra la richiesta all'LLM.
- Riconciliazione dei token e telemetria (percorso di risposta):
- Quando l'endpoint LLM restituisce la risposta di completamento, il gateway estrae i conteggi effettivi dei token
input,outputecacheddal payload della risposta. - La gestione dei token riconcilia i token utilizzati con la quota
maxTokensdel pool. - Se il consumo aggiornato supera la soglia di avviso o raggiunge il 100% del budget, il gateway scrive un avviso in Logging.
- Il gateway esporta le metriche relative al consumo di token per agente (
gen_ai.client.token.usage) e al costo stimato dei token (gcp.token_management.token.estimated_cost) in Monitoring.
- Quando l'endpoint LLM restituisce la risposta di completamento, il gateway estrae i conteggi effettivi dei token
Tieni presente che i conteggi dei token di output vengono registrati solo dopo il completamento di una risposta LLM. Di conseguenza, le richieste in parallelo ammesse prima che un pool raggiunga maxTokens possono superare il limite prima che le richieste successive vengano bloccate con HTTP 429. Per evitare limitazioni impreviste, imposta un alertThreshold come 0.6 o 0.8 per testare le nuove policy con validateOnly: true prima di attivare l'applicazione rigorosa.
Controlli di governance correlati
La tabella seguente mostra come funzionano le policy di gestione dei token con altre piattaforme agent e controlli di governance di Cloud de Confiance :
| Livello di governance | Policy o meccanismo | Finalità |
|---|---|---|
| Controllo degli accessi | Policy di accesso di Identity and Access Management (IAM) | Controlla quali identità degli agenti (ID SPIFFE) sono autorizzate a connettersi a server MCP, strumenti ed endpoint dei modelli specifici. |
| Intent e regole aziendali | Norme di governance semantica | Valuta le chiamate degli strumenti proposte rispetto ai vincoli di linguaggio naturale (NLC) e allo user intent prima dell'esecuzione. |
| Sicurezza dei contenuti | Model Armor | Analizza prompt e risposte per rilevare prompt injection, jailbreak e dati sensibili. |
| Limitazione di frequenza basata sul numero di richieste | Limitazione di frequenza del servizio (RateLimitPolicy) |
Protegge i bilanciatori del carico e i proxy in entrata da flood di richieste volumetriche limitando le richieste HTTP al secondo o al minuto (countLimit). |
| Governance dei token e dei costi LLM | Policy di gestione dei token
(TokenAggregationPolicy, TokenBudgetPolicy,
CostPerTokenPolicy) |
Monitora e attribuisce l'utilizzo dei token LLM e applica i budget dei token condivisi (maxTokens) e gli override dei costi tra i gruppi di agenti e i provider di modelli. |
Limitazioni
Le policy di gestione dei token presentano le seguenti limitazioni:
- Puoi collegare al massimo un
TokenAggregationPolicy, unTokenBudgetPolicye unCostPerTokenPolicya un determinato ambito di destinazione del progetto. - Ogni
TokenAggregationPolicysupporta fino a 10 regole di aggregazione (rules) e ogniTokenBudgetPolicysupporta fino a 10 pool di token. - I pool di token supportano periodi di reimpostazione di
HOURLYeDAILY; i budget giornalieri vengono reimpostati alla mezzanotte del fuso orario del Pacifico. - Logging genera voci di log solo quando un pool di token supera la soglia
alertThresholdconfigurata o raggiunge il 100% dimaxTokens(token_management_alert_logs).