

Visão geral
As políticas de gerenciamento de tokens permitem monitorar e atribuir com precisão o uso de tokens de modelos de linguagem grandes (LLMs) e aplicar orçamentos de tokens compartilhados em todos os agentes e aplicativos de IA da empresa.
Quando os agentes de IA interagem com LLMs, a limitação de taxa de contagem de solicitações, como solicitações por segundo ou por minuto, não é suficiente para controlar os gastos ou a capacidade. Uma única solicitação HTTP para um LLM pode consumir de uma dúzia a mais de 100.000 tokens. Sem a governança no nível do token, um único loop de agente descontrolado pode esgotar as cotas de modelos empresariais compartilhados e causar picos de custo inesperados. Para gerenciar os gastos com IA, as empresas também precisam definir orçamentos de cotas de modelos para usuários e departamentos em toda a organização.
Com as políticas de gerenciamento de tokens, é possível:
- Calcule o uso de tokens de entrada, saída e em cache em todas as interações entre o agente e o modelo.
- Atribua o consumo de tokens e o custo estimado a grupos relevantes para os negócios, aplicativos de IA e identidades de agentes individuais em modelos hospedados na Gemini Enterprise Agent Platform ou em qualquer outra plataforma de hospedagem de modelos.
- Aplique orçamentos de tokens compartilhados em tempo real, emitindo alertas de limite ou
retornando HTTP
429 Too Many Requestsquando o orçamento de um pool de tokens estiver esgotado. - Exporte telemetria de observabilidade granular para o Cloud Monitoring e agregue alertas de uso de tokens no Cloud Logging.
Como funciona
A Figura 1 mostra como as políticas de gerenciamento de tokens avaliam as solicitações e respostas de LLM na camada de gateway.
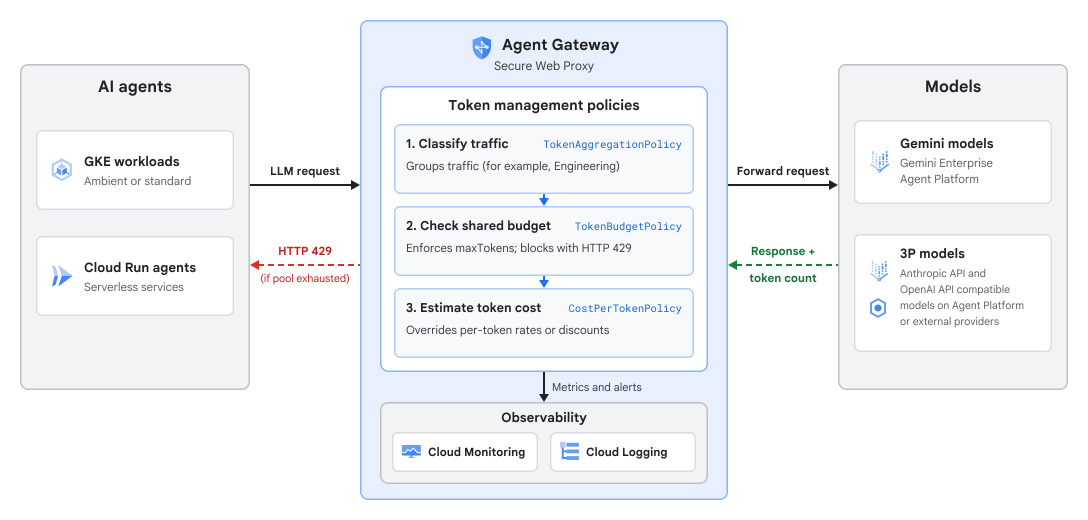
O gerenciamento de tokens usa três recursos de política que trabalham juntos para classificar o tráfego, aplicar orçamentos de tokens e personalizar os cálculos de custo:
- Política de agregação de tokens (
TokenAggregationPolicy): classifica as solicitações de agente para modelo recebidas e agrega o consumo de tokens em grupos de tokens lógicos. Os agrupamentos podem ser baseados na hierarquia de recursos (escopo do projeto), aplicativos de IA, agentes individuais, modelos de destino ou tags personalizadas transmitidas em cabeçalhos de solicitação HTTP (incluindo chaves de API). - Política de orçamento de tokens (
TokenBudgetPolicy): define os pools de tokens que aplicam cotas de tokens em um ou mais grupos de tokens identificados pela política de agregação de tokens. Cada pool de tokens especifica uma contagem máxima de tokens, uma janela de redefinição periódica (por hora ou por dia), uma lista opcional de modelos de destino, um limite de alerta e um modo de aplicação. - Política de custo por token (
CostPerTokenPolicy): substitui o preço padrão por token de modelo usado para calcular a métricagcp.token_management.token.estimated_costno Monitoring. É possível configurar um desconto percentual no preço padrão do modelo ou taxas personalizadas por token em USD para tokens de entrada, saída e em cache.
Dependência de políticas e ordem de criação
O gerenciamento de tokens aplica uma hierarquia de dependência estrita entre os recursos de política anexados ao mesmo escopo de destino na seguinte ordem:
TokenAggregationPolicyprecisa ser criado primeiro para classificar as solicitações em grupos de tokens para o escopo de destino. Essa política é o requisito mínimo para ter observabilidade granular no nível do agente sobre o uso de tokens.- (Opcional)
TokenBudgetPolicyprecisa ser configurado para limitar o uso de tokens em relação aos grupos de tokens identificados noTokenAggregationPolicy. - (Opcional)
CostPerTokenPolicysó pode ser criado depois que umTokenBudgetPolicycorrespondente existir para o escopo de destino.
Ao excluir políticas, faça isso na ordem inversa: primeiro CostPerTokenPolicy, depois TokenBudgetPolicy e, em seguida, TokenAggregationPolicy.
Avaliação de regras e correspondência padrão
Em um TokenAggregationPolicy, as regras são avaliadas na ordem em que estão listadas, e a primeira regra correspondente vence:
- Tráfego correspondente:quando uma solicitação de agente corresponde aos critérios de origem de uma regra
(aplicativo de IA ou identidade do agente) e aos critérios de destino (cabeçalhos HTTP ou
endpoints do provedor de modelos), o uso de tokens é atribuído ao grupo de tokens
da regra (
tokenGroup). - Regra catch-all:é possível colocar uma regra com um bloco de correspondência vazio no
final da lista de regras para atribuir todo o tráfego restante a um grupo de tokens
padrão, como
Default. - Tráfego sem correspondência:se você não incluir uma regra geral e uma solicitação
não corresponder a nenhuma regra na política, o consumo de tokens será registrado
no grupo
unmatcheddo sistema no Monitoring. - Tráfego de pool indefinido:se um
TokenPoolna política de orçamento de tokens (TokenBudgetPolicy) restringir a aplicação a modelos específicos, as solicitações para modelos fora dessa lista não serão bloqueadas e serão registradas com o nome do pool definido comoundefinedno Monitoring.
Ambientes e modelos compatíveis
As políticas de gerenciamento de tokens são compatíveis com os seguintes Agent Runtimes, implantações de Gateway de Agente e modelos:
| Componente | Opções aceitas |
|---|---|
| Ambientes de execução de agentes de IA |
|
| Implantações do Gateway de Agente | Secure Web Proxy no seu projeto do Cloud de Confiance by S3NS : aplica a governança de tokens de saída para todas as solicitações de agente para modelo. |
| Modelos |
Modelos compatíveis com as APIs do Gemini, da Anthropic e da OpenAI em qualquer provedor de modelos:
|
| Agrupamentos de agregação |
|
Fluxo de aplicação de políticas
Com a limitação de taxa padrão, cada solicitação conta como uma unidade antes de chegar ao back-end. Com as chamadas de LLM, o número total de tokens de entrada e saída só é conhecido depois que o modelo responde. Para lidar com isso, o Gateway de Agente processa cada solicitação em duas fases:
- Verificação de orçamento para o flight pré-flight (caminho da solicitação):
- Um agente envia uma solicitação de inferência para um endpoint de LLM pelo Gateway de Agente.
- O gateway avalia a solicitação em relação ao
TokenAggregationPolicypara identificar otokenGroupcorrespondente e procura oTokenPoolassociado noTokenBudgetPolicy. - Se o orçamento de tokens do pool estiver esgotado e a aplicação rigorosa estiver
ativada, o gateway rejeitará a solicitação imediatamente com um código de status HTTP
429. Se o pool tiver orçamento restante ou estiver configurado para o modo somente alerta, o gateway encaminhará a solicitação para o LLM.
- Reconciliação de tokens e telemetria (caminho de resposta):
- Quando o endpoint do LLM retorna a resposta de conclusão, o gateway
extrai as contagens reais de tokens
input,outputecacheddo payload de resposta. - O gerenciamento de tokens reconcilia os tokens consumidos com a cota de
maxTokensdo pool. - Se o consumo atualizado ultrapassar o limite de aviso ou atingir 100% do orçamento, o gateway vai gravar um aviso no Logging.
- O gateway exporta métricas de consumo de tokens por agente
(
gen_ai.client.token.usage) e custo estimado de tokens (gcp.token_management.token.estimated_cost) para o Monitoring.
- Quando o endpoint do LLM retorna a resposta de conclusão, o gateway
extrai as contagens reais de tokens
As contagens de tokens de saída são registradas somente após a conclusão de uma resposta do LLM. Como resultado, as solicitações simultâneas admitidas antes que um pool atinja
maxTokens podem exceder o limite antes que as solicitações posteriores sejam bloqueadas com
HTTP 429. Para evitar limitações inesperadas, defina um alertThreshold, como
0.6 ou 0.8, para testar novas políticas com validateOnly: true antes de
ativar a aplicação estrita.
Controles de governança relacionados
A tabela a seguir mostra como as políticas de gerenciamento de tokens funcionam com outros controles de governança e da plataforma de agentes do Cloud de Confiance :
| Camada de governança | Política ou mecanismo | Finalidade |
|---|---|---|
| Controle de acesso | Políticas de acesso do Identity and Access Management (IAM) | Controla quais identidades de agente (IDs SPIFFE) estão autorizadas a se conectar a servidores MCP, ferramentas e endpoints de modelo específicos. |
| Intenção e regras de negócios | Políticas de governança semântica | Avalia as chamadas de ferramentas propostas em relação às restrições de linguagem natural (NLC) e à intenção do usuário antes da execução. |
| Segurança do conteúdo | Model Armor | Verifica comandos e respostas em busca de injeção de comandos, jailbreaks e dados sensíveis. |
| Limitação de taxa de contagem de solicitações | Limitação de taxa de serviço (RateLimitPolicy) |
Protege os balanceadores de carga de entrada e os proxies contra inundações de solicitações volumétricas,
limitando as solicitações HTTP por segundo ou minuto
(countLimit). |
| Governança de tokens e custos de LLM | Políticas de gerenciamento de tokens
(TokenAggregationPolicy, TokenBudgetPolicy,
CostPerTokenPolicy) |
Monitora e atribui o uso de tokens de LLM e aplica orçamentos de tokens compartilhados (maxTokens) e substituições de custo em grupos de agentes e provedores de modelos. |
Limitações
As políticas de gerenciamento de tokens têm as seguintes limitações:
- É possível anexar no máximo um
TokenAggregationPolicy, umTokenBudgetPolicye umCostPerTokenPolicya um determinado escopo de destino do projeto. - Cada
TokenAggregationPolicyaceita até 10 regras de agregação (rules), e cadaTokenBudgetPolicyaceita até 10 pools de tokens. - Os pools de tokens são redefinidos a cada
HOURLYeDAILY. Os orçamentos diários são redefinidos à meia-noite, horário do Pacífico. - O Logging gera entradas de registro somente quando um pool de tokens ultrapassa
o
alertThresholdconfigurado ou atinge 100% demaxTokens(token_management_alert_logs).