

概览
借助 token 管理政策,您可以监控和准确归因大语言模型 (LLM) token 使用情况,并在企业 AI 智能体和应用中强制执行共享 token 预算。
当 AI 智能体与 LLM 交互时,每秒请求数或每分钟请求数等请求数速率限制不足以控制支出或容量。对 LLM 的单个 HTTP 请求可能会消耗十几个到超过 10 万个 token。如果没有令牌级治理,单个失控的智能体循环可能会耗尽共享的企业模型配额,并导致费用意外飙升。为了管理 AI 支出,企业还需要为整个组织的用户和部门设置模型配额预算。
借助令牌管理政策,您可以执行以下操作:
- 计算所有智能体与模型交互中的输入、输出和缓存 token 的 token 使用量。
- 将 Gemini Enterprise Agent Platform 或任何其他模型托管平台上托管的模型的 token 消耗量和估算费用归因于业务相关群组、AI 应用和各个智能体身份。
- 实时强制执行共享 token 预算,在 token 池的预算用尽时发出阈值提醒或返回 HTTP
429 Too Many Requests。 - 将精细的可观测性遥测数据导出到 Cloud Monitoring,并在 Cloud Logging 中汇总 token 使用情况提醒。
工作原理
图 1 展示了令牌管理政策如何在网关层评估 LLM 请求和响应。
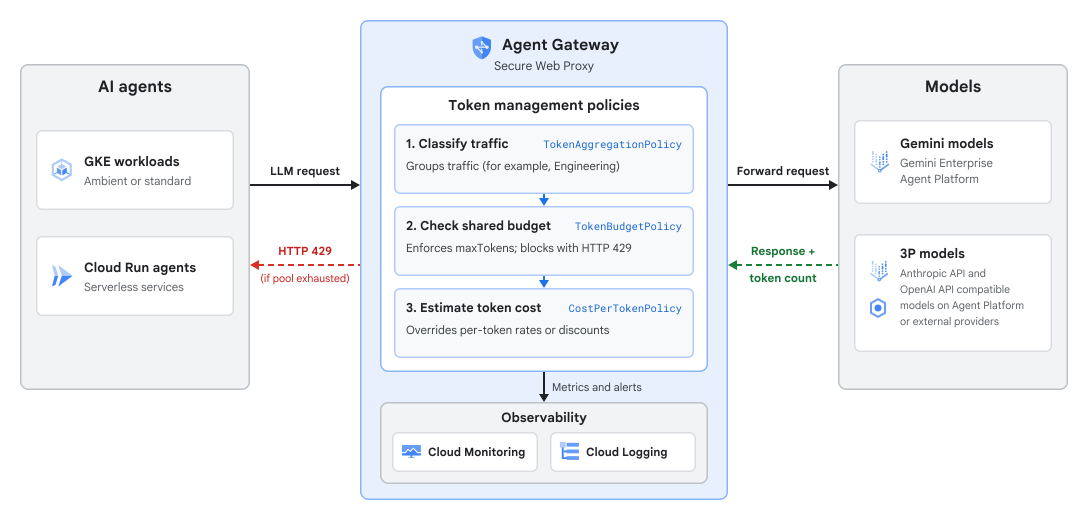
Token 管理使用三种政策资源,它们协同工作,对流量进行分类、强制执行 token 预算并自定义费用计算:
- Token 汇总政策 (
TokenAggregationPolicy):对传入的智能体到模型请求进行分类,并将其 token 消耗量汇总到逻辑 token 组中。分组可以基于资源层次结构(项目范围)、AI 应用、单个智能体、目标模型或 HTTP 请求标头中传递的自定义标记(包括 API 密钥)。 - 令牌预算政策 (
TokenBudgetPolicy):定义令牌池,这些令牌池在令牌汇总政策标识的一个或多个令牌组中应用令牌配额。每个 token 池都指定了 token 数量上限、定期重置窗口(每小时或每天)、可选的目标模型列表、提醒阈值和强制执行模式。 - 每个 token 费用政策 (
CostPerTokenPolicy):替换用于在 Monitoring 中计算gcp.token_management.token.estimated_cost指标的默认每个模型 token 价格。您可以配置默认模型价格的百分比折扣,也可以为输入、输出和缓存的 token 配置自定义的美元单价。
政策依赖关系和创建顺序
令牌管理会按照以下顺序,对附加到同一目标范围的政策资源强制执行严格的依赖关系层次结构:
- 必须先创建
TokenAggregationPolicy,才能将请求分类到目标范围的令牌组中。此政策是获得精细的智能体级令牌用量可观测性的最低要求。 - (可选)必须配置
TokenBudgetPolicy,以限制针对TokenAggregationPolicy中标识的令牌组的令牌使用。 - (可选)只有在目标范围存在相应的
TokenBudgetPolicy后,才能创建CostPerTokenPolicy。
删除政策时,请按相反顺序删除:先删除 CostPerTokenPolicy,然后删除 TokenBudgetPolicy,最后删除 TokenAggregationPolicy。
规则评估和默认匹配
在 TokenAggregationPolicy 中,系统会按规则的列出顺序对其进行评估,并以第一个匹配的规则为准:
- 匹配的流量:当智能体请求与规则的来源条件(AI 应用或智能体身份)和目标条件(HTTP 标头或模型提供方端点)匹配时,其 token 用量会分配给该规则的 token 组 (
tokenGroup)。 - 包罗万象的规则:您可以在规则列表末尾放置一条具有空匹配块的规则,以将所有剩余流量分配给默认令牌组,例如
Default。 - 不匹配的流量:如果您未添加包罗万象的规则,并且请求与政策中的任何规则都不匹配,则其令牌消耗会记录在 Monitoring 中的系统
unmatched组下。 - 未定义的池流量:如果令牌预算政策 (
TokenBudgetPolicy) 中的TokenPool将强制执行限制为特定模型,则系统不会屏蔽对该列表之外的模型的请求,并且会在 Monitoring 中记录这些请求,并将池名称设置为undefined。
支持的环境和模型
令牌管理政策支持以下 Agent Runtime、Agent Gateway 部署和模型:
| 组件 | 支持的选项 |
|---|---|
| AI 智能体运行时 |
|
| Agent Gateway 部署 | Cloud de Confiance by S3NS 项目中的 Secure Web Proxy:针对所有智能体到模型的请求强制执行出站令牌治理。 |
| 模型 |
与 Gemini、Anthropic 和 OpenAI API 兼容的模型,不限模型提供商:
|
| 汇总分组 |
|
政策执行流程
在标准速率限制下,每个请求在到达后端之前都算作一个单位。对于 LLM 调用,只有在模型响应后,才能知道输入和输出 token 的总数。为此,Agent Gateway 会分两个阶段处理每个请求:
- 预检排期预算检查(请求路径):
- 智能体通过 Agent Gateway 向 LLM 端点发送推理请求。
- 网关会根据您的
TokenAggregationPolicy评估请求,以识别匹配的tokenGroup,并在您的TokenBudgetPolicy中查找关联的TokenPool。 - 如果池的令牌预算已用尽,并且启用了严格强制执行,则网关会立即拒绝请求,并返回 HTTP
429状态代码。如果池有剩余预算或配置为仅提醒模式,网关会将请求转发到 LLM。
- 令牌对账和遥测(响应路径):
- 当 LLM 端点返回补全回答时,网关会从回答载荷中提取实际的
input、output和cachedtoken 计数。 - token 管理会根据池的
maxTokens配额来核对消耗的 token。 - 如果更新后的消耗量超过警告阈值或达到预算的 100%,网关会将警告写入 Logging。
- 网关会将每个代理的 token 消耗量 (
gen_ai.client.token.usage) 和估算的 token 费用 (gcp.token_management.token.estimated_cost) 指标导出到 Monitoring。
- 当 LLM 端点返回补全回答时,网关会从回答载荷中提取实际的
请注意,只有在 LLM 响应完成后,系统才会记录输出词元计数。因此,在池达到 maxTokens 之前允许的并发请求可能会超过限制,然后后续请求会被 HTTP 429 阻止。为避免意外限制,请设置 alertThreshold(例如 0.6 或 0.8),以便在启用严格强制执行之前使用 validateOnly: true 测试新政策。
相关治理控制措施
下表展示了词元管理政策如何与其他 Agent Platform 和 Cloud de Confiance 治理控制措施搭配使用:
| 治理层 | 政策或机制 | 用途 |
|---|---|---|
| 访问权限控制 | Identity and Access Management (IAM) 访问权限政策 | 控制哪些智能体身份 (SPIFFE ID) 有权连接到特定的 MCP 服务器、工具和模型端点。 |
| 意图和业务规则 | 语义治理政策 | 在执行前,根据自然语言限制条件 (NLC) 和用户意图评估建议的工具调用。 |
| 内容安全 | Model Armor | 扫描提示和回答,以检测提示词注入、越狱和敏感数据。 |
| 请求数速率限制 | 服务速率限制 (RateLimitPolicy) |
通过限制每秒或每分钟的 HTTP 请求数 (countLimit),保护入站流量负载均衡器和代理免受大量请求泛滥的影响。 |
| LLM token 和费用治理 | 令牌管理政策(TokenAggregationPolicy、TokenBudgetPolicy、CostPerTokenPolicy) |
监控和归因 LLM token 使用情况,并在代理组和模型提供商之间强制执行共享 token 预算 (maxTokens) 和费用替换。 |
限制
令牌管理政策具有以下限制:
- 您最多可以为一个给定的项目目标范围附加一个
TokenAggregationPolicy、一个TokenBudgetPolicy和一个CostPerTokenPolicy。 - 每个
TokenAggregationPolicy最多支持 10 条汇总规则 (rules),每个TokenBudgetPolicy最多支持 10 个令牌池。 - 令牌池支持
HOURLY和DAILY重置周期;每日预算会在美国太平洋时间午夜重置。 - 仅当令牌池超过其配置的
alertThreshold或达到maxTokens(token_management_alert_logs) 的 100% 时,Logging 才会生成日志条目。