

總覽
您可以透過詞元管理政策,監控及準確歸因大型語言模型 (LLM) 詞元用量,並在企業 AI 代理和應用程式中強制執行共用詞元預算。
AI 代理與 LLM 互動時,如果只限制每秒或每分鐘的要求數量,並不足以控管支出或容量。對 LLM 發出單一 HTTP 要求,可能會耗用數十到超過 10 萬個權杖。如果沒有權杖層級的控管機制,單一失控的代理迴圈可能會耗盡共用的企業模型配額,導致費用意外飆升。為控管 AI 支出,企業也需要為組織內的使用者和部門設定模型配額預算。
您可以透過權杖管理政策執行下列操作:
- 計算所有代理與模型互動的輸入、輸出和快取詞元用量。
- 無論模型託管於 Gemini Enterprise Agent Platform 或其他平台,您都能將權杖用量和預估費用歸因至業務相關群組、AI 應用程式和個別代理身分。
- 即時強制執行共用權杖預算,在權杖集區的預算用盡時,發出門檻警示或傳回 HTTP
429 Too Many Requests。 - 將精細的觀測能力遙測資料匯出至 Cloud Monitoring,並在 Cloud Logging 中匯總權杖用量警告。
運作方式
圖 1 顯示權杖管理政策如何在閘道層評估 LLM 要求和回覆。
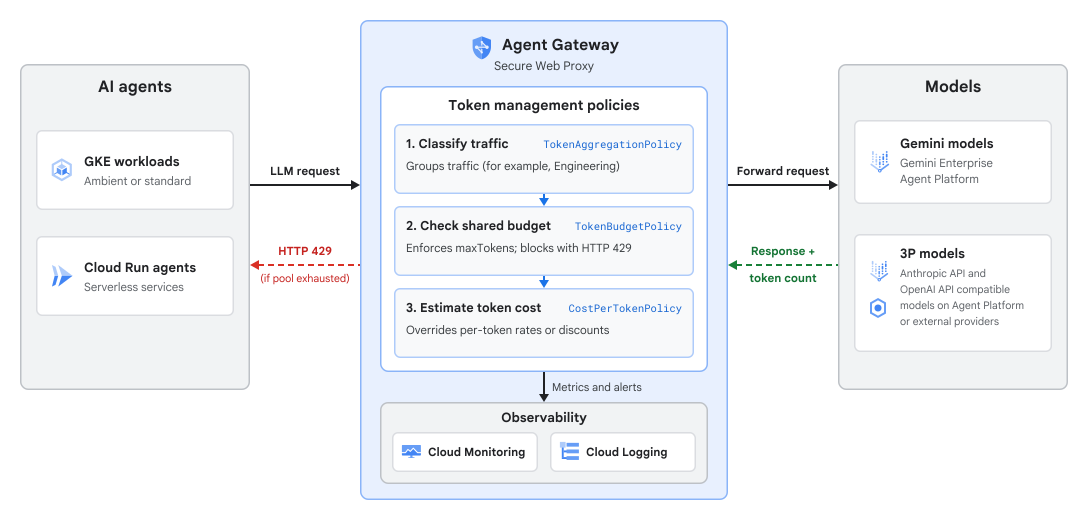
權杖管理會使用三項政策資源,共同分類流量、強制執行權杖預算,以及自訂成本計算:
- 詞元匯總政策 (
TokenAggregationPolicy):將傳入的代理到模型要求分類,並將詞元用量匯總至邏輯詞元群組。分組依據可以是資源階層 (專案範圍)、AI 應用程式、個別代理、目的地模型,或 HTTP 要求標頭中傳遞的自訂標記 (包括 API 金鑰)。 - 權杖預算政策 (
TokenBudgetPolicy):定義權杖集區,針對權杖匯總政策識別的一或多個權杖群組,套用權杖配額。每個權杖集區都會指定權杖數量上限、定期重設時間範圍 (每小時或每日)、選用的目標模型清單、警告門檻和強制執行模式。 - 每個權杖的費用政策 (
CostPerTokenPolicy):覆寫預設的每個模型權杖定價,用於計算 Monitoring 中的gcp.token_management.token.estimated_cost指標。您可以設定預設模型價格的折扣百分比,或以美元為單位,自訂輸入、輸出和快取詞元的費率。
政策依附元件和建立順序
權杖管理會按照下列順序,對附加至相同目標範圍的政策資源,強制執行嚴格的依附元件階層:
- 必須先建立
TokenAggregationPolicy,才能將要求分類為目標範圍的權杖群組。這項政策是最低要求,可讓您以精細的代理層級觀測權杖用量。 - (選用) 必須設定
TokenBudgetPolicy,限制TokenAggregationPolicy中識別的權杖群組使用權杖。 - (選用) 必須先為目標範圍建立對應的
TokenBudgetPolicy,才能建立CostPerTokenPolicy。
刪除政策時,請按照相反順序刪除:先刪除 CostPerTokenPolicy,再刪除 TokenBudgetPolicy,最後刪除 TokenAggregationPolicy。
規則評估和預設比對
在 TokenAggregationPolicy 中,系統會依列出的順序評估規則,並採用第一個相符的規則:
- 相符流量:如果代理要求符合規則的來源條件 (AI 應用程式或代理身分) 和目的地條件 (HTTP 標頭或模型供應商端點),其權杖用量就會指派給該規則的權杖群組 (
tokenGroup)。 - Catch-all 規則:您可以在規則清單結尾處放置一個比對區塊空白的規則,將所有剩餘流量指派給預設權杖群組,例如
Default。 - 不相符的流量:如果您未加入 catch-all 規則,且要求不符合政策中的任何規則,系統會在 Monitoring 的
unmatched群組中記錄其權杖消耗量。 - 未定義的集區流量:如果權杖預算政策 (
TokenBudgetPolicy) 中的TokenPool限制只對特定模型強制執行,系統就不會封鎖對該清單以外模型的請求,並會在 Monitoring 中記錄集區名稱設為undefined。
支援的環境和模型
權杖管理政策支援下列 Agent Runtime、Agent Gateway 部署作業和模型:
| 元件 | 支援的選項 |
|---|---|
| AI 代理執行階段 |
|
| Agent Gateway 部署作業 | Cloud de Confiance by S3NS 專案中的 Secure Web Proxy:針對所有代理到模型的請求,強制執行輸出權杖管理。 |
| 模型 |
Gemini、Anthropic 和 OpenAI API 相容模型,不限模型供應商:
|
| 匯總分組 |
|
政策違規處置流程
使用標準頻率限制時,每個要求在到達後端之前都會計為一個單位。使用 LLM 呼叫時,只有在模型回覆後,才能得知輸入和輸出詞元的總數。為此,Agent Gateway 會分兩個階段處理每項要求:
- 檔期預算預檢 (要求路徑):
- 代理透過 Agent Gateway 向 LLM 端點傳送推論要求。
- 閘道會根據
TokenAggregationPolicy評估要求,找出相符的tokenGroup,並在TokenBudgetPolicy中查詢相關聯的TokenPool。 - 如果集區的權杖預算用盡,且已啟用嚴格強制執行,閘道會立即拒絕要求,並傳回 HTTP
429狀態碼。如果集區仍有預算,或設為僅限警告模式,閘道會將要求轉送至 LLM。
- 權杖對帳和遙測 (回應路徑):
- LLM 端點傳回完成回應時,閘道會從回應酬載中擷取實際的
input、output和cached詞元數量。 - 權杖管理功能會根據集區的
maxTokens配額,調整已使用的權杖。 - 如果更新後的消耗量超過警告門檻,或達到預算的 100%,閘道會將警告寫入 Logging。
- 閘道會將每個代理的詞元消耗量 (
gen_ai.client.token.usage) 和預估詞元費用 (gcp.token_management.token.estimated_cost) 指標匯出至 Monitoring。
- LLM 端點傳回完成回應時,閘道會從回應酬載中擷取實際的
請注意,只有在 LLM 回覆完成後,系統才會記錄輸出詞元數量。因此,在集區達到 maxTokens 之前允許的並行要求可能會超過限制,之後的要求則會遭到封鎖,並傳回 HTTP 429。為避免意外限流,請設定 alertThreshold (例如 0.6 或 0.8),先使用 validateOnly: true 測試新政策,再啟用嚴格強制執行。
相關管理控制項
下表說明權杖管理政策如何與其他 Agent Platform 和 Cloud de Confiance 控管機制搭配運作:
| 管理層 | 政策或機制 | 目的 |
|---|---|---|
| 存取控管 | Identity and Access Management (IAM) 存取權政策 | 控管哪些代理身分 (SPIFFE ID) 有權連線至特定 MCP 伺服器、工具和模型端點。 |
| 意圖和業務規則 | 語意管理政策 | 在執行前,根據自然語言限制 (NLC) 和使用者意圖,評估建議的工具呼叫。 |
| 內容安全 | Model Armor | 掃描提示詞和回覆,找出提示詞注入、越獄和機密資料。 |
| 要求計數頻率限制 | 服務頻率限制 (RateLimitPolicy) |
限制每秒或每分鐘的 HTTP 要求數 (countLimit),保護輸入負載平衡器和 Proxy,防範巨量要求氾濫。 |
| LLM 詞元和成本管理 | 權杖管理政策 (TokenAggregationPolicy、TokenBudgetPolicy、CostPerTokenPolicy) |
監控及歸因 LLM 詞元用量,並在代理群組和模型供應商之間強制執行共用詞元預算 (maxTokens) 和費用覆寫。 |
限制
權杖管理政策有下列限制:
- 在特定專案目標範圍內,最多可附加一個
TokenAggregationPolicy、一個TokenBudgetPolicy和一個CostPerTokenPolicy。 - 每個
TokenAggregationPolicy最多支援 10 個匯總規則 (rules),每個TokenBudgetPolicy最多支援 10 個權杖集區。 - 權杖集區支援
HOURLY和DAILY重設週期;每日預算會在太平洋時間午夜重設。 - 只有在權杖集區超過設定的
alertThreshold或達到maxTokens的 100% (token_management_alert_logs) 時,Logging 才會產生記錄項目。