 Google משתמשת בטכנולוגיית AI כדי לתרגם תוכן לשפה המועדפת עליך. בתרגומים כאלו עשויות להיות שגיאות.
אימון מודל באמצעות קוד מוכן מראש לעיבוד נתונים: מחברת
כמדעני נתונים, זהו תהליך עבודה נפוץ: אימון מודל באופן מקומי (ב-Notebook), רישום הפרמטרים, רישום מדדי סדרת הזמן של האימון ב-Vertex AI TensorBoard ורישום מדדי ההערכה.
כמדען נתונים, אני רוצה להשתמש בקוד לעיבוד מראש של נתונים שכתבו אנשים אחרים בחברה שלי, כדי לפשט את כל תהליך ה-data wrangling המורכב שאנחנו מבצעים ולהפוך אותו לתהליך סטנדרטי. אני רוצה:
- שימוש בספריית עיבוד מקדים של נתונים ב-Python כדי לנקות מערך נתונים בזיכרון (Pandas Dataframe) ב-notebook.
- לאמן מודל באמצעות Keras (שוב ב-notebook).
Notebook: ניסויים במודלים עם נתונים שעברו עיבוד מראש
ב-Notebook "יצירת שושלת של Vertex AI Experiments לאימון בהתאמה אישית", תלמדו איך לשלב קוד עיבוד מראש ב-Vertex AI Experiments.
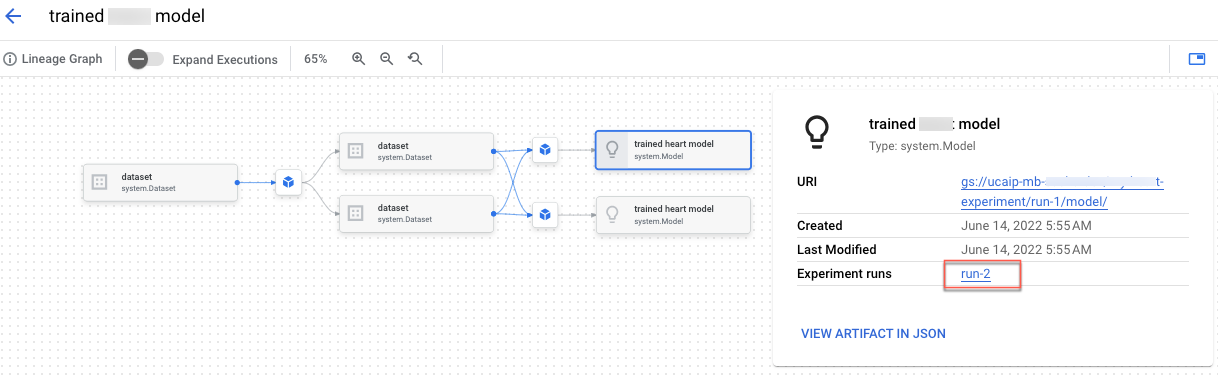
בנוסף, תבנו את שושלת הניסוי שמאפשרת לתעד, לנתח, לנפות באגים ולבדוק מטא-נתונים וארטיפקטים שנוצרו במהלך תהליך ה-ML.
אפשר לראות את שושלת היוחסין של פריט המידע במסוף Cloud de Confiance .
תוכן רלוונטי
אלא אם צוין אחרת, התוכן של דף זה הוא ברישיון Creative Commons Attribution 4.0 ודוגמאות הקוד הן ברישיון Apache 2.0. לפרטים, ניתן לעיין במדיניות האתר Google Developers. Java הוא סימן מסחרי רשום של חברת Oracle ו/או של השותפים העצמאיים שלה.
עדכון אחרון: 2026-10-21 (שעון UTC).
[[["התוכן קל להבנה","easyToUnderstand","thumb-up"],["התוכן עזר לי לפתור בעיה","solvedMyProblem","thumb-up"],["סיבה אחרת","otherUp","thumb-up"]],[["חסרים לי מידע או פרטים","missingTheInformationINeed","thumb-down"],["התוכן מורכב מדי או עם יותר מדי שלבים","tooComplicatedTooManySteps","thumb-down"],["התוכן לא עדכני","outOfDate","thumb-down"],["בעיה בתרגום","translationIssue","thumb-down"],["בעיה בדוגמאות/בקוד","samplesCodeIssue","thumb-down"],["סיבה אחרת","otherDown","thumb-down"]],["עדכון אחרון: 2026-10-21 (שעון UTC)."],[],[]]
