

En esta página, se proporciona una descripción general de Model Monitoring.
Descripción general de Monitoring
Model Monitoring te permite ejecutar trabajos de supervisión según sea necesario o de forma regular para hacer un seguimiento de la calidad de tus modelos tabulares. Si configuraste alertas, Model Monitoring te informa cuando las métricas superan un umbral especificado.
Por ejemplo, supongamos que tienes un modelo que predice el valor del ciclo de vida del cliente. A medida que cambian los hábitos de los clientes, también cambian los factores que predicen sus gastos. Por lo tanto, es posible que los atributos y sus valores que usaste para entrenar el modelo antes no sean relevantes para realizar inferencias hoy. Esta desviación en los datos se conoce como desvío.
Model Monitoring puede realizar un seguimiento y alertarte cuando las desviaciones superen un umbral especificado. Luego, puedes volver a evaluar o entrenar el modelo para asegurarte de que se comporte según lo previsto.
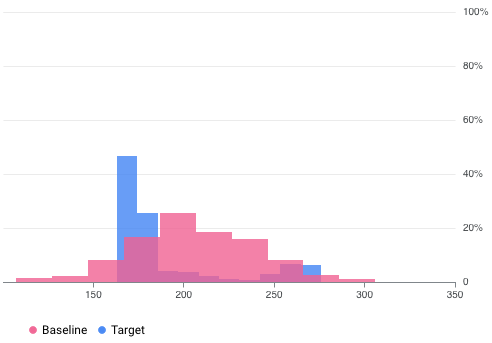
Por ejemplo, Model Monitoring puede proporcionar visualizaciones como en la siguiente figura, que superpone dos gráficos de dos conjuntos de datos. Esta visualización te permite comparar y ver rápidamente las desviaciones entre los dos conjuntos de datos.
Versiones de Model Monitoring
Model Monitoring ofrece dos versiones: v2 y v1.
Model Monitoring v2 se encuentra en versión preliminar y es la oferta más reciente que asocia todas las tareas de supervisión con una versión del modelo. En cambio, Model Monitoring v1 está disponible de forma general y se configura en los extremos de Gemini Enterprise Agent Platform.
Si necesitas asistencia a nivel de producción y quieres supervisar un modelo que se implementa en un extremo de Agent Platform, usa Model Monitoring v1. Para todos los demás casos de uso, usa Model Monitoring v2, que proporciona todas las funciones de Model Monitoring v1 y mucho más. Para obtener más información, consulta la descripción general de cada versión:
Para los usuarios existentes de Model Monitoring v1, Model Monitoring v1 se mantiene tal como está. No es necesario que migres a Model Monitoring v2. Si quieres migrar, puedes usar ambas versiones de forma simultánea hasta que hayas migrado por completo a Model Monitoring v2 para evitar brechas de supervisión durante la transición.
Descripción general de Model Monitoring v2
Model Monitoring v2 te permite hacer un seguimiento de las métricas a lo largo del tiempo después de configurar un supervisor de modelos y ejecutar trabajos de supervisión. Puedes ejecutar trabajos de supervisión a pedido o configurar ejecuciones programadas. Con las ejecuciones programadas, Model Monitoring ejecuta automáticamente trabajos de supervisión según un programa que definas.
Objetivos de supervisión
Las métricas y los umbrales que supervisas se asignan a los objetivos de supervisión. Para cada versión del modelo, puedes especificar uno o más objetivos de supervisión. En la siguiente tabla, se detalla cada objetivo:
| Objetivo | Descripción | Tipo de datos del atributo | Métricas admitidas |
|---|---|---|---|
| Desvío de datos de atributos de entrada |
Mide la distribución de los valores de los atributos de entrada en comparación con una distribución de datos de referencia. |
Categóricos: booleanos, cadenas y categóricos |
|
| Numérico: número de punto flotante, número entero | Divergencia de Jensen-Shannon | ||
| Desvío de datos de inferencia de salida |
Mide la distribución de datos de inferencias del modelo en comparación con una distribución de datos de referencia. |
Categóricos: booleanos, cadenas y categóricos |
|
| Numérico: número de punto flotante, número entero | Divergencia de Jensen-Shannon | ||
| Aplicación de atributos |
Mide el cambio en la contribución de los atributos a la inferencia de un modelo en comparación con un modelo de referencia. Por ejemplo, puedes hacer un seguimiento para ver si un atributo muy importante disminuye de forma repentina. |
Todos los tipos de datos | Valor de SHAP (explicaciones aditivas de Shapley) |
Desvío de atributos de entrada y de inferencia de salida
Después de implementar un modelo en producción, los datos de entrada pueden desviarse de los datos que se usaron para entrenar el modelo, o la distribución de los datos de atributos en producción podría cambiar de forma significativa con el tiempo. Model Monitoring v2 puede supervisar los cambios en la distribución de los datos de producción en comparación con los datos de entrenamiento o hacer un seguimiento de la evolución de la distribución de los datos de producción a lo largo del tiempo.
Del mismo modo, para los datos de inferencia, Model Monitoring v2 puede supervisar los cambios en la distribución de los resultados previstos en comparación con los datos de entrenamiento o la distribución de los datos de producción a lo largo del tiempo.
Aplicación de atributos
Las atribuciones de atributos indican cuánto contribuyó cada atributo del modelo a las inferencias para cada instancia determinada. Las puntuaciones de atribución son proporcionales a la contribución del atributo a la inferencia de un modelo. Por lo general, se firman, lo que indica si un atributo ayuda a aumentar o reducir la inferencia. Las atribuciones en todos los atributos deben sumar la puntuación de inferencia del modelo.
Con la supervisión de atribuciones de atributos, Model Monitoring v2 realiza un seguimiento de los cambios en las contribuciones de un atributo a las inferencias de un modelo a lo largo del tiempo. Un cambio en la puntuación de atribución de un atributo clave a menudo indica que el atributo cambió de una manera que puede afectar la exactitud de las inferencias del modelo.
Para obtener más información sobre las atribuciones y las métricas de atributos, consulta Explicaciones basadas en atributos y Método de Shapley muestreado.
Cómo configurar Model Monitoring v2
Primero, debes registrar tus modelos en Model Registry. Si entregas modelos fuera de Agent Platform, no es necesario que subas el artefacto del modelo. Luego, creas un supervisor de modelos, que asocias con una versión del modelo, y defines el esquema del modelo. Para algunos modelos, como los de AutoML, el esquema se te proporciona.
En la supervisión de modelos, puedes especificar de forma opcional parámetros de configuración predeterminados, como los objetivos de supervisión, un conjunto de datos de entrenamiento, la ubicación de salida de la supervisión y la configuración de notificaciones. Para obtener más información, consulta Configura la supervisión de modelos.
Después de crear un supervisor de modelos, puedes ejecutar un trabajo de supervisión a pedido o programar trabajos periódicos para la supervisión continua. Cuando ejecutas un trabajo, Model Monitoring usa la configuración predeterminada establecida en el supervisor de modelos, a menos que proporciones una configuración de supervisión diferente. Por ejemplo, si proporcionas diferentes objetivos de supervisión o un conjunto de datos de comparación distinto, Model Monitoring usa los parámetros de configuración del trabajo en lugar de la configuración predeterminada del supervisor de modelos. Para obtener más información, consulta Ejecuta un trabajo de supervisión.
Precios
No se te cobrará por Model Monitoring v2 durante la versión preliminar. Aún se te cobrará por el uso de otros servicios, como Cloud Storage, BigQuery, las inferencias por lotes de Agent Platform, la IA explicable de Agent Platform y Cloud Logging.
Instructivos para uso de notebooks
En los siguientes instructivos, se muestra cómo usar el SDK de Agent Platform para Python con el objetivo de configurar Model Monitoring v2 para tu modelo.
Model Monitoring v2: Trabajo de inferencia por lotes de modelos personalizados
Model Monitoring v2: Inferencia en línea de modelos personalizados
Model Monitoring v2: Modelos fuera de Gemini Enterprise Agent Platform
Descripción general de Model Monitoring v1
Para ayudarte a mantener el rendimiento de un modelo, Model Monitoring v1 supervisa los datos de entrada de inferencia del modelo para detectar el sesgo y el desvío de atributos:
El sesgo entre el entrenamiento y la entrega se produce cuando la distribución de datos de atributos en la producción difiere de la distribución de datos de atributos que se usó para entrenar el modelo. Si los datos de entrenamiento originales están disponibles, puedes habilitar la detección de sesgos a fin de supervisar tus modelos para el sesgo de entrenamiento y entrega.
El desvío de inferencia ocurre cuando la distribución de datos de atributos en la producción cambia de manera significativa con el tiempo. Si los datos de entrenamiento originales no están disponibles, puedes habilitar la detección de desvío para supervisar las entradas de datos en busca de cambios con el tiempo.
Puedes habilitar la detección de sesgo y de desvío.
Model Monitoring v1 admite la detección de desvío y sesgo de atributos categóricos y numéricos.
Los atributos categóricos son datos limitados por la cantidad de valores posibles, comúnmente agrupados por propiedades cualitativas. Por ejemplo, las categorías como tipo de producto, país o tipo de cliente.
Los atributos numéricos son datos que pueden corresponder a cualquier valor numérico. Por ejemplo, peso y altura.
Una vez que el sesgo o desvío del atributo de un modelo excede el umbral de alertas que estableciste, Model Monitoring v1 te envía una alerta por correo electrónico. También puedes ver las distribuciones para cada atributo con el paso del tiempo para evaluar si necesitas volver a entrenar el modelo.
Calcula el desvío
Para detectar el desvío de la versión 1, Model Monitoring usa TensorFlow Data Validation (TFDV) para calcular las distribuciones y las puntuaciones de distancia.
Calcula la distribución estadística del modelo de referencia:
Para la detección de sesgo, el modelo de referencia es la distribución estadística de los valores del atributo en los datos de entrenamiento.
Para la detección de desvíos, el modelo de referencia es la distribución estadística de los valores del atributo que se vieron en producción en el pasado.
Las distribuciones de atributos categóricos y numéricos se calculan de la siguiente manera:
Para los atributos categóricos, la distribución calculada es el número o porcentaje de instancias de cada valor posible del atributo.
Para los atributos numéricos, Model Monitoring divide el rango de valores posibles del atributo en intervalos iguales y calcula la cantidad o el porcentaje de valores del atributo que se encuentran en cada intervalo.
El modelo de referencia se calcula cuando creas un trabajo de Model Monitoring y solo se vuelve a calcular si actualizas el conjunto de datos de entrenamiento para el trabajo.
Calcula la distribución estadística de los valores más recientes del atributo vistos en producción.
Calcula la puntuación de distancia para comparar la distribución de los valores más recientes del atributo en producción con la distribución del modelo de referencia:
Para los atributos categóricos, la puntuación de distancia se calcula mediante la distancia L infinito.
Para los atributos numéricos, la puntuación de distancia se calcula mediante la divergencia de Jensen-Shannon.
Cuando la puntuación de distancia entre dos distribuciones estadísticas supera el umbral que especificaste, Model Monitoring identifica la anomalía como sesgo o desvío.
En el siguiente ejemplo, se muestra el sesgo o desvío entre el modelo de referencia y las distribuciones más recientes de un atributo categórico:
Distribución de modelo de referencia

Distribución más reciente

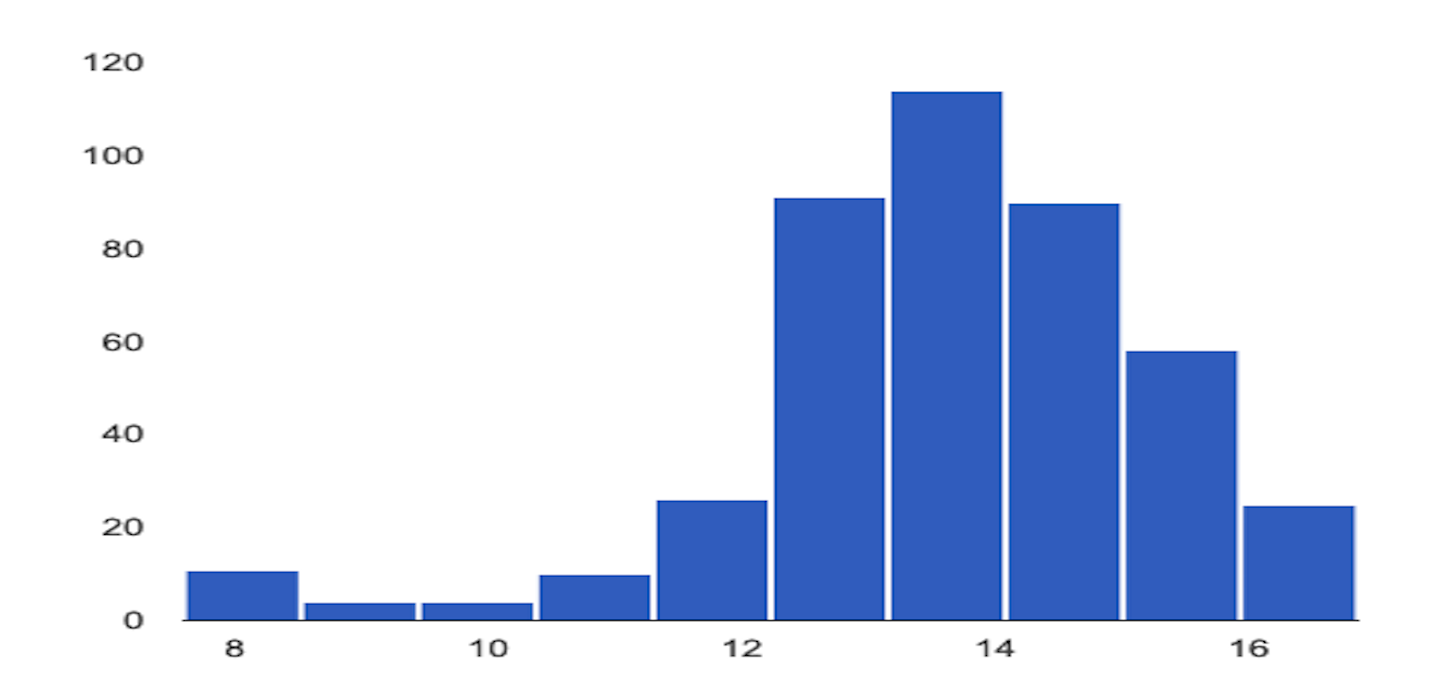
En el siguiente ejemplo, se muestra un sesgo o un desvío entre el modelo de referencia y las distribuciones más recientes de un atributo numérico:
Distribución de modelo de referencia
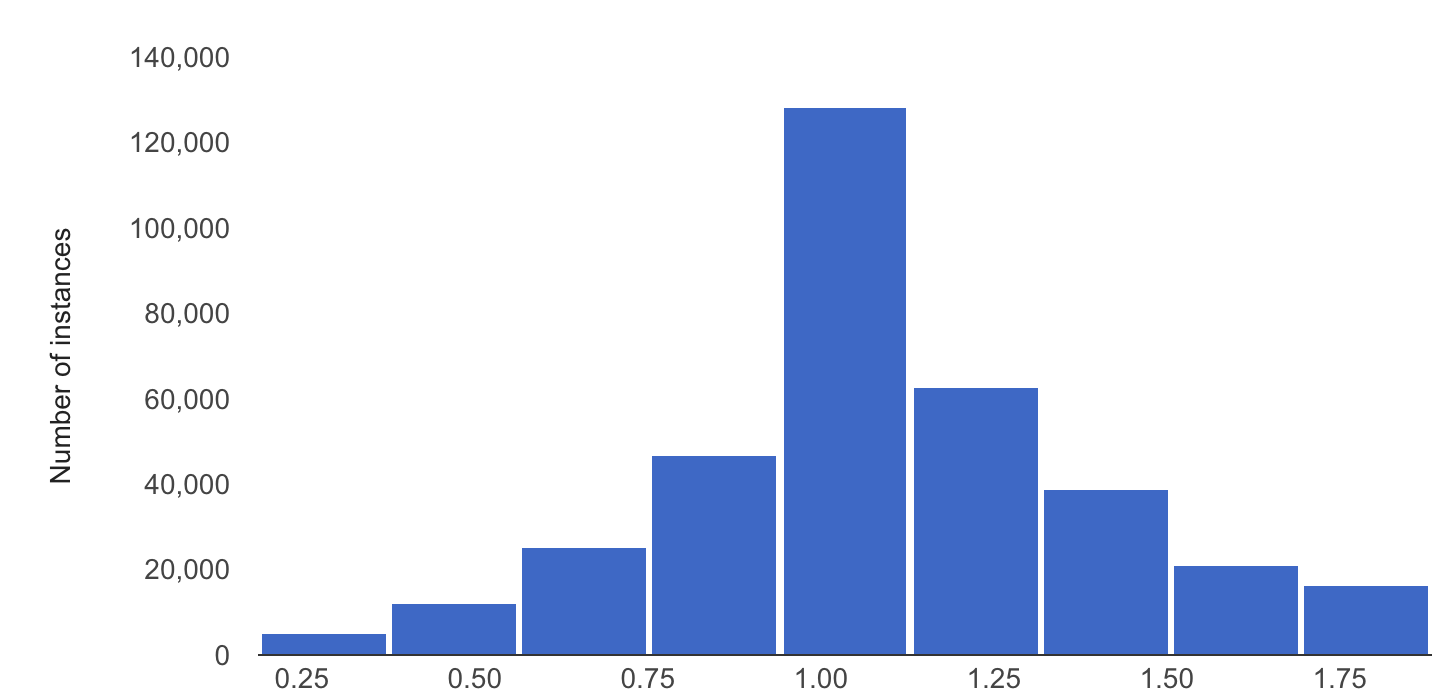
Distribución más reciente
Consideraciones para usar Model Monitoring
Para fines de rentabilidad, puedes configurar una tasa de muestreo de solicitudes de inferencia para supervisar un subconjunto de las entradas de producción en un modelo.
Puedes establecer una frecuencia con la que se supervisarán las entradas registradas recientemente de un modelo implementado para detectar sesgos o desvíos. La frecuencia de supervisión determina el período, o el tamaño del período de supervisión, de los datos registrados que se analizan en cada ejecución de supervisión.
Puedes especificar umbrales de alertas para cada función que desees supervisar. Se registra una alerta cuando la distancia estadística entre la distribución de los atributos de entrada y el modelo de referencia correspondiente supera el umbral especificado. De forma predeterminada, se supervisa cada atributo categórico y numérico, con valores de umbral de 0.3.
Un extremo de inferencia en línea puede alojar varios modelos. Cuando habilitas la detección de sesgo o desvío en un extremo, se comparten los siguientes parámetros de configuración en todos los modelos alojados en ese extremo:
- Tipo de detección
- Frecuencia de supervisión
- Fracción de las solicitudes de entrada supervisadas
En los otros parámetros de configuración, puedes establecer valores diferentes para cada modelo.