

Questa pagina fornisce una panoramica di Model Monitoring.
Panoramica del monitoraggio
Model Monitoring consente di eseguire job di monitoraggio on demand o in base a una pianificazione regolare per monitorare la qualità dei modelli tabulari. Se hai impostato avvisi, Model Monitoring ti informa quando le metriche superano una soglia specificata.
Ad esempio, supponiamo di avere un modello che prevede il customer lifetime value. Man mano che le abitudini dei clienti cambiano, cambiano anche i fattori che prevedono la spesa dei clienti. Di conseguenza, le caratteristiche e i valori delle caratteristiche che hai utilizzato per addestrare il modello in precedenza potrebbero non essere pertinenti per fare inferenze oggi. Questa deviazione nei dati è nota come deviazione.
Model Monitoring può monitorare e avvisarti quando le deviazioni superano una soglia specificata. Puoi quindi rivalutare o riaddestrare il modello per assicurarti che si comporti come previsto.
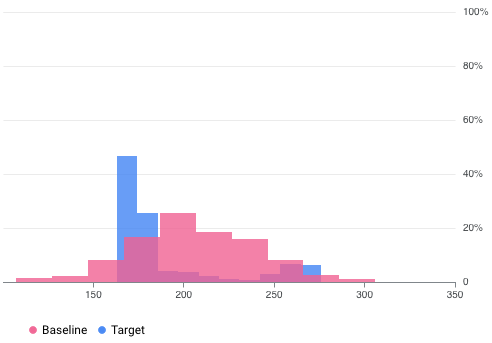
Ad esempio, Model Monitoring può fornire visualizzazioni come quella nella figura seguente, che sovrappone due grafici di due set di dati. Questa visualizzazione ti consente di confrontare rapidamente e vedere le deviazioni tra i due set di dati.
Versioni di Model Monitoring
Model Monitoring offre due versioni: v2 e v1.
Model Monitoring v2 è in anteprima ed è l'ultima offerta che associa tutte le attività di monitoraggio a una versione del modello. Al contrario, Model Monitoring v1 è in disponibilità generale ed è configurato sugli endpoint di Gemini Enterprise Agent Platform.
Se hai bisogno di assistenza a livello di produzione e vuoi monitorare un modello di cui è stato eseguito il deployment su un endpoint Agent Platform, utilizza Model Monitoring v1. Per tutti gli altri casi d'uso, utilizza Model Monitoring v2, che fornisce tutte le funzionalità di Model Monitoring v1 e altro ancora. Per saperne di più, consulta la panoramica di ciascuna versione:
Per gli utenti esistenti di Model Monitoring v1, Model Monitoring v1 viene mantenuto così com'è. Non è necessario eseguire la migrazione a Model Monitoring v2. Se vuoi eseguire la migrazione, puoi utilizzare entrambe le versioni contemporaneamente fino a quando non avrai eseguito completamente la migrazione a Model Monitoring v2 per evitare lacune nel monitoraggio durante la transizione.
Panoramica di Model Monitoring v2
Model Monitoring v2 ti consente di monitorare le metriche nel tempo dopo aver configurato un monitor del modello ed eseguito i job di monitoraggio. Puoi eseguire job di monitoraggio on demand o configurare esecuzioni pianificate. Utilizzando le esecuzioni pianificate, Model Monitoring esegue automaticamente i job di monitoraggio in base a una pianificazione definita da te.
Obiettivi di monitoraggio
Le metriche e le soglie che monitori sono mappate agli obiettivi di monitoraggio. Per ogni versione del modello, puoi specificare uno o più obiettivi di monitoraggio. La tabella seguente descrive in dettaglio ogni obiettivo:
| Obiettivo | Descrizione | Tipo di dati della caratteristica | Metriche supportate |
|---|---|---|---|
| Deviazione dei dati delle caratteristiche di input |
Misura la distribuzione dei valori delle caratteristiche di input rispetto a una distribuzione dei dati di riferimento. |
Categorico: booleano, stringa, categorico |
|
| Numerici: float, integer | Divergenza di Jensen-Shannon | ||
| Deviazione dei dati di inferenza di output |
Misura la distribuzione dei dati delle inferenze del modello rispetto a una distribuzione dei dati di riferimento. |
Categorico: booleano, stringa, categorico |
|
| Numerici: float, integer | Divergenza di Jensen-Shannon | ||
| Attribuzione delle caratteristiche |
Misura la variazione del contributo delle caratteristiche all'inferenza di un modello rispetto a una base di riferimento. Ad esempio, puoi monitorare se l'importanza di una caratteristica molto importante diminuisce improvvisamente. |
Tutti i tipi di dati | Valore SHAP (SHapley Additive exPlanations) |
Deviazione della caratteristica di input e dell'inferenza di output
Dopo il deployment di un modello in produzione, i dati di input possono deviare dai dati utilizzati per addestrare il modello o la distribuzione dei dati delle caratteristiche in produzione potrebbe cambiare in modo significativo nel tempo. Model Monitoring v2 può monitorare le variazioni nella distribuzione dei dati di produzione rispetto ai dati di addestramento o monitorare l'evoluzione della distribuzione dei dati di produzione nel tempo.
Analogamente, per i dati di inferenza, Model Monitoring v2 può monitorare le variazioni nella distribuzione dei risultati previsti rispetto alla distribuzione dei dati di addestramento o dei dati di prodotto nel tempo.
Attribuzione delle caratteristiche
Le attribuzioni delle caratteristiche indicano in che misura ciascuna caratteristica del modello ha contribuito alle inferenze per ogni istanza specifica. I punteggi di attribuzione sono proporzionali al contributo della caratteristica all'inferenza di un modello. In genere sono firmati, il che indica se una funzionalità contribuisce a spingere l'inferenza verso l'alto o verso il basso. Le attribuzioni di tutte le caratteristiche devono corrispondere al punteggio di inferenza del modello.
Monitorando le attribuzioni delle caratteristiche, Model Monitoring v2 monitora le variazioni nel tempo dei contributi di una caratteristica alle inferenze di un modello. Una variazione del punteggio di attribuzione di una caratteristica chiave spesso indica che la caratteristica è cambiata in un modo che può influire sull'accuratezza delle inferenze del modello.
Per ulteriori informazioni sulle attribuzioni e sulle metriche delle caratteristiche, consulta Spiegazioni basate sulle caratteristiche e Metodo Shapley campionato.
Come configurare Model Monitoring v2
Devi prima registrare i modelli in Model Registry. Se utilizzi modelli esterni ad Agent Platform, non è necessario caricare l'artefatto del modello. Poi crei un monitoraggio del modello, che associ a una versione del modello, e definisci lo schema del modello. Per alcuni modelli, come i modelli AutoML, lo schema viene fornito automaticamente.
Nel monitoraggio del modello, puoi facoltativamente specificare configurazioni predefinite come obiettivi di monitoraggio, un set di dati di addestramento, la posizione di output del monitoraggio e le impostazioni di notifica. Per saperne di più, consulta Configura il monitoraggio del modello.
Dopo aver creato un monitoraggio del modello, puoi eseguire un job di monitoraggio on demand o pianificare job regolari per il monitoraggio continuo. Quando esegui un job, Model Monitoring utilizza la configurazione predefinita impostata nel monitoraggio del modello, a meno che non fornisci una configurazione di monitoraggio diversa. Ad esempio, se fornisci obiettivi di monitoraggio diversi o un set di dati di confronto diverso, Model Monitoring utilizza le configurazioni del job anziché la configurazione predefinita del monitoraggio del modello. Per saperne di più, consulta Esegui un job di monitoraggio.
Prezzi
Non ti verrà addebitato alcun costo per Model Monitoring v2 durante l'anteprima. Ti verranno comunque addebitati i costi per l'utilizzo di altri servizi, come Cloud Storage, BigQuery, le inferenze batch di Agent Platform, l'AI spiegabile di Agent Platform e Cloud Logging.
Tutorial sui notebook
I seguenti tutorial mostrano come utilizzare l'SDK Agent Platform per Python per configurare Model Monitoring v2 per il tuo modello.
Model Monitoring v2: job di inferenza batch del modello personalizzato
Model Monitoring v2: inferenza online del modello personalizzato
Model Monitoring v2: modelli esterni a Gemini Enterprise Agent Platform
Panoramica di Model Monitoring v1
Per aiutarti a mantenere le prestazioni di un modello, Model Monitoring v1 monitora i dati di input di inferenza del modello per rilevare disallineamenti e deviazioni delle caratteristiche:
Il disallineamento addestramento/produzione si verifica quando la distribuzione dei dati delle caratteristiche in produzione si discosta dalla distribuzione dei dati delle caratteristiche utilizzata per addestrare il modello. Se i dati di addestramento originali sono disponibili, puoi attivare il rilevamento del disallineamento per monitorare i modelli per il disallineamento addestramento/erogazione.
Si verifica una deviazione dell'inferenza quando la distribuzione dei dati delle funzionalità in produzione cambia in modo significativo nel tempo. Se i dati di addestramento originali non sono disponibili, puoi attivare il rilevamento della deviazione per monitorare i dati di input per rilevare eventuali modifiche nel tempo.
Puoi attivare il rilevamento di disallineamenti e deviazioni.
Model Monitoring v1 supporta il rilevamento di disallineamento e deviazione delle caratteristiche per le caratteristiche categoriche e numeriche:
Le caratteristiche categoriche sono dati limitati dal numero di valori possibili, in genere raggruppati in base a proprietà qualitative. Ad esempio, categorie come tipo di prodotto, paese o tipo di cliente.
Le caratteristiche numeriche sono dati che possono essere qualsiasi valore numerico. Ad esempio, peso e altezza.
Quando lo sfasamento o la deviazione di una caratteristica di un modello supera una soglia di avviso impostata da te, Model Monitoring v1 ti invia un avviso via email. Puoi anche visualizzare le distribuzioni per ogni caratteristica nel tempo per valutare se devi addestrare nuovamente il modello.
Calcola la deviazione
Per rilevare la deviazione per v1, Model Monitoring utilizza TensorFlow Data Validation (TFDV) per calcolare le distribuzioni e i punteggi di distanza.
Calcola la distribuzione statistica della base di riferimento:
Per il rilevamento del disallineamento, la base è la distribuzione statistica dei valori della caratteristica nei dati di addestramento.
Per il rilevamento della deviazione, la base è la distribuzione statistica dei valori della caratteristica rilevati in produzione nel passato.
Le distribuzioni per le caratteristiche categoriche e numeriche vengono calcolate come segue:
Per le caratteristiche categoriche, la distribuzione calcolata è il numero o la percentuale di istanze di ogni possibile valore della caratteristica.
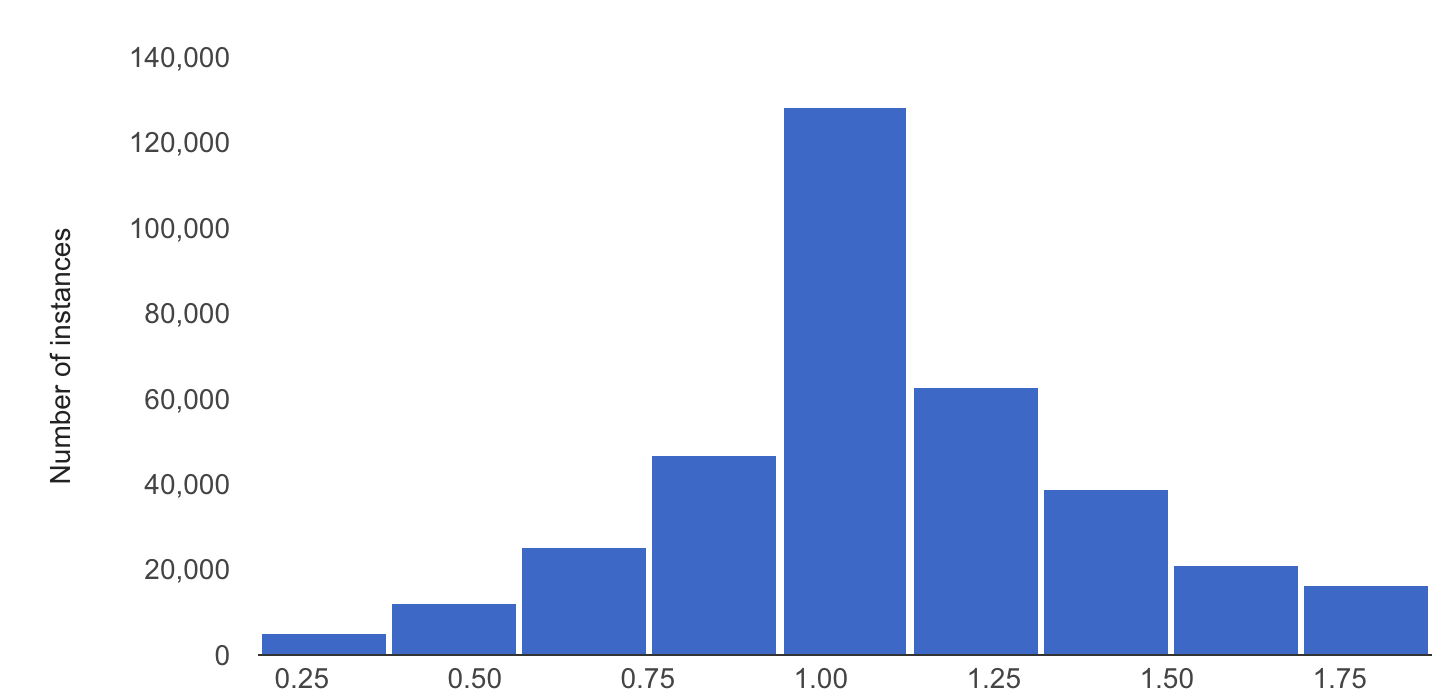
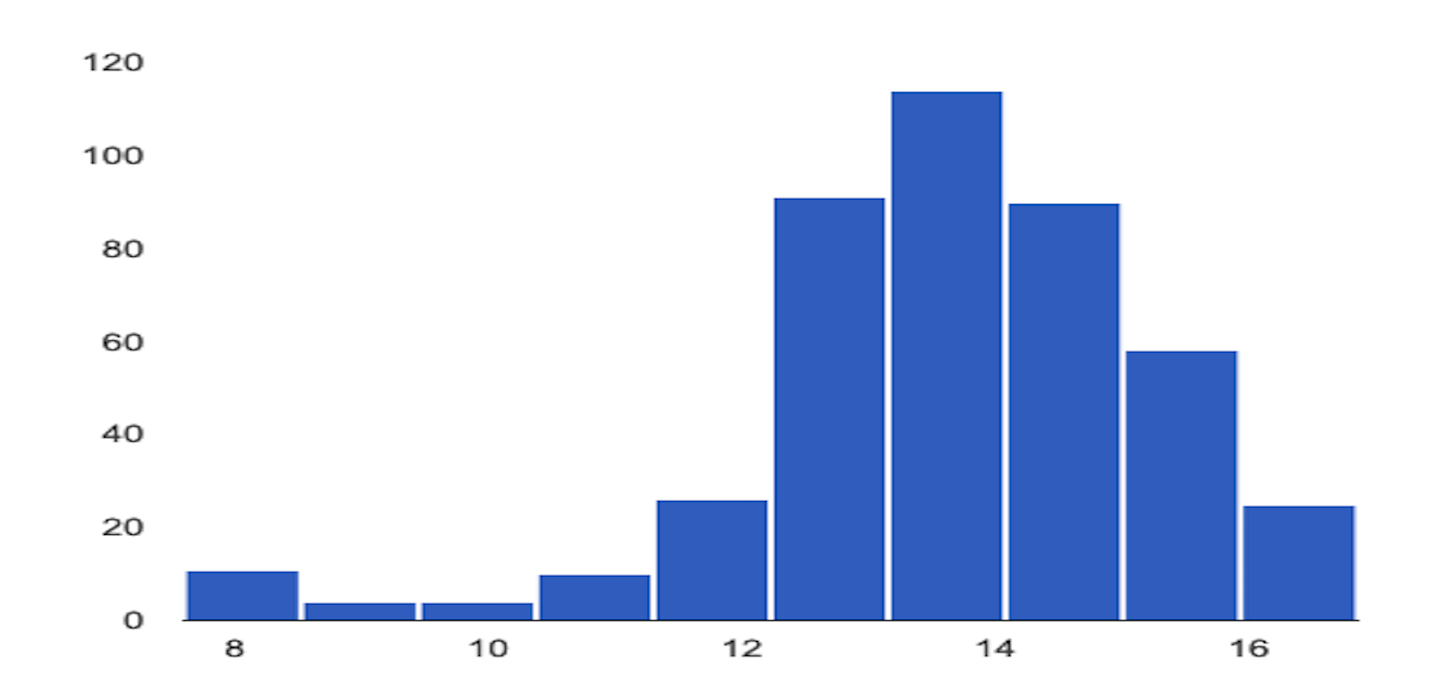
Per le caratteristiche numeriche, Model Monitoring divide l'intervallo di possibili valori delle caratteristiche in intervalli uguali e calcola il numero o la percentuale di valori delle caratteristiche che rientrano in ciascun intervallo.
La base di riferimento viene calcolata quando crei un job di Model Monitoring e viene ricalcolata solo se aggiorni il set di dati di addestramento per il job.
Calcola la distribuzione statistica degli ultimi valori delle caratteristiche rilevati in produzione.
Confronta la distribuzione degli ultimi valori delle caratteristiche in produzione con la distribuzione di riferimento calcolando un punteggio di distanza:
Per le caratteristiche categoriche, il punteggio di distanza viene calcolato utilizzando la distanza L-infinity.
Per le caratteristiche numeriche, il punteggio di distanza viene calcolato utilizzando la divergenza di Jensen-Shannon.
Se il punteggio della distanza tra due distribuzioni statistiche supera la soglia specificata, Model Monitoring identifica l'anomalia come disallineamento o deviazione.
L'esempio seguente mostra lo sfasamento o la deviazione tra la distribuzione di riferimento e quella più recente di una caratteristica categorica:
Distribuzione di riferimento

Ultima distribuzione

L'esempio seguente mostra l'asimmetria o la deviazione tra la distribuzione di riferimento e quella più recente di una caratteristica numerica:
Distribuzione di riferimento
Ultima distribuzione
Considerazioni sull'utilizzo di Model Monitoring
Per l'efficienza dei costi, puoi impostare una frequenza di campionamento delle richieste di inferenza per monitorare un sottoinsieme degli input di produzione di un modello.
Puoi impostare una frequenza con cui gli input registrati di recente di un modello di cui è stato eseguito il deployment vengono monitorati per verificare la presenza di disallineamenti o deviazioni. La frequenza di monitoraggio determina il periodo di tempo, o durata della finestra di monitoraggio, dei dati registrati che vengono analizzati in ogni esecuzione del monitoraggio.
Puoi specificare le soglie di avviso per ogni caratteristica che vuoi monitorare. Viene registrato un avviso quando la distanza statistica tra la distribuzione delle caratteristiche di input e la rispettiva base di riferimento supera la soglia specificata. Per impostazione predefinita, vengono monitorate tutte le caratteristiche categoriche e numeriche, con valori di soglia pari a 0,3.
Un endpoint di inferenza online può ospitare più modelli. Quando attivi il rilevamento dello skew o del drift su un endpoint, i seguenti parametri di configurazione vengono condivisi tra tutti i modelli ospitati in quell'endpoint:
- Tipo di rilevamento
- Frequenza di monitoraggio
- Frazione di richieste di input monitorate
Per gli altri parametri di configurazione, puoi impostare valori diversi per ogni modello.