

תרחישי היקש מותאמים אישית מאפשרים לכם ליצור קונטיינרים בהתאמה אישית עם קוד לעיבוד מקדים ולעיבוד לאחר, בלי להתעסק בפרטים של הגדרת שרת HTTP או של יצירת קונטיינר מאפס. אתם יכולים להשתמש בעיבוד מקדים כדי לנרמל ולשנות את הקלט או לבצע קריאות לשירותים חיצוניים כדי לקבל נתונים נוספים, ולהשתמש בעיבוד לאחר מכן כדי לעצב את ההסקה של המודל או להריץ לוגיקה עסקית.
בתרשים הבא מוצג תהליך העבודה של המשתמש עם תרחישי היקש מותאמים אישית ובלי תרחישי היקש מותאמים אישית.
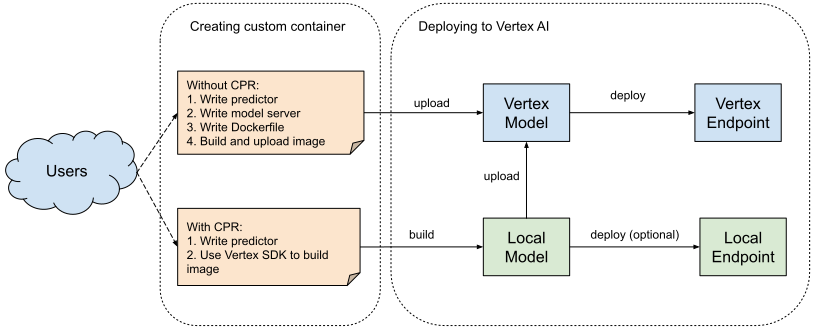
ההבדלים העיקריים הם:
לא צריך לכתוב שרת מודל או קובץ Docker. שרת המודל, שהוא שרת ה-HTTP שמארח את המודל, מסופק לכם.
אתם יכולים לפרוס את המודל ולנפות בו באגים באופן מקומי, וכך להאיץ את מחזור האיטרציה במהלך הפיתוח.
יצירה ופריסה של קונטיינר בהתאמה אישית
בקטע הזה מוסבר איך להשתמש ב-CPR כדי ליצור קונטיינר בהתאמה אישית עם לוגיקה של עיבוד מקדים ועיבוד לאחר, ולפרוס אותו גם בנקודת קצה מקומית וגם בנקודת קצה אונליין.
הגדרה
בסביבה שלכם צריכים להיות מותקנים Agent Platform SDK for Python ו-Docker.
כתיבת ממשק הסקה מותאם אישית ב-Predictor
מטמיעים את הממשק Predictor.
לדוגמה, ראו ההטמעה של Predictor ב-Sklearn.
כתיבת Handler בהתאמה אישית (אופציונלי)
ל-handlers בהתאמה אישית יש גישה לאובייקט הבקשה הגולמי, ולכן הם שימושיים במקרים נדירים שבהם צריך להתאים אישית לוגיקה שקשורה לשרת אינטרנט, כמו תמיכה בכותרות נוספות של בקשות ותגובות או ביטול סריאליזציה של בקשות הסקה שלא בפורמט JSON.
הנה דוגמה ל-notebook שמטמיע גם את Predictor וגם את Handler.
כדי לארגן את הקוד בצורה טובה יותר ולאפשר מינוף מחדש, מומלץ להטמיע את הלוגיקה של שרת האינטרנט ב-Handler ואת הלוגיקה של ML ב-Predictor, כמו שמוצג ב-Handler שמוגדר כברירת מחדל.
יצירת מאגר בהתאמה אישית
מכניסים לספרייה את הקוד בהתאמה אישית וקובץ requirements.txt נוסף, אם צריך להתקין חבילות כלשהן בתמונות.
כדי ליצור קונטיינרים בהתאמה אישית, משתמשים ב-Agent Platform SDK לפייתון באופן הבא:
from google.cloud.aiplatform.prediction import LocalModel

# {import your predictor and handler}

local_model = LocalModel.build_cpr_model(
    {PATH_TO_THE_SOURCE_DIR},
    f"{REGION}-docker.pkg.dev/{PROJECT_ID}/{REPOSITORY}/{IMAGE}",
    predictor={PREDICTOR_CLASS},
    handler={HANDLER_CLASS},
    requirements_path={PATH_TO_REQUIREMENTS_TXT},
)
אתם יכולים לבדוק את מפרט הקונטיינר כדי לקבל מידע שימושי כמו URI של קובץ האימג' ומשתני סביבה.
local_model.get_serving_container_spec()
הפעלת הקונטיינר באופן מקומי (אופציונלי)
השלב הזה נדרש רק אם רוצים להריץ ולבדוק את הקונטיינר באופן מקומי, כדי לקצר את זמן החזרה לפיתוח. בדוגמה הבאה, אתם פורסים לנקודת קצה מקומית ושולחים בקשת הסקה (פורמט של גוף הבקשה).
with local_model.deploy_to_local_endpoint(
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
    credential_path={PATH_TO_CREDENTIALS},
) as local_endpoint:
    health_check_response = local_endpoint.run_health_check()
    predict_response = local_endpoint.predict(
        request_file={PATH_TO_INPUT_FILE},
        headers={ANY_NEEDED_HEADERS},
    )
מדפיסים את התגובה של בדיקת התקינות וההסקה.
print(health_check_response, health_check_response.content)
print(predict_response, predict_response.content)
מדפיסים את כל יומני הקונטיינר.
local_endpoint.print_container_logs(show_all=True)
העלאה למרשם המודלים של Gemini Enterprise Agent Platform
המודל צריך לגשת לארטיפקטים של המודל (הקבצים מהאימון), אז חשוב לוודא שהעליתם אותם ל-Cloud Storage.
מעבירים את קובץ האימג' ל-Artifact Registry.
local_model.push_image()
לאחר מכן, מעלים את המודל למרשם המודלים.
from google.cloud import aiplatform

model = aiplatform.Model.upload(
    local_model=local_model,
    display_name={MODEL_DISPLAY_NAME},
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
)
אחרי שמעלים את המודל ל-מרשם המודלים, אפשר להשתמש בו כדי לקבל הסקות באצווה או לפרוס אותו בנקודת קצה של Agent Platform כדי לקבל הסקות אונליין.
פריסה לנקודת קצה ב-Agent Platform
endpoint = model.deploy(machine_type="n1-standard-4")
אחרי פריסת המודל, אפשר לקבל הסקות אונליין.
דוגמאות ל-Notebook
הדוגמאות ממחישות את הדרכים השונות שבהן אפשר לפרוס מודל עם עיבוד מראש ועיבוד לאחר מכן בהתאמה אישית באמצעות Vertex AI Inference.
- חיזוי בהתאמה אישית עם עיבוד מראש ועיבוד סופי בהתאמה אישית ל-Sklearn, בניית קונטיינר משלכם באמצעות Agent Platform SDK ל-Python.
- ב-Predictor, מטמיעים רק טעינה של שיטות עיבוד מקדים, עיבוד מקדים ועיבוד לאחר עיבוד בסדרה. התנהגות ברירת המחדל של טעינת המודל והחיזוי עוברת בירושה מ-
SklearnPredictorשמופץ על ידי Agent Platform.
- ב-Predictor, מטמיעים רק טעינה של שיטות עיבוד מקדים, עיבוד מקדים ועיבוד לאחר עיבוד בסדרה. התנהגות ברירת המחדל של טעינת המודל והחיזוי עוברת בירושה מ-
- Custom Predictor, build your own container with Agent Platform SDK for Python.
- הטמעה בהתאמה אישית של כל ה-Predictor.
- Custom Predictor and Handler, build your own container with Agent Platform SDK for Python.
- הטמעה בהתאמה אישית של Predictor ו-Handler.
- התאמה אישית של ה-handler מאפשרת לשרת המודל לטפל בקלט של קובצי CSV.
- Custom Predictor, build your own container with Agent Platform SDK for Python and PyTorch.
- הטמעה בהתאמה אישית של Predictor.
- תמונה קיימת, הסקת מסקנות לבדיקה באופן מקומי ופריסת מודלים באמצעות Agent Platform SDK ל-Python.
- שימוש בשרת הסקת המסקנות של NVIDIA Triton למודלים של PyTorch.