

自訂推論程序可讓您使用預先處理和後置處理程式碼建構自訂容器,不必處理設定 HTTP 伺服器或從頭建構容器的細節。您可以使用預先處理功能,將輸入內容正規化及轉換,或呼叫外部服務來取得額外資料,並使用後置處理功能,設定模型推論格式或執行商業邏輯。
下圖說明有無自訂推論程序的使用者工作流程。
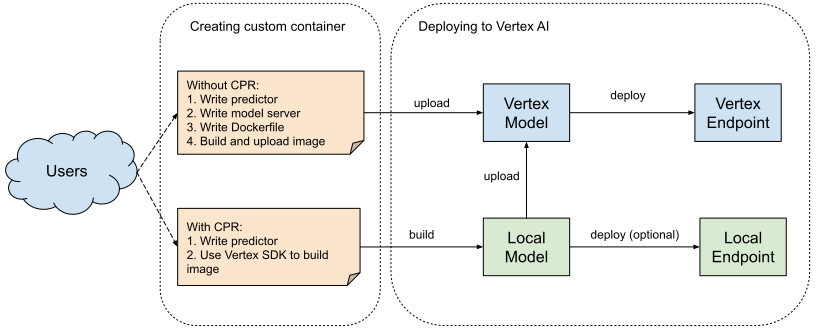
主要差異如下:
您不需要編寫模型伺服器或 Dockerfile。模型伺服器是託管模型的 HTTP 伺服器,由系統提供。
您可以在本機部署及偵錯模型,加快開發期間的疊代週期。
建構及部署自訂容器
本節說明如何使用 CPR 建構具備預先處理和後置處理邏輯的自訂容器,並部署至本機和線上端點。
設定
環境中必須安裝 Agent Platform SDK for Python 和 Docker。
編寫自訂 Predictor 推論介面
實作 Predictor 介面。
例如,請參閱 Sklearn 的 Predictor 實作。
撰寫自訂Handler (選用)
自訂處理常式可存取原始要求物件,因此在極少數情況下,如果您需要自訂網路伺服器相關邏輯,例如支援其他要求和回應標頭,或反序列化非 JSON 格式的推論要求,這項功能就非常實用。
以下是實作預測器和處理器的筆記本範例。
雖然這並非必要,但為了提升程式碼組織和重複使用性,建議您在處理常式中實作網路伺服器邏輯,並在預測器中實作機器學習邏輯,如預設處理常式所示。
建構自訂容器
如需在映像檔中安裝任何套件,請將自訂程式碼和額外的 requirements.txt 檔案放入目錄。
使用 Agent Platform SDK for Python 建構自訂容器,步驟如下:
from google.cloud.aiplatform.prediction import LocalModel

# {import your predictor and handler}

local_model = LocalModel.build_cpr_model(
    {PATH_TO_THE_SOURCE_DIR},
    f"{REGION}-docker.pkg.dev/{PROJECT_ID}/{REPOSITORY}/{IMAGE}",
    predictor={PREDICTOR_CLASS},
    handler={HANDLER_CLASS},
    requirements_path={PATH_TO_REQUIREMENTS_TXT},
)
您可以檢查容器規格,取得映像檔 URI 和環境變數等實用資訊。
local_model.get_serving_container_spec()
在本機執行容器 (選用)
只有在您想在本機執行及測試容器時,才需要執行這個步驟,這有助於加快疊代速度。在以下範例中,您會部署至本機端點,並傳送推論要求 (要求主體格式)。
with local_model.deploy_to_local_endpoint(
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
    credential_path={PATH_TO_CREDENTIALS},
) as local_endpoint:
    health_check_response = local_endpoint.run_health_check()
    predict_response = local_endpoint.predict(
        request_file={PATH_TO_INPUT_FILE},
        headers={ANY_NEEDED_HEADERS},
    )
列印健康狀態檢查和推論回應。
print(health_check_response, health_check_response.content)
print(predict_response, predict_response.content)
列印所有容器記錄。
local_endpoint.print_container_logs(show_all=True)
上傳至 Gemini Enterprise Agent Platform Model Registry
模型需要存取模型構件 (訓練檔案),因此請務必將這些檔案上傳至 Cloud Storage。
將映像檔推送至 Artifact Registry。
local_model.push_image()
然後上傳至 Model Registry。
from google.cloud import aiplatform

model = aiplatform.Model.upload(
    local_model=local_model,
    display_name={MODEL_DISPLAY_NAME},
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
)
模型上傳至 Model Registry 後,可用於取得批次推論,或部署至 Agent Platform 端點,取得線上推論。
部署至 Agent Platform 端點
endpoint = model.deploy(machine_type="n1-standard-4")
模型部署後,您就可以取得線上推論。
Notebook 範例
這些範例展示了如何使用 Vertex AI Inference,以自訂預先處理和後處理方式部署模型。
- Sklearn 的自訂預測器,可自訂預先/後續處理作業,使用 Agent Platform SDK for Python 建構自己的容器。
- 在 Predictor 中,僅實作序列化預處理器、預處理和後處理方法的載入作業。從 Agent Platform 分散式
SklearnPredictor繼承預設模型載入和預測行為。
- 在 Predictor 中,僅實作序列化預處理器、預處理和後處理方法的載入作業。從 Agent Platform 分散式
- 自訂預測器:使用 Agent Platform SDK for Python 建構自己的容器。
- 自訂整個預測器的實作。
- 自訂預測器和處理常式,使用 Agent Platform SDK for Python 建構自己的容器。
- 自訂預測器和處理常式的實作。
- 自訂處理常式後,模型伺服器就能處理 CSV 輸入內容。
- 自訂預測器:使用 Agent Platform SDK for Python 和 PyTorch 建構自己的容器。
- 預測器的自訂實作。
- 現有映像檔、在本機測試推論,以及使用 Agent Platform SDK for Python 部署模型。
- 使用 NVIDIA Triton 推論伺服器,執行 PyTorch 模型。