

Con Agent Platform Neural Architecture Search, puoi cercare architetture neurali ottimali in termini di accuratezza, latenza, memoria, una combinazione di questi o una metrica personalizzata.
Determinare se Agent Platform Neural Architecture Search è lo strumento migliore per me
- Agent Platform Neural Architecture Search è uno strumento di ottimizzazione di fascia alta utilizzato per trovare le migliori architetture neurali in termini di accuratezza con o senza vincoli come latenza, memoria o una metrica personalizzata. Lo spazio di ricerca delle possibili scelte di architettura neurale può raggiungere 10^20. Si basa su una tecnica che negli ultimi anni ha generato con successo diversi modelli di computer vision all'avanguardia, tra cui Nasnet, MNasnet, EfficientNet, NAS-FPN e SpineNet.
- Agent Platform Neural Architecture Search non è una soluzione in cui puoi semplicemente inserire i tuoi dati e aspettarti un buon risultato senza sperimentare. È uno strumento di sperimentazione.
- Agent Platform Neural Architecture Search non è per l'ottimizzazione degli iperparametri, ad esempio per l'ottimizzazione del tasso di apprendimento o delle impostazioni dell'ottimizzatore. È destinato solo a una ricerca di architettura. Non devi combinare la regolazione degli iperparametri con Agent Platform Neural Architecture Search.
- Agent Platform Neural Architecture Search non è consigliato con dati di addestramento limitati o per set di dati molto sbilanciati in cui alcune classi sono molto rare. Se utilizzi già aumenti pesanti per l'addestramento di base a causa della mancanza di dati, Neural Architecture Search di Agent Platform non è consigliata.
- Ti consigliamo di provare prima altri metodi e tecniche di machine learning tradizionali e convenzionali, come la regolazione degli iperparametri. Ti consigliamo di utilizzare la ricerca di architetture neurali di Agent Platform solo se non noti ulteriori miglioramenti con questi metodi tradizionali.
- Dovresti avere un team interno per la messa a punto del modello, che abbia un'idea di base sui parametri dell'architettura da modificare e provare. Questi parametri possono includere le dimensioni del kernel, il numero di canali o le connessioni tra molte altre possibilità. Se hai in mente uno spazio di ricerca da esplorare, Agent Platform Neural Architecture Search è molto utile e può ridurre di almeno sei mesi il tempo di ingegneria necessario per esplorare un ampio spazio di ricerca: fino a 10^20 scelte di architettura.
- Agent Platform Neural Architecture Search è destinato ai clienti aziendali che possono spendere diverse migliaia di dollari per un esperimento.
- La ricerca di architetture neurali di Agent Platform non è limitata al solo caso d'uso della visione. Al momento vengono forniti solo spazi di ricerca predefiniti e addestratori predefiniti basati sulla visione, ma i clienti possono portare anche i propri spazi di ricerca e addestratori non basati sulla visione.
- Agent Platform Neural Architecture Search non utilizza un approccio supernet (NAS basato su oneshot o sulla condivisione dei pesi) in cui è sufficiente portare i propri dati e utilizzarli come soluzione. La personalizzazione di una supernet non è banale (richiede mesi di lavoro). A differenza di una supernet, Agent Platform Neural Architecture Search è altamente personalizzabile per definire spazi di ricerca e premi personalizzati. La personalizzazione può essere eseguita in circa uno o due giorni.
- Agent Platform Neural Architecture Search è supportato in 8 regioni in tutto il mondo. Controlla la disponibilità nella tua regione.
Prima di utilizzare Agent Platform Neural Architecture Search, devi anche leggere la sezione seguente sui costi previsti, sui miglioramenti dei risultati e sui requisiti di quota GPU.
Costo previsto, miglioramenti dei risultati e requisiti di quota GPU

La figura mostra una tipica curva di ricerca di architetture neurali di Agent Platform Neural Architecture Search.
Y-axis mostra i premi della prova, mentre
X-axis indica il numero di prove avviate.
Man mano che il numero di prove aumenta, il controller inizia a trovare modelli migliori. Pertanto, la ricompensa inizia ad aumentare e, in seguito, la
varianza e la crescita della ricompensa iniziano a diminuire
e mostrano la convergenza. Nel punto di convergenza, il numero di prove
può variare in base alle dimensioni dello spazio di ricerca, ma è dell'ordine di
circa 2000 prove.
Ogni prova è progettata per essere una versione più piccola dell'addestramento completo chiamato proxy-task, che viene eseguito per circa 1-2 ore su due GPU Nvidia V100. Il cliente
può interrompere la ricerca manualmente in qualsiasi momento e potrebbe trovare modelli di ricompensa
più elevati rispetto al suo valore di riferimento
prima che si verifichi il punto di convergenza.
Potrebbe essere meglio attendere il punto di convergenza
per scegliere i risultati migliori.
Dopo la ricerca, la fase successiva consiste nello scegliere
i 10 migliori tentativi (modelli) ed eseguire un addestramento completo.
(Facoltativo) Prova lo spazio di ricerca e l'addestratore MNasNet predefiniti
In questa modalità, osserva la curva di ricerca o alcuni tentativi, circa 25, ed esegui un test drive con uno spazio di ricerca e un addestramento MNasNet predefiniti.

Nella figura, la migliore ricompensa di livello 1 inizia a salire da circa 0,30 alla prova 1 a circa 0,37 alla prova 17. La tua corsa esatta potrebbe apparire leggermente diversa a causa della casualità del campionamento, ma dovresti notare un piccolo aumento della migliore ricompensa. Tieni presente che si tratta ancora di un test e non rappresenta alcuna proof of concept o una convalida pubblica del benchmark.
Il costo di questa esecuzione è dettagliato come segue:
- Fase 1:
- Numero di prove: 25
- Numero di GPU per prova: 2
- Tipo di GPU: TESLA_T4
- Numero di CPU per prova: 1
- Tipo di CPU: n1-highmem-16
- Tempo medio di addestramento per una singola prova: 3 ore
- Numero di prove parallele: 6
- Quota GPU utilizzata: (num-gpus-per-trial * num-parallel-trials) = 12 GPU. Utilizza la regione us-central1 per il test drive e ospita i dati di addestramento nella stessa regione. Nessuna quota aggiuntiva necessaria.
- Tempo di esecuzione: (total-trials * training-time-per-trial)/(num-parallel-trials) = 12 ore
- Ore GPU: (totale-prove * tempo-addestramento-per-prova * num-gpu-per-prova) = 150 ore GPU T4
- Ore CPU: (total-trials * training-time-per-trial * num-cpus-per-trial) = 75 ore n1-highmem-16
- Costo: circa 185 $. Puoi interrompere il job prima per ridurre i costi. Per calcolare il prezzo esatto, consulta la pagina dei prezzi.
Poiché si tratta di un'esecuzione di prova, non è necessario eseguire un addestramento completo di fase 2 per i modelli della fase 1. Per scoprire di più sull'esecuzione della fase 2, consulta il tutorial 3.
Per questa esecuzione viene utilizzato il notebook MnasNet.
(Facoltativo) Esecuzione della proof of concept (POC) dello spazio di ricerca e dell'addestratore MNasNet predefiniti
Se ti interessa replicare quasi completamente un risultato MNasnet pubblicato, puoi utilizzare questa modalità. Secondo l'articolo, MnasNet raggiunge una precisione top-1 del 75,2% con una latenza di 78 ms su uno smartphone Pixel, ovvero 1,8 volte più veloce di MobileNetV2 con una precisione superiore dello 0,5% e 2,3 volte più veloce di NASNet con una precisione superiore dell'1,2%. Tuttavia, questo esempio utilizza GPU anziché TPU per l'addestramento e utilizza la CPU cloud (n1-highmem-8) per valutare la latenza. Con questo esempio, l'accuratezza top-1 di Stage2 prevista su MNasNet è del 75,2% con una latenza di 50 ms sulla CPU cloud (n1-highmem-8).
Il costo di questa esecuzione è dettagliato come segue:
Ricerca di primo livello:
- Numero di prove: 2000
- Numero di GPU per prova: 2
- Tipo di GPU: TESLA_T4
- Tempo medio di addestramento per una singola prova: 3 ore
- Numero di prove parallele: 10
- Quota GPU utilizzata: (num-gpus-per-trial * num-parallel-trials) = 20 GPU T4. Poiché questo numero è superiore alla quota predefinita, crea una richiesta di quota dalla UI del progetto. Per saperne di più, consulta la sezione setting_up_path.
- Tempo di esecuzione: (total-trials * training-time-per-trial)/(num-parallel-trials)/24 = 25 giorni. Nota: il job termina dopo 14 giorni. Trascorso questo periodo, puoi riprendere la ricerca di lavoro facilmente con un solo comando per altri 14 giorni. Se hai una quota GPU più elevata, il runtime diminuisce proporzionalmente.
- Ore GPU: (totale-prove * tempo-addestramento-per-prova * num-gpu-per-prova) = 12.000 ore GPU T4.
- Costo: circa 15.000 $
Addestramento completo di fase 2 con i primi 10 modelli:
- Numero di prove: 10
- Numero di GPU per prova: 4
- Tipo di GPU: TESLA_T4
- Tempo medio di addestramento di una singola prova: circa 9 giorni
- Numero di prove parallele: 10
- Quota GPU utilizzata: (num-gpus-per-trial * num-parallel-trials) = 40 GPU T4. Poiché questo numero è superiore alla quota predefinita, crea una richiesta di quota dalla UI del progetto. Per saperne di più, consulta la sezione setting_up_path. Puoi anche eseguire questa operazione con 20 GPU T4 eseguendo il job due volte con cinque modelli alla volta anziché tutti e 10 in parallelo.
- Tempo di esecuzione: (total-trials * training-time-per-trial)/(num-parallel-trials)/24 = ~9 giorni
- Ore GPU: (totale-prove * tempo-addestramento-per-prova * num-gpu-per-prova) = 8960 ore GPU T4.
- Costo: circa 8000 $
Costo totale: circa 23.000 $. Per calcolare il prezzo esatto, consulta la pagina dei prezzi. Nota: questo esempio non è un normale job di addestramento medio. L'addestramento completo dura circa nove giorni su quattro GPU TESLA_T4.
Per questa esecuzione viene utilizzato il notebook MnasNet.
Utilizzare lo spazio di ricerca e gli addestratori
Forniamo un costo approssimativo per un utente personalizzato medio. Le tue esigenze possono variare a seconda dell'attività di addestramento e delle GPU e delle CPU utilizzate. Per un'esecuzione end-to-end, è necessaria una quota di almeno 20 GPU come documentato qui. Nota: l'aumento del rendimento dipende completamente dall'attività. Possiamo fornire solo esempi come MNasnet come esempi di riferimento per l'aumento del rendimento.
Il costo di questa esecuzione personalizzata ipotetica è dettagliato come segue:
Ricerca di primo livello:
- Numero di prove: 2000
- Numero di GPU per prova: 2
- Tipo di GPU: TESLA_T4
- Tempo medio di addestramento di una singola prova: 1,5 ore
- Numero di prove parallele: 10
- Quota GPU utilizzata: (num-gpus-per-trial * num-parallel-trials) = 20 GPU T4. Poiché questo numero è superiore alla quota predefinita, devi creare una richiesta di quota dall'interfaccia utente del progetto. Per ulteriori informazioni, vedi Richiedere una quota di dispositivi aggiuntiva per il progetto.
- Tempo di esecuzione: (total-trials * training-time-per-trial)/(num-parallel-trials)/24 = 12,5 giorni
- Ore GPU: (totale-prove * tempo-addestramento-per-prova * num-gpu-per-prova) = 6000 ore GPU T4.
- Costo: circa 7400 $
Addestramento completo della fase 2 con i primi 10 modelli:
- Numero di prove: 10
- Numero di GPU per prova: 2
- Tipo di GPU: TESLA_T4
- Tempo medio di addestramento di una singola prova: circa 4 giorni
- Numero di prove parallele: 10
- Quota GPU utilizzata: (num-gpus-per-trial * num-parallel-trials) = 20 GPU T4. **Poiché questo numero è superiore alla quota predefinita, devi creare una richiesta di quota dall'interfaccia utente del progetto. Per saperne di più, consulta Richiedere una quota di dispositivi aggiuntiva per il progetto. Consulta la stessa documentazione per le esigenze di quota personalizzata.
- Tempo di esecuzione: (total-trials * training-time-per-trial)/(num-parallel-trials)/24 = circa 4 giorni
- Ore GPU: (total-trials * training-time-per-trial * num-gpus-per-trial) = 1920 ore GPU T4.
- Costo: circa 2400 $
Per ulteriori informazioni sul costo della progettazione delle attività proxy, consulta Progettazione delle attività proxy. Il costo è simile all'addestramento di 12 modelli (la fase 2 della figura utilizza 10 modelli):
- Quota di GPU utilizzata: uguale all'esecuzione della fase 2 nella figura.
- Costo: (12/10) * stage-2-cost-for-10-models = ~$2,880
Costo totale: circa 12.680 $. Per calcolare il prezzo esatto, consulta la pagina dei prezzi.
Riepilogo di prestazioni e costi
La tabella seguente riepiloga alcuni punti dati con diversi casi d'uso e rendimento e costi associati.
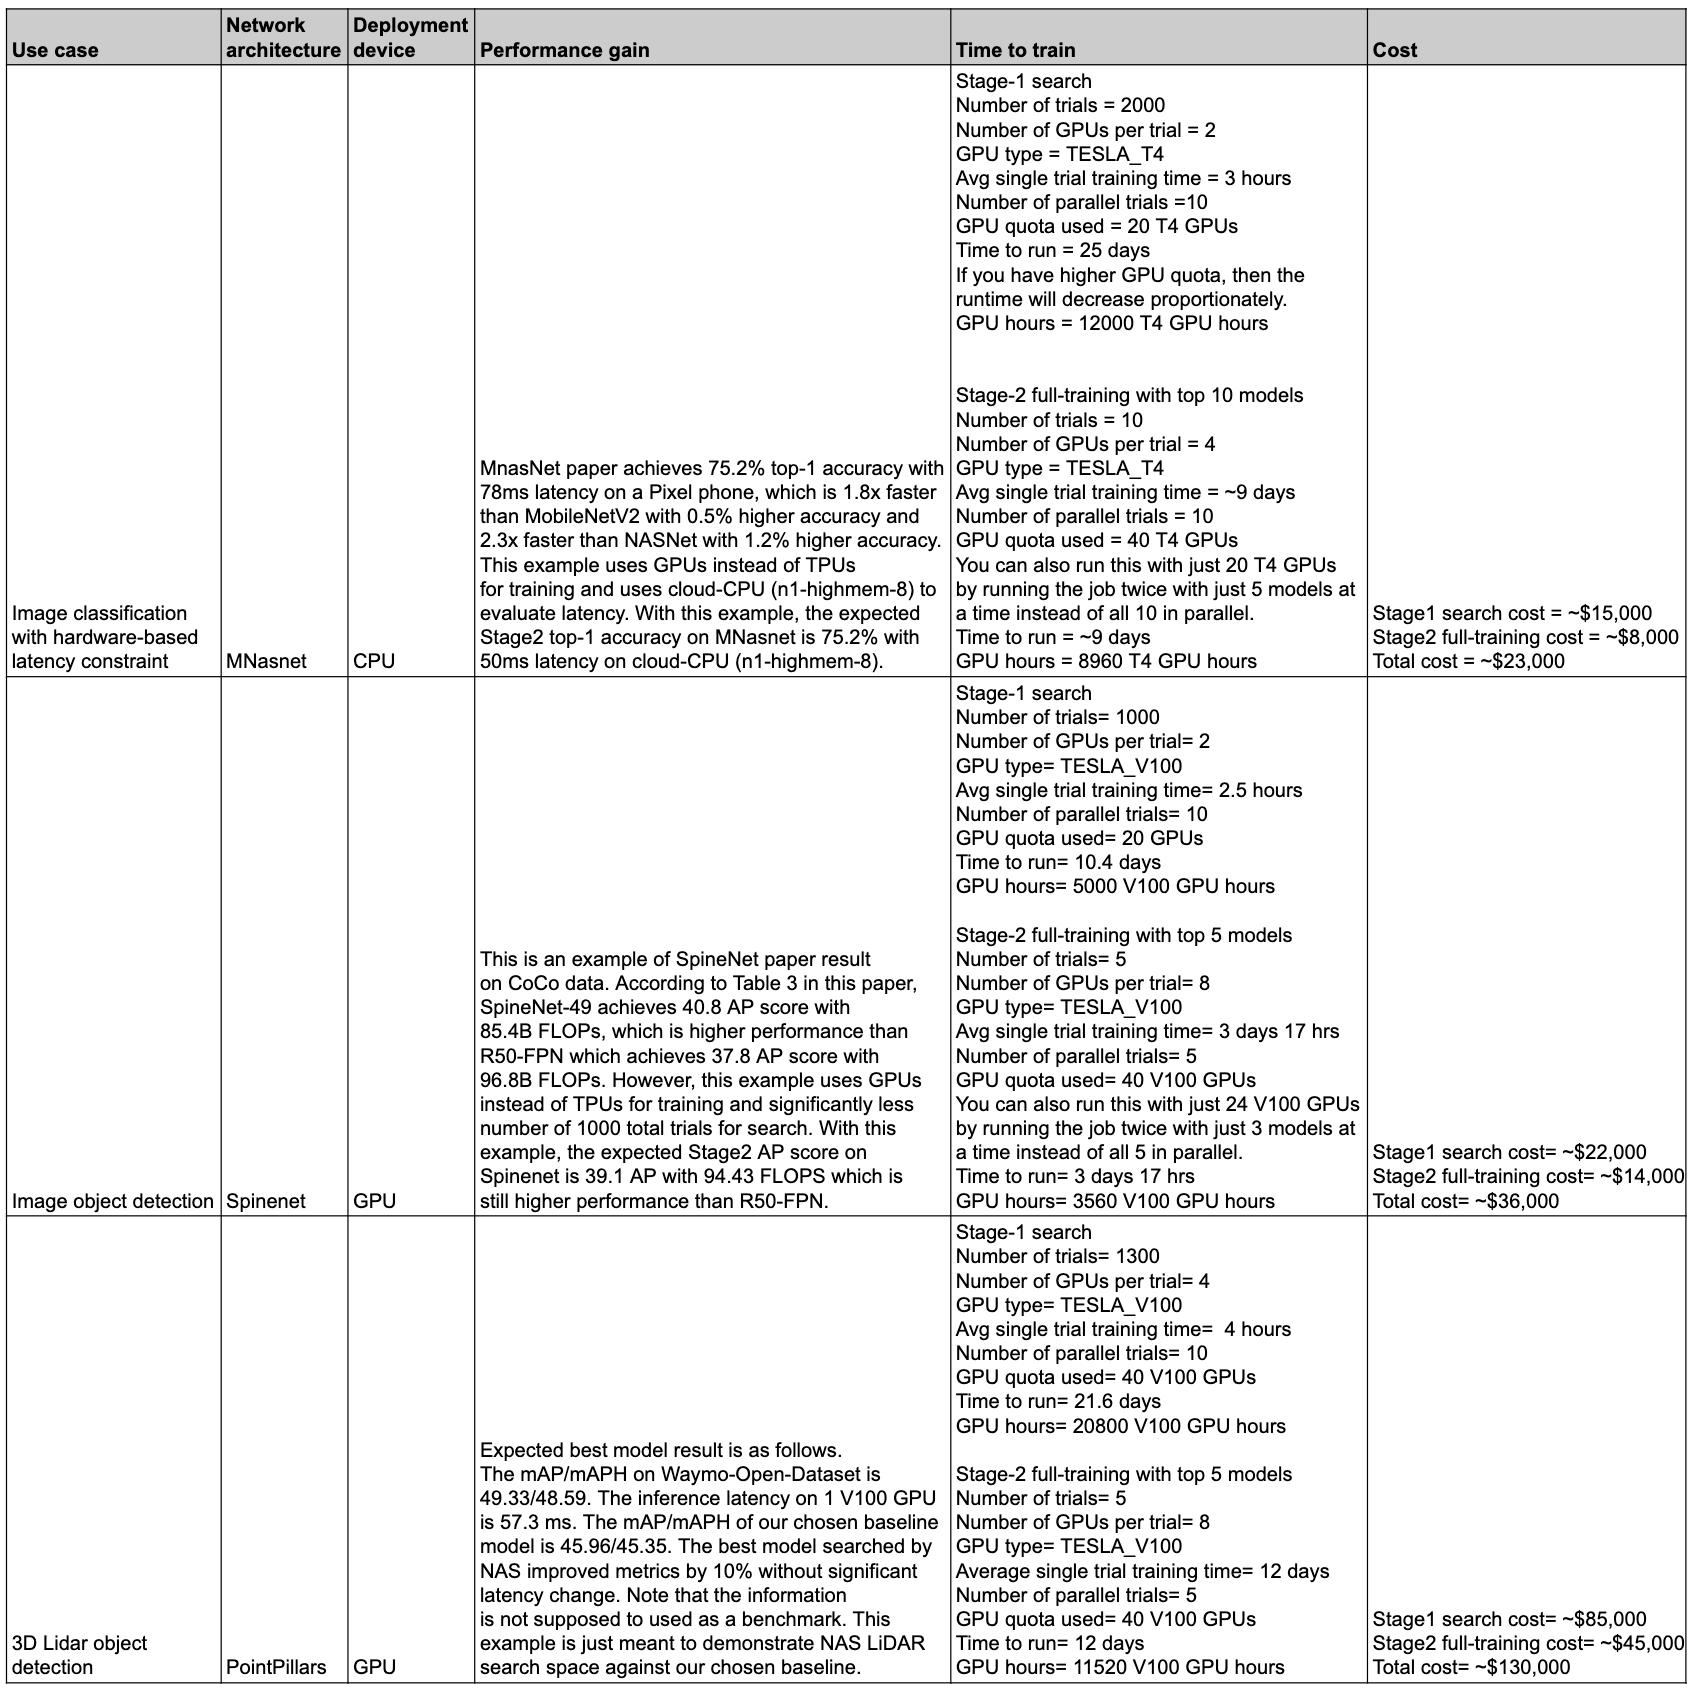
Casi d'uso e funzionalità
Le funzionalità di Agent Platform Neural Architecture Search Neural Architecture Search sono flessibili e facili da usare. Un utente principiante può utilizzare spazi di ricerca predefiniti, addestramento predefinito e blocchi note senza ulteriori configurazioni per iniziare a esplorare Agent Platform Neural Architecture Search per il proprio set di dati. Allo stesso tempo, un utente esperto può utilizzare Agent Platform Neural Architecture Search con il proprio trainer personalizzato, lo spazio di ricerca personalizzato e il dispositivo di inferenza personalizzato e persino estendere la ricerca di architetture anche a casi d'uso non di visione.
Agent Platform Neural Architecture Search offre addestratori e spazi di ricerca predefiniti da eseguire sulle GPU per i seguenti casi d'uso:
- Addestratori TensorFlow con risultati basati su set di dati pubblici pubblicati in un notebook
- Rilevamento di oggetti immagine con spazi di ricerca end-to-end (SpineNet)
- Classificazione con spazi di ricerca backbone predefiniti (MnasNet)
- Rilevamento di oggetti con nuvole di punti 3D LiDAR con spazi di ricerca end-to-end predefiniti
- Ricerca con vincoli di memoria e latenza per i dispositivi di targeting
- Addestratori PyTorch da utilizzare solo come esempio di tutorial
- Esempio di spazio di ricerca per la segmentazione di immagini mediche 3D PyTorch
- Classificazione MNasNet basata su PyTorch
- Ricerca con vincoli di memoria e latenza per i dispositivi di targeting
- Spazi di ricerca predefiniti all'avanguardia basati su TensorFlow aggiuntivi con codice
- Scalabilità del modello
- Aumento dei dati
L'intero set di funzionalità offerte da Agent Platform Neural Architecture Search può essere utilizzato facilmente anche per architetture e casi d'uso personalizzati:
- Un linguaggio di ricerca di architetture neurali di Agent Platform Neural Architecture Search per definire uno spazio di ricerca personalizzato sulle possibili architetture neurali e integrare questo spazio di ricerca con il codice di addestramento personalizzato.
- Spazi di ricerca predefiniti allo stato dell'arte pronti all'uso con codice.
- Trainer predefinito pronto all'uso, con codice, che viene eseguito sulla GPU.
- Un servizio gestito per la ricerca di architetture, tra cui
- Un controller di ricerca di architetture neurali di Agent Platform Neural Architecture Search che campiona lo spazio di ricerca per trovare l'architettura migliore.
- Docker/librerie precompilati, con codice, per calcolare la latenza/FLOP/memoria su hardware personalizzato.
- Tutorial per insegnare l'utilizzo del NAS.
- Un insieme di strumenti per progettare attività proxy.
- Indicazioni ed esempio per un addestramento PyTorch efficiente con Agent Platform Neural Architecture Search.
- Supporto della libreria per il reporting e l'analisi delle metriche personalizzate.
- Cloud de Confiance Interfaccia utente della console per monitorare e gestire i job.
- Notebook facili da usare per avviare la ricerca.
- Supporto della libreria per la gestione dell'utilizzo delle risorse GPU/CPU a livello di progetto o di granularità per job.
- Nas-client basato su Python per creare Docker, avviare job NAS e riprendere un job di ricerca precedente.
- Cloud de Confiance by S3NS assistenza clienti basata sulla UI della console.
Sfondo
Agent Platform Neural Architecture Search Neural Architecture Search è una tecnica per automatizzare la progettazione di reti neurali. Negli anni scorsi ha generato diversi modelli di computer vision all'avanguardia, tra cui:
Questi modelli risultanti sono all'avanguardia in tutte e tre le classi chiave di problemi di visione artificiale: classificazione delle immagini, rilevamento degli oggetti e segmentazione.
Con Agent Platform Neural Architecture Search, gli ingegneri possono ottimizzare i modelli per accuratezza, latenza e memoria nella stessa prova, riducendo il tempo necessario per il deployment dei modelli. Agent Platform Neural Architecture Search esplora molti tipi diversi di modelli: il controller propone modelli ML, poi li addestra e li valuta e ripete l'operazione più di 1000 volte per trovare le soluzioni migliori con vincoli di latenza e/o memoria sui dispositivi di targeting. La figura seguente mostra i componenti chiave del framework di ricerca dell'architettura:
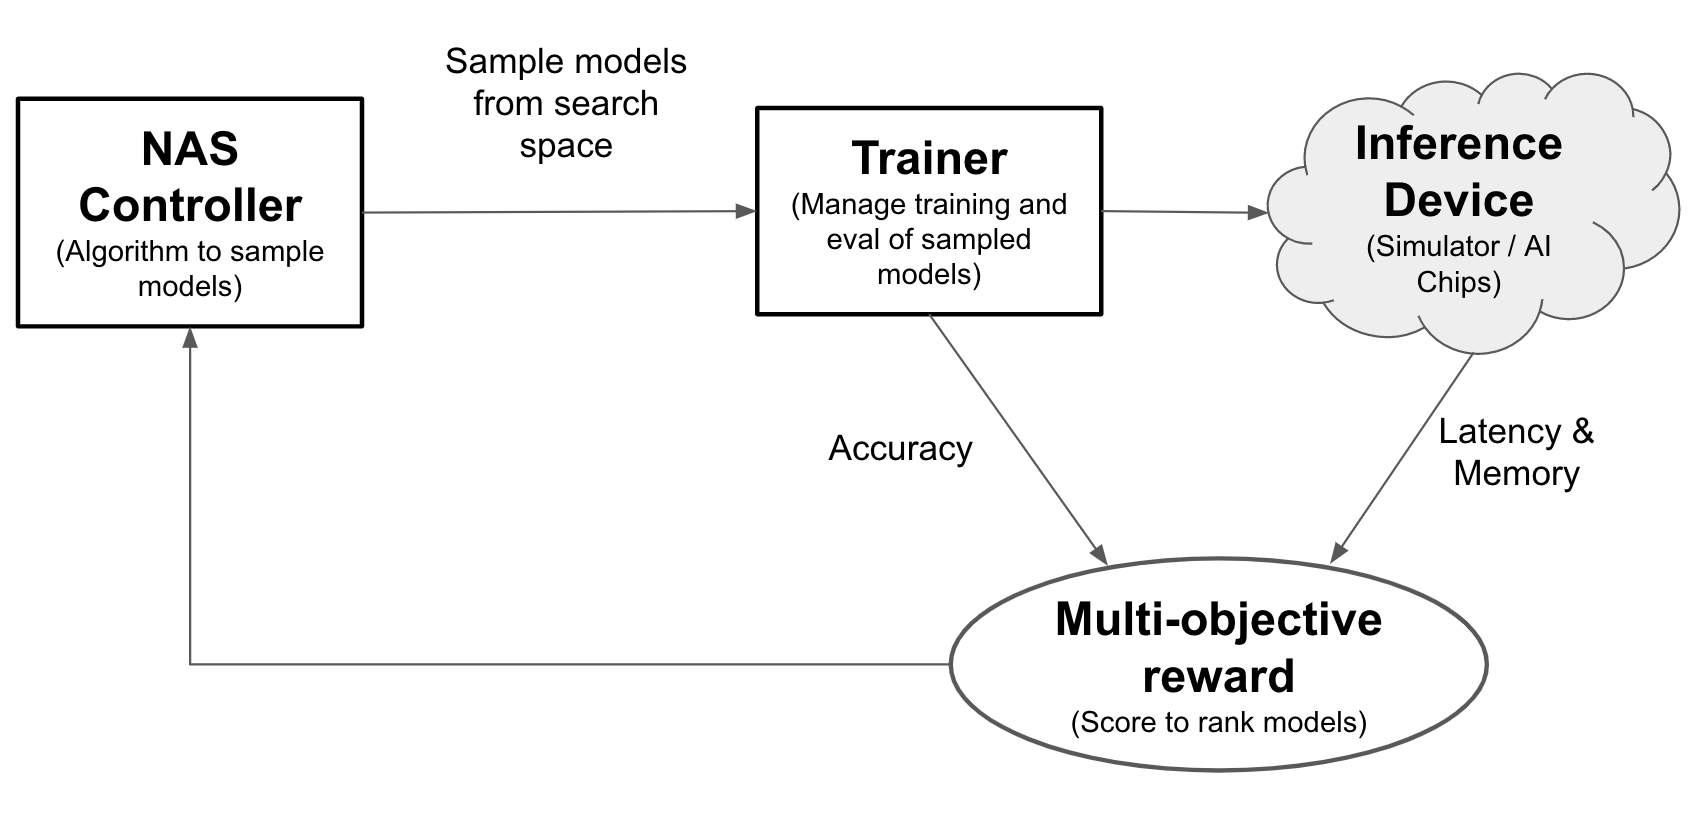
- Modello: un'architettura neurale con operazioni e connessioni.
- Spazio di ricerca: lo spazio dei possibili modelli (operazioni e connessioni) che possono essere progettati e ottimizzati.
- Docker di addestramento: codice di addestramento personalizzabile dall'utente per addestrare e valutare un modello e calcolare la sua accuratezza.
- Dispositivo di inferenza: un dispositivo hardware come CPU/GPU su cui vengono calcolati la latenza e la memoria utilizzata del modello.
- Ricompensa: una combinazione di metriche del modello come accuratezza, latenza e memoria utilizzate per classificare i modelli come migliori o peggiori.
- Agent Platform Neural Architecture Search Neural Architecture Search Controller: l'algoritmo di orchestrazione che (a) campiona i modelli dallo spazio di ricerca, (b) riceve i premi del modello e (c) fornisce il successivo set di suggerimenti sui modelli da valutare per trovare i modelli più ottimali.
Attività di configurazione utente
Agent Platform Neural Architecture Search offre un addestratore predefinito integrato con spazi di ricerca predefiniti che possono essere utilizzati con i notebook forniti senza ulteriori configurazioni.
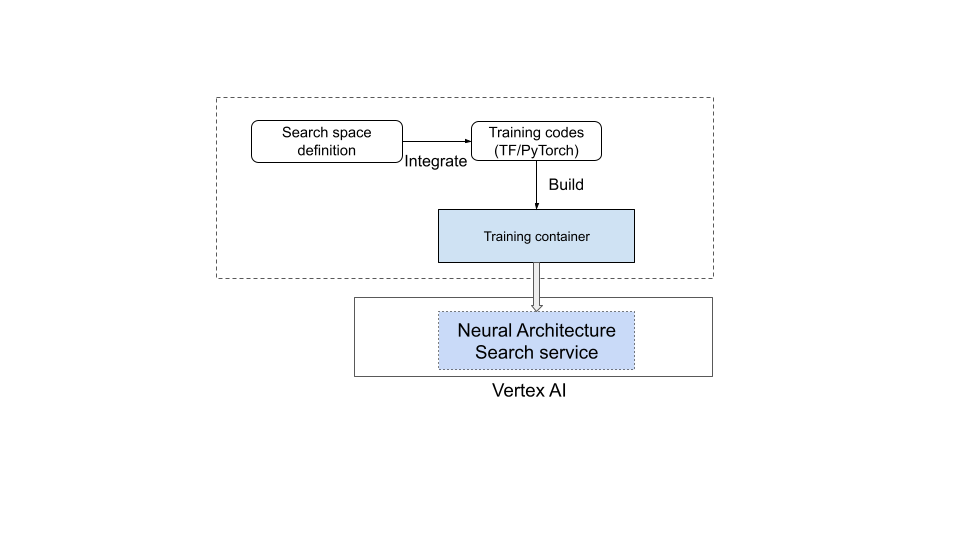
Tuttavia, la maggior parte degli utenti deve utilizzare l'addestramento personalizzato, gli spazi di ricerca personalizzati, le metriche personalizzate (memoria, latenza e tempo di addestramento, ad esempio) e la ricompensa personalizzata (combinazione di elementi come precisione e latenza). Per questo, devi:
- Definisci uno spazio di ricerca personalizzato utilizzando il linguaggio Neural Architecture Search di Agent Platform Neural Architecture Search fornito.
- Integra la definizione dello spazio di ricerca nel codice del trainer.
- Aggiungi i report sulle metriche personalizzate al codice del trainer.
- Aggiungi un premio personalizzato al codice dell'allenatore.
- Crea un contenitore di addestramento e utilizzalo per avviare i job di ricerca dell'architettura neurale di Agent Platform Neural Architecture Search.
Il seguente diagramma illustra questo concetto:
Servizio Agent Platform Neural Architecture Search in funzione
Dopo aver configurato il contenitore di addestramento da utilizzare, il servizio Neural Architecture Search di Agent Platform avvia più contenitori di addestramento in parallelo su più dispositivi GPU. Puoi controllare quante prove utilizzare in parallelo per l'addestramento e quante prove totali avviare. A ogni training-container viene fornita un'architettura suggerita dallo spazio di ricerca. Il contenitore di addestramento crea il modello suggerito, esegue l'addestramento/la valutazione e poi invia le ricompense al servizio Neural Architecture Search di Agent Platform. Man mano che questo processo procede, il servizio di ricerca di architetture neurali di Agent Platform Neural Architecture Search utilizza il feedback sulla ricompensa per trovare architetture di modelli sempre migliori. Dopo la ricerca, hai accesso alle metriche generate per ulteriori analisi.

Panoramica del percorso dell'utente per Agent Platform Neural Architecture Search
Di seguito sono riportati i passaggi di alto livello per eseguire un esperimento di ricerca dell'architettura neurale di Agent Platform Neural Architecture Search:
Configurazioni e definizioni:
- Identifica il set di dati etichettato e specifica il tipo di attività (ad esempio rilevamento o segmentazione).
- Personalizzare il codice allenatore:
- Utilizza uno spazio di ricerca predefinito o definisci uno spazio di ricerca personalizzato utilizzando il linguaggio di Neural Architecture Search di Agent Platform Neural Architecture Search.
- Integra la definizione dello spazio di ricerca nel codice del trainer.
- Aggiungi i report sulle metriche personalizzate al codice del trainer.
- Aggiungi un premio personalizzato al codice dell'allenatore.
- Crea un container di addestramento.
- Configura i parametri di prova della ricerca per l'addestramento parziale (attività proxy). L'addestramento
della ricerca dovrebbe idealmente terminare rapidamente (ad esempio, 30-60 minuti)
per addestrare parzialmente i modelli:
- Numero minimo di epoche necessarie affinché i modelli campionati raccolgano la ricompensa (il numero minimo di epoche non deve garantire la convergenza del modello).
- Iperparametri (ad esempio, il tasso di apprendimento).
Esegui la ricerca localmente per assicurarti che il contenitore integrato dello spazio di ricerca possa essere eseguito correttamente.
Avvia il job di Cloud de Confiance ricerca (fase 1) con cinque prove di test e verifica che le prove di ricerca soddisfino gli obiettivi di runtime e precisione.
Avvia il job di Cloud de Confiance ricerca (fase 1) con +1000 prove.
Nell'ambito della ricerca, imposta anche un intervallo regolare per l'addestramento (fase 2) dei primi N modelli:
- Iperparametri e algoritmo per la ricerca degli iperparametri. La fase 2 in genere utilizza una configurazione simile alla fase 1, ma con impostazioni più elevate per determinati parametri, come passaggi/epoche di addestramento e numero di canali.
- Criteri di interruzione (il numero di epoche).
Analizza le metriche segnalate e/o visualizza le architetture per ottenere insight.
Un esperimento di ricerca dell'architettura può essere seguito da un esperimento di ricerca di scalabilità, a sua volta seguito da un esperimento di ricerca di aumento.
Ordine di lettura della documentazione
- (Obbligatorio) Configura l'ambiente
- (Obbligatorio) Tutorial
- (Obbligatorio solo per i clienti PyTorch) Addestramento efficiente di PyTorch con dati cloud
- (Obbligatorio) Best practice e flusso di lavoro suggerito
- (Obbligatorio) Progettazione dell'attività proxy
- (Obbligatorio solo quando si utilizzano addestratori predefiniti) Come utilizzare spazi di ricerca predefiniti e un addestratore predefinito
Riferimenti
- Utilizzo del machine learning per esplorare l'architettura delle reti neurali
- MnasNet: Towards Automating the Design of Mobile Machine Learning Models
- EfficientNet: Improving Accuracy and Efficiency through AutoML and Model Scaling
- NAS-FPN: Learning Scalable Feature Pyramid Architecture for Object Detection
- SpineNet: Learning Scale-Permuted Backbone for Recognition and Localization
- RandAugment