

Questa guida mostra come eseguire un job di Agent Platform Neural Architecture Search utilizzando gli spazi di ricerca predefiniti e il codice di addestramento predefinito di Google basato su TF-vision per MnasNet e SpineNet. Per esempi end-to-end, consulta il notebook di classificazione MnasNet e il notebook di rilevamento di oggetti SpineNet.
Preparazione dei dati per l'addestratore predefinito
L'addestratore predefinito di Agent Platform Neural Architecture Search richiede che i dati siano in formato TFRecord, contenente tf.train.Examples. I tf.train.Examples devono includere i seguenti campi:
'image/encoded': tf.FixedLenFeature(tf.string)
'image/height': tf.FixedLenFeature(tf.int64)
'image/width': tf.FixedLenFeature(tf.int64)

# For image classification only.
'image/class/label': tf.FixedLenFeature(tf.int64)

# For object detection only.
'image/object/bbox/xmin': tf.VarLenFeature(tf.float32)
'image/object/bbox/xmax': tf.VarLenFeature(tf.float32)
'image/object/bbox/ymin': tf.VarLenFeature(tf.float32)
'image/object/bbox/ymax': tf.VarLenFeature(tf.float32)
'image/object/class/label': tf.VarLenFeature(tf.int64)
Puoi seguire le istruzioni per la preparazione dei dati ImageNet qui.
Per convertire i dati personalizzati, utilizza lo script di analisi incluso nel codice campione e nelle utilità che hai scaricato. Per personalizzare l'analisi dei dati, modifica i tf_vision/dataloaders/*_input.py file.
Scopri di più su
TFRecord e tf.train.Example.
Definisci le variabili di ambiente dell'esperimento
Prima di eseguire gli esperimenti, dovrai definire diverse variabili di ambiente, tra cui:
- TRAINER_DOCKER_ID:
${USER}_nas_experiment(formato consigliato) Percorsi Cloud Storage dei set di dati di addestramento e convalida che verranno utilizzati dall'esperimento. Ad esempio (CoCo per il rilevamento):
gs://cloud-samples-data/ai-platform/built-in/image/coco/train*gs://cloud-samples-data/ai-platform/built-in/image/coco/val*
Percorso Cloud Storage per l'output dell'esperimento. Formato consigliato:
gs://${USER}_nas_experiment
REGION: una regione che deve essere la stessa della regione del bucket di output dell'esperimento. Ad esempio:
us-central1.PARAM_OVERRIDE: un file YAML che esegue l'override dei parametri dell'addestratore predefinito. Agent Platform Neural Architecture Search fornisce alcune configurazioni predefinite che puoi utilizzare:
PROJECT_ID=PROJECT_ID
TRAINER_DOCKER_ID=TRAINER_DOCKER_ID
LATENCY_CALCULATOR_DOCKER_ID=LATENCY_CALCULATOR_DOCKER_ID
GCS_ROOT_DIR=OUTPUT_DIR
REGION=REGION
PARAM_OVERRIDE=tf_vision/configs/experiments/spinenet_search_gpu.yaml
TRAINING_DATA_PATH=gs://PATH_TO_TRAINING_DATA
VALIDATION_DATA_PATH=gs://PATH_TO_VALIDATION_DATA
Potresti voler selezionare o modificare il file di override che corrisponde ai tuoi requisiti di addestramento. Considera quanto segue:
- Puoi impostare
--accelerator_typeper scegliere tra GPU o CPU. Per eseguire solo alcune epoche per test rapidi utilizzando la CPU, puoi impostare il flag--accelerator_type=""e utilizzare il file di configurazionetf_vision/test_files/fast_nas_detection_spinenet_search_for_testing.yaml. - Numero di epoche
- Runtime di addestramento
- Iperparametri come il tasso di apprendimento
Per un elenco di tutti i parametri per controllare i job di addestramento, consulta tf_vision/configs/. Di seguito sono riportati i parametri chiave:
task:
  train_data:
    global_batch_size: 80
  validation_data:
    global_batch_size: 16
  init_checkpoint: null
trainer:
  train_steps: 16634
  steps_per_loop: 1386
  optimizer_config:
    learning_rate:
      cosine:
        initial_learning_rate: 0.16
        decay_steps: 16634
      type: 'cosine'
    warmup:
      type: 'linear'
      linear:
        warmup_learning_rate: 0.0067
        warmup_steps: 1386
Crea un bucket Cloud Storage per Agent Platform Neural Architecture Search per archiviare gli output dei job (ad es. checkpoint):
gcloud storage buckets create $GCS_ROOT_DIR
Crea un container di addestramento e un container di calcolo della latenza
Il comando seguente creerà un'immagine di addestramento con il
seguente URI:
Cloud de Confiance by S3NS gcr.io/PROJECT_ID/TRAINER_DOCKER_ID che verrà utilizzata nel job di Agent Platform Neural Architecture Search nel
passaggio successivo.
python3 vertex_nas_cli.py build \
--project_id=PROJECT_ID \
--trainer_docker_id=TRAINER_DOCKER_ID \
--latency_calculator_docker_id=LATENCY_CALCULATOR_DOCKER_ID \
--trainer_docker_file=tf_vision/nas_multi_trial.Dockerfile \
--latency_calculator_docker_file=tf_vision/latency_computation_using_saved_model.Dockerfile
Per modificare lo spazio di ricerca e la ricompensa, aggiornali nel file Python e poi ricompila l'immagine Docker.
Testa l'addestratore localmente
Poiché l'avvio di un job nel Cloud de Confiance servizio richiede diversi minuti, potrebbe essere più
comodo testare il Docker dell'addestratore localmente, ad esempio convalidando il formato TFRecord. Utilizzando lo spazio di ricerca spinenet come esempio, puoi eseguire il job di ricerca localmente (il modello verrà campionato in modo casuale):
# Define the local job output dir.
JOB_DIR="/tmp/iod_${search_space}"

python3 vertex_nas_cli.py search_in_local \
--project_id=PROJECT_ID \
--trainer_docker_id=TRAINER_DOCKER_ID \
--prebuilt_search_space=spinenet \
--use_prebuilt_trainer=True \
--local_output_dir=${JOB_DIR} \
--search_docker_flags \
params_override="tf_vision/test_files/fast_nas_detection_spinenet_search_for_testing.yaml" \
training_data_path=TEST_COCO_TF_RECORD \
validation_data_path=TEST_COCO_TF_RECORD \
model=retinanet
training_data_path e validation_data_path sono i percorsi dei TFRecord.
Avvia un job di ricerca di fase 1 seguito da un job di addestramento di fase 2 su Cloud de Confiance
Per esempi end-to-end, consulta il notebook di classificazione MnasNet e il notebook di rilevamento di oggetti SpineNet.
Puoi impostare i flag
--max_parallel_nas_triale--max_nas_trialper personalizzare. Agent Platform Neural Architecture Search avvieràmax_parallel_nas_trialprove in parallelo e terminerà dopomax_nas_trialprove.Se il flag
--target_device_latency_msè impostato, verrà avviato un joblatency calculatorseparato con l'acceleratore specificato dal flag--target_device_type.Il controller di Agent Platform Neural Architecture Search fornirà a ogni prova un suggerimento per un nuovo candidato di architettura tramite il FLAG
--nas_params_str.Ogni prova creerà un grafico in base al valore del FLAG
nas_params_stre avvierà un job di addestramento. Ogni prova salva anche il suo valore in un file JSON (inos.path.join(nas_job_dir, str(trial_id), "nas_params_str.json")).
Ricompensa con un vincolo di latenza
Il notebook di classificazione MnasNet mostra un esempio di ricerca con vincoli di latenza basata su un dispositivo cloud-cpu.
Per cercare modelli con vincoli di latenza, l'addestratore può segnalare la ricompensa come funzione sia dell'accuratezza sia della latenza.
Nel codice sorgente condiviso, la ricompensa viene calcolata nel seguente modo:
def compute_reward(target_latency, accuracy, inference_latency, weight=0.07):
  """Compute reward from accuracy and latency."""
  speed_ratio = target_latency / inference_latency
  return accuracy * (speed_ratio**weight)
Puoi utilizzare altre varianti del reward calcolo a pagina 3
di l'articolo MnasNet.
target_device_typespecifica il tipo di dispositivo di destinazione supportato Cloud de Confiance, ad esempioNVIDIA_TESLA_P100.use_prebuilt_latency_calculatorutilizza il nostro calcolatore di latenza predefinitotf_vision/latency_computation_using_saved_model.py.target_device_latency_msspecifica la latenza del dispositivo di destinazione.
Per informazioni su come personalizzare la funzione di calcolo della latenza,
consulta tf_vision/latency_computation_using_saved_model.py.
Monitora l'avanzamento del job di Agent Platform Neural Architecture Search
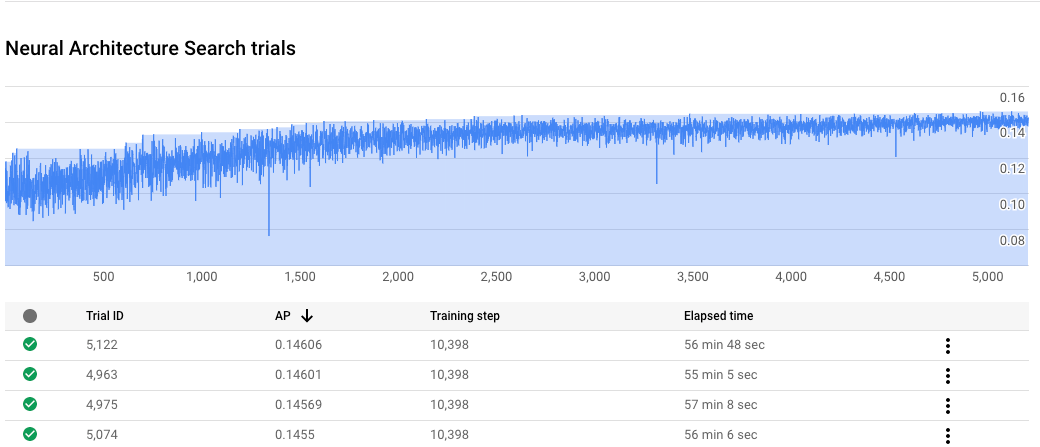
Nella Cloud de Confiance console, nella pagina del job, il grafico mostra la reward vs. trial number
mentre la tabella mostra le ricompense per ogni prova. Puoi trovare le prove migliori con la ricompensa più alta.
Traccia una curva di addestramento di fase 2
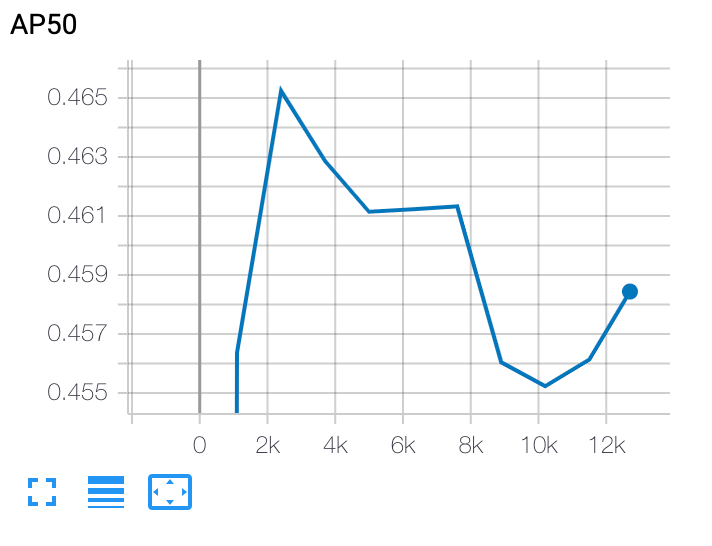
Dopo l'addestramento di fase 2, utilizza Cloud Shell o Cloud de Confiance
TensorBoard per tracciare
la curva di addestramento puntandola alla directory del job:
Esegui il deployment di un modello selezionato
Per creare un SavedModel, puoi utilizzare lo
export_saved_model.py
script con
params_override=${GCS_ROOT_DIR}/${TRIAL_ID}/params.yaml.