

בהנחה שכבר הפעלתם את המדריכים, בדף הזה מפורטות שיטות מומלצות לשימוש ב-Agent Platform Neural Architecture Search. בחלק הראשון מופיע סיכום של תהליך עבודה מלא, שאפשר לפעול לפיו כדי להריץ את העבודה שלכם ב-Agent Platform Neural Architecture Search. בחלקים הבאים מופיע תיאור מפורט של כל שלב. מומלץ מאוד לקרוא את כל הדף הזה לפני שמריצים את העבודה הראשונה ב-Agent Platform Neural Architecture Search.
הצעה לתהליך עבודה
כאן אנחנו מסכמים את תהליך העבודה המומלץ לחיפוש ארכיטקטורה עצבית ב-Agent Platform, ומספקים קישורים לקטעים המתאימים לפרטים נוספים:
- פיצול של מערך נתוני האימון לחיפוש בשלב 1.
- חשוב לוודא שמרחב החיפוש עומד בהנחיות שלנו.
- מריצים אימון מלא עם מודל הבסיס ומקבלים עקומת אימות.
- מריצים כלי עיצוב של משימות פרוקסי כדי למצוא את משימת הפרוקסי הכי טובה.
- מבצעים בדיקות סופיות למשימת ה-proxy.
- מגדירים את המספר הנכון של תקופות ניסיון כוללות ותקופות ניסיון מקבילות ואז מתחילים את החיפוש.
- עוקבים אחרי תרשים החיפוש ומפסיקים אותו כשהוא מתכנס או כשמוצג בו מספר גדול של שגיאות או כשלא רואים בו סימן להתכנסות.
- מריצים אימון מלא עם כ-10 ניסויים מובילים שנבחרו מתוך החיפוש כדי לקבל את התוצאה הסופית. כדי להשיג את הביצועים הכי טובים שאפשר, יכול להיות שתצטרכו להשתמש ביותר הגדלות או במשקלים שאומנו מראש.
- לנתח את המדדים או הנתונים ששמרתם מהחיפוש ולהסיק מסקנות לגבי איטרציות עתידיות של מרחב החיפוש.
חיפוש טיפוסי של ארכיטקטורה עצבית ב-Agent Platform

האיור שלמעלה מציג עקומת חיפוש אופיינית של ארכיטקטורה עצבית ב-Agent Platform.
המספר Y-axis כאן מציין את מספר תקופות הניסיון עם תגמולים, והמספר X-axis מציין את מספר תקופות הניסיון שהופעלו עד עכשיו.
בדרך כלל, ב-100 עד 200 הניסויים הראשונים, הבקר מבצע חיפושים אקראיים במרחב החיפוש.
במהלך הבדיקות הראשוניות האלה, התגמולים מראים שונות גבוהה כי המערכת מנסה הרבה סוגים של מודלים במרחב החיפוש.
ככל שמספר הניסויים גדל, הבקר מתחיל למצוא מודלים טובים יותר. לכן, התגמול מתחיל לעלות, ואז השונות של התגמול והגידול בתגמול מתחילים לרדת, וכך מתקבלת התכנסות. מספר הניסויים שנדרשים כדי להגיע להתכנסות יכול להשתנות בהתאם לגודל מרחב החיפוש, אבל בדרך כלל מדובר בסדר גודל של כ-2,000 ניסויים.
שני שלבים של Agent Platform Neural Architecture Search: proxy-task ואימון מלא
הפעולה של Agent Platform Neural Architecture Search מחולקת לשני שלבים:
בשלב 1 – חיפוש נעשה שימוש בייצוג קטן בהרבה של האימון המלא, שבדרך כלל מסתיים תוך שעה עד שעתיים. הייצוג הזה נקרא משימת proxy והוא עוזר להקטין את עלות החיפוש.
בשלב 2 של האימון המלא, מתבצע אימון מלא של כ-10 המודלים המובילים מתוך שלב 1 של החיפוש. בגלל האופי הסטוכסטי של החיפוש, יכול להיות שהמודל העליון מחיפוש בשלב 1 לא יהיה המודל העליון במהלך האימון המלא בשלב 2. לכן חשוב לבחור מאגר של מודלים לאימון מלא.
מכיוון שהבקר מקבל את אות התגמול ממשימת הפרוקסי הקטנה יותר במקום מהאימון המלא, חשוב למצוא משימת פרוקסי אופטימלית למשימה שלכם.
עלות של Agent Platform Neural Architecture Search
העלות של Agent Platform Neural Architecture Search היא:
search-cost = num-trials-to-converge * avg-proxy-task-cost.
בהנחה שזמן החישוב של משימת ה-proxy הוא בערך 1/30 מזמן האימון המלא, ומספר הניסויים שנדרשים להתכנסות הוא בערך 2,000, אז עלות החיפוש היא בערך 67 * full-training-cost.
העלות של חיפוש ארכיטקטורה עצבית ב-Agent Platform גבוהה, ולכן מומלץ להקדיש זמן לכוונון של משימת ה-proxy ולהשתמש במרחב חיפוש קטן יותר לחיפוש הראשון.
פיצול של קבוצת נתונים בין שני שלבים של חיפוש ארכיטקטורה עצבית ב-Agent Platform
בהנחה שכבר יש לכם את training-data ואת validation-data לאימון הבסיסי, מומלץ לפצל את מערך הנתונים באופן הבא לשני השלבים של NAS Agent Platform Neural Architecture Search:
- Stage1-search training: ~90% of training-data
אימות שלב 1: ~10% מנתוני האימון
אימון Stage2-full-training: 100% מנתוני האימון
אימות שלב 2 – אימון מלא: 100% מנתוני האימות
פיצול נתוני האימון של שלב 2 זהה לפיצול נתוני האימון הרגיל. אבל בשלב 1 נעשה שימוש בפיצול נתוני האימון לצורך אימות. שימוש בנתוני אימות שונים בשלב 1 ובשלב 2 עוזר לזהות הטיה בחיפוש המודל בגלל פיצול מערך הנתונים. חשוב לוודא שנתוני האימון עברו ערבוב טוב לפני שמחלקים אותם עוד יותר, ושפיצול נתוני האימון הסופי של 10% דומה לפיצול נתוני האימות המקוריים.
נתונים בכמות קטנה או לא מאוזנים
לא מומלץ להשתמש בחיפוש ארכיטקטורה עם נתוני אימון מוגבלים או עם מערכי נתונים לא מאוזנים מאוד שבהם חלק מהסיווגים נדירים מאוד. אם אתם כבר משתמשים בהרחבות משמעותיות לאימון הבסיסי שלכם בגלל חוסר בנתונים, לא מומלץ להשתמש בחיפוש המודל.
במקרה כזה, אפשר להריץ רק את החיפוש לשיפור כדי לחפש את מדיניות השיפור הטובה ביותר, במקום לחפש ארכיטקטורה אופטימלית.
חיפוש עיצובים של מרחבים
לא מומלץ לשלב בין חיפוש ארכיטקטורה לבין חיפוש הגדרה או חיפוש היפרפרמטרים (כמו קצב למידה או הגדרות אופטימיזציה). המטרה של חיפוש ארכיטקטורה היא להשוות את הביצועים של מודל א' לביצועים של מודל ב' כשיש הבדלים רק על בסיס הארכיטקטורה. לכן, הגדרות ההגדרה וההיפרפרמטרים צריכות להישאר זהות.
אפשר לבצע את החיפוש המשופר בשלב אחר אחרי שמסיימים את חיפוש הארכיטקטורה.
החיפוש של ארכיטקטורות עצביות ב-Agent Platform יכול להגיע לגודל של 10^20 במרחב החיפוש. אבל אם מרחב החיפוש גדול יותר, אפשר לחלק אותו לחלקים שלא חופפים. לדוגמה, אפשר לחפש את המקודד בנפרד מהפענוח או מהראש. אם עדיין רוצים לבצע חיפוש משותף של כולם, אפשר ליצור מרחב חיפוש קטן יותר סביב האפשרויות הטובות ביותר שנמצאו קודם.
(אופציונלי) כשמעצבים מרחב חיפוש, אפשר להפריד בין התאמת המודל לבין עיצוב הבלוקים. קודם צריך לבצע את החיפוש של עיצוב הבלוק באמצעות מודל מוקטן. כך אפשר להקטין משמעותית את העלות של זמן הריצה של משימות פרוקסי. לאחר מכן תוכלו לבצע חיפוש נפרד כדי להרחיב את המודל. מידע נוסף זמין במאמר
Examples of scaled down models.
אופטימיזציה של זמן האימון וזמן החיפוש
לפני שמריצים את Agent Platform Neural Architecture Search, חשוב לבצע אופטימיזציה של זמן האימון של מודל הבסיס. כך תוכלו לחסוך בעלויות בטווח הארוך. ריכזנו כאן כמה אפשרויות לאופטימיזציה של האימון:
- מקסום מהירות טעינת הנתונים:
- מוודאים שה-bucket שבו הנתונים נמצאים הוא באותו אזור כמו העבודה.
- אם משתמשים ב-TensorFlow, אפשר לעיין במאמר
Best practice summary. אפשר גם לנסות להשתמש בפורמט TFRecord לנתונים. - אם משתמשים ב-PyTorch, צריך לפעול לפי ההנחיות לאימון יעיל של PyTorch.
- כדי לנצל את היתרונות של כמה מאיצים או כמה מכונות, אפשר להשתמש באימון מבוזר.
- כדי להאיץ משמעותית את האימון ולצמצם את השימוש בזיכרון, כדאי להשתמש באימון עם דיוק מעורב.
מידע על אימון ב-TensorFlow עם דיוק מעורב זמין במאמר
Mixed Precision. - חלק מהמאיצים (כמו A100) בדרך כלל חסכוניים יותר.
- כדאי לשנות את גודל האצווה כדי למקסם את השימוש ב-GPU.
בתרשים הבא אפשר לראות שה-GPU לא מנוצל מספיק (ב-50%).
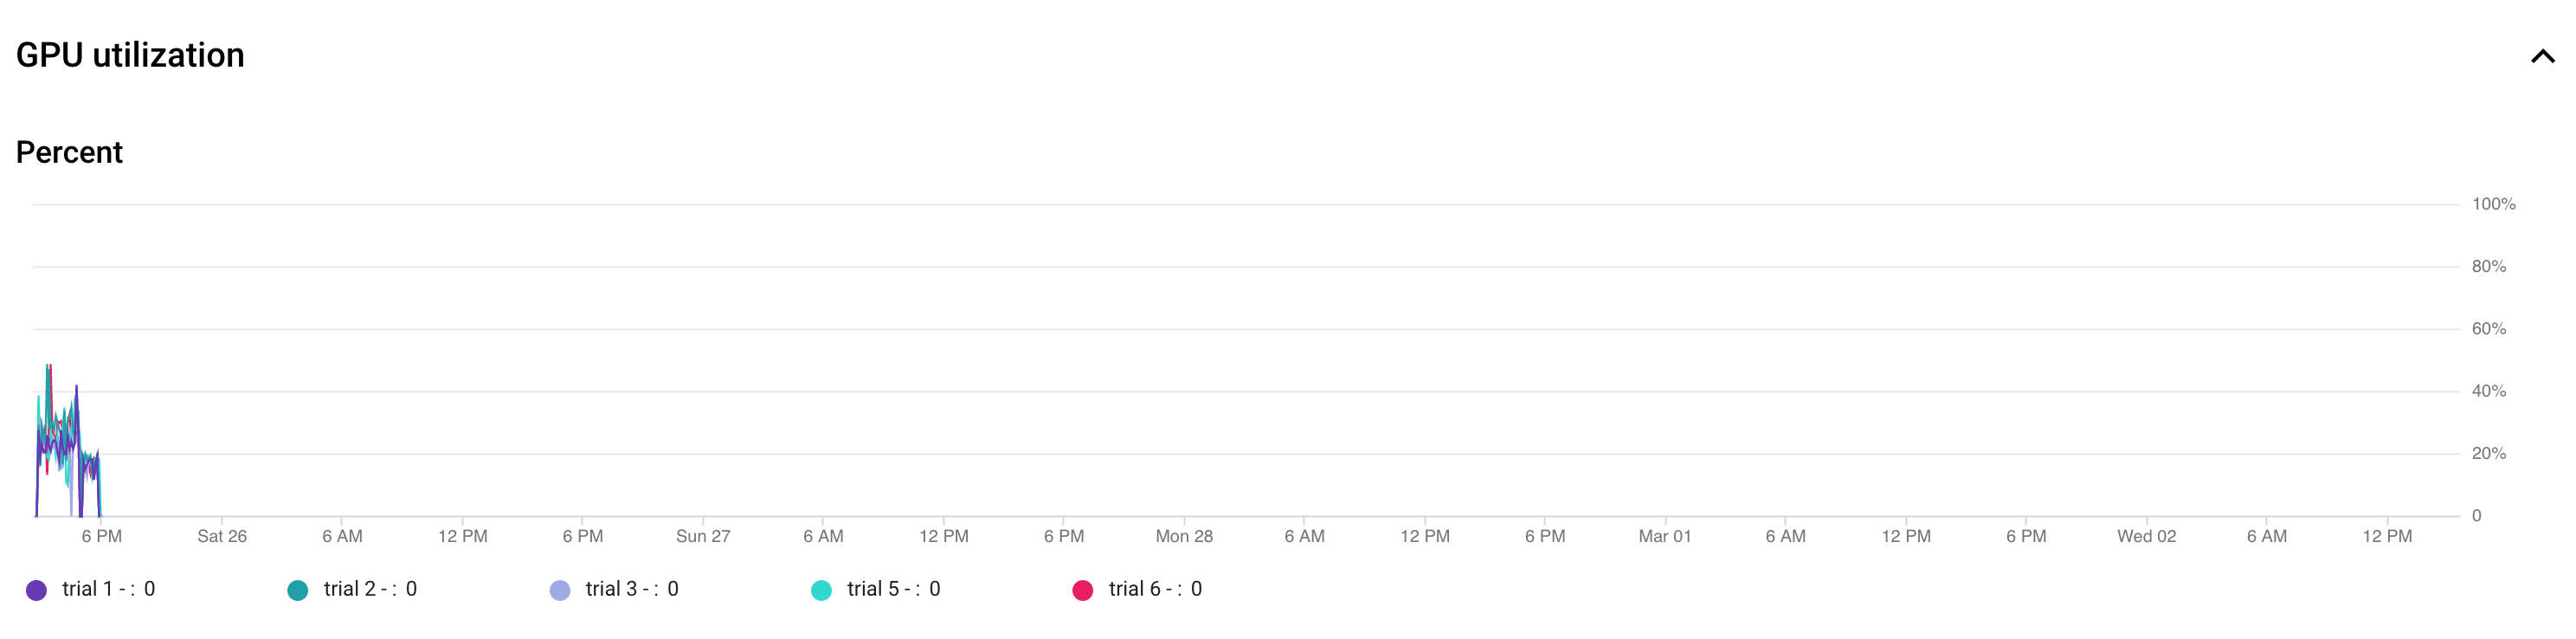 הגדלת גודל האצווה יכולה לעזור להשתמש ביחידות GPU בצורה יעילה יותר. עם זאת, צריך להגדיל את גודל האצווה בזהירות כי הוא עלול להגדיל את שגיאות חוסר הזיכרון במהלך החיפוש.
- אם בלוקים מסוימים בארכיטקטורה לא תלויים במרחב החיפוש, אפשר לנסות לטעון נקודות ביקורת שאומנו מראש עבור הבלוקים האלה כדי להאיץ את האימון. נקודות הבדיקה שאומנו מראש צריכות להיות זהות במרחב החיפוש, ולא להציג הטיה. לדוגמה, אם מרחב החיפוש מיועד רק למפענח, המקודד יכול להשתמש בנקודות ביקורת שאומנו מראש.
מספר המעבדים הגרפיים לכל ניסיון חיפוש
כדי לקצר את זמן ההתחלה, כדאי להשתמש במספר קטן יותר של מעבדי GPU לכל ניסוי. לדוגמה, התחלה של 2 מעבדי GPU נמשכת 5 דקות, בעוד שהתחלה של 8 מעבדי GPU נמשכת 20 דקות. יעיל יותר להשתמש ב-2 מעבדי GPU לכל ניסוי כדי להריץ משימת proxy של חיפוש ארכיטקטורה עצבית ב-Agent Platform.
סך הניסויים והניסויים המקבילים לרשת החיפוש
הגדרה כוללת של תקופת ניסיון
אחרי שמחפשים ובוחרים את משימת הפרוקסי הטובה ביותר, אפשר להפעיל חיפוש מלא. אי אפשר לדעת מראש כמה ניסיונות יידרשו כדי להגיע לנקודת ההתכנסות. מספר הניסויים שנדרשים כדי להגיע להתכנסות יכול להשתנות בהתאם לגודל מרחב החיפוש, אבל בדרך כלל מדובר בסדר גודל של כ-2,000 ניסויים.
מומלץ להגדיר ערך גבוה מאוד ל---max_nas_trial: בערך 5,000 עד 10,000, ואז לבטל את עבודת החיפוש מוקדם יותר אם הגרף של החיפוש מראה התכנסות. אפשר גם להפעיל מחדש עבודת חיפוש קודמת באמצעות הפקודה search_resume. עם זאת, אי אפשר להפעיל מחדש את החיפוש מעבודת חיפוש אחרת. לכן, אפשר להפעיל מחדש עבודת חיפוש מקורית רק פעם אחת.
הגדרה של תקופות ניסיון מקבילות
השלב הראשון של עבודת החיפוש מבצע עיבוד באצווה על ידי הפעלת --max_parallel_nas_trial מספר ניסויים במקביל בכל פעם. זה חשוב כדי לצמצם את זמן הריצה הכולל של עבודת החיפוש. אפשר לחשב את מספר הימים הצפוי לחיפוש:
days-required-for-search = (trials-to-converge / max-parallel-nas-trial) * (avg-trial-duration-in-hours / 24)
הערה: אפשר להשתמש בהתחלה ב-3000 כהערכה גסה ל-trials-to-converge, שמהווה גבול עליון טוב להתחלה. אפשר להשתמש בהתחלה ב-2 שעות כהערכה גסה ל-avg-trial-duration-in-hours, שמהווה גבול עליון טוב לזמן שנדרש לכל משימת proxy. מומלץ להשתמש בהגדרה --max_parallel_nas_trial של ~20-to-50 בהתאם למכסת המאיצים שיש לפרויקט ול-days-required-for-search. לדוגמה, אם מגדירים את --max_parallel_nas_trial כ-20 וכל משימת proxy משתמשת בשני מעבדי GPU מסוג NVIDIA T4, צריך להקצות מכסה של לפחות 40 מעבדי GPU מסוג NVIDIA T4. ההגדרה --max_parallel_nas_trial לא משפיעה על תוצאת החיפוש הכוללת, אבל היא משפיעה על days-required-for-search. אפשר להגדיר ערך קטן יותר ל-max_parallel_nas_trial, כמו 10 בערך (20 מעבדי GPU), אבל אז צריך להעריך באופן גס את days-required-for-search ולוודא שהוא נמצא במגבלת הזמן הקצוב לתפוגה של העבודה.
בדרך כלל, עבודת ההכשרה stage2-full-training מכשירה את כל הניסויים במקביל כברירת מחדל. בדרך כלל מדובר ב-10 ניסויים מובילים שפועלים במקביל. עם זאת, אם כל ניסיון של שלב 2-אימון מלא משתמש ביותר מדי מעבדי GPU (לדוגמה, שמונה מעבדי GPU כל אחד) לתרחיש השימוש שלכם ואין לכם מכסת שימוש מספקת, אתם יכולים להריץ באופן ידני משימות של שלב 2 באצוות. לדוגמה, אתם יכולים להריץ שלב 2-אימון מלא רק לחמישה ניסיונות, ואז להריץ שלב 2-אימון מלא נוסף לחמישה ניסיונות הבאים.
ברירת המחדל של הזמן הקצוב לתפוגה של משימה
הזמן הקצוב לתפוגה של עבודת NAS מוגדר כברירת מחדל ל-14 ימים, ואחרי כן העבודה מבוטלת. אם אתם צופים שההרצה של העבודה תימשך זמן רב יותר, אתם יכולים לנסות להמשיך את עבודת החיפוש רק עוד פעם אחת למשך 14 ימים נוספים. בסך הכול, אפשר להריץ חיפוש עבודה למשך 28 ימים, כולל קורות חיים.
ההגדרה 'מספר מקסימלי של ניסיונות כושלים'
מספר הניסיונות המקסימלי הכושל צריך להיות בערך שליש מההגדרה max_nas_trial. העבודה תבוטל כשהמספר של הניסיונות הכושלים יגיע למגבלה הזו.
מתי להפסיק את החיפוש
כדאי להפסיק את החיפוש במקרים הבאים:
העקומה של החיפוש מתחילה להתכנס (השונות יורדת):
הערה: אם לא נעשה שימוש באילוץ השהיה או אם נעשה שימוש באילוץ השהיה הקשיח עם מגבלת השהיה רופפת, יכול להיות שלא יופיע בעקומה גידול בתגמול, אבל עדיין אמור להופיע התכנסות. הסיבה לכך היא שהבקר כבר ראה רמות דיוק טובות בשלב מוקדם של החיפוש.יותר מ-20% מהניסיונות שלך מציגים תגמולים לא תקינים (כשלים):
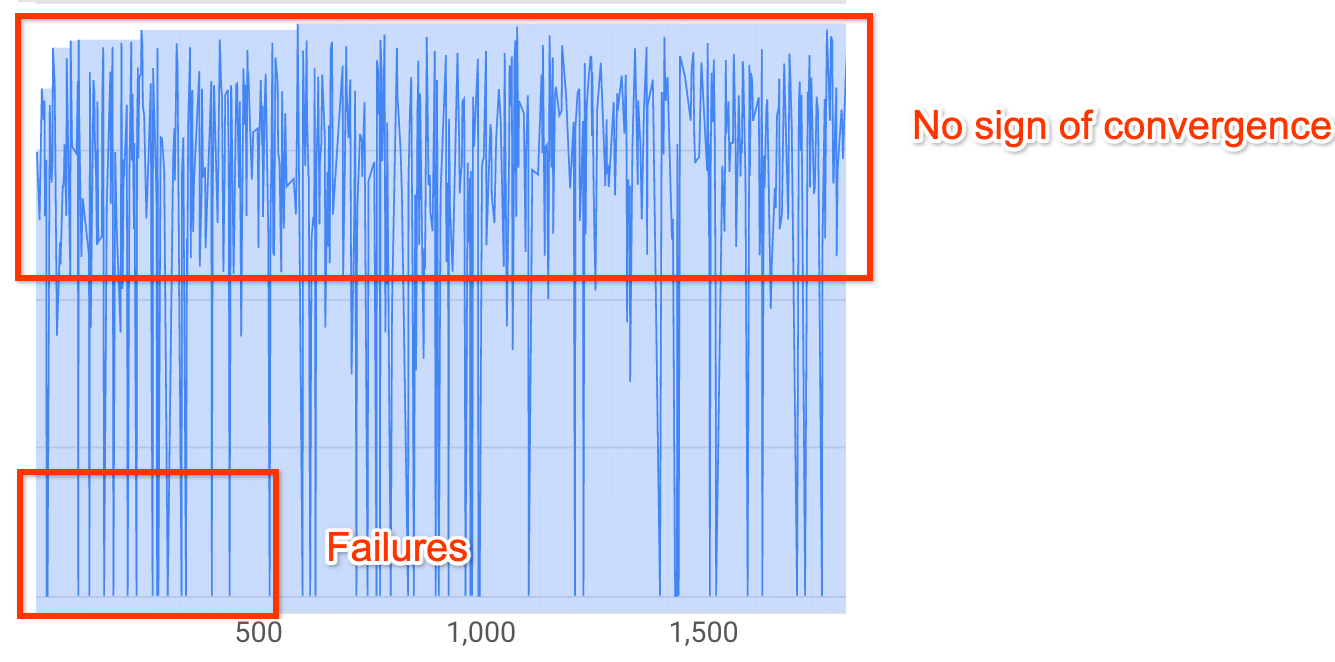
עקומת החיפוש לא עולה ולא מתכנסת (כפי שמוצג למעלה) גם אחרי כ-500 ניסיונות. אם מוצגות העלייה בפרס או הירידה בשונות, אפשר להמשיך.