

Supponendo che tu abbia già eseguito i tutorial, questa pagina descrive le best practice per Agent Platform Neural Architecture Search. La prima sezione riepiloga un workflow completo, che puoi seguire per il tuo job Agent Platform Neural Architecture Search. Le altre sezioni forniscono una descrizione dettagliata di ogni passaggio. Ti consigliamo vivamente di leggere l'intera pagina prima di eseguire il primo job di Agent Platform Neural Architecture Search.
Workflow suggerito
Di seguito riassumiamo un flusso di lavoro suggerito per Agent Platform Neural Architecture Search e forniamo i link alle sezioni corrispondenti per maggiori dettagli:
- Dividi il set di dati di addestramento per la ricerca di primo livello.
- Assicurati che il tuo spazio di ricerca rispetti le nostre linee guida.
- Esegui l'addestramento completo con il modello di base e ottieni una curva di convalida.
- Esegui gli strumenti di progettazione delle attività proxy per trovare l'attività proxy migliore.
- Esegui i controlli finali per l'attività di proxy.
- Imposta il numero corretto di prove totali e parallele e poi avvia la ricerca.
- Monitora il grafico di ricerca e interrompilo quando converge o mostra un numero elevato di errori o non mostra alcun segno di convergenza.
- Esegui l'addestramento completo con le prime 10 prove scelte dalla ricerca per il risultato finale. Per l'addestramento completo, puoi utilizzare più aumenti o pesi preaddestrati per ottenere il miglior rendimento possibile.
- Analizza le metriche/i dati salvati dalla ricerca e trai conclusioni per le future iterazioni dello spazio di ricerca.
Tipica ricerca di architetture neurali di Agent Platform
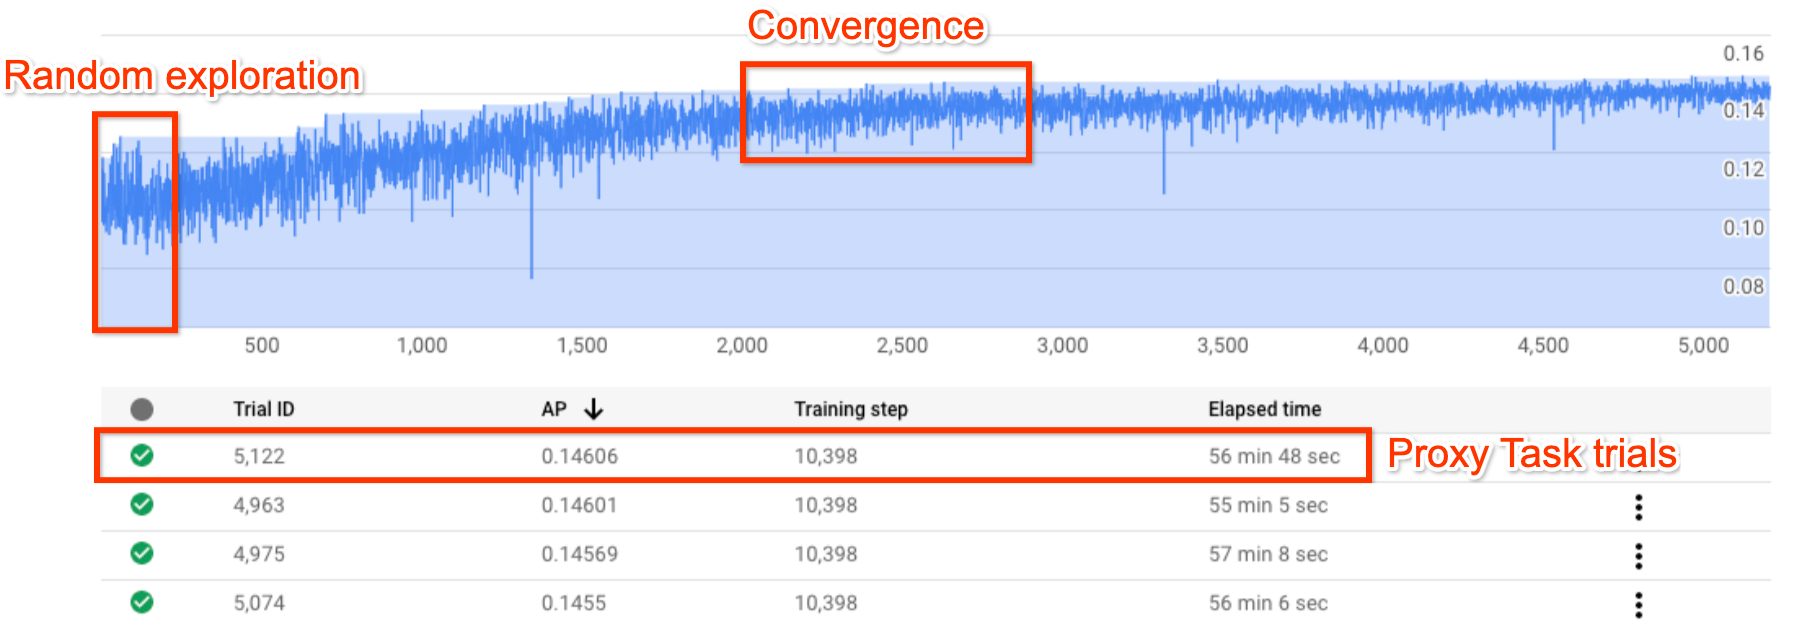
La figura sopra mostra una tipica curva di ricerca dell'architettura neurale di Agent Platform.
Y-axis mostra le prove e i premi
X-axis mostra il numero di prove lanciate finora.
I primi 100-200 tentativi sono per lo più esplorazioni casuali
dello spazio di ricerca da parte del controller.
Durante queste esplorazioni iniziali, le ricompense mostrano
una grande varianza perché vengono provati molti tipi di modelli
nello spazio di ricerca.
Man mano che il numero di prove aumenta, il controller inizia a trovare modelli migliori. Pertanto, la ricompensa inizia prima ad aumentare, poi la
varianza e la crescita della ricompensa iniziano a diminuire,
mostrando così la convergenza. Il numero di prove
in cui si verifica la convergenza può variare in base alle
dimensioni dello spazio di ricerca, ma in genere è dell'ordine di circa 2000 prove.
Due fasi di Agent Platform Neural Architecture Search: attività proxy e addestramento completo
Agent Platform Neural Architecture Search funziona in due fasi:
La ricerca Stage1 utilizza una rappresentazione molto più piccola dell'addestramento completo, che in genere termina entro 1-2 ore. Questa rappresentazione è chiamata attività proxy e contribuisce a mantenere basso il costo della ricerca.
Stage2-full-training prevede l'addestramento completo per i circa 10 modelli con il punteggio più alto della fase 1-search. A causa della natura stocastica della ricerca, il modello in primo piano della fase 1-search potrebbe non essere il modello in primo piano durante la fase 2-full-training e, pertanto, è importante selezionare un pool di modelli per l'addestramento completo.
Poiché il controller riceve il segnale di ricompensa dall'attività proxy più piccola anziché dall'addestramento completo, è importante trovare un'attività proxy ottimale per la tua attività.
Costo di Agent Platform Neural Architecture Search
Il costo di Neural Architecture Search di Agent Platform è dato da:
search-cost = num-trials-to-converge * avg-proxy-task-cost.
Supponendo che il tempo di calcolo del proxy-task sia circa 1/30 del tempo di addestramento completo e che il numero di prove necessarie per la convergenza sia circa 2000, il costo della ricerca diventa circa 67 * full-training-cost.
Poiché il costo di Agent Platform Neural Architecture Search è elevato, è consigliabile dedicare del tempo all'ottimizzazione dell'attività proxy e utilizzare uno spazio di ricerca più piccolo per la prima ricerca.
Divisione del set di dati tra due fasi di Agent Platform Neural Architecture Search
Supponendo che tu disponga già dei dati di addestramento e dei dati di convalida per l'addestramento di base, per le due fasi di NAS Agent Platform Neural Architecture Search è consigliata la seguente suddivisione del set di dati:
- Fase 1 - Addestramento della ricerca: circa il 90% dei dati di addestramento
Fase 1 - Convalida della ricerca: circa il 10% dei dati di addestramento
Addestramento Stage2-full-training: 100% dei dati di addestramento
Stage2-full-training validation: 100% of validation-data
La suddivisione dei dati di addestramento stage2-full-training è la stessa dell'addestramento normale. Tuttavia, la fase 1 della ricerca utilizza una suddivisione dei dati di addestramento per la convalida. L'utilizzo di dati di convalida diversi nella fase 1 e nella fase 2 consente di rilevare eventuali bias di ricerca del modello dovuti alla suddivisione del set di dati. Assicurati che i dati di addestramento siano ben mischiati prima di suddividerli ulteriormente e che la suddivisione finale del 10% dei dati di addestramento abbia una distribuzione simile a quella dei dati di convalida originali.
Dati di piccole dimensioni o sbilanciati
La ricerca dell'architettura non è consigliata con dati di addestramento limitati o per set di dati molto sbilanciati in cui alcune classi sono molto rare. Se utilizzi già aumenti pesanti per l'addestramento di base a causa della mancanza di dati, la ricerca del modello non è consigliata.
In questo caso, puoi eseguire solo la ricerca di aumento per cercare la migliore norma di aumento anziché cercare un'architettura ottimale.
Progettazione dello spazio di ricerca
La ricerca dell'architettura non deve essere combinata con la ricerca di aumento o con la ricerca degli iperparametri (ad esempio, impostazioni del tasso di apprendimento o dell'ottimizzatore). L'obiettivo della ricerca dell'architettura è confrontare il rendimento del modello A con quello del modello B quando esistono solo differenze basate sull'architettura. Pertanto, le impostazioni di aumento e degli iperparametri devono rimanere invariate.
La ricerca di aumento può essere eseguita in una fase diversa dopo la ricerca dell'architettura.
Agent Platform Neural Architecture Search può raggiungere dimensioni dello spazio di ricerca fino a 10^20. Tuttavia, se lo spazio di ricerca è più grande, puoi dividerlo in parti mutualmente esclusive. Ad esempio, puoi cercare separatamente l'encoder dal decoder o dalla testa. Se vuoi comunque eseguire una ricerca congiunta su tutti, puoi creare uno spazio di ricerca più piccolo intorno alle migliori opzioni individuali trovate in precedenza.
(Facoltativo) Puoi separare lo scaling del modello dalla progettazione dei blocchi quando progetti uno spazio di ricerca. La ricerca della progettazione dei blocchi deve essere eseguita prima con un modello ridimensionato. In questo modo, il costo del runtime dell'attività proxy può essere molto inferiore. Puoi quindi eseguire una ricerca separata per scalare il modello. Per ulteriori informazioni, consulta
Examples of scaled down models.
Ottimizzare i tempi di addestramento e ricerca
Prima di eseguire la ricerca di architetture neurali di Agent Platform, è importante ottimizzare il tempo di addestramento per il modello di base. In questo modo risparmierai costi a lungo termine. Ecco alcune opzioni per ottimizzare l'addestramento:
- Massimizzare la velocità di caricamento dei dati:
- Assicurati che il bucket in cui si trovano i tuoi dati si trovi nella stessa regione del job.
- Se utilizzi TensorFlow, consulta
Best practice summary. Puoi anche provare a utilizzare il formato TFRecord per i tuoi dati. - Se utilizzi PyTorch, segui le linee guida per un addestramento efficiente di PyTorch.
- Utilizza l'addestramento distribuito per sfruttare più acceleratori o più macchine.
- Utilizza l'addestramento in precisione mista
per ottenere un aumento significativo della velocità di addestramento e una riduzione della memoria utilizzata.
Per l'addestramento in precisione mista di TensorFlow,
consulta
Mixed Precision. - Alcuni acceleratori (come A100) sono in genere più efficienti in termini di costi.
- Ottimizza la dimensione del batch per assicurarti di massimizzare l'utilizzo della GPU.
Il seguente grafico mostra il sottoutilizzo delle GPU (al 50%).
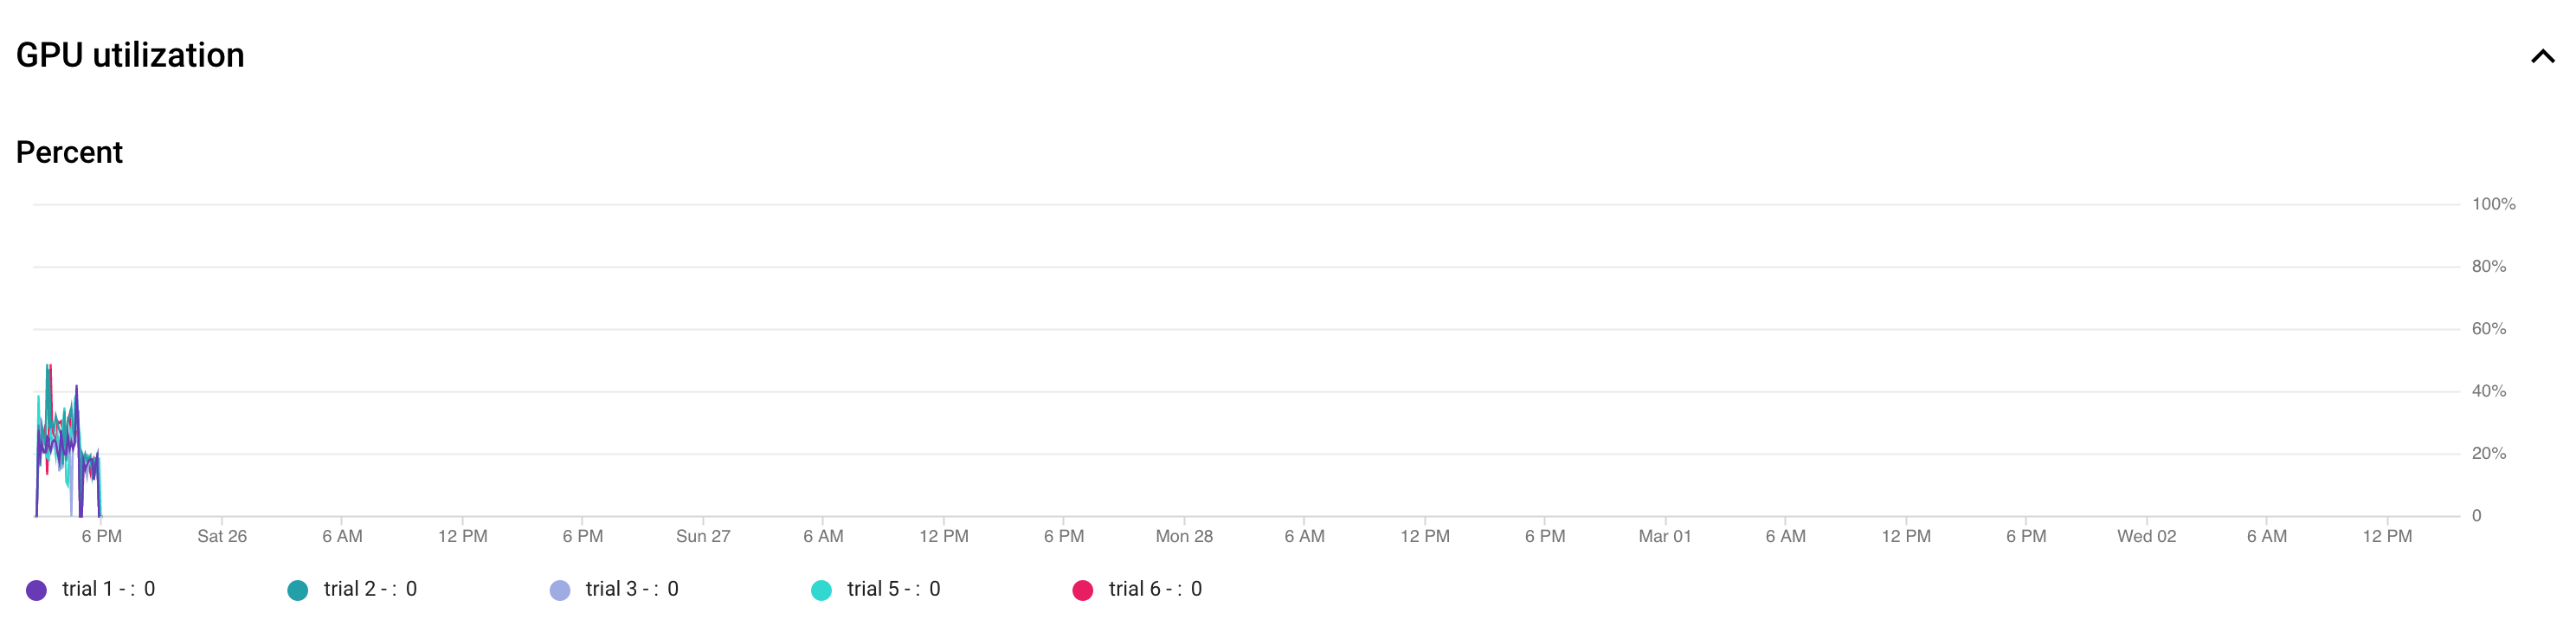 L'aumento della dimensione del batch può contribuire a utilizzare maggiormente le GPU. Tuttavia, le dimensioni del batch
devono essere aumentate con attenzione, in quanto possono aumentare
gli errori di memoria insufficiente durante la ricerca.
- Se determinati blocchi di architettura sono indipendenti dallo spazio di ricerca, puoi provare a caricare i checkpoint preaddestrati per questi blocchi per un addestramento più rapido. I checkpoint preaddestrati devono essere uguali nello spazio di ricerca e non devono introdurre un bias. Ad esempio, se lo spazio di ricerca è solo per il decoder, l'encoder può utilizzare i checkpoint preaddestrati.
Numero di GPU per ogni prova di ricerca
Utilizza un numero inferiore di GPU per prova per ridurre il tempo di avvio. Ad esempio, l'avvio di 2 GPU richiede 5 minuti, mentre l'avvio di 8 GPU richiede 20 minuti. È più efficiente utilizzare 2 GPU per prova per eseguire un'attività proxy del job di Agent Platform Neural Architecture Search.
Prove totali e prove parallele per la rete di ricerca
Impostazione totale della prova
Dopo aver cercato e selezionato l'attività proxy migliore, puoi avviare una ricerca completa. Non è possibile sapere in anticipo il numero di prove necessarie per la convergenza. Il numero di prove in cui si verifica la convergenza può variare in base alle dimensioni dello spazio di ricerca, ma in genere è dell'ordine di circa 2000 prove.
Ti consigliamo un'impostazione molto elevata
per --max_nas_trial: circa 5000-10.000 e poi
annullare il job di ricerca in precedenza se il
grafico di ricerca mostra la convergenza.
Hai anche la possibilità di riprendere un job di ricerca precedente utilizzando
il comando search_resume.
Tuttavia, non puoi riprendere la ricerca da un altro job di ripresa della ricerca.
Pertanto, puoi riprendere un job di ricerca originale una sola volta.
Impostazione delle prove parallele
Il job stage1-search esegue l'elaborazione batch eseguendo
--max_parallel_nas_trial prove in parallelo
alla volta. Ciò è fondamentale per ridurre il runtime complessivo
del job di ricerca. Puoi calcolare il numero previsto di giorni per la ricerca:
days-required-for-search = (trials-to-converge / max-parallel-nas-trial) * (avg-trial-duration-in-hours / 24)
Nota: inizialmente puoi utilizzare 3000 come stima approssimativa di trials-to-converge, che è un buon limite superiore da cui iniziare. Inizialmente puoi utilizzare 2 ore
come stima approssimativa per avg-trial-duration-in-hours, che
rappresenta un buon limite superiore per il tempo impiegato da ogni attività proxy.
È consigliabile
utilizzare l'impostazione --max_parallel_nas_trial
di circa 20-50 a seconda di quanta quota di acceleratore
ha il tuo progetto e
days-required-for-search.
Ad esempio, se imposti --max_parallel_nas_trial su 20 e ogni attività proxy utilizza due GPU NVIDIA T4, devi aver riservato una quota di almeno 40 GPU NVIDIA T4. L'impostazione
--max_parallel_nas_trial non influisce sul risultato di ricerca
generale, ma ha un impatto sul days-required-for-search.
È possibile anche un'impostazione più piccola per max_parallel_nas_trial, ad esempio circa 10 (20 GPU), ma in questo caso devi stimare approssimativamente days-required-for-search e assicurarti che rientri nel limite di timeout del job.
Per impostazione predefinita, il job stage2-full-training addestra in parallelo tutte le prove. In genere, si tratta delle prime 10 prove eseguite in parallelo. Tuttavia, se ogni prova stage2-full-training utilizza troppe GPU (ad esempio, otto GPU ciascuna) per il tuo caso d'uso e non disponi di una quota sufficiente, puoi eseguire manualmente i job stage2 in batch, ad esempio eseguire un job stage2-full-training per le prime cinque prove e poi un altro per le successive cinque prove.
Timeout job predefinito
Il timeout predefinito del job NAS è impostato su 14 giorni, dopodiché il job viene annullato. Se prevedi di eseguire il job per un periodo di tempo più lungo, puoi provare a riprendere il job di ricerca solo un'altra volta per altri 14 giorni. In generale, puoi pubblicare un annuncio di ricerca per 28 giorni, incluso il curriculum.
Impostazione del numero massimo di prove non riuscite
Il numero massimo di prove non riuscite deve essere impostato su circa un terzo dell'impostazione max_nas_trial. Il job verrà annullato quando il numero di
tentativi non riusciti raggiungerà questo limite.
Quando interrompere la ricerca
Devi interrompere la ricerca quando:
La curva di ricerca inizia a convergere (la varianza diminuisce):
Nota:se non viene utilizzato alcun vincolo di latenza o se viene utilizzato il vincolo di latenza rigido con un limite di latenza blando, la curva potrebbe non mostrare un aumento della ricompensa, ma dovrebbe comunque mostrare la convergenza. Questo perché il controller potrebbe aver già riscontrato una buona precisione all'inizio della ricerca.Più del 20% delle prove mostra premi non validi (errori):
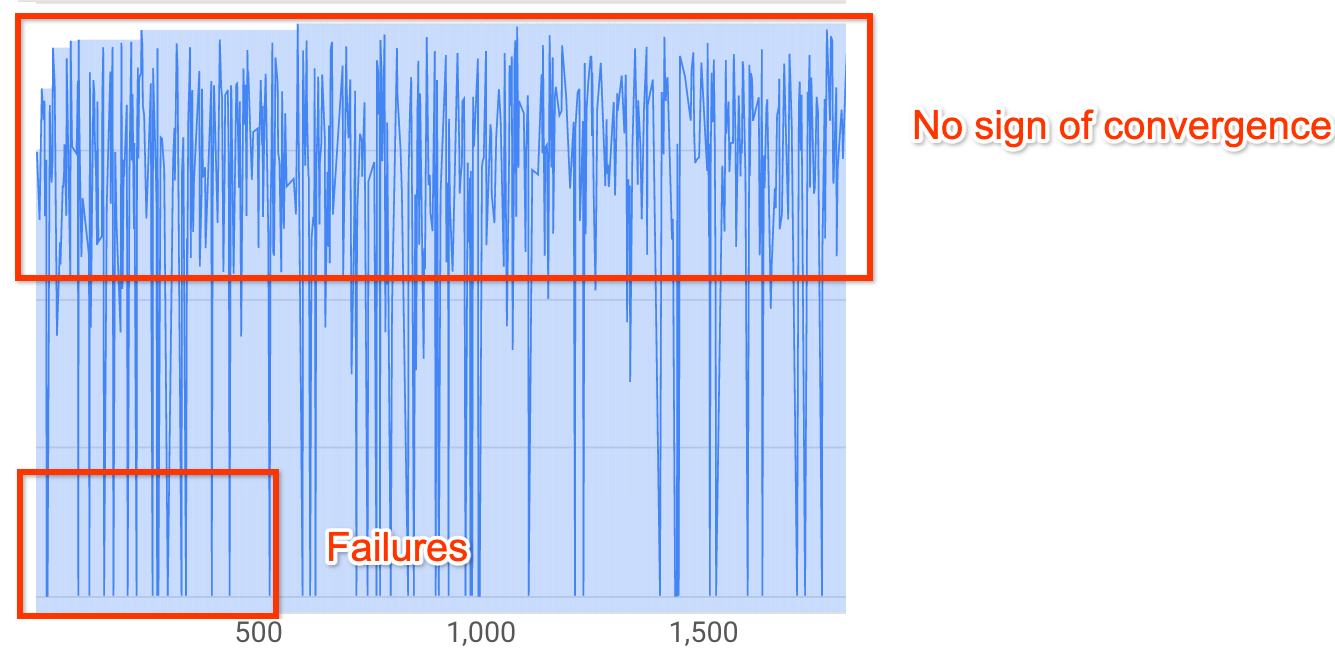
La curva di ricerca non aumenta né converge (come mostrato sopra) anche dopo circa 500 prove. Se mostra un aumento della ricompensa o una diminuzione della varianza, puoi continuare.