

Les clusters d'entraînement exécutent des vérifications d'état automatisées sur vos nœuds et interviennent en cas d'échec. Par exemple, en cas d'erreur XID fatale, ils peuvent drainer le nœud, remettre en file d'attente la tâche Slurm concernée et recréer le nœud. Chacune de ces interventions est écrite dans les journaux de votre projet en tant qu'événement de résilience.
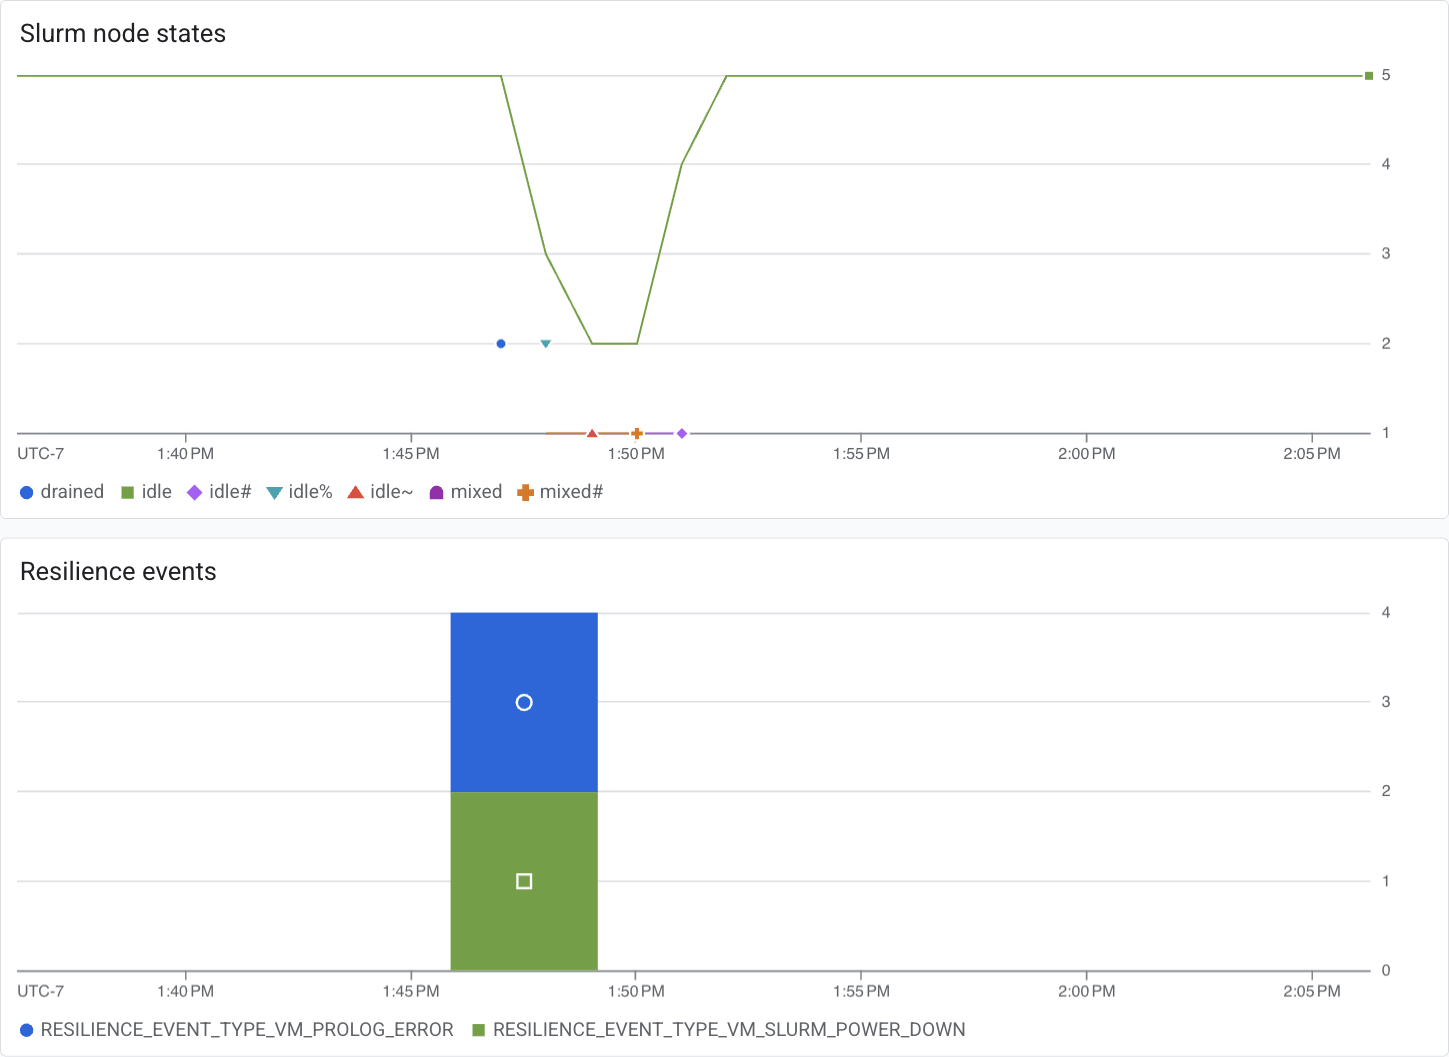
Cette page vous explique comment créer un tableau de bord Cloud Monitoring personnalisé qui représente ces événements de résilience à côté de l'état Slurm de vos nœuds de calcul. Vous pouvez ainsi voir les actions de récupération effectuées par le service et leur corrélation avec l'état de votre cluster. Le tableau de bord comporte deux graphiques :
- États des nœuds Slurm : nombre de nœuds dans chaque état Slurm au fil du temps,
extrait de la métrique
hypercomputecluster.googleapis.com/slurm/node_state. - Événements de résilience : nombre d'événements de résilience, répartis par type d'événement, extrait d'une métrique basée sur les journaux que vous créez dans la section suivante.
Avant de commencer
Installez et initialisez la Google Cloud CLI, puis définissez le projet contenant vos clusters d'entraînement :
gcloud auth login
gcloud config set project PROJECT_ID
Remplacez PROJECT_ID par l'ID de votre projet.
Rôles requis
Pour obtenir les autorisations nécessaires pour créer la métrique basée sur les journaux et le tableau de bord, demandez à votre administrateur de vous accorder les rôles IAM suivants sur le projet :
-
Créer la métrique basée sur les journaux:
Rédacteur de configuration des journaux (
roles/logging.configWriter) -
Créer le tableau de bord:
Éditeur de configuration du tableau de bord Monitoring (
roles/monitoring.dashboardEditor)
Pour en savoir plus sur l'attribution de rôles, consultez Gérer l'accès aux projets, aux dossiers et aux organisations.
Ces rôles prédéfinis contiennent les autorisations requises pour créer la métrique basée sur les journaux et le tableau de bord. Pour connaître les autorisations exactes requises, développez la section Autorisations requises :
Autorisations requises
Vous devez disposer des autorisations suivantes pour créer la métrique basée sur les journaux et le tableau de bord :
-
Créer la métrique basée sur les journaux :
logging.logMetrics.create -
Créer le tableau de bord :
monitoring.dashboards.create
Vous pouvez également obtenir ces autorisations avec des rôles personnalisés ou d'autres rôles prédéfinis.
Créer la métrique basée sur les journaux
Les événements de résilience sont enregistrés dans les journaux de votre projet, où chaque événement comporte un libellé event_type préfixé par RESILIENCE_EVENT_TYPE_. Pour afficher les événements bruts dans l'explorateur de journaux, utilisez la requête suivante :
labels.event_type=~"RESILIENCE_EVENT_TYPE_.*"
Cloud Monitoring ne peut pas représenter directement les entrées de journal. Vous devez donc d'abord transformer cette requête en métrique basée sur les journaux.
Enregistrez la configuration suivante dans un fichier nommé
resilience_metric.yaml:name: training_cluster_resilience_events description: "Resilience events on training cluster nodes (VM instances)." filter: 'resource.type="gce_instance" AND labels.event_type=~"RESILIENCE_EVENT_TYPE_.*"' metricDescriptor: metricKind: DELTA valueType: INT64 unit: "1" labels: - key: cluster_id valueType: STRING description: "The ID of the training cluster." - key: event_type valueType: STRING description: "The type of resilience event." - key: slurm_job_name valueType: STRING description: "The name of the Slurm job that triggered the resilience event, if applicable." - key: slurm_job_id valueType: STRING description: "The ID of the Slurm job that triggered the resilience event, if applicable." - key: slurm_job_partition valueType: STRING description: "The partition that the resilience event acts on." labelExtractors: cluster_id: "EXTRACT(labels.cluster_id)" event_type: "EXTRACT(labels.event_type)" slurm_job_name: "EXTRACT(labels.slurm_job_name)" slurm_job_id: "EXTRACT(labels.slurm_job_id)" slurm_job_partition: "EXTRACT(labels.slurm_job_partition)"Le champ
labelExtractorscopie les libellés de chaque entrée de journal dans la métrique, ce qui vous permet de décomposer le graphique par type d'événement, par cluster ou par tâche Slurm.Créez la métrique :
gcloud logging metrics create training_cluster_resilience_events \
    --config-from-file=resilience_metric.yaml
Vérifiez que la métrique existe :
gcloud logging metrics describe training_cluster_resilience_eventsVous pouvez également confirmer la métrique dans la Cloud de Confiance console sur la pageMétriques basées sur les journaux.
Créer le tableau de bord
Enregistrez la configuration suivante dans un fichier nommé
resilience_dashboard.json:{ "displayName": "Training Clusters Resilience Dashboard", "mosaicLayout": { "columns": 48, "tiles": [ { "height": 16, "width": 24, "widget": { "title": "Slurm node states", "xyChart": { "chartOptions": { "mode": "COLOR" }, "dataSets": [ { "minAlignmentPeriod": "60s", "plotType": "LINE", "targetAxis": "Y1", "timeSeriesQuery": { "timeSeriesFilter": { "aggregation": { "alignmentPeriod": "60s", "crossSeriesReducer": "REDUCE_SUM", "groupByFields": [ "metric.label.\"state\"" ], "perSeriesAligner": "ALIGN_MEAN" }, "filter": "metric.type=\"hypercomputecluster.googleapis.com/slurm/node_state\" resource.type=\"gce_instance\"" } } } ], "yAxis": { "scale": "LINEAR" } } } }, { "yPos": 16, "height": 16, "width": 24, "widget": { "title": "Resilience events", "xyChart": { "chartOptions": { "mode": "COLOR" }, "dataSets": [ { "minAlignmentPeriod": "60s", "plotType": "STACKED_BAR", "targetAxis": "Y1", "timeSeriesQuery": { "timeSeriesFilter": { "aggregation": { "alignmentPeriod": "60s", "crossSeriesReducer": "REDUCE_COUNT", "groupByFields": [ "metric.label.\"event_type\"" ], "perSeriesAligner": "ALIGN_COUNT" }, "filter": "metric.type=\"logging.googleapis.com/user/training_cluster_resilience_events\" resource.type=\"gce_instance\"" } } } ], "yAxis": { "scale": "LINEAR" } } } } ] } }Si vous avez donné un autre nom à la métrique basée sur les journaux dans la section précédente, modifiez le filtre
logging.googleapis.com/user/pour qu'il corresponde.Créez le tableau de bord :
gcloud monitoring dashboards create \
    --config-from-file=resilience_dashboard.json
Dans la Cloud de Confiance console, accédez à la page Tableaux de bord, puis, sous Mes tableaux de bord, ouvrez Tableau de bord de résilience des clusters d'entraînement. L'affichage du tableau de bord peut prendre environ une minute.
Dépannage
Les sections suivantes décrivent les problèmes les plus susceptibles de se produire après la création de la métrique et du tableau de bord.
Le graphique "Événements de résilience" est vide
Une métrique basée sur les journaux n'est pas renseignée de manière rétroactive. Elle ne comptabilise que les entrées de journal qui arrivent après la création de la métrique. Comme l'explique la présentation des métriques basées sur les journaux, une métrique n'est pas renseignée de manière rétroactive avec les données des entrées de journal qui sont déjà présentes dans Cloud Logging.
Si des événements de résilience se sont produits depuis que vous avez créé la métrique et que le graphique est toujours vide, vérifiez que les événements sont présents dans l'explorateur de journaux en exécutant la requête dans Créer la métrique basée sur les journaux.
Le graphique "États des nœuds Slurm" ne contient pas tous les clusters
La métrique hypercomputecluster.googleapis.com/slurm/node_state n'est signalée que par les clusters exécutant une version suffisamment récente du logiciel de cluster. Si un
cluster n'apparaît pas dans le graphique,
mettez-le à jour
, puis vérifiez à nouveau le graphique.
Le graphique "États des nœuds Slurm" n'affiche pas les nœuds de connexion
ce qui est tout à fait normal. Les nœuds de connexion n'ont pas d'état Slurm, tel que idle ou mixed. Ils ne signalent donc pas la métrique slurm/node_state.
Le graphique "Événements de résilience" surestime le nombre d'événements
Cloud Logging traite chaque entrée de journal au moins une fois. Par conséquent, une erreur interne temporaire peut entraîner le comptage d'une entrée plusieurs fois. Pour en savoir plus, consultez Résoudre les problèmes liés aux métriques basées sur les journaux.
Les entrées de journal elles-mêmes sont la source de vérité. Pour obtenir un nombre exact sur une période donnée, interrogez les événements dans l'explorateur de journaux au lieu de les lire dans le graphique.