

Mit dem Tool „Computernutzung“ von Gemini können Sie Ihre Anwendungen so konfigurieren, dass sie mit dem Browser interagieren und Aufgaben darin automatisieren. Wenn die Computernutzung aktiviert ist, verwendet das Modell Screenshots, um Informationen über den Computerbildschirm zu erhalten, und führt Aktionen aus, indem es bestimmte UI-Aktionen wie Mausklicks und Tastatureingaben generiert.
Mit der Computernutzung können Sie Agenten erstellen, die Folgendes können:
- Automatisieren Sie wiederkehrende Dateneingaben oder das Ausfüllen von Formularen auf Websites.
- Websites aufrufen, um Informationen zu sammeln
- Unterstützung von Nutzern durch Ausführen von Aktionsfolgen in Webanwendungen.
In diesem Leitfaden werden die folgenden Themen behandelt:
- So funktioniert die Computernutzung
- Computernutzung aktivieren
- Anfragen senden, Antworten empfangen und Agentenschleifen erstellen
- Unterstützte Computeraktionen
- Support für Sicherheit
- Preise für Vorabversionen
Ähnlich wie bei Funktionsaufrufen müssen Sie den clientseitigen Anwendungscode schreiben, um den Funktionsaufruf für die Computernutzung zu empfangen und die entsprechenden Aktionen auszuführen.
In diesem Leitfaden wird davon ausgegangen, dass Sie das Google Gen AI SDK for Python verwenden und mit der Playwright API vertraut sind. Die Computernutzung befindet sich in der Vorabversion und wird während dieser Vorschau nicht in den anderen SDK-Sprachen oder in der Cloud de Confiance Console unterstützt.
Die Referenzimplementierung für die Computernutzung finden Sie auf GitHub.
Unterstützte Modelle
Die Computernutzung wird für die folgenden Modelle unterstützt:
Klicken, um unterstützte Modelle einzublenden
So funktioniert die Computernutzung
Anstatt Textantworten zu generieren, bestimmt die Computernutzung, wann bestimmte UI-Aktionen wie Mausklicks ausgeführt werden sollen, und gibt die erforderlichen Parameter zurück, um diese Aktionen auszuführen. Sie müssen den clientseitigen Anwendungscode schreiben, um die function_call für die Computernutzung zu empfangen und die entsprechenden Aktionen auszuführen.
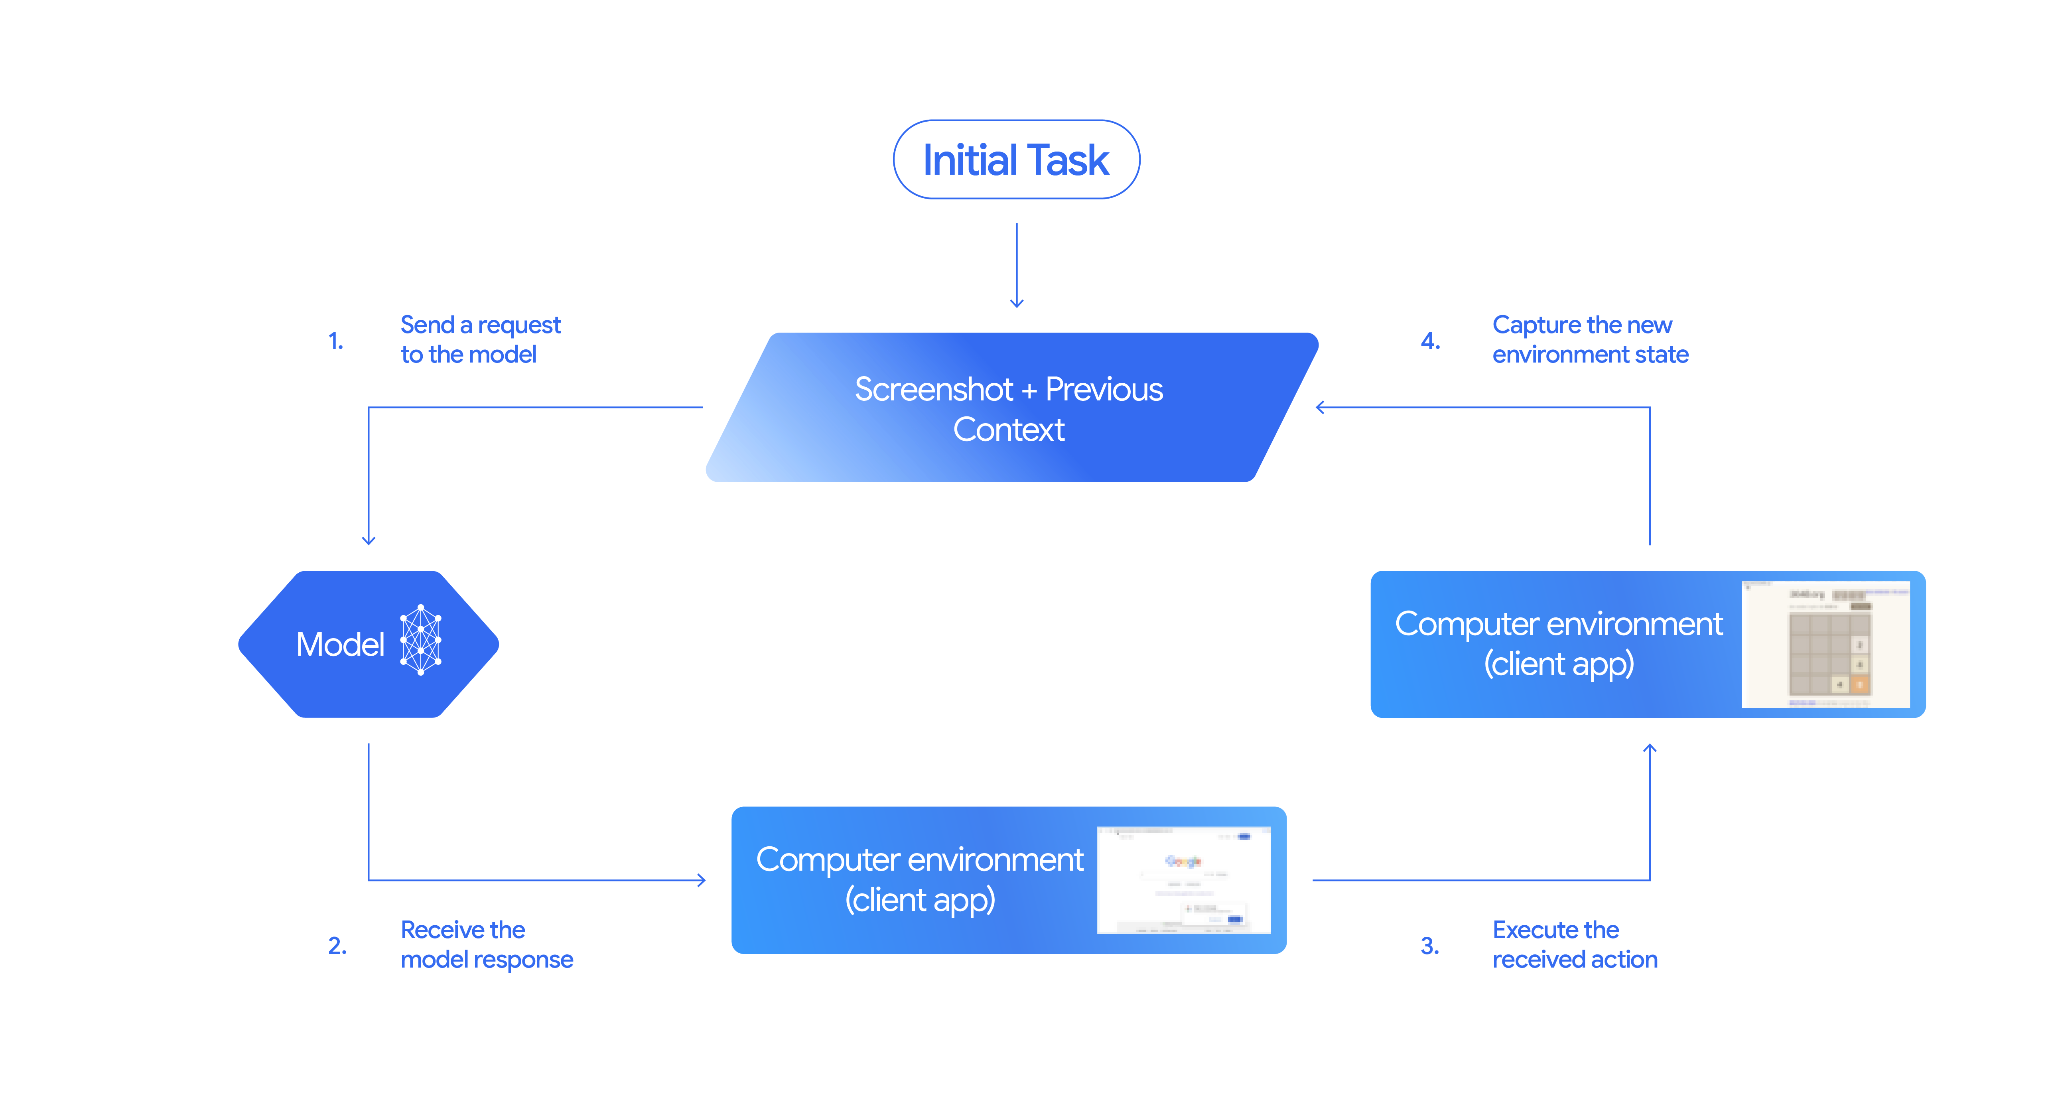
Die Interaktionen bei der Computernutzung folgen einem Agentenschleifenprozess:
Anfrage an das Modell senden
- Fügen Sie Ihrer API-Anfrage die Computernutzung (und optional zusätzliche Tools) hinzu.
- Senden Sie einen Prompt mit der Nutzeranfrage und einem Screenshot, der den aktuellen Status der GUI darstellt, an das Modell.
Modellantwort erhalten
- Das Modell analysiert die Nutzeranfrage und den Screenshot und generiert eine Antwort, die einen vorgeschlagenen
function_callenthält, der eine UI-Aktion darstellt (z. B. „Klicken Sie auf die Koordinaten (x,y)“ oder „Geben Sie ‚Text‘ ein“). Eine Liste aller Aktionen, die Sie mit dem Modell verwenden können, finden Sie unter Unterstützte Aktionen. - Die API-Antwort kann auch eine
safety_responsevon einem internen Sicherheitssystem enthalten, das die vorgeschlagene Aktion des Modells geprüft hat. In diesemsafety_responsewird die Aktion so klassifiziert:- Regulär oder zulässig:Die Aktion gilt als sicher. Dies kann auch dadurch dargestellt werden, dass kein
safety_responsevorhanden ist. - Bestätigung erforderlich: Das Modell ist im Begriff, eine Aktion auszuführen, die riskant sein könnte (z. B. das Klicken auf ein Cookie-Banner).
- Regulär oder zulässig:Die Aktion gilt als sicher. Dies kann auch dadurch dargestellt werden, dass kein
- Das Modell analysiert die Nutzeranfrage und den Screenshot und generiert eine Antwort, die einen vorgeschlagenen
Empfangene Aktion ausführen
- Ihr clientseitiger Code empfängt die
function_callund alle zugehörigensafety_response. - Wenn der
safety_responseregulär oder zulässig ist (oder wenn keinsafety_responsevorhanden ist), kann Ihr clientseitiger Code die angegebenefunction_callin Ihrer Zielumgebung (z. B. einem Webbrowser) ausführen. - Wenn die
safety_responseeine erforderliche Bestätigung angibt, muss Ihre Anwendung den Endnutzer zur Bestätigung auffordern, bevor diefunction_callausgeführt wird. Wenn der Nutzer bestätigt, fahre mit der Ausführung der Aktion fort. Wenn der Nutzer die Aktion ablehnt, führe sie nicht aus.
- Ihr clientseitiger Code empfängt die
Neuen Umgebungsstatus erfassen
- Wenn die Aktion ausgeführt wurde, erstellt Ihr Client einen neuen Screenshot der GUI und der aktuellen URL, um sie als Teil einer
function_responsean das Modell zurückzusenden. - Wenn eine Aktion vom Sicherheitssystem blockiert oder vom Nutzer nicht bestätigt wurde, kann Ihre Anwendung eine andere Art von Feedback an das Modell senden oder die Interaktion beenden.
- Wenn die Aktion ausgeführt wurde, erstellt Ihr Client einen neuen Screenshot der GUI und der aktuellen URL, um sie als Teil einer
Eine neue Anfrage wird mit dem aktualisierten Status an das Modell gesendet. Der Prozess wird ab Schritt 2 wiederholt. Das Modell verwendet den neuen Screenshot (falls vorhanden) und das laufende Ziel, um die nächste Aktion vorzuschlagen. Die Schleife wird fortgesetzt, bis die Aufgabe abgeschlossen ist, ein Fehler auftritt oder der Prozess beendet wird (z. B. wenn eine Antwort durch Sicherheitsfilter oder eine Nutzerentscheidung blockiert wird).
Das folgende Diagramm veranschaulicht, wie die Computernutzung funktioniert:
Computernutzung aktivieren
Wenn Sie die Computernutzung aktivieren möchten, muss Ihre Anwendung eines der unterstützten Modelle verwenden. Fügen Sie die Computernutzung dann der Liste der aktivierten Tools hinzu:
Python
from google import genai
from google.genai import types
from google.genai.types import Content, Part, FunctionResponse

client = genai.Client()

# Add computer use to the list of tools
generate_content_config = genai.types.GenerateContentConfig(
    tools=[
        types.Tool(
            computer_use=types.ComputerUse(
                environment=types.Environment.ENVIRONMENT_BROWSER,
                )
              ),
            ]
          )

# Example request using computer use
contents = [
    Content(
        role="user",
        parts=[
            Part(text="Go to google.com and search for 'weather in New York'"),
          ],
        )
      ]

response = client.models.generate_content(
    model="gemini-3-flash-preview",
    contents=contents,
    config=generate_content_config,
  )
Anfrage senden
Nachdem Sie das Tool zur Computernutzung konfiguriert haben, senden Sie einen Prompt an das Modell, der das Ziel des Nutzers und einen ersten Screenshot der GUI enthält.
Optional können Sie auch Folgendes hinzufügen:
- Ausgeschlossene Aktionen: Wenn es Aktionen aus der Liste der unterstützten UI-Aktionen gibt, die das Modell nicht ausführen soll, geben Sie diese Aktionen in der
excluded_predefined_functionsan. - Benutzerdefinierte Funktionen: Sie können zusätzlich zur Computernutzung benutzerdefinierte Funktionen einbinden.
Im folgenden Beispielcode wird die Computernutzung aktiviert und die Anfrage an das Modell gesendet:
Python
from google import genai
from google.genai import types
from google.genai.types import Content, Part

client = genai.Client()

# Specify predefined functions to exclude (optional)
excluded_functions = ["drag_and_drop"]

# Configuration for computer use with browser environment
generate_content_config = genai.types.GenerateContentConfig(
    tools=[
        # 1. Computer Use tool with browser environment
        types.Tool(
            computer_use=types.ComputerUse(
                environment=types.Environment.ENVIRONMENT_BROWSER,
                # Optional: Exclude specific predefined functions
                excluded_predefined_functions=excluded_functions
                )
              ),
        # 2. Optional: Custom user-defined functions (need to defined above)
        # types.Tool(
           # function_declarations=custom_functions
           #   )
    ],
)

# Create the content with user message
contents: list[Content] = [
    Content(
        role="user",
        parts=[
            Part(text="Search for highly rated smart fridges with touchscreen, 2 doors, around 25 cu ft, priced below 4000 dollars on Google Shopping. Create a bulleted list of the 3 cheapest options in the format of name, description, price in an easy-to-read layout."),
            # Optional: include a screenshot of the initial state
            # Part.from_bytes(
                 # data=screenshot_image_bytes,
                 # mime_type='image/png',
            # ),
        ],
    )
]

# Generate content with the configured settings
response = client.models.generate_content(
    model='gemini-3-flash-preview',
    contents=contents,
    config=generate_content_config,
)

# Print the response output
print(response.text)
Sie können auch benutzerdefinierte Funktionen einbinden, um die Funktionalität des Modells zu erweitern. Informationen dazu, wie Sie die Computernutzung für mobile Anwendungsfälle konfigurieren können, indem Sie Aktionen wie open_app, long_press_at und go_home hinzufügen und browserspezifische Aktionen ausschließen, finden Sie unter Computernutzung für mobile Anwendungsfälle verwenden.
Antworten erhalten
Das Modell antwortet mit einem oder mehreren FunctionCalls, wenn es feststellt, dass UI-Aktionen oder benutzerdefinierte Funktionen erforderlich sind, um die Aufgabe abzuschließen. Ihr Anwendungscode muss diese Aktionen parsen, ausführen und die Ergebnisse erfassen.
Die Computernutzung unterstützt parallele Funktionsaufrufe. Das bedeutet, dass das Modell in einem einzigen Durchlauf mehrere unabhängige Aktionen zurückgeben kann.
{
  "content": {
    "parts": [
      {
        "text": "I will type the search query into the search bar. The search bar is in the center of the page."
      },
      {
        "function_call": {
          "name": "type_text_at",
          "args": {
            "x": 371,
            "y": 470,
            "text": "highly rated smart fridges with touchscreen, 2 doors, around 25 cu ft, priced below 4000 dollars on Google Shopping",
            "press_enter": true
          }
        }
      }
    ]
  }
}
Je nach Aktion kann die API-Antwort auch ein safety_response-Objekt enthalten:
{
  "content": {
    "parts": [
      {
        "text": "I have evaluated step 2. It seems Google detected unusual traffic and is asking me to verify I'm not a robot. I need to click the 'I'm not a robot' checkbox located near the top left (y=98, x=95)."
      },
      {
        "function_call": {
          "name": "click_at",
          "args": {
            "x": 60,
            "y": 100,
            "safety_decision": {
              "explanation": "I have encountered a CAPTCHA challenge that requires interaction. I need you to complete the challenge by clicking the 'I'm not a robot' checkbox and any subsequent verification steps.",
              "decision": "require_confirmation"
            }
          }
        }
      }
    ]
  }
}
Empfangene Aktionen ausführen
Nachdem Sie eine Antwort erhalten haben, muss das Modell die empfangenen Aktionen ausführen.
Der folgende Code extrahiert Funktionsaufrufe aus einer Gemini-Antwort, konvertiert Koordinaten aus dem Bereich 0–1000 in tatsächliche Pixel, führt Browseraktionen mit Playwright aus und gibt den Erfolgs- oder Fehlerstatus für jede Aktion zurück:
import time
from typing import Any, List, Tuple


def normalize_x(x: int, screen_width: int) -> int:
    """Convert normalized x coordinate (0-1000) to actual pixel coordinate."""
    return int(x / 1000 * screen_width)


def normalize_y(y: int, screen_height: int) -> int:
    """Convert normalized y coordinate (0-1000) to actual pixel coordinate."""
    return int(y / 1000 * screen_height)


def execute_function_calls(response, page, screen_width: int, screen_height: int) -> List[Tuple[str, Any]]:
    """
    Extract and execute function calls from Gemini response.

    Args:
        response: Gemini API response object
        page: Playwright page object
        screen_width: Screen width in pixels
        screen_height: Screen height in pixels

    Returns:
        List of tuples: [(function_name, result), ...]
    """
    # Extract function calls and thoughts from the model's response
    candidate = response.candidates[0]
    function_calls = []
    thoughts = []

    for part in candidate.content.parts:
        if hasattr(part, 'function_call') and part.function_call:
            function_calls.append(part.function_call)
        elif hasattr(part, 'text') and part.text:
            thoughts.append(part.text)

    if thoughts:
        print(f"Model Reasoning: {' '.join(thoughts)}")

    # Execute each function call
    results = []
    for function_call in function_calls:
        result = None

        try:
            if function_call.name == "open_web_browser":
                print("Executing open_web_browser")
                # Browser is already open via Playwright, so this is a no-op
                result = "success"

            elif function_call.name == "click_at":
                actual_x = normalize_x(function_call.args["x"], screen_width)
                actual_y = normalize_y(function_call.args["y"], screen_height)

                print(f"Executing click_at: ({actual_x}, {actual_y})")
                page.mouse.click(actual_x, actual_y)
                result = "success"

            elif function_call.name == "type_text_at":
                actual_x = normalize_x(function_call.args["x"], screen_width)
                actual_y = normalize_y(function_call.args["y"], screen_height)
                text = function_call.args["text"]
                press_enter = function_call.args.get("press_enter", False)
                clear_before_typing = function_call.args.get("clear_before_typing", True)

                print(f"Executing type_text_at: ({actual_x}, {actual_y}) text='{text}'")

                # Click at the specified location
                page.mouse.click(actual_x, actual_y)
                time.sleep(0.1)

                # Clear existing text if requested
                if clear_before_typing:
                    page.keyboard.press("Control+A")
                    page.keyboard.press("Backspace")

                # Type the text
                page.keyboard.type(text)

                # Press enter if requested
                if press_enter:
                    page.keyboard.press("Enter")

                result = "success"

            else:
                # For any functions not parsed above
                print(f"Unrecognized function: {function_call.name}")
                result = "unknown_function"

        except Exception as e:
            print(f"Error executing {function_call.name}: {e}")
            result = f"error: {str(e)}"

        results.append((function_call.name, result))

    return results
Wenn der zurückgegebene safety_decision-Wert require_confirmation ist, müssen Sie den Nutzer um Bestätigung bitten, bevor Sie die Aktion ausführen. Gemäß den Nutzungsbedingungen ist es nicht zulässig, Anfragen zur Bestätigung durch Menschen zu umgehen.
Im Folgenden wird dem vorherigen Code Sicherheitslogik hinzugefügt:
import termcolor


def get_safety_confirmation(safety_decision):
    """Prompt user for confirmation when safety check is triggered."""
    termcolor.cprint("Safety service requires explicit confirmation!", color="red")
    print(safety_decision["explanation"])

    decision = ""
    while decision.lower() not in ("y", "n", "ye", "yes", "no"):
        decision = input("Do you wish to proceed? [Y]es/[N]o\n")

    if decision.lower() in ("n", "no"):
        return "TERMINATE"
    return "CONTINUE"


def execute_function_calls(response, page, screen_width: int, screen_height: int):
    # ... Extract function calls from response ...

    for function_call in function_calls:
        extra_fr_fields = {}

        # Check for safety decision
        if 'safety_decision' in function_call.args:
            decision = get_safety_confirmation(function_call.args['safety_decision'])
            if decision == "TERMINATE":
                print("Terminating agent loop")
                break
            extra_fr_fields["safety_acknowledgement"] = "true"

        # ... Execute function call and append to results ...
Neuen Status erfassen
Senden Sie nach dem Ausführen der Aktionen das Ergebnis der Funktionsausführung an das Modell zurück, damit es diese Informationen zum Generieren der nächsten Aktion verwenden kann. Wenn mehrere Aktionen (parallele Aufrufe) ausgeführt wurden, müssen Sie für jede Aktion im nachfolgenden Nutzer-Turn einen FunctionResponse senden. Bei benutzerdefinierten Funktionen sollte FunctionResponse den Rückgabewert der ausgeführten Funktion enthalten.
function_response_parts = []

for name, result in results:
    # Take screenshot after each action
    screenshot = page.screenshot()
    current_url = page.url

    function_response_parts.append(
        FunctionResponse(
            name=name,
            response={"url": current_url},  # Include safety acknowledgement
            parts=[
                types.FunctionResponsePart(
                    inline_data=types.FunctionResponseBlob(
                       mime_type="image/png", data=screenshot
                    )
                )
            ]
        )
    )

# Create the user feedback content with all responses
user_feedback_content = Content(
    role="user",
    parts=function_response_parts
)

# Append this feedback to the 'contents' history list for the next API call
contents.append(user_feedback_content)
Agentenschleife erstellen
Kombinieren Sie die vorherigen Schritte in einer Schleife, um mehrstufige Interaktionen zu ermöglichen. Die Schleife muss parallele Funktionsaufrufe verarbeiten. Denken Sie daran, den Unterhaltungsverlauf (Inhaltsarray) korrekt zu verwalten, indem Sie sowohl Modellantworten als auch Ihre Funktionsantworten anhängen.
Python
from google import genai
from google.genai.types import Content, Part
from playwright.sync_api import sync_playwright


def has_function_calls(response):
    """Check if response contains any function calls."""
    candidate = response.candidates[0]
    return any(hasattr(part, 'function_call') and part.function_call
               for part in candidate.content.parts)


def main():
    client = genai.Client()

    # ... (config setup from "Send a request to model" section) ...

    with sync_playwright() as p:
        browser = p.chromium.launch(headless=False)
        page = browser.new_page()
        page.goto("https://www.google.com")

        screen_width, screen_height = 1920, 1080

        # ... (initial contents setup from "Send a request to model" section) ...

        # Agent loop: iterate until model provides final answer
        for iteration in range(10):
            print(f"\nIteration {iteration + 1}\n")

            # 1. Send request to model (see "Send a request to model" section)
            response = client.models.generate_content(
                model='gemini-3-flash-preview',
                contents=contents,
                config=generate_content_config,
            )

            contents.append(response.candidates[0].content)

            # 2. Check if done - no function calls means final answer
            if not has_function_calls(response):
                print(f"FINAL RESPONSE:\n{response.text}")
                break

            # 3. Execute actions (see "Execute the received actions" section)
            results = execute_function_calls(response, page, screen_width, screen_height)
            time.sleep(1)

            # 4. Capture state and create feedback (see "Capture the New State" section)
            contents.append(create_feedback(results, page))

        input("\nPress Enter to close browser...")
        browser.close()


if __name__ == "__main__":
    main()
Gemini 3.5 Flash oder höher und Anwendungsfälle für Mobilgeräte oder Computer
Die Computernutzung unterstützt das Festlegen von mobilen (ENVIRONMENT_MOBILE), Desktop- (ENVIRONMENT_DESKTOP) oder Browser-Umgebungen (ENVIRONMENT_BROWSER). Der Standardwert ist ENVIRONMENT_BROWSER.
In den folgenden Beispielen wird gezeigt, wie Sie die Ausführungsumgebung für die Computernutzung mit Gemini 3.5 Flash oder höher konfigurieren:
REST API
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: Ihre Projekt-ID.
HTTP-Methode und URL:
POST https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent
JSON-Text anfordern:
{
  "contents": [
    {
      "role": "user",
      "parts": {
        "text": "find me a flight from SF to Hawaii on Jun 30th, coming back on Jul 6th. start by navigating directly to flights.google.com"
      }
    }
  ],
  "generation_config": {
    "candidateCount": 1
  },
  "tools": [
    {
      "computer_use": {
        "environment": "ENVIRONMENT_BROWSER"
      }
    }
  ]
}
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten einen erfolgreichen Statuscode (2xx) und eine leere Antwort als Ausgabe erhalten.
Python
Für das folgende Beispiel ist python-genai Version 2.7.0 oder höher erforderlich.
from google import genai
from google.genai.types import (
    Part,
    GenerateContentConfig,
    Content,
    Tool,
    ComputerUse,
    Environment,
    ThinkingConfig,
)
client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.6-flash",
    contents=[
        Content(
            role="user",
            parts=[
                Part(text="find me a flight from SF to Hawaii on Jun 30th, coming back on Jul 6th"),
            ],
        )
    ],
    config=GenerateContentConfig(
        temperature=1,
        top_p=0.95,
        top_k=40,
        max_output_tokens=8192,
        tools=[
            Tool(
                computer_use=ComputerUse(
                    environment=Environment.ENVIRONMENT_MOBILE
                ),
            ),
        ],
        thinking_config=ThinkingConfig(
            include_thoughts=True
        ),
    )
)
Unterstützte Aktionen
Mit dem Tool zur Computernutzung kann das Modell die folgenden Aktionen über einen FunctionCall anfordern. Ihr clientseitiger Code muss die Ausführungslogik für diese Aktionen implementieren. Beispiele finden Sie in der Referenzimplementierung. In der folgenden Tabelle sind die unterstützten Aktionen für die Browserumgebung aufgeführt.
Gemini 3 Flash und Gemini 3.5 Flash haben unterschiedliche FunctionCall-Namen.
Gemini 3.5 Flash
Gemini 3.5 Flash: Je nach ausgewählter Umgebung haben Sie Zugriff auf verschiedene Funktionsaufrufe:Mobile Umgebung
| Befehlsname | Beschreibung | Argumente (im Funktionsaufruf) |
|---|---|---|
open_app |
Öffnet eine Anwendung anhand ihres Namens. | intent: str |
click |
Klickt mit der linken Maustaste auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
list_apps |
Listet die auf dem Gerät verfügbaren Anwendungen auf und gibt deren Namen und Paketnamen zurück. | intent: str |
wait |
Wartet die angegebene Anzahl von Sekunden. |
intent: strseconds: int(optional, Standardwert: 1)
|
go_back |
Kehrt zur vorherigen Webseite im Browserverlauf zurück. | intent: str |
type |
Gibt Text ein. |
text: strintent: strpress_enter: bool(Optional, default false)
|
drag_and_drop |
Zieht das Element von start_y und start_x zu end_y und end_x |
start_y: int (0-999)start_x: int (0-999)end_y: int (0-999)end_x: int (0-999)intent: str
|
long_press |
Führt ein langes Drücken an einer bestimmten y- (0–999) und x-Koordinate (0–999) auf dem Bildschirm aus. |
y: int (0–999)x: int (0–999)intent: strseconds: int (optional, Standardwert: 2)
|
press_key |
Drückt die angegebene Taste und lässt sie wieder los. |
key: strintent: str
|
take_screenshot |
Gibt einen Screenshot des aktuellen Bildschirms zurück. | intent: str |
Desktopumgebung
| Befehlsname | Beschreibung | Argumente (im Funktionsaufruf) |
|---|---|---|
click |
Klickt mit der linken Maustaste auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
double_click |
Doppelklickt auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
triple_click |
Dreifachklicks auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
middle_click |
Klickt mit der mittleren Maustaste auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
right_click |
Klickt mit der rechten Maustaste auf die Koordinate. |
y: int (0–999)x: int (0–999)intent: str
|
mouse_down |
Hält die Maustaste an der Koordinate gedrückt. |
y: int (0–999)x: int (0–999)intent: str
|
mouse_up |
Lässt die Maustaste an der Koordinate los. |
y: int (0–999)x: int (0–999)intent: str
|
move |
Bewegt den Cursor an die angegebene Position. |
y: int (0–999)x: int (0–999)intent: str
|
type |
Gibt Text ein. |
text: strintent: strpress_enter: bool(Optional, default false)
|
drag_and_drop |
Zieht ein Element von start_y und start_x zu end_y und end_x. |
start_y: int (0-999)start_x: int (0-999)end_y: int (0-999)end_x: int (0-999)intent: str
|
wait |
Warten Sie die angegebene Anzahl von Sekunden. |
intent: strseconds: int(optional, Standardwert: 1)
|
press_key |
Drückt die angegebene Taste und lässt sie wieder los. |
key: strintent: str
|
key_down |
Drückt die angegebene Taste und hält sie gedrückt. |
key: strintent: str
|
key_up |
Gibt die angegebene Taste frei. |
key: strintent: str
|
hotkey |
Drückt die angegebene Tastenkombination. |
keys: List[str]intent: str
|
take_screenshot |
Gibt einen Screenshot des aktuellen Bildschirms zurück. | intent: str |
scroll |
Scrollt an einer Koordinate um einen Pixelabstand nach oben, unten, links oder rechts. |
y: int (0-999)x: int (0-999)direction: str ("up", "down", "left", "right")intent: strmagnitude_in_pixels: int (0-999, optional, Standardwert 300)
|
Gemini 3 Flash
| Befehlsname | Beschreibung | Argumente (im Funktionsaufruf) | Beispiel für einen Funktionsaufruf |
|---|---|---|---|
| open_web_browser | Öffnet den Webbrowser. | Keine | {"name": "open_web_browser", "args": {}} |
| wait_5_seconds | Pausiert die Ausführung für 5 Sekunden, damit dynamische Inhalte geladen oder Animationen abgeschlossen werden können. | Keine | {"name": "wait_5_seconds", "args": {}} |
| go_back | Ruft die vorherige Seite im Browserverlauf auf. | Keine | {"name": "go_back", "args": {}} |
| go_forward | Navigiert zur nächsten Seite im Browserverlauf. | Keine | {"name": "go_forward", "args": {}} |
| search | Ruft die Startseite der Standardsuchmaschine auf (z. B. Google). Nützlich, um eine neue Suchaufgabe zu starten. | Keine | {"name": "search", "args": {}} |
| navigate | Leitet den Browser direkt zur angegebenen URL weiter. | url: str |
{"name": "navigate", "args": {"url": "https://www.wikipedia.org"}}
|
| click_at | Klickt auf eine bestimmte Koordinate auf der Webseite. Die x- und y-Werte basieren auf einem 1000x1000-Raster und werden auf die Bildschirmabmessungen skaliert. | y: int (0–999), x: int (0–999) |
{"name": "click_at", "args": {"y": 300, "x": 500}}
|
| hover_at | 521963309 Bewegt den Mauszeiger auf eine bestimmte Koordinate auf der Webseite. Nützlich zum Einblenden von Untermenüs. x und y basieren auf einem 1000x1000-Raster. | y: int (0–999) x: int (0–999) |
{"name": "hover_at", "args": {"y": 150, "x": 250}}
|
| type_text_at | Gibt Text an einer bestimmten Koordinate ein. Standardmäßig wird das Feld zuerst gelöscht und nach der Eingabe die Eingabetaste gedrückt. Diese Optionen können jedoch deaktiviert werden. x und y basieren auf einem 1000x1000-Raster. |
y: int (0-999), x: int (0-999),
text: str, press_enter: bool (Optional,
Standardwert True), clear_before_typing: bool (Optional,
Standardwert True)
|
{"name": "type_text_at", "args": {"y": 250, "x": 400,
              "text": "search query", "press_enter": false}}
|
| key_combination | Drückt Tasten oder Tastenkombinationen wie „Strg + C“ oder „Eingabe“. Nützlich zum Auslösen von Aktionen (z. B. Senden eines Formulars mit der Eingabetaste) oder Zwischenablagevorgängen. |
keys: str (z. B. „enter“, „control+c“). Eine vollständige Liste der zulässigen Schlüssel finden Sie in der API-Referenz.
|
{"name": "key_combination", "args": {"keys":
              "Control+A"}}
|
| scroll_document | Scrollt die gesamte Webseite nach oben, unten, links oder rechts. | direction: str ("up", "down", "left" oder "right") |
{"name": "scroll_document", "args": {"direction": "down"}}
|
| scroll_at | Scrollt ein bestimmtes Element oder einen bestimmten Bereich an der Koordinate (x, y) in die angegebene Richtung um einen bestimmten Betrag. Koordinaten und Größe (Standardwert: 800) basieren auf einem 1000x1000-Raster. |
y: int (0–999), x: int (0–999),
direction: str ("up", "down", "left", "right"),
magnitude: int (0–999, optional, Standardwert 800)
|
{"name": "scroll_at", "args": {"y": 500, "x": 500,
              "direction": "down", "magnitude": 400}}
|
| drag_and_drop | Zieht ein Element von einer Startkoordinate (x, y) und legt es an einer Zielkoordinate (destination_x, destination_y) ab. Alle Koordinaten basieren auf einem 1000 x 1000-Raster. |
y: int (0-999), x: int (0-999),
destination_y: int (0-999),
destination_x: int (0-999)
|
{"name": "drag_and_drop", "args": {"y": 100, "x": 100,
              "destination_y": 500, "destination_x": 500}}
|
Sicherheit
In diesem Abschnitt werden die Sicherheitsmaßnahmen beschrieben, die das Tool zur Computernutzung bietet, um die Kontrolle durch den Nutzer und die Sicherheit zu verbessern. Außerdem werden Best Practices zur Minimierung potenzieller neuer Risiken beschrieben, die das Tool mit sich bringen könnte.
Sicherheitsentscheidung bestätigen
Je nach Aktion kann die Antwort des Modells einen safety_decision von einem internen Sicherheitssystem enthalten. Mit dieser Entscheidung wird die vom Tool vorgeschlagene Aktion auf Sicherheit überprüft.
{
  "content": {
    "parts": [
      {
        "text": "I have evaluated step 2. It seems Google detected unusual traffic and is asking me to verify I'm not a robot. I need to click the 'I'm not a robot' checkbox located near the top left (y=98, x=95)."
      },
      {
        "function_call": {
          "name": "click_at",
          "args": {
            "x": 60,
            "y": 100,
            "safety_decision": {
              "explanation": "I have encountered a CAPTCHA challenge that requires interaction. I need you to complete the challenge by clicking the 'I'm not a robot' checkbox and any subsequent verification steps.",
              "decision": "require_confirmation"
            }
          }
        }
      }
    ]
  }
}
Wenn der safety_decision require_confirmation ist, müssen Sie den Endnutzer um Bestätigung bitten, bevor Sie die Aktion ausführen.
Im folgenden Codebeispiel wird der Endnutzer vor dem Ausführen der Aktion um Bestätigung gebeten. Wenn der Nutzer die Aktion nicht bestätigt, wird die Schleife beendet. Wenn der Nutzer die Aktion bestätigt, wird sie ausgeführt und das Feld safety_acknowledgement wird als True markiert.
import termcolor

def get_safety_confirmation(safety_decision):
    """Prompt user for confirmation when safety check is triggered."""
    termcolor.cprint("Safety service requires explicit confirmation!", color="red")
    print(safety_decision["explanation"])

    decision = ""
    while decision.lower() not in ("y", "n", "ye", "yes", "no"):
        decision = input("Do you wish to proceed? [Y]es/[N]o\n")

    if decision.lower() in ("n", "no"):
        return "TERMINATE"
    return "CONTINUE"

def execute_function_calls(response, page, screen_width: int, screen_height: int):

    # ... Extract function calls from response ...

    for function_call in function_calls:
        extra_fr_fields = {}

        # Check for safety decision
        if 'safety_decision' in function_call.args:
            decision = get_safety_confirmation(function_call.args['safety_decision'])
            if decision == "TERMINATE":
                print("Terminating agent loop")
                break
            extra_fr_fields["safety_acknowledgement"] = "true" # Safety acknowledgement

        # ... Execute function call and append to results ...
Wenn der Nutzer die Bestätigung erteilt, müssen Sie die Sicherheitsbestätigung in Ihre FunctionResponse aufnehmen.
function_response_parts.append(
    FunctionResponse(
        name=name,
        response={"url": current_url,
                  **extra_fr_fields},  # Include safety acknowledgement
        parts=[
            types.FunctionResponsePart(
                inline_data=types.FunctionResponseBlob(
                    mime_type="image/png", data=screenshot
                )
             )
           ]
         )
       )
Erkennung von Prompt Injection
Die Computernutzung in Gemini 3.5 Flash oder höher unterstützt einen erweiterten Sicherheitsmechanismus, um Prompt-Injection-Angriffe zu erkennen. Wenn diese Funktion aktiviert ist, wird geprüft, ob ein enthaltener Screenshot das Potenzial hat, einen Prompt-Injection-Angriff auszulösen. Sie können diese Funktion in der Konfiguration für die Computernutzung festlegen. Der Standardwert ist false.
In den folgenden Beispielen wird gezeigt, wie Sie die Konfiguration für die Computernutzung aktivieren, um die Prompt-Injection-Erkennung zu aktivieren:
REST API
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: Ihre Projekt-ID.
HTTP-Methode und URL:
POST https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent
JSON-Text anfordern:
{
  "contents": [
    {
      "role": "user",
      "parts": {
        "text": "find me a flight from SF to Hawaii on Jun 30th, coming back on Jul 6th. start by navigating directly to flights.google.com"
      }
    }
  ],
  "generation_config": {
    "candidateCount": 1
  },
  "tools": [
    {
      "computer_use": {
        "environment": "ENVIRONMENT_BROWSER",
        "enable_prompt_injection_detection": true
      }
    }
  ]
}
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten einen erfolgreichen Statuscode (2xx) und eine leere Antwort als Ausgabe erhalten.
Python
Für das folgende Beispiel ist python-genai Version 2.7.0 oder höher erforderlich.
from google import genai
from google.genai.types import (
    Part,
    GenerateContentConfig,
    Content,
    Tool,
    ComputerUse,
    Environment,
    ThinkingConfig,
)
client = genai.Client()

response = client.models.generate_content(
    model="gemini-3.6-flash",
    contents=[
        Content(
            role="user",
            parts=[
                Part(text="find me a flight from SF to Hawaii on Jun 30th, coming back on Jul 6th"),
            ],
        )
    ],
    config=GenerateContentConfig(
        temperature=1,
        top_p=0.95,
        top_k=40,
        max_output_tokens=8192,
        tools=[
            Tool(
                computer_use=ComputerUse(
                    environment=Environment.ENVIRONMENT_MOBILE,
                    enable_prompt_injection_detection=True
                ),
            ),
        ],
        thinking_config=ThinkingConfig(
            include_thoughts=True
        ),
    )
)
Best Practices für die Sicherheit
Die Nutzung von Computern birgt Risiken, die Entwickler beachten sollten:
- Nicht vertrauenswürdige Inhalte und Betrug: Wenn das Modell versucht, das Ziel des Nutzers zu erreichen, kann es sich auf nicht vertrauenswürdige Informationsquellen und Anweisungen auf dem Bildschirm verlassen. Wenn das Ziel des Nutzers beispielsweise darin besteht, ein Pixel Smartphone zu kaufen, und das Modell auf einen Betrugsversuch wie „Kostenloses Pixel, wenn Sie an einer Umfrage teilnehmen“ stößt, besteht die Möglichkeit, dass das Modell die Umfrage ausfüllt.
- Gelegentliche unbeabsichtigte Aktionen:Das Modell kann das Ziel eines Nutzers oder den Inhalt einer Webseite falsch interpretieren, was zu falschen Aktionen wie dem Klicken auf die falsche Schaltfläche oder dem Ausfüllen des falschen Formulars führen kann. Dies kann zu fehlgeschlagenen Aufgaben oder zur Daten-Exfiltration führen.
- Richtlinienverstöße: Die Funktionen der API könnten absichtlich oder unabsichtlich für Aktivitäten verwendet werden, die gegen die Nutzungsbedingungen und Richtlinien von Google verstoßen. Dazu gehören Aktionen, die die Integrität eines Systems beeinträchtigen, die Sicherheit gefährden, Sicherheitsmaßnahmen wie CAPTCHAs umgehen, Medizinprodukte steuern usw.
Um diese Risiken zu minimieren, sollten Sie die folgenden Sicherheitsmaßnahmen und Best Practices implementieren:
- Human-in-the-Loop (HITL):
- Nutzerbestätigung implementieren: Wenn die Sicherheitsantwort „require_confirmation“ enthält, müssen Sie vor der Ausführung eine Nutzerbestätigung implementieren.
- Benutzerdefinierte Sicherheitsanweisungen bereitstellen: Zusätzlich zu den integrierten Bestätigungsprüfungen durch Nutzer können Entwickler optional eine benutzerdefinierte Systemanweisung hinzufügen, die ihre eigenen Sicherheitsrichtlinien durchsetzt. Damit können sie entweder bestimmte Modellaktionen blockieren oder eine Bestätigung durch Nutzer anfordern, bevor das Modell bestimmte risikoreiche, unumkehrbare Aktionen ausführt. Hier ist ein Beispiel für eine benutzerdefinierte Systemanweisung zur Sicherheit, die Sie bei der Interaktion mit dem Modell verwenden können.
Klicken, um ein Beispiel für das Erstellen einer Verbindung anzusehen
## **RULE 1: Seek User Confirmation (USER_CONFIRMATION)**

This is your first and most important check. If the next required action falls
into any of the following categories, you MUST stop immediately, and seek the
user's explicit permission.

**Procedure for Seeking Confirmation:**  * **For Consequential Actions:**
Perform all preparatory steps (e.g., navigating, filling out forms, typing a
message). You will ask for confirmation **AFTER** all necessary information is
entered on the screen, but **BEFORE** you perform the final, irreversible action
(e.g., before clicking "Send", "Submit", "Confirm Purchase", "Share").  * **For
Prohibited Actions:** If the action is strictly forbidden (e.g., accepting legal
terms, solving a CAPTCHA), you must first inform the user about the required
action and ask for their confirmation to proceed.

**USER_CONFIRMATION Categories:**

*   **Consent and Agreements:** You are FORBIDDEN from accepting, selecting, or
    agreeing to any of the following on the user's behalf. You must ask th e
    user to confirm before performing these actions.
    *   Terms of Service
    *   Privacy Policies
    *   Cookie consent banners
    *   End User License Agreements (EULAs)
    *   Any other legally significant contracts or agreements.
*   **Robot Detection:** You MUST NEVER attempt to solve or bypass the
    following. You must ask the user to confirm before performing these actions.
*   CAPTCHAs (of any kind)
    *   Any other anti-robot or human-verification mechanisms, even if you are
        capable.
*   **Financial Transactions:**
    *   Completing any purchase.
    *   Managing or moving money (e.g., transfers, payments).
    *   Purchasing regulated goods or participating in gambling.
*   **Sending Communications:**
    *   Sending emails.
    *   Sending messages on any platform (e.g., social media, chat apps).
    *   Posting content on social media or forums.
*   **Accessing or Modifying Sensitive Information:**
    *   Health, financial, or government records (e.g., medical history, tax
        forms, passport status).
    *   Revealing or modifying sensitive personal identifiers (e.g., SSN, bank
        account number, credit card number).
*   **User Data Management:**
    *   Accessing, downloading, or saving files from the web.
    *   Sharing or sending files/data to any third party.
    *   Transferring user data between systems.
*   **Browser Data Usage:**
    *   Accessing or managing Chrome browsing history, bookmarks, autofill data,
        or saved passwords.
*   **Security and Identity:**
    *   Logging into any user account.
    *   Any action that involves misrepresentation or impersonation (e.g.,
        creating a fan account, posting as someone else).
*   **Insurmountable Obstacles:** If you are technically unable to interact with
    a user interface element or are stuck in a loop you cannot resolve, ask the
    user to take over.
---

## **RULE 2: Default Behavior (ACTUATE)**

If an action does **NOT** fall under the conditions for `USER_CONFIRMATION`,
your default behavior is to **Actuate**.

**Actuation Means:**  You MUST proactively perform all necessary steps to move
the user's request forward. Continue to actuate until you either complete the
non-consequential task or encounter a condition defined in Rule 1.

*   **Example 1:** If asked to send money, you will navigate to the payment
    portal, enter the recipient's details, and enter the amount. You will then
    **STOP** as per Rule 1 and ask for confirmation before clicking the final
    "Send" button.
*   **Example 2:** If asked to post a message, you will navigate to the site,
    open the post composition window, and write the full message. You will then
    **STOP** as per Rule 1 and ask for confirmation before clicking the final
    "Post" button.

    After the user has confirmed, remember to get the user's latest screen
    before continuing to perform actions.

# Final Response Guidelines:
Write final response to the user in these cases:
- User confirmation
- When the task is complete or you have enough information to respond to the user
- Sichere Ausführungsumgebung: Führen Sie Ihren Agenten in einer sicheren Sandbox-Umgebung aus, um seine potenziellen Auswirkungen zu begrenzen (z. B. eine Sandbox-VM, ein Container wie Docker oder ein dediziertes Browserprofil mit eingeschränkten Berechtigungen).
- Eingabebereinigung: Bereinigen Sie alle von Nutzern generierten Texte in Prompts, um das Risiko unbeabsichtigter Anweisungen oder Prompt Injections zu minimieren. Dies ist eine hilfreiche Sicherheitsebene, aber kein Ersatz für eine sichere Ausführungsumgebung.
- Zulassungs- und Sperrlisten: Implementieren Sie Filtermechanismen, um zu steuern, wohin das Modell navigieren und was es tun kann. Eine Sperrliste mit verbotenen Websites ist ein guter Ausgangspunkt, während eine restriktivere Zulassungsliste noch sicherer ist.
- Beobachtbarkeit und Logging: Führen Sie detaillierte Logs für die Fehlerbehebung, Audits und die Incident Response. Ihr Client sollte Prompts, Screenshots, vom Modell vorgeschlagene Aktionen (
function_call), Sicherheitsantworten und alle letztendlich vom Client ausgeführten Aktionen protokollieren.
Preise
Die Computernutzung wird zu denselben Preisen wie Gemini abgerechnet und verwendet dieselben SKUs. Verwenden Sie benutzerdefinierte Metadatenlabels, um die Kosten für die Computernutzung aufzuteilen. Weitere Informationen zur Verwendung benutzerdefinierter Metadatenlabels für das Kostenmonitoring finden Sie unter Benutzerdefinierte Metadatenlabels.
Gemini 3 Flash und mobile Nutzung
Das folgende Beispiel für Gemini 3 Flash zeigt, wie Sie benutzerdefinierte Funktionen (z. B. open_app, long_press_at und go_home) definieren, sie mit der Computernutzung kombinieren und unnötige browserspezifische Funktionen ausschließen. Durch die Registrierung dieser benutzerdefinierten Funktionen kann das Modell sie intelligent zusammen mit Standard-UI-Aktionen aufrufen, um Aufgaben in Nicht-Browser-Umgebungen auszuführen.
from typing import Optional, Dict, Any

from google import genai
from google.genai import types
from google.genai.types import Content, Part


client = genai.Client()

def open_app(app_name: str, intent: Optional[str] = None) -> Dict[str, Any]:
    """Opens an app by name.

    Args:
        app_name: Name of the app to open (any string).
        intent: Optional deep-link or action to pass when launching, if the app supports it.

    Returns:
        JSON payload acknowledging the request (app name and optional intent).
    """
    return {"status": "requested_open", "app_name": app_name, "intent": intent}


def long_press_at(x: int, y: int, duration_ms: int = 500) -> Dict[str, int]:
    """Long-press at a specific screen coordinate.

    Args:
        x: X coordinate (absolute), scaled to the device screen width (pixels).
        y: Y coordinate (absolute), scaled to the device screen height (pixels).
        duration_ms: Press duration in milliseconds. Defaults to 500.

    Returns:
        Object with the coordinates pressed and the duration used.
    """
    return {"x": x, "y": y, "duration_ms": duration_ms}


def go_home() -> Dict[str, str]:
    """Navigates to the device home screen.

    Returns:
        A small acknowledgment payload.
    """
    return {"status": "home_requested"}


#  Build function declarations
CUSTOM_FUNCTION_DECLARATIONS = [
    types.FunctionDeclaration.from_callable(client=client, callable=open_app),
    types.FunctionDeclaration.from_callable(client=client, callable=long_press_at),
    types.FunctionDeclaration.from_callable(client=client, callable=go_home),
]

# Exclude browser functions

EXCLUDED_PREDEFINED_FUNCTIONS = [
    "open_web_browser",
    "search",
    "navigate",
    "hover_at",
    "scroll_document",
    "go_forward",
    "key_combination",
    "drag_and_drop",
]

# Utility function to construct a GenerateContentConfig

def make_generate_content_config() -> genai.types.GenerateContentConfig:
    """Return a fixed GenerateContentConfig with Computer Use + custom functions."""
    return genai.types.GenerateContentConfig(
        tools=[
            types.Tool(
                computer_use=types.ComputerUse(
                    environment=types.Environment.ENVIRONMENT_BROWSER,
                    excluded_predefined_functions=EXCLUDED_PREDEFINED_FUNCTIONS,
                )
            ),
            types.Tool(function_declarations=CUSTOM_FUNCTION_DECLARATIONS),
        ]
    )


# Create the content with user message
contents: list[Content] = [
    Content(
        role="user",
        parts=[
            # text instruction
            Part(text="Open Chrome, then long-press at 200,400."),
            # optional screenshot attachment
            Part.from_bytes(
                data=screenshot_image_bytes,
                mime_type="image/png",
            ),
        ],
    )
]

# Build your fixed config (from helper)
config = make_generate_content_config()

# Generate content with the configured settings
response = client.models.generate_content(
        model="gemini-3-flash-preview",
        contents=contents,
        config=generate_content_config,
    )

    print(response)