

אחרי שיוצרים ומעריכים את מודל ה-AI הגנרטיבי, אפשר להשתמש בו כדי ליצור סוכן כמו צ'אט בוט. שירות ההערכה ל-AI גנרטיבי מאפשר לכם למדוד את היכולת של הנציג להשלים משימות ויעדים בתרחיש לדוגמה שלכם.
סקירה כללית
יש כמה אפשרויות להערכת הנציג:
הערכת התשובה הסופית: הערכת הפלט הסופי של הנציג (אם הנציג השיג את המטרה שלו או לא).
הערכת מסלול: הערכת המסלול (רצף הקריאות לכלים) שהנציג עבר כדי להגיע לתשובה הסופית.
בעזרת שירות ההערכה ל-AI גנרטיבי, אתם יכולים להפעיל את הסוכן ולקבל מדדים להערכת המסלול ולהערכת התשובה הסופית בשאילתה אחת של Vertex AI SDK.
סוכנים נתמכים
שירות ההערכה של AI גנרטיבי תומך בקטגוריות הבאות של נציגים:
| סוכנים נתמכים | תיאור |
|---|---|
| סוכן שנוצר באמצעות התבנית של Agent Runtime | Agent Runtime היא פלטפורמה של Cloud de Confiance by S3NS שבה אפשר לפרוס ולנהל סוכנים. |
| סוכני LangChain שנוצרו באמצעות התבנית של Agent Runtime שניתנת להתאמה אישית | LangChain היא פלטפורמת קוד פתוח. |
| פונקציה מותאמת אישית של Agent | פונקציית סוכן בהתאמה אישית היא פונקציה גמישה שמקבלת הנחיה לסוכן ומחזירה תשובה ומסלול במילון. |
הגדרת מדדים להערכת תפקוד הסוכנים
הגדירו את המדדים להערכת התשובה הסופית או המסלול:
הערכת התשובה הסופית
התהליך של הערכת התשובה הסופית זהה לתהליך של הערכת התשובה של המודל. מידע נוסף זמין במאמר הגדרת מדדי ההערכה.
הערכת מסלול
המדדים הבאים עוזרים להעריך את היכולת של המודל לעקוב אחרי המסלול הצפוי:
התאמה מדויקת
אם המסלול החזוי זהה למסלול הייחוס, עם אותן קריאות לפונקציות בדיוק באותו סדר, המדד trajectory_exact_match מחזיר ציון של 1, אחרת הוא מחזיר 0.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכן השתמש כדי להגיע לתשובה הסופית. |
reference_trajectory |
הכלי שהסוכן צפוי להשתמש בו כדי לענות על השאילתה. |
ציוני פלט
| ערך | תיאור |
|---|---|
| 0 | המסלול החזוי לא תואם למסלול הייחוס. |
| 1 | המסלול החזוי תואם לקובץ העזר. |
התאמה לפי הסדר
אם המסלול החזוי מכיל את כל הקריאות לפונקציות מהמסלול לדוגמה באותו סדר, ויכול להיות שהוא מכיל גם קריאות נוספות לפונקציות, המדד trajectory_in_order_match מחזיר את הציון 1, אחרת הוא מחזיר את הציון 0.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
המסלול החזוי שבו הסוכן משתמש כדי להגיע לתשובה הסופית. |
reference_trajectory |
המסלול הצפוי של הנציג כדי לענות על השאילתה. |
ציוני פלט
| ערך | תיאור |
|---|---|
| 0 | הקריאות לפונקציות במסלול החזוי לא תואמות לסדר במסלול לדוגמה. |
| 1 | המסלול החזוי תואם לקובץ העזר. |
התאמה בכל סדר
אם המסלול החזוי מכיל את כל הקריאות לפונקציות ממסלול העזר, אבל הסדר לא משנה ויכול להיות שהוא מכיל קריאות נוספות לפונקציות, המדד trajectory_any_order_match מחזיר ציון של 1, אחרת הוא מחזיר 0.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכן השתמש כדי להגיע לתשובה הסופית. |
reference_trajectory |
הכלי שהסוכן צפוי להשתמש בו כדי לענות על השאילתה. |
ציוני פלט
| ערך | תיאור |
|---|---|
| 0 | המסלול החזוי לא מכיל את כל הקריאות לפונקציות במסלול לדוגמה. |
| 1 | המסלול החזוי תואם למסלול הייחוס. |
דיוק
המדד trajectory_precision בודק כמה מהקריאות לפונקציות במסלול החזוי הן רלוונטיות או נכונות בפועל, בהתאם למסלול הייחוס.
הדיוק מחושב באופן הבא: סופרים כמה פעולות במסלול החזוי מופיעות גם במסלול הייחוס. מחלקים את המספר הזה במספר הכולל של הפעולות במסלול החזוי.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכן השתמש כדי להגיע לתשובה הסופית. |
reference_trajectory |
הכלי שהסוכן צפוי להשתמש בו כדי לענות על השאילתה. |
ציוני פלט
| ערך | תיאור |
|---|---|
| מספר ממשי בטווח [0,1] | ככל שהציון גבוה יותר, כך המסלול החזוי מדויק יותר. |
Recall
המדד trajectory_recall בודק כמה מהקריאות החיוניות לפונקציות ממסלול הייחוס נלכדות בפועל במסלול החזוי.
האחזור מחושב באופן הבא: סופרים כמה פעולות במסלול הייחוס מופיעות גם במסלול החזוי. מחלקים את המספר הזה במספר הכולל של הפעולות במסלול לדוגמה.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכן השתמש כדי להגיע לתשובה הסופית. |
reference_trajectory |
הכלי שהסוכן צפוי להשתמש בו כדי לענות על השאילתה. |
ציוני פלט
| ערך | תיאור |
|---|---|
| מספר ממשי בטווח [0,1] | ככל שהציון גבוה יותר, כך הריקול של המסלול החזוי טוב יותר. |
שימוש בכלי אחד
המדד trajectory_single_tool_use בודק אם כלי ספציפי שצוין במפרט המדדים נמצא בשימוש במסלול החזוי. היא לא בודקת את סדר הקריאות לפונקציות או את מספר הפעמים שבהן נעשה שימוש בפונקציה, אלא רק אם היא קיימת או לא.
פרמטרים של קלט המדד
| פרמטר קלט | תיאור |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכן השתמש כדי להגיע לתשובה הסופית. |
ציוני פלט
| ערך | תיאור |
|---|---|
| 0 | הכלי לא קיים |
| 1 | הכלי קיים. |
בנוסף, שני מדדים לבדיקת ביצועים הבאים של הנציג נוספים לתוצאות ההערכה כברירת מחדל. אין צורך לציין אותם ב-EvalTask.
latency
הזמן שלוקח לסוכן להחזיר תשובה.
| ערך | תיאור |
|---|---|
| מספר ממשי (float) | מחושב בשניות. |
failure
ערך בוליאני שמתאר אם הפעלת הנציג הסתיימה בשגיאה או הצליחה.
ציוני פלט
| ערך | תיאור |
|---|---|
| 1 | שגיאה |
| 0 | התקבלה תשובה תקינה |
הכנת מערך הנתונים להערכת תפקוד הסוכנים
מכינים את מערך הנתונים להערכה של התגובה הסופית או של תהליך היצירה.
סכימת הנתונים להערכת התשובה הסופית דומה לזו של הערכת התשובה של המודל.
כדי להעריך את המסלול על סמך חישוב, קבוצת הנתונים צריכה לכלול את הפרטים הבאים:
| סוג קלט | תוכן של שדה להזנת קלט |
|---|---|
predicted_trajectory |
רשימת הקריאות לכלים שבהן הסוכנים השתמשו כדי להגיע לתשובה הסופית. |
reference_trajectory (לא נדרש עבור trajectory_single_tool_use metric) |
הכלי שהסוכן צפוי להשתמש בו כדי לענות על השאילתה. |
דוגמאות למערכי נתונים להערכה
בדוגמאות הבאות מוצגות קבוצות נתונים להערכת מסלול. חשוב לזכור שצריך להגדיר את reference_trajectory לכל המדדים, חוץ מ-trajectory_single_tool_use.
reference_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_2",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_y"
      }
  },
  {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

predicted_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_3",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_z"
      }
    },
    {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

eval_dataset = pd.DataFrame({
    "predicted_trajectory": predicted_trajectory,
    "reference_trajectory": reference_trajectory,
})
ייבוא של מערך נתוני ההערכה
אפשר לייבא את מערך הנתונים בפורמטים הבאים:
קובץ JSONL או CSV שמאוחסן ב-Cloud Storage
טבלה ב-BigQuery
Pandas DataFrame
שירות ההערכה ל-AI גנרטיבי מספק מערכי נתונים ציבוריים לדוגמה כדי להדגים איך אפשר להעריך את הנציגים. הקוד הבא מראה איך לייבא את מערכי הנתונים הציבוריים מקטגוריה של Cloud Storage:
# dataset name to be imported
dataset = "on-device" # Alternatives: "customer-support", "content-creation"

# copy the tools and dataset file
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/tools.py .
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/eval_dataset.json .

# load the dataset examples
import json

eval_dataset = json.loads(open('eval_dataset.json').read())

# run the tools file
%run -i tools.py
כאשר dataset הוא אחד ממערכי הנתונים הציבוריים הבאים:
"on-device"ל-On-Device Home Assistant, ששולט במכשירים בבית. הסוכן עוזר בשאילתות כמו "תזמן את מיזוג האוויר בחדר השינה כך שיופעל בין 23:00 ל-8:00, ויהיה כבוי בשאר הזמן"."customer-support"לנציג תמיכת לקוחות. הנציג יכול לעזור בשאילתות כמו "אפשר לבטל את כל ההזמנות בהמתנה ולהעביר לטיפול ברמה גבוהה יותר את כל כרטיסי התמיכה הפתוחים?"
"content-creation"לסוכן ליצירת תוכן שיווקי. הנציג יכול לעזור בשאילתות כמו "שנה את המועד של קמפיין X כך שיהיה קמפיין חד-פעמי באתר המדיה החברתית Y עם תקציב מופחת ב-50%, רק ב-25 בדצמבר 2024".
הרצת הערכת תפקוד הסוכנים
מריצים הערכה של מסלול או הערכה של התשובה הסופית:
כדי להעריך את תפקוד הסוכן, אתם יכולים לשלב מדדים להערכת התשובות ומדדים להערכת המסלול, כמו בקוד הבא:
single_tool_use_metric = TrajectorySingleToolUse(tool_name='tool_name')

eval_task = EvalTask(
    dataset=EVAL_DATASET,
    metrics=[
        "rouge_l_sum",
        "bleu",
        custom_trajectory_eval_metric, # custom computation-based metric
        "trajectory_exact_match",
        "trajectory_precision",
        single_tool_use_metric,
        response_follows_trajectory_metric # llm-based metric
    ],
)
eval_result = eval_task.evaluate(
    runnable=RUNNABLE,
)
התאמה אישית של המדדים
אתם יכולים להתאים אישית מדד שמבוסס על מודל שפה גדול (LLM) להערכת מסלול באמצעות ממשק עם תבניות או מאפס. מידע נוסף זמין במאמר הגדרת מדדי הערכה. הנה דוגמה לתבנית:
response_follows_trajectory_prompt_template = PointwiseMetricPromptTemplate(
    criteria={
        "Follows trajectory": (
            "Evaluate whether the agent's response logically follows from the "
            "sequence of actions it took. Consider these sub-points:\n"
            "  - Does the response reflect the information gathered during the trajectory?\n"
            "  - Is the response consistent with the goals and constraints of the task?\n"
            "  - Are there any unexpected or illogical jumps in reasoning?\n"
            "Provide specific examples from the trajectory and response to support your evaluation."
        )
    },
    rating_rubric={
        "1": "Follows trajectory",
        "0": "Does not follow trajectory",
    },
    input_variables=["prompt", "predicted_trajectory"],
)

response_follows_trajectory_metric = PointwiseMetric(
    metric="response_follows_trajectory",
    metric_prompt_template=response_follows_trajectory_prompt_template,
)
אתם יכולים גם להגדיר מדד מותאם אישית מבוסס-מחשוב להערכת מסלול או להערכת תשובה, באופן הבא:
def essential_tools_present(instance, required_tools = ["tool1", "tool2"]):
    trajectory = instance["predicted_trajectory"]
    tools_present = [tool_used['tool_name'] for tool_used in trajectory]
    if len(required_tools) == 0:
      return {"essential_tools_present": 1}
    score = 0
    for tool in required_tools:
      if tool in tools_present:
        score += 1
    return {
        "essential_tools_present": score/len(required_tools),
    }

custom_trajectory_eval_metric = CustomMetric(name="essential_tools_present", metric_function=essential_tools_present)
איך רואים ומפרשים את התוצאות
בהערכת מסלול או בהערכת התשובה הסופית, תוצאות ההערכה מוצגות באופן הבא:
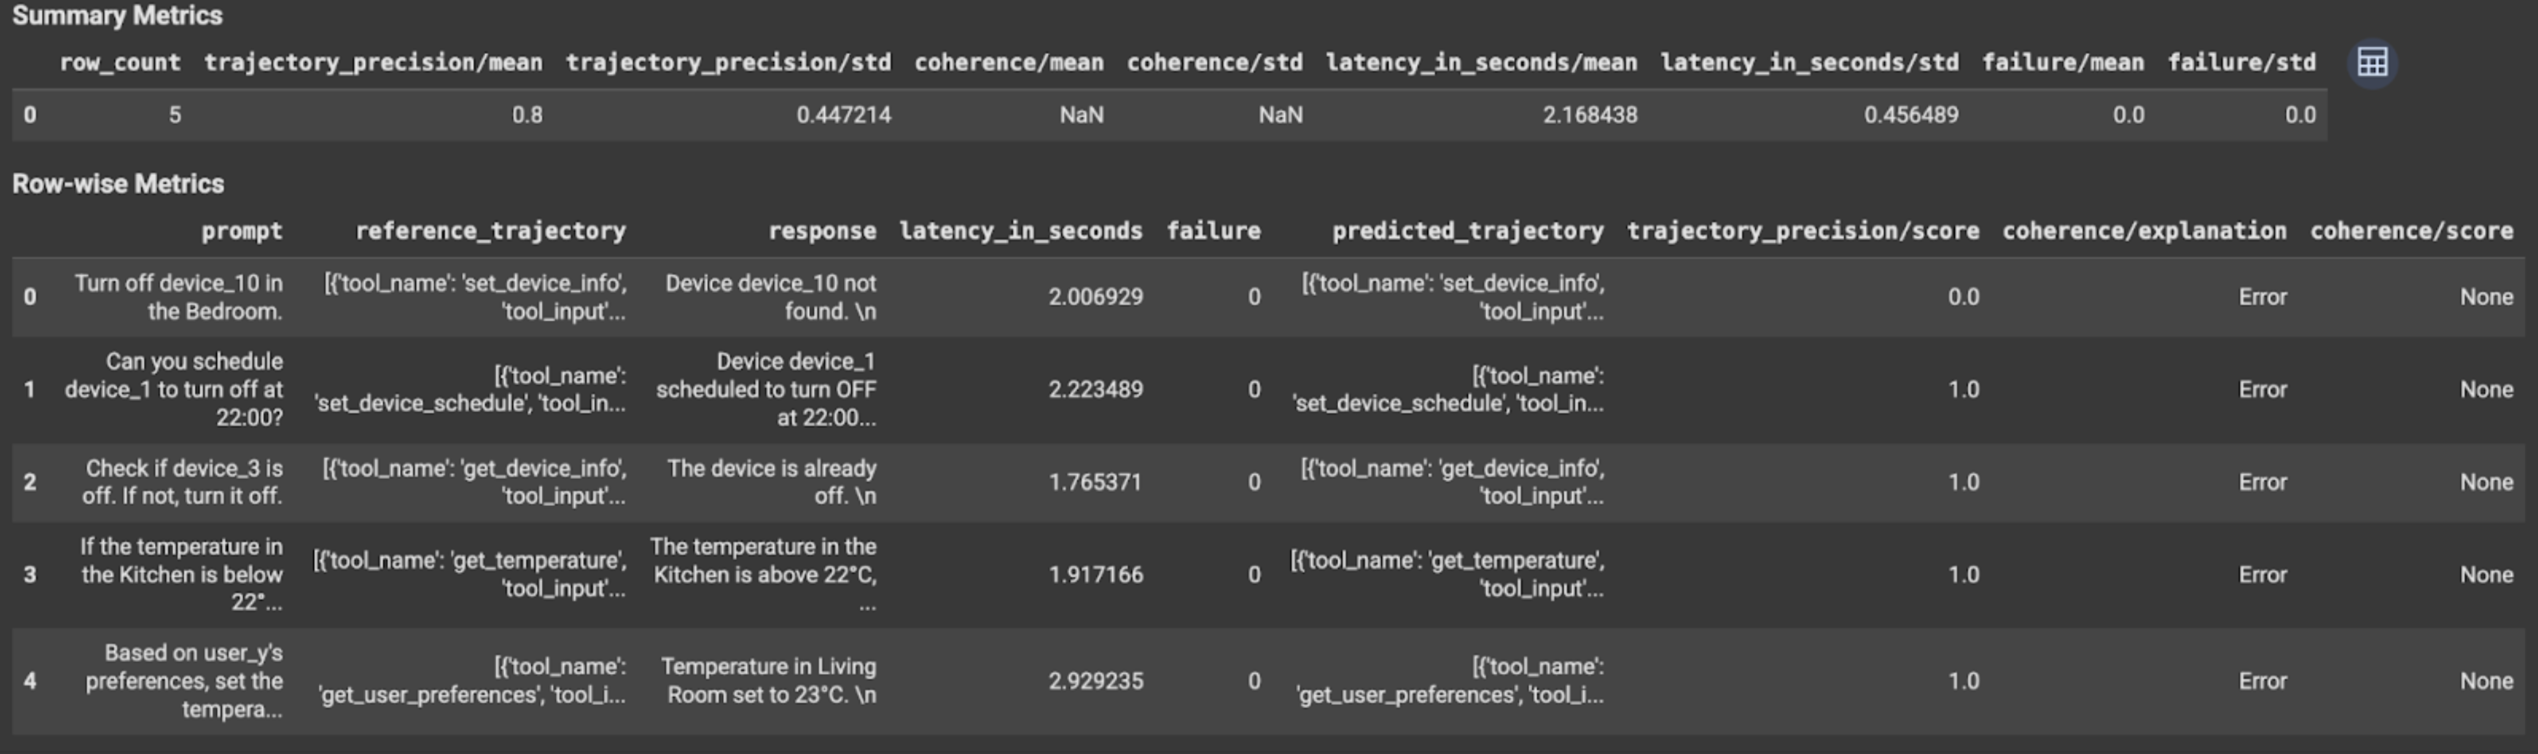
תוצאות הבדיקה כוללות את הפרטים הבאים:
מדדי התשובה הסופית
תוצאות ברמת המכונה
| עמודה | תיאור |
|---|---|
| תשובה | התשובה הסופית שהסוכן יצר. |
| latency_in_seconds | הזמן שלקח ליצור את התשובה. |
| נכשלה | מציין אם נוצרה תשובה תקינה או לא. |
| ציון | ציון שמחושב לתשובה שצוינה במפרט המדדים. |
| הסבר | ההסבר לציון שצוין במפרט המדדים. |
תוצאות מצטברות
| עמודה | תיאור |
|---|---|
| ממוצע | הציון הממוצע של כל המופעים. |
| סטיית תקן | סטיית תקן לכל הציונים. |
מדדי מסלול
תוצאות ברמת המכונה
| עמודה | תיאור |
|---|---|
| predicted_trajectory | רצף של קריאות לכלים ואחריהן הסוכן כדי להגיע לתשובה הסופית. |
| reference_trajectory | רצף של קריאות צפויות לכלים. |
| ציון | ציון שמחושב למסלול החזוי ולמסלול הייחוס שצוינו במפרט המדדים. |
| latency_in_seconds | הזמן שלקח ליצור את התשובה. |
| נכשלה | מציין אם נוצרה תשובה תקינה או לא. |
תוצאות מצטברות
| עמודה | תיאור |
|---|---|
| ממוצע | הציון הממוצע של כל המופעים. |
| סטיית תקן | סטיית תקן לכל הציונים. |
פרוטוקול Agent2Agent (A2A)
אם אתם יוצרים מערכת מרובת סוכנים, מומלץ מאוד לעיין בפרוטוקול A2A. פרוטוקול A2A הוא תקן פתוח שמאפשר תקשורת ושיתוף פעולה חלקים בין סוכני AI, בלי קשר למסגרות הבסיסיות שלהם. הוא נתרם על ידי Cloud de Confiance by S3NS ל-Linux Foundation ביוני 2025. כדי להשתמש בערכות ה-SDK של A2A או לנסות את הדוגמאות, עיינו במאגר GitHub.
המאמרים הבאים
נסו את ה-notebooks הבאים להערכת תפקוד הסוכנים: