

建構及評估生成式 AI 模型後,您可以使用模型建構代理,例如聊天機器人。Gen AI Evaluation Service 可用來評估代理完成特定用途的任務和目標的能力。
總覽
您可以透過下列方式評估代理:
最終回覆評估:評估代理的最終輸出內容 (無論代理是否達成目標)。
軌跡評估:評估代理為取得最終回覆而採取的路徑 (工具呼叫序列)。
使用 Gen AI Evaluation Service,您就能觸發代理執行作業,並透過單一 Vertex AI SDK 查詢,取得軌跡評估和最終回覆評估的指標。
支援的代理
Gen AI Evaluation Service 支援下列類別的代理:
| 支援的代理 | 說明 |
|---|---|
| 使用 Agent Runtime 範本建構的代理 | Agent Runtime 是 Cloud de Confiance by S3NS 平台,可讓您部署及管理代理。 |
| 使用 Agent Runtime 可自訂範本建構的 LangChain 代理 | LangChain 是開放原始碼平台。 |
| 自訂代理函式 | 自訂代理函式是一項彈性函式,可接收代理的提示,並以字典形式傳回回覆和軌跡。 |
定義代理評估指標
定義最終回覆或軌跡評估的指標:
最終回覆評估
最終回覆評估程序與模型回覆評估相同。詳情請參閱「定義評估指標」。
軌跡評估
下列指標可協助您評估模型是否能按照預期軌跡運作:
完全比對
如果預測軌跡與參考軌跡完全相同,且工具呼叫和順序也完全一致,trajectory_exact_match 指標會傳回 1 分,否則傳回 0 分。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的工具呼叫清單。 |
reference_trajectory |
代理預期使用的工具,用於滿足查詢。 |
輸出分數
| 值 | 說明 |
|---|---|
| 0 | 預測軌跡與參考資料不符。 |
| 1 | 預測軌跡與參考資料相符。 |
依序比對
如果預測軌跡包含參考軌跡中的所有工具呼叫,且順序相同,且可能還有額外的工具呼叫,trajectory_in_order_match 指標會傳回 1 分,否則傳回 0 分。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的預測軌跡。 |
reference_trajectory |
代理為滿足查詢而預期的軌跡。 |
輸出分數
| 值 | 說明 |
|---|---|
| 0 | 預測軌跡中的工具呼叫與參考軌跡中的順序不符。 |
| 1 | 預測軌跡與參考資料相符。 |
順序不限
如果預測軌跡包含參考軌跡的所有工具呼叫,但順序不重要,且可能包含額外的工具呼叫,則 trajectory_any_order_match 指標會傳回分數 1,否則傳回 0。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的工具呼叫清單。 |
reference_trajectory |
代理預期使用的工具,用於滿足查詢。 |
輸出分數
| 值 | 說明 |
|---|---|
| 0 | 預測軌跡未包含參考軌跡中的所有工具呼叫。 |
| 1 | 預測軌跡與參考資料相符。 |
精確度
trajectory_precision 指標會根據參考軌跡,評估預測軌跡中實際相關或正確的工具呼叫數量。
精確度的計算方式如下:計算預測軌跡中,有多少動作也出現在參考軌跡中。將該計數除以預測軌跡中的動作總數。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的工具呼叫清單。 |
reference_trajectory |
代理預期使用的工具,用於滿足查詢。 |
輸出分數
| 值 | 說明 |
|---|---|
| 介於 [0,1] 之間的浮點值 | 分數越高,預測軌跡越精確。 |
召回率
trajectory_recall 指標會評估參考軌跡中,有多少重要工具呼叫實際出現在預測軌跡中。
召回率的計算方式如下:計算參考軌跡中有多少動作也出現在預測軌跡中。將該計數除以參考軌跡中的動作總數。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的工具呼叫清單。 |
reference_trajectory |
代理預期使用的工具,用於滿足查詢。 |
輸出分數
| 值 | 說明 |
|---|---|
| 介於 [0,1] 之間的浮點值 | 分數越高,預測軌跡的喚回度就越高。 |
單一工具使用
trajectory_single_tool_use 指標會檢查預測軌跡中,是否使用指標規格中指定的特定工具。不會檢查工具呼叫的順序或工具的使用次數,只會檢查工具是否存在。
指標輸入參數
| 輸入參數 | 說明 |
|---|---|
predicted_trajectory |
代理用來得出最終回覆的工具呼叫清單。 |
輸出分數
| 值 | 說明 |
|---|---|
| 0 | 缺少工具 |
| 1 | 工具已存在。 |
此外,評估結果預設會加入下列兩項代理成效指標。您不需要在 EvalTask 中指定這些項目。
latency
代理傳回回覆所需的時間。
| 值 | 說明 |
|---|---|
| 浮點值 | 以秒為單位。 |
failure
布林值,說明代理叫用結果為錯誤或成功。
輸出分數
| 值 | 說明 |
|---|---|
| 1 | 錯誤 |
| 0 | 傳回有效回應 |
準備代理評估資料集
準備資料集,用於最終回覆或軌跡評估。
最終回覆評估的資料架構與模型回覆評估類似。
如要進行以運算為基礎的軌跡評估,資料集必須提供下列資訊:
| 輸入類型 | 輸入欄位內容 |
|---|---|
predicted_trajectory |
代理用來取得最終回覆的工具呼叫清單。 |
reference_trajectory (trajectory_single_tool_use metric不需要) |
代理預期使用的工具,用於滿足查詢。 |
評估資料集範例
以下是軌跡評估資料集的範例。請注意,除了 trajectory_single_tool_use 以外,所有指標都必須提供 reference_trajectory。
reference_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_2",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_y"
      }
  },
  {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

predicted_trajectory = [
# example 1
[
  {
    "tool_name": "set_device_info",
    "tool_input": {
        "device_id": "device_3",
        "updates": {
            "status": "OFF"
        }
    }
  }
],
# example 2
[
    {
      "tool_name": "get_user_preferences",
      "tool_input": {
          "user_id": "user_z"
      }
    },
    {
      "tool_name": "set_temperature",
      "tool_input": {
          "location": "Living Room",
          "temperature": 23
      }
    },
  ]
]

eval_dataset = pd.DataFrame({
    "predicted_trajectory": predicted_trajectory,
    "reference_trajectory": reference_trajectory,
})
匯入評估資料集
您可以匯入下列格式的資料集:
儲存在 Cloud Storage 的 JSONL 或 CSV 檔案
BigQuery 資料表
Pandas DataFrame
Gen AI Evaluation Service 提供公開資料集範例,示範如何評估代理。下列程式碼說明如何從 Cloud Storage bucket 匯入公開資料集:
# dataset name to be imported
dataset = "on-device" # Alternatives: "customer-support", "content-creation"

# copy the tools and dataset file
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/tools.py .
!gcloud storage cp gs://cloud-ai-demo-datasets/agent-eval-datasets/{dataset}/eval_dataset.json .

# load the dataset examples
import json

eval_dataset = json.loads(open('eval_dataset.json').read())

# run the tools file
%run -i tools.py
其中 dataset 是下列其中一個公開資料集:
"on-device":用於裝置端 Home 助理,可控制住宅裝置。代理可協助處理「安排臥室空調在晚上 11 點到早上 8 點之間開啟,其餘時間關閉」等查詢。"customer-support":客戶服務專員。代理可協助處理「可以取消待處理訂單,並呈報未解決的支援單嗎?」等查詢。"content-creation",用於行銷內容創作代理。代理可協助處理這類查詢:「將廣告活動 X 重新排定為在社群媒體網站 Y 放送的一次性廣告活動,預算減少 50%,僅限 2024 年 12 月 25 日。」
執行代理評估
執行軌跡或最終回覆評估:
評估代理時,您可以混合使用回覆評估指標和軌跡評估指標,如以下程式碼所示:
single_tool_use_metric = TrajectorySingleToolUse(tool_name='tool_name')

eval_task = EvalTask(
    dataset=EVAL_DATASET,
    metrics=[
        "rouge_l_sum",
        "bleu",
        custom_trajectory_eval_metric, # custom computation-based metric
        "trajectory_exact_match",
        "trajectory_precision",
        single_tool_use_metric,
        response_follows_trajectory_metric # llm-based metric
    ],
)
eval_result = eval_task.evaluate(
    runnable=RUNNABLE,
)
自訂指標
您可以使用範本介面或從頭開始,自訂以大型語言模型為基礎的指標,用於評估軌跡。詳情請參閱「定義評估指標」。以下是範本範例:
response_follows_trajectory_prompt_template = PointwiseMetricPromptTemplate(
    criteria={
        "Follows trajectory": (
            "Evaluate whether the agent's response logically follows from the "
            "sequence of actions it took. Consider these sub-points:\n"
            "  - Does the response reflect the information gathered during the trajectory?\n"
            "  - Is the response consistent with the goals and constraints of the task?\n"
            "  - Are there any unexpected or illogical jumps in reasoning?\n"
            "Provide specific examples from the trajectory and response to support your evaluation."
        )
    },
    rating_rubric={
        "1": "Follows trajectory",
        "0": "Does not follow trajectory",
    },
    input_variables=["prompt", "predicted_trajectory"],
)

response_follows_trajectory_metric = PointwiseMetric(
    metric="response_follows_trajectory",
    metric_prompt_template=response_follows_trajectory_prompt_template,
)
您也可以定義自訂的以運算為基礎的指標,用於評估軌跡或回覆,如下所示:
def essential_tools_present(instance, required_tools = ["tool1", "tool2"]):
    trajectory = instance["predicted_trajectory"]
    tools_present = [tool_used['tool_name'] for tool_used in trajectory]
    if len(required_tools) == 0:
      return {"essential_tools_present": 1}
    score = 0
    for tool in required_tools:
      if tool in tools_present:
        score += 1
    return {
        "essential_tools_present": score/len(required_tools),
    }

custom_trajectory_eval_metric = CustomMetric(name="essential_tools_present", metric_function=essential_tools_present)
查看並解讀結果
如果是軌跡評估或最終回覆評估,評估結果會顯示如下:
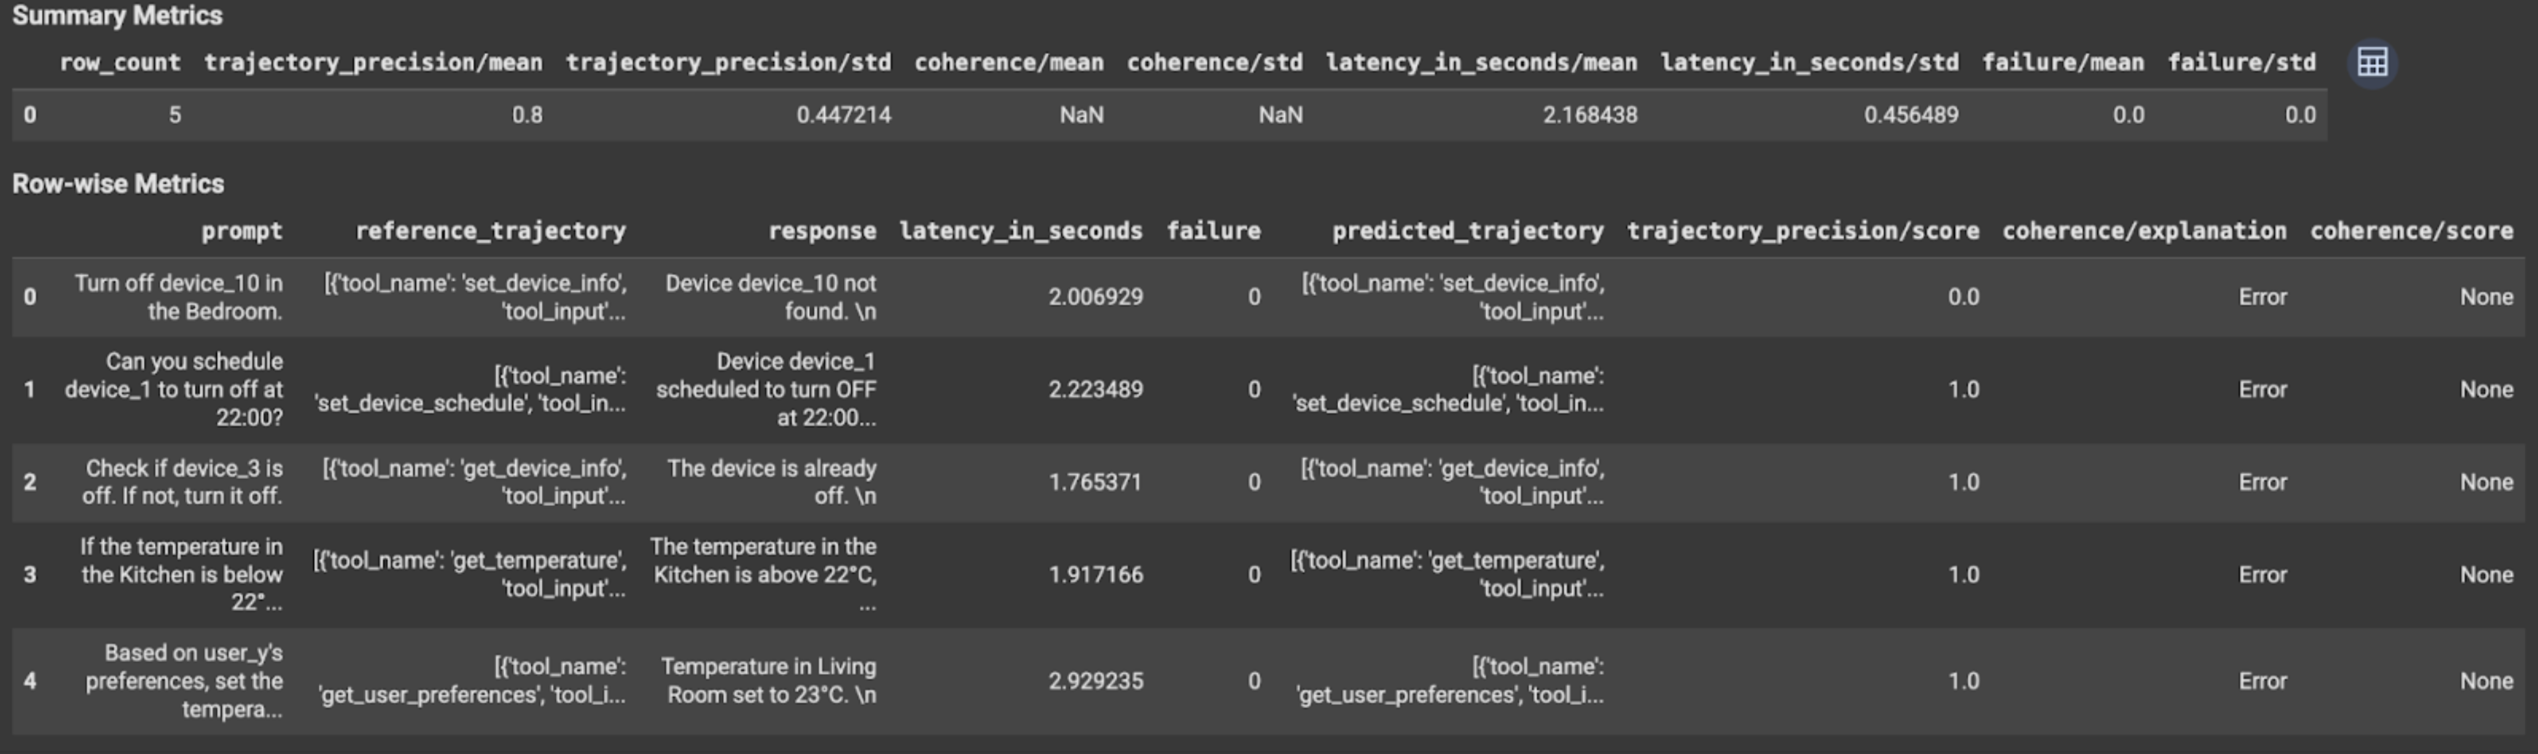
評估結果包含下列資訊:
最終回覆指標
執行個體層級結果
| 欄 | 說明 |
|---|---|
| 回應 | 代理生成的最終回覆。 |
| latency_in_seconds | 生成回覆所需的時間。 |
| 失敗 | 指出是否生成有效回覆。 |
| 分數 | 根據指標規格中指定的回覆計算出的分數。 |
| explanation | 指標規格中指定分數的說明。 |
匯總結果
| 欄 | 說明 |
|---|---|
| 平均值 | 所有執行個體的平均分數。 |
| 標準差 | 所有分數的標準差。 |
軌跡指標
執行個體層級結果
| 欄 | 說明 |
|---|---|
| predicted_trajectory | 代理為取得最終回覆而執行的工具呼叫序列。 |
| reference_trajectory | 預期工具呼叫的順序。 |
| 分數 | 根據指標規格中指定的預測軌跡和參考軌跡,計算出的分數。 |
| latency_in_seconds | 生成回覆所需的時間。 |
| 失敗 | 指出是否生成有效回覆。 |
匯總結果
| 欄 | 說明 |
|---|---|
| 平均值 | 所有執行個體的平均分數。 |
| 標準差 | 所有分數的標準差。 |
Agent2Agent (A2A) 通訊協定
如果您要建構多代理系統,強烈建議您參閱 A2A 通訊協定。A2A 通訊協定是一項開放標準,可讓 AI 代理順暢通訊及協作,不受基礎框架限制。由 Cloud de Confiance by S3NS 於 2025 年 6 月捐贈給 Linux Foundation。如要使用 A2A SDK 或試用範例,請前往 GitHub 存放區。
後續步驟
試用下列代理評估筆記本: