

AlphaFold 3 是由 Google DeepMind 和 Isomorphic Labs 開發的深度學習模型,這項工具可預測蛋白質、DNA、RNA、配體和離子的 3D 結構和互動。本文說明如何使用 Gemini Enterprise Agent Platform 的 Model Garden,部署及使用 AlphaFold 3 模型。
主要功能
在 Agent Platform 上部署 AlphaFold 3,可提供進階研發和商業藥物探索工作流程所需的下列功能:
商業用途:Model Garden 中的 AlphaFold 3 可用於商業用途。
任意自訂配體:AlphaFold 3 支援蛋白質、DNA 和 RNA 的統一共摺疊,以及使用 SMILES 字串或 CIF 化學成分字典 (CCD) 代碼定義的自訂配體。
工作流程彈性:Model Garden 上的 AlphaFold 3 支援完整的端對端摺疊管道 (結合資料庫搜尋和模型預測),或僅限推論模式,您可提供預先計算的 MSA 比對,以縮短執行時間並提高 GPU 使用率。
注意事項
評估工作負載的 AlphaFold 3 時,請注意下列限制:
並行:AlphaFold 3 端點的並行上限為每個節點一個。如要提高並行處理量,端點可以擴充至多個節點。如果傳送預測要求時,另一個預測正在執行中,且要求數量超過節點數量,端點會拒絕新要求並傳回
HTTP 429 Too Many Requests錯誤。權杖限制:Agent Platform 端點的預測時間上限為 60 分鐘。由於 MSA 搜尋的負擔會有所變動,A3 GPU 支援的最大序列大小約為 4,500 個生物標記 (例如胺基酸、核苷酸或配體原子) 負擔。提供預先計算的對齊方式可略過 MSA 搜尋執行作業,因此可進行複雜的摺疊,最多可達硬體限制的約 5,400 個權杖。
酬載限制:標準預測 REST 要求的大小上限為 8 MB。如果使用僅供推論模式,則必須使用 Cloud Storage URI 參照大型預先計算的對齊方式 (
.a3m檔案),而不是內嵌為內嵌字串,以免酬載遭到拒絕。網路設定:由於預測是長時間執行的作業,最多可能需要 60 分鐘才能完成,因此您應只使用 Private Service Connect (PSC) 部署端點,略過標準端點 10 分鐘的逾時限制。
部署作業操作說明
本節將詳細說明如何將 AlphaFold 3 部署至 Cloud de Confiance by S3NS 專案中 Agent Platform 提供的端點。
事前準備
部署 AlphaFold 3 前,請務必完成下列事項:
- 要求模型存取權。
- 採購 GPU 資源。
- 設定必要的 Identity and Access Management (IAM) 權限:
- 建立服務帳戶並授予 Agent Platform 管理員 IAM 角色。
- 請確認 IAM 主體具備
roles/iam.serviceAccountCreator角色,可在部署模型時做為服務帳戶。
- 確認資源配額。
資源需求
AlphaFold 3 需要 a3-highgpu-1g 虛擬機器 (VM)。
部署前,請確認 Cloud de Confiance by S3NS 專案在目標部署區域中,有下列資源的足夠配額:
加速器:至少一個
a3-highgpu-1g機型。本機 SSD:A3 VM 佈建了 750 GB 的本機 SSD 空間。這是為了永久快取參考序列資料庫 (UniProt、MGnify、Rfam),以便在所有預測要求中,於基因資料庫搜尋 (Jackhmmer/Nhmmer) 期間實現低延遲讀取。
Cloud Storage bucket
AlphaFold 3 需要 Cloud Storage bucket 儲存提供的 MSA 檔案,並匯出完整預測輸出內容。為避免跨區域傳輸,建議您使用與端點位於同一區域的 Cloud Storage bucket,或是使用多區域 bucket。
身分與存取權管理角色
為參與身分設定下列角色:
模型部署者 (又稱 IT 管理員):部署模型的身分必須具備
roles/aiplatform.admin權限,才能建立端點及管理部署作業。服務身分:執行推論時,AlphaFold 3 端點會使用租戶專案服務帳戶,將輸出結構直接寫入 Cloud Storage。對應的服務帳戶必須具備目標 Cloud Storage bucket 的
roles/storage.objectUser。模型使用者:開始預測的帳戶必須符合下列條件:
roles/aiplatform.user,向端點傳送預測要求。roles/storage.objectUser,即可存取 Cloud Storage bucket 中的預測輸出內容。
部署 AlphaFold 3
使用 Agent Platform SDK 以程式輔助方式部署 AlphaFold 3,但只能做為 Google Cloud 專屬端點或 Private Service Connect 端點。視 GPU 可用性而定,端點可能需要 10 到 15 分鐘才能準備好進行推論。
以下是 Python 程式碼片段範例,說明如何在 Cloud de Confiance by S3NS 專案中部署模型,包括延長推論逾時時間:
import google.auth
from google.auth.transport.requests import AuthorizedSession
import vertexai
from vertexai import model_garden

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
MODEL_ID = "google/alphafold3@v3_0_4"
MACHINE_TYPE = "a3-highgpu-1g"

vertexai.init(project=PROJECT_ID, location=LOCATION)

# 1. Deploy Model Garden OpenModel to Dedicated Endpoint
af3_model = model_garden.OpenModel(MODEL_ID)
endpoint = af3_model.deploy(
    endpoint_display_name="af3-dedicated-ep",
    model_display_name="af3-on-mg",
    machine_type=MACHINE_TYPE,
    accelerator_type="NVIDIA_H100_80GB",
    accelerator_count=1,
    reservation_affinity_type="ANY_RESERVATION",
    use_dedicated_endpoint=True,
    accept_eula=True,
    min_replica_count=1,
    max_replica_count=1,
    serving_container_deployment_timeout=3600,
)

# 2. Update inference timeout to 3,600 seconds
credentials, _ = google.auth.default(
    scopes=["https://www.googleapis.com/auth/cloud-platform"]
)
session = AuthorizedSession(credentials)
url = f"https://{LOCATION}-aiplatform.googleapis.com/v1/{endpoint.resource_name}:update"
payload = {
    "endpoint": {
        "name": endpoint.resource_name,
        "clientConnectionConfig": {
            "inferenceTimeout": {
                "seconds": 3600
            }
        }
    }
}
response = session.post(url, json=payload)
response.raise_for_status()
print(f"Endpoint Resource Name: {endpoint.resource_name}")
API 參考資料
本節說明端點位置、網址格式、路徑參數和要求酬載結構定義。
HTTP 要求
POST https://HOST/v1/projects/PROJECT_ID/locations/LOCATION/endpoints/ENDPOINT_ID:predict
更改下列內容:
HOST:服務端點主機。這取決於部署類型是專屬公開端點,還是使用 Private Service Connect。PROJECT_ID:代管已部署端點的 Cloud de Confiance by S3NS 專案 ID。LOCATION:端點部署的 Cloud de Confiance by S3NS 區域 (例如us-central1)。ENDPOINT_ID:已部署的 Agent Platform 端點專屬 ID。
要求主體
要求主體包含採用下列 JSON 結構的資料:
{
  "instances": [
    {
      # The AlphaFold 3 input JSON - see the input documentation at
      # https://github.com/google-deepmind/alphafold3/blob/main/docs/input.md
    }
  ],
  "parameters": {
    "output_dir": "string",
    "dry_run": boolean,
    "run_data_pipeline": boolean,
    "force_output_dir": boolean,
    "resolve_msa_overlaps": boolean,
    "max_template_date": "string",
    "conformer_max_iterations": integer,
    "fix_standalone_glycans": boolean,
    "flash_attention_implementation": "string",
    "num_recycles": integer,
    "num_diffusion_samples": integer,
    "save_embeddings": boolean,
    "save_distogram": boolean,
    "compress_large_output_files": boolean,
    "num_seeds": integer
  }
}
頂層要求欄位
| 欄位 | 類型 | 說明 |
|---|---|---|
instances |
array |
必要。要預測的生物序列設定清單。這個清單必須包含一個元素。如果傳遞零個或多個元素,就會導致 HTTP 422 Unprocessable
Entity 錯誤。instances 主體應根據
AlphaFold 3 說明文件中發布的規格,指定輸入內容。 |
parameters |
object |
選填。包含執行參數的物件,用於設定預測執行作業 (例如 dry_run、output_dir)。
|
參數
設定 AlphaFold 3 執行的執行旗標。
| 欄位 | 類型 | 預設值 | 說明 |
|---|---|---|---|
dry_run |
boolean |
false |
選填。如果 true,API 會執行要求驗證,但略過模型執行作業,並立即傳回空白回應。有助於檢查連線和語法。
|
run_data_pipeline |
boolean |
true |
選填。如果 true,則執行完整管道 (MSA 搜尋和推論)。如果為 false,則只會執行推論 (略過資料庫搜尋;需要預先計算的 MSA)。詳情請參閱
GitHub 說明文件。
|
output_dir |
string |
null |
選填。Cloud Storage URI (例如 gs://bucket/path),成功執行後,系統會將完整的原始輸出檔案 (包括 CIF 結構、PAE 和排名 CSV) 上傳至這個位置。 |
force_output_dir |
boolean |
false |
選填。如果是 true,則允許覆寫指定 output_dir 中的現有檔案。如果 false,API 會在 Cloud Storage 路徑不為空時立即傳回 HTTP 400 Bad Request 錯誤,避免資料意外遺失。 |
resolve_msa_overlaps |
boolean |
true |
選填。是否要針對已配對的 MSA,對未配對的 MSA 進行重複資料刪除。如需最佳做法,請參閱 GitHub AlphaFold 3 說明文件中的指南。 |
max_template_date |
string |
null |
選填。要納入考量的範本最晚發布日期,格式為 YYYY-MM-DD (例如 "2024-05-15")。如果格式不正確,驗證會失敗並顯示 HTTP 422 錯誤。 |
conformer_max_iterations |
integer |
null |
選填。覆寫 RDKit 構形搜尋的疊代次數上限。必須為非負整數 (大於或等於零)。驗證失敗,負值出現 HTTP 422 錯誤。
|
fix_standalone_glycans |
boolean |
false |
選填。啟用獨立的聚醣位置修正功能。 |
flash_attention_implementation |
string |
null |
選填。要使用的 Flash attention 後端實作項目。允許的值為 "triton"、"cudnn"、"xla"。 |
num_recycles |
integer |
10 |
選填。在推論期間使用的回收疊代次數。 必須是正整數 (大於零)。請參閱最佳做法一節,瞭解相關取捨。 |
num_diffusion_samples |
integer |
5 |
選填。要生成的擴散樣本數。必須是正整數 (大於零)。請參閱最佳做法一節,瞭解相關取捨。 |
save_embeddings |
boolean |
false |
選填。是否要將最終主幹單一和配對嵌入儲存在 output_dir 位置。如果
true,嵌入內容會以 .npz 檔案的形式寫入名為 seed-{SEED}_embeddings/ 的子資料夾下 (例如 outputs_config_job_seed-50_embeddings.npz)。
|
save_distogram |
boolean |
false |
選填。是否要將最終預測的距離圖儲存在 output_dir 位置。如果 true,嵌入內容會以 .npz 檔案的形式寫入名為 seed-{SEED}_embeddings/ 的子資料夾下 (例如 outputs_config_job_seed-50_embeddings.npz)。 |
compress_large_output_files |
boolean |
false |
選填。如果 true,則使用 zstandard 壓縮大型輸出檔案 (mmCIF 結構和信賴度 JSON)。這會輸出副檔名為 .cif.zst 和 .json.zst 的檔案,而非 .cif 和 .json。小型檔案 (例如 ranking_scores.csv) 仍會維持未壓縮狀態。 |
num_seeds |
integer |
null |
選填。用於推論的隨機種子數量。一般來說,您應在 instances.modelSeeds 欄位中設定種子,以利重現結果。請參閱最佳做法一節,瞭解相關取捨。 |
回覆 (輸出)
本節說明成功執行後,API 回應中傳回的欄位。
回應主體
執行成功後,端點會以標準 Agent Platform 線上預測結構定義格式傳回回應:
{
  "deployedModelId": "string",
  "model": "string",
  "modelDisplayName": "string",
  "modelVersionId": "string",
  "predictions": [
    {
      "structure_cif": "string",
      "plddt": [
        number
      ],
      "pae": [
        [
          number
        ]
      ],
      "summary": {
        "ptm": number,
        "iptm": number,
        "fraction_disordered": number,
        "has_clash": boolean,
        "ranking_score": number,
        "chain_pair_pae_min": [
          [
            number
          ]
        ],
        "chain_pair_iptm": [
          [
            number
          ]
        ],
        "chain_ptm": [
          number
        ],
        "chain_iptm": [
          number
        ],
        "chain_ids": [
          string
        ]
      },
      "output_dir": "string"
    }
  ]
}
頂層回應欄位
| 欄位 | 類型 | 說明 |
|---|---|---|
deployedModelId |
string |
部署在 Agent Platform 端點上的模型 ID。 |
model |
string |
模型的完整資源名稱。 |
modelDisplayName |
string |
已部署模型的顯示名稱 (一律為 "alphafold3")。 |
modelVersionId |
string |
已部署模型的版本 ID。 |
predictions |
array |
預測結果清單。如果是 AlphaFold 3,這個陣列只會包含一個預測結果物件。 |
預測結果詳細資料 (predictions[])
AlphaFold 3 預測端點會傳回 HTTP 200 JSON 回應,其中包含 predictions 陣列,內含排名最高的候選結構的結構座標和信賴度指標。如需完整的欄位定義和輸出檔案規格,請參閱 GitHub 上的 AlphaFold 3 官方說明文件。
視要求中是否提供 parameters.output_dir 而定,API 回應中的輸出結構可能有所不同:
HTTP 回應中的預測結果:內嵌回應會直接在 HTTP JSON 回應酬載主體中,傳回全域摘要指標 (
summary)、3D 結構座標 (structure_cif)、每個原子的信賴分數 (plddt) 和 2D 預測對齊錯誤矩陣 (pae)。指定輸出目錄時,HTTP 回應酬載會省略 (空值) 大型酬載欄位 (structure_cif、plddt和pae),避免序列化瓶頸。所有原始模型輸出內容都會非同步匯出至指定的 Cloud Storage 值區。儲存在 Cloud Storage bucket 中的構件:指定輸出目錄 (
parameters.output_dir) 後,系統會將完整的預測結果上傳至 Cloud Storage。輸出資料夾包含的資料符合 GitHub 上的 AlphaFold 3 說明文件中發布的規格。
進行預測
Model Garden 部署作業可簡化端對端預測管道的執行作業,包括在單一 API 呼叫中執行資料管道和模型推論。下圖顯示 AlphaFold 3 預測的高階架構:
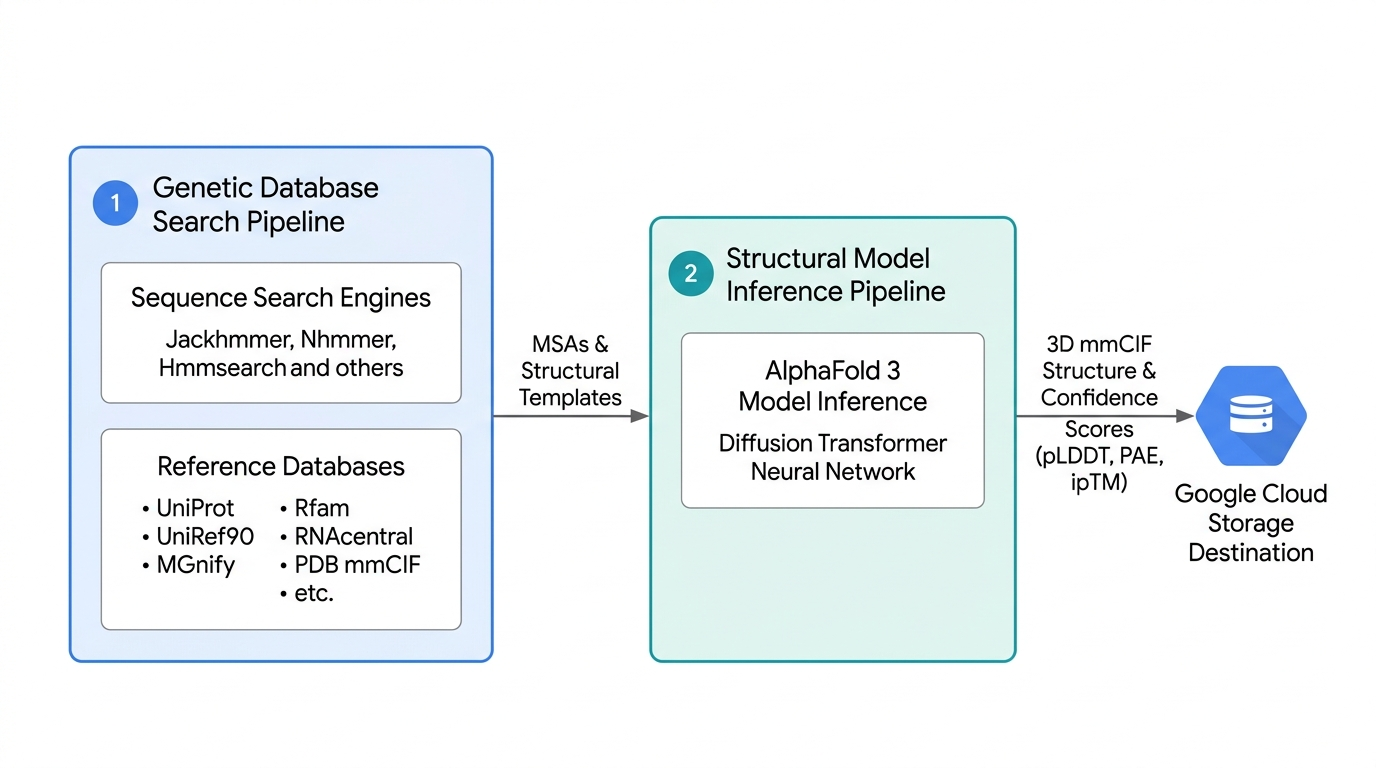
圖 1:完整的預測管道
執行預測時,強烈建議直接在參數中提供 Cloud Storage 值區,以匯出完整原始資料集,包括每個樣本的子目錄、排名資訊清單和原始輸出內容。如要查看所有可設定的要求欄位完整細目,包括多重隨機取樣、神經網路回收、擴散軌跡和自訂共價鍵的參數調整,請參閱 API 參考資料部分。
啟動長時間執行的摺疊工作或批次管道前,您可以執行模擬測試,快速驗證驗證、IAM 權限和端點網路連線。
預測選項
視工作流程而定,AlphaFold 3 處理作業可分為四種不同的執行模式:
模擬測試模式
如要驗證 API 連線、驗證、網路和 JSON 結構定義,而不啟動預測管道,可以在 parameters 物件中提交含有 "dry_run":
true 的要求。端點會執行所有驗證常式 (包括檢查 Cloud Storage 值區寫入權限和驗證序列字元),但會略過執行作業,並立即傳回空白的預測回應。
以下是模擬測試模式的 Python 指令碼範例:
from google.cloud import aiplatform

PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Connect to Dedicated Endpoint
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define prediction payload
instances = [
    {
        "name": "preflight_check",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                }
            }
        ],
    }
]

parameters = {
    "dry_run": True,
}

# Execute prediction request
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)
print(response.predictions)
端對端預測模式
如要執行端對端預測,請在單一要求中提交原始生物序列 (蛋白質、DNA、RNA、配體和 PTM)。端點會自動執行基因資料庫搜尋,並立即進行模型推論。如果摺疊作業沒有預先對齊,建議使用這項功能。
以下是端對端預測模式的 Python 指令碼範例:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/alphafold_output/"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "e2e_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
僅使用預先計算的 MSA 和範本進行推論
您可能已經有預先計算的 MSA 和 mmCIF 範本,這些範本來自先前的執行作業,或是在模型端點外產生。在這些情況下,只要提供比對結果和範本,即可完全略過基因資料庫搜尋,直接將要求傳送至結構預測程序。這也能大幅縮短推論回應時間。在下列情況下,建議採用這種做法:
- 如果針對單一靜態蛋白質目標對接多種不同的小分子配體,則可重複使用 MSA。
- 在多個隨機種子中,以疊代方式執行相同的分子序列,繪製結構彈性圖。
- 離線比對私人非公開基因體資料庫中的序列。
- 最佳化 AlphaFold 3 的 GPU 資源,只專注於結構生成。
以下是僅供推論模式使用的 Python 指令碼範例:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_protein_ligand_complex",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "modifications": [
                        {"ptmType": "HY3", "ptmPosition": 1}
                    ],
                    "unpairedMsaPath": "gs://YOUR_BUCKET_NAME/path/to/unpaired.a3m",
                    "pairedMsa": "",
                    "templates": [],
                }
            },
            {
                "ligand": {
                    "id": "B",
                    "ccdCodes": ["MG"],
                }
            },
        ],
    }
]

parameters = {
    "run_data_pipeline": False,
    "output_dir": STORAGE_OUTPUT_DIR,
    "force_output_dir": True,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters
)

print(response.predictions)
不使用 MSA 和範本執行
您也可以選擇完全略過基因資料庫搜尋和範本比對。模型只會使用查詢序列預測 3D 結構,不會使用同源序列或共同演化資訊。如要觸發此模式,請在執行個體中為 MSA 參數 unpairedMsa 和 pairedMsa 提供空字串,並為 templates 提供空清單,然後在參數中將 run_data_pipeline 設為 false。這項功能有助於設計合成或工程分子,或在沒有演化脈絡的情況下測試結構預測。
以下是執行 AlphaFold 3 MSA 和無範本的 Python 指令碼範例:
from google.cloud import aiplatform

# Configuration
PROJECT_ID = "YOUR_PROJECT_ID"
LOCATION = "us-west1"
ENDPOINT_ID = "YOUR_ENDPOINT_ID"
STORAGE_OUTPUT_DIR = "gs://YOUR_BUCKET_NAME/af3_results/inference_only_gcs_job"

# Initialize AI Platform SDK
aiplatform.init(project=PROJECT_ID, location=LOCATION)

# Instantiate Endpoint reference
endpoint = aiplatform.Endpoint(ENDPOINT_ID)

# Define Prediction Payload
instances = [
    {
        "name": "inference_only_gcs_job",
        "dialect": "alphafold3",
        "version": 4,
        "modelSeeds": [1, 2, 3],
        "sequences": [
            {
                "protein": {
                    "id": "A",
                    "sequence": "PVLSCGEWQL",
                    "unpairedMsa": "",
                    "pairedMsa": "",
                    "templates": [],
                }
            }
        ],
    }
]

parameters = {
    "output_dir": STORAGE_OUTPUT_DIR,
    "run_data_pipeline": False,
}

# Execute Prediction
response = endpoint.predict(
    instances=instances,
    parameters=parameters,
    timeout=3600.0,
)

print(response.predictions)
如需詳細規格、實體參數和輸出信賴度指標,請參閱 GitHub 上的 AlphaFold 3 說明文件。
預測輸出內容
AlphaFold 3 預測服務提供兩種互補的傳送機制,可擷取預測輸出內容。根據預設,API 回應會針對排名最高的候選人,以同步方式傳回預測結果。您可以選擇指定 Cloud Storage 目錄。
以下各節將概述預測輸出內容。如需更多詳細資料,請參閱 GitHub 上的 AlphaFold 3 說明文件。
內嵌回覆與已儲存構件
AlphaFold 3 預測服務支援兩種主要輸出模式:
- 內嵌回應:只會傳回排名最高的候選項目,並直接在 HTTP REST 回應酬載中提供 3D 結構座標和信賴度指標。非常適合快速互動式原型設計或單一序列查詢。
- 儲存的構件 (Cloud Storage):指定輸出目錄會將完整的多樣本資料集匯出至 Cloud Storage。包括每個產生的隨機種子和擴散樣本的個別座標檔案、信賴度 JSON、距離圖、嵌入和摘要指標。建議您使用 Cloud Storage 處理實際工作環境負載、對應構象集合,以及略過要求酬載大小限制。
以下 Python 範例說明如何從 Cloud Storage 擷取已儲存的構件,以進行後續分析:
from google.cloud import storage

BUCKET_NAME = "your-bucket-name"
JOB_NAME = "my_alphafold_job"
STORAGE_PREFIX = f"af3_results/my_folder/{JOB_NAME}"

# Initialize GCS client
client = storage.Client(project="your-project-id")
bucket = client.bucket(BUCKET_NAME)

# Download the top-ranked 3D structure and global ranking ledger
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_model.cif").download_to_filename("model.cif")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_ranking_scores.csv").download_to_filename("ranking_scores.csv")
bucket.blob(f"{STORAGE_PREFIX}/{JOB_NAME}_summary_confidences.json").download_to_filename("summary.json")
由於 AlphaFold 3 採用生成式擴散模型,因此每次預測執行作業都會在種子和取樣軌跡中,生成一組候選 3D 結構。評估及比較這些候選執行作業,有助於在執行詳細的結構分析前,解讀預測輸出內容。
您可以使用下列三個核心檔案,調查完整的複合樣本構件資料集:
ranking_scores.csv:主要分類帳,列出所有產生的軌跡配對及其複合ranking_score。資料列會依軌跡執行順序儲存 (先依種子遞增排序,再依樣本索引遞增排序),不會預先依分數排序。使用者應依ranking_score遞減排序,找出候選排名。summary_confidences.json:包含頂尖候選人的全域品質指標 (pTM、ipTM、has_clash、fraction_disordered)。每個樣本
summary_confidences.json:位於個別seed-{SEED}_sample-{INDEX}/資料夾內,可讓您視需要檢查特定非頂尖候選項目執行的鏈結層級 pTM 和 ipTM 矩陣。
下列 Python 範例會剖析 ranking_scores.csv 和 summary_confidences.json,以排列候選樣本的優先順序,並驗證最高候選樣本的品質:
import csv
import json

print("=== Candidate Samples Ledger (ranking_scores.csv) ===")
with open("ranking_scores.csv", "r", newline="", encoding="utf-8") as f:
    rows = sorted(
        csv.DictReader(f), key=lambda x: float(x["ranking_score"]), reverse=True
    )

# Calculate column widths cleanly and readably
headers = list(rows[0].keys())
widths = {}
for col in headers:
    lengths = [len(col)] + [len(r[col]) for r in rows]
    widths[col] = max(lengths)

print("  ".join(col.rjust(widths[col]) for col in headers))
for r in rows:
    print("  ".join(r[col].rjust(widths[col]) for col in headers))

top = rows[0]
print(
    f"\nPromoted Top Candidate: Seed {int(top['seed'])}, Sample"
    f" {int(top['sample'])} (Score: {float(top['ranking_score']):.4f})"
)

print("\n=== Top Candidate Quality Validation (summary.json) ===")
with open("summary.json", "r", encoding="utf-8") as f:
    summary = json.load(f)

clash_str = (
    "DETECTED (FAIL)" if summary.get("has_clash") else "None Detected (PASS)"
)
print("Top Candidate Metrics:")
print(f"  • Ranking Score : {summary.get('ranking_score', 'N/A')}")
print(f"  • Global pTM    : {summary.get('ptm', 'N/A')}")
print(f"  • Interface ipTM: {summary.get('iptm', 'N/A')}")
print(f"  • Steric Clash  : {clash_str}")
如要查看儲存檔案和 mmCIF 屬性的完整結構定義規格,請參閱 GitHub 上的 AlphaFold 3 說明文件。此外,請參閱 EMBL-EBI 的「如何評估 AlphaFold 3 預測的品質」指南,瞭解如何評估預測品質。
最佳做法
以下各節說明在 Agent Platform 上使用 AlphaFold 3 的最佳做法:
減少要求逾時
Agent Platform 上的端點會對每個要求強制執行預設的執行逾時上限,即 60 分鐘。為確保預測作業順利完成,不會逾時,請遵守下列規範:
- 避免在單一要求中過度取樣:在單一 API 呼叫中初始化大量種子或過高的反向擴散參數,可能會導致執行時間超過 60 分鐘上限。
- 分解大型掃描:對於大規模研究,請將種子和參數掃描分成多個較小的預測有效負載,並以個別工作形式提交。這項功能也會充分運用端點的自動調整容量。
略過 MSA 搜尋
基因資料庫搜尋管道是 AlphaFold 管道中最耗時的階段。對相同序列執行疊代預測時 (例如對固定蛋白質目標執行配體篩選掃描),完全略過資料庫搜尋可大幅縮短執行時間:
- 擷取 MSA:執行初始端對端預測,並指定 Cloud Storage 輸出目錄 (
output_dir)。從輸出 Cloud Storage bucket 下載產生的{JOB_NAME}_data.json檔案。 - 只提交推論預測:在 JSON 檔案中找出
unpairedMsa和pairedMsa欄位。擷取這些 MSA 字串,並使用unpairedMsaPath和pairedMsaPath指向 Cloud Storage URI,將這些字串傳遞至後續的預測要求。
或者,您也可以在自己的基礎架構上執行 MSA 搜尋,並在預測要求中輸入預先計算的 MSA 範本。
處理可信度偏低的執行作業
如果預測輸出內容產生低信賴度指標,請嘗試進行有目標的補救,而不是將其視為無法復原的預測失敗。最佳化特定參數可讓您探查其他潛在軌跡。本節列出一些方法,可在預測結果的信賴度偏低時進行復原。
使用多重隨機數取樣
AlphaFold 3 會從潛在空間中的隨機雜訊,初始化 3D 座標生成作業。如果使用特定單一隨機數提交預測,擴散軌跡可能會與其他隨機數不同。傳遞種子陣列會強制模型從不同狀態開始取樣軌跡。
多重隨機數產生器取樣有兩項重要優點:驗證獨立執行作業的結構一致性,以及探查功能構象動態。舉例來說,如果五個種子都收斂到相同的 3D 座標,您就能對全域摺疊有高度信心。反之,如果不同的種子產生不同的高信賴度結合姿勢,則整體可能揭示具有生物學意義的構象狀態,例如開放與封閉的活性部位迴路,或替代的網域交換二聚物。
擴展擴散軌跡
modelSeeds 會改變潛在空間中的起始雜訊狀態,而 num_diffusion_samples 參數 (預設為 5) 則會控制在反向擴散過程中,每個種子產生的候選 3D 結構數量。如果是彈性迴路區域或淺層繫結口袋,增加取樣會擴大每個種子的候選集區。如果特定迴圈的本機信賴分數偏低 (pLDDT < 70),但整體網域摺疊仍具信賴度 (pTM > 0.80),這項做法就特別有效。這有助於發掘高信賴度的候選結構,這些結構可能在初始執行時遭到忽略。
增加回收疊代次數
在擴散模組生成 3D 座標之前,AlphaFold 3 會先處理序列和成對特徵。num_recycles 參數會決定中間結構表示法和成對空間嵌入內容,透過網路反覆饋送的次數。
對於大型複雜分子或共演化訊號較弱的目標,增加 num_recycles 可讓主幹網路進行額外疊代,以解析遠距鏈之間的空間關係,再將輸入內容傳遞至擴散模組。如果個別鏈結顯示高區域摺疊信賴度 (pLDDT > 70),但非對角 PAE 矩陣顯示高鏈結間不確定度 (> 15 Å),即可嘗試這種做法。請注意,回收次數增加會導致預測執行階段時間線性增加,因此應保留給難以處理的介面目標。
使用自訂對齊管道
AlphaFold 3 會自動執行基因資料庫搜尋管道,產生 MSA 範本。使用者也可以使用 unpairedMsaPath 和 pairedMsaPath,透過 Cloud Storage URI 提供 .a3m 格式的私密預先計算自訂對齊方式。提供深層 MSA 可產生強大的共同演化限制,經常將低信賴度預測轉換為高信賴度模型。