

במדריך הזה נסביר איך לפרוס את מודל Meta-Llama-3.1-8B ב-Gemini Enterprise Agent Platform. תלמדו איך לפרוס נקודות קצה ולבצע אופטימיזציה לפי הצרכים הספציפיים שלכם. אם יש לכם עומסי עבודה עמידים בכשלים, אתם יכולים להשתמש במכונות וירטואליות זמניות (Spot VMs) כדי לבצע אופטימיזציה של העלויות. אם רוצים להבטיח זמינות, כדאי להשתמש בהזמנות ב-Compute Engine. במאמר הזה מוסבר איך לפרוס נקודות קצה שמשתמשות ב:
- מכונות וירטואליות מסוג Spot: שימוש במכונות וירטואליות מסוג Spot מאפשר לחסוך בעלויות.
- הזמנות: הזמנות מבטיחות זמינות של משאבים לביצועים צפויים, במיוחד לעומסי עבודה של ייצור. במדריך הזה מוצג שימוש בשמירת מקום אוטומטית (
ANY_RESERVATION) ובשמירת מקום ספציפית (SPECIFIC_RESERVATION).
מידע נוסף זמין במאמרים בנושא מכונות וירטואליות מסוג Spot או איך מבקשים מקום שמור למשאבים של Compute Engine.
דרישות מוקדמות
לפני שמתחילים, צריך לוודא שהתנאים הבאים מתקיימים:
- Cloud de Confiance by S3NS פרויקט שהחיוב בו מופעל.
- הפעלתם את Gemini Enterprise Agent Platform ואת Compute Engine APIs.
- מכסת שימוש מספיקה לסוג המכונה ולמאיץ שבהם אתם מתכוונים להשתמש, כמו GPU מסוג NVIDIA L4. כדי לבדוק את מכסות השימוש, אפשר לעיין במאמר מכסות שימוש ומגבלות מערכת במסוף. Cloud de Confiance
- חשבון ב-Hugging Face וטוקן גישה למשתמש עם הרשאת קריאה.
- אם אתם משתמשים בהזמנות משותפות, צריך להעניק הרשאות IAM בין הפרויקטים. כל ההרשאות האלה מפורטות ב-Notebook.
פריסה ב-VMs במודל Spot
בקטעים הבאים מפורט תהליך ההגדרה של Cloud de Confiance by S3NS הפרויקט, הגדרת האימות של Hugging Face, פריסת מודל Llama-3.1 באמצעות מכונות וירטואליות מסוג Spot או הזמנות, ובדיקת הפריסה.
1. הגדרה של Cloud de Confiance by S3NS פרויקט ומקום שמור משותף
פותחים את הנוטבוק של Colab Enterprise.
בקטע הראשון, מגדירים את המשתנים PROJECT_ID, SHARED_PROJECT_ID (אם רלוונטי), BUCKET_URI ו-REGION בנוטבוק של Colab.
מחברת ה-notebook מקצה את התפקיד compute.viewer לחשבון השירות של שני הפרויקטים.
אם אתם מתכוונים להשתמש במקום שמור שנוצר בפרויקט אחר באותו ארגון, הקפידו להעניק את התפקיד compute.viewer ל-P4SA (חשבון שירות ראשי) של שני הפרויקטים. קוד הנוטבוק יבצע זאת באופן אוטומטי, אבל חשוב לוודא שההגדרה SHARED_PROJECT_ID נכונה. ההרשאה הזו בין פרויקטים מאפשרת לנקודת הקצה של Gemini Enterprise Agent Platform בפרויקט הראשי שלכם לראות את קיבולת המקום השמור בפרויקט המשותף ולהשתמש בה.
2. הגדרת אימות של Hugging Face
כדי להוריד את מודל Llama-3.1, צריך לספק את טוקן הגישה של המשתמש ב-Hugging Face במשתנה HF_TOKEN בתוך נוטבוק של Colab. אם לא תציינו את המידע הזה, תוצג השגיאה הבאה: Cannot access gated repository for URL.
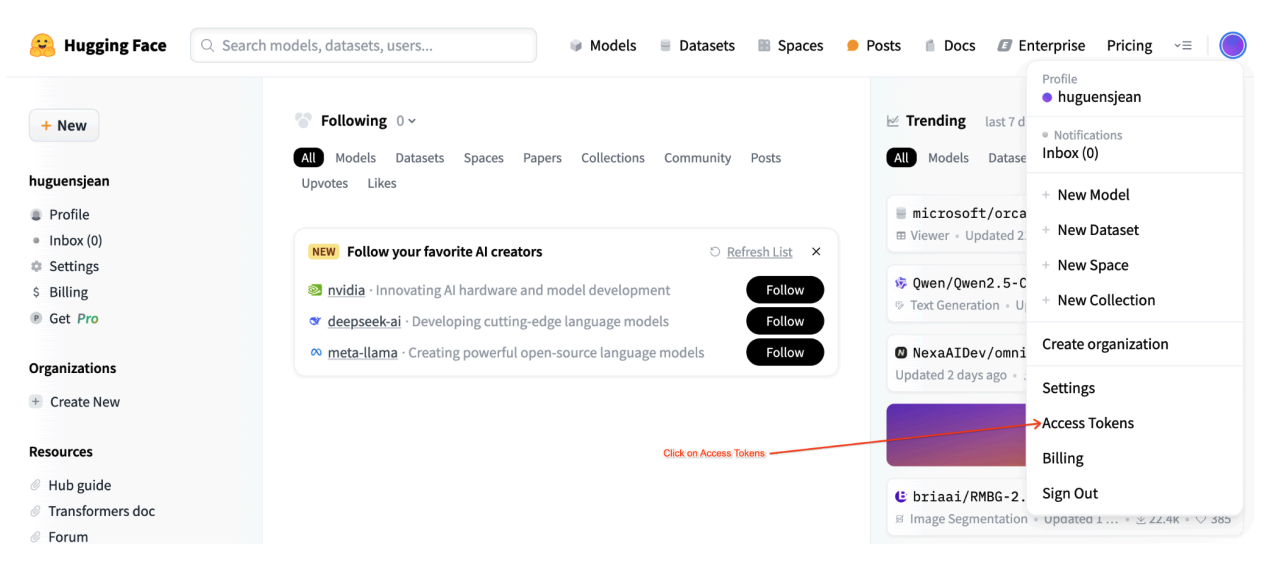 איור 1: הגדרות של טוקן גישה ב-Hugging Face
3. פריסה באמצעות VM במודל Spot
כדי לפרוס את מודל Llama ל-VM במודל Spot, עוברים לקטע Spot VM Gemini Enterprise Agent Platform Endpoint Deployment (פריסת נקודת קצה של פלטפורמת סוכני Gemini Enterprise ב-VM במודל Spot) בנוטבוק של Colab ומגדירים את is_spot=True.
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = "meta-llama/" + base_model_name

if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
    max_loras = 5
else:
    raise ValueError(
        f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}."
    )

common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)

gpu_memory_utilization = 0.95
max_model_len = 8192

models["vllm_gpu_spotvm"], endpoints["vllm_gpu_spotvm"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix="llama3_1-serve-spotvm"),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=False,
    model_type="llama3.1",
    is_spot=True,
)
פריסה במופעים של הזמנה משותפת
בקטעים הבאים מוסבר איך ליצור הזמנה משותפת, להגדיר את ההגדרות של ההזמנה, לפרוס את מודל Llama-3.1 באמצעות ANY_RESERVATION או SPECIFIC_RESERVATION ולבדוק את הפריסה.
1. יצירת הזמנה משותפת
כדי להגדיר את ההזמנות, עוברים לקטע Set Up Reservations for Gemini Enterprise Agent Platform Predictions (הגדרת הזמנות לחיזויים של Gemini Enterprise Agent Platform) במחברת. מגדירים את המשתנים הנדרשים להזמנה, כמו RES_ZONE, RESERVATION_NAME, RES_MACHINE_TYPE, RES_ACCELERATOR_TYPE ו-RES_ACCELERATOR_COUNT.
אתם נדרשים להגדיר את RES_ZONE כ-{REGION}-{availability_zone}
RES_ZONE = "a"
RES_ZONE = f"{REGION}-{RES_ZONE}"

RESERVATION_NAME = "shared-reservation-1"
RESERVATION_NAME = f"{PROJECT_ID}-{RESERVATION_NAME}"
RES_MACHINE_TYPE = "g2-standard-12"
RES_ACCELERATOR_TYPE = "nvidia-l4"
RES_ACCELERATOR_COUNT = 1
rev_names.append(RESERVATION_NAME)

create_reservation(
    res_project_id=PROJECT_ID,
    res_zone=RES_ZONE,
    res_name=RESERVATION_NAME,
    res_machine_type=RES_MACHINE_TYPE,
    res_accelerator_type=RES_ACCELERATOR_TYPE,
    res_accelerator_count=RES_ACCELERATOR_COUNT,
    shared_project_id=SHARED_PROJECT_ID,
)
2. שיתוף ההזמנות
יש שני סוגים של הזמנות: הזמנות לפרויקט יחיד (ברירת המחדל) והזמנות משותפות. מכונות וירטואליות יכולות להשתמש בהזמנות של פרויקט יחיד רק אם הן נמצאות באותו פרויקט כמו ההזמנה עצמה. לעומת זאת, במכונות וירטואליות בפרויקט שבו נמצאת ההזמנה, וגם במכונות וירטואליות בכל פרויקט אחר שאליו שותפה ההזמנה. שימוש בהזמנות משותפות יכול לשפר את הניצול של המשאבים המוזמנים ולהפחית את המספר הכולל של ההזמנות שצריך ליצור ולנהל. המדריך הזה מתמקד בהזמנות משותפות. מידע נוסף זמין במאמר בנושא איך פועלות הזמנות משותפות.
לפני שממשיכים, חשוב לוודא ששיתפתם עם שירותים אחרים של Google דרך Cloud de Confiance by S3NS המסוף, כמו שמוצג באיור:
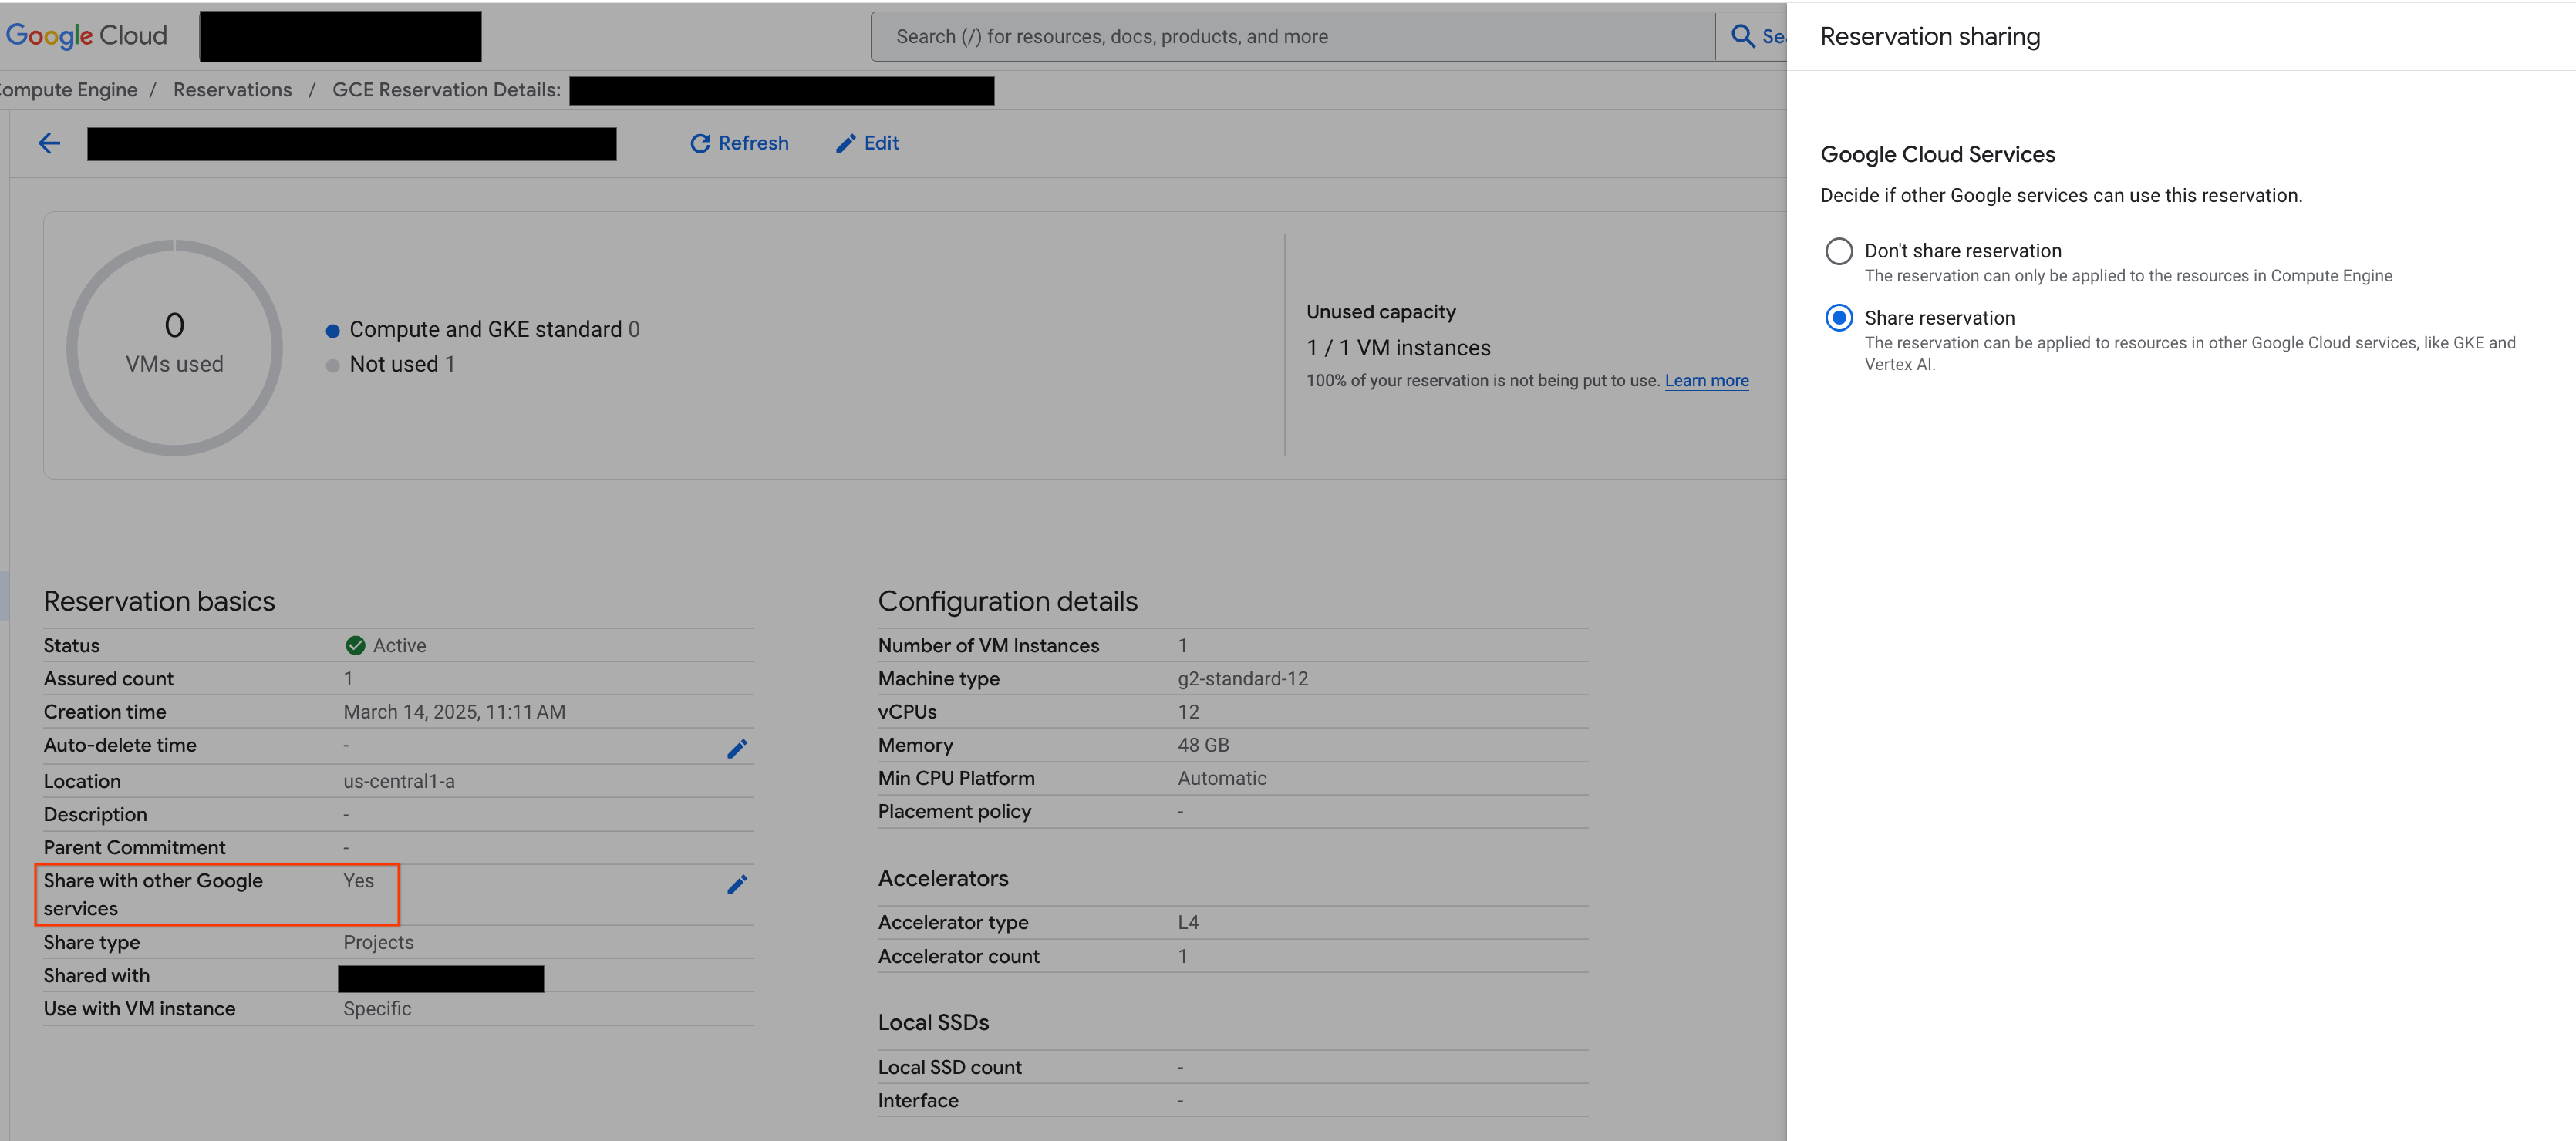 איור 2: שיתוף הזמנה עם שירותים אחרים של Google
3. פריסה עם ANY_RESERVATION
כדי לפרוס את נקודת הקצה באמצעות ANY_RESERVATION, עוברים לקטע 'פריסת נקודת קצה של Llama-3.1 באמצעות ANY_RESERVATION' במחברת. מציינים את הגדרות הפריסה ומגדירים את reservation_affinity_type="ANY_RESERVATION". לאחר מכן, מריצים את התא כדי לפרוס את נקודת הקצה.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

models["vllm_gpu_any_reserve"], endpoints["vllm_gpu_any_reserve"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-any-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_affinity_type="ANY_RESERVATION",
)
4. בדיקת נקודת הקצה ANY_RESERVATION
אחרי פריסת נקודת הקצה, חשוב לבדוק כמה הנחיות כדי לוודא שהיא נפרסה בצורה תקינה.
5. פריסה עם SPECIFIC_RESERVATION
כדי לפרוס את נקודת הקצה באמצעות SPECIFIC_RESERVATION, עוברים לקטע 'פריסת נקודת קצה של Llama-3.1 באמצעות SPECIFIC_RESERVATION' במחברת. מציינים את הפרמטרים הבאים: reservation_name, reservation_affinity_type="SPECIFIC_RESERVATION", reservation_project וreservation_zone. לאחר מכן, מריצים את התא כדי לפרוס את נקודת הקצה.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

MACHINE_TYPE = "g2-standard-12"
ACCELERATOR_TYPE = "NVIDIA_L4"
ACCELERATOR_COUNT = 1

(
    models["vllm_gpu_specific_reserve"],
    endpoints["vllm_gpu_specific_reserve"],
) = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-specific-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_name=RESERVATION_NAME,
    reservation_affinity_type="SPECIFIC_RESERVATION",
    reservation_project=PROJECT_ID,
    reservation_zone=RES_ZONE,
)
6. בדיקה של נקודת הקצה SPECIFIC_RESERVATION
אחרי פריסת נקודת הקצה, צריך לוודא ש-Gemini Enterprise Agent Platform משתמש בהזמנה לחיזוי אונליין, ולבדוק כמה הנחיות כדי לוודא שהפריסה בוצעה בצורה תקינה.
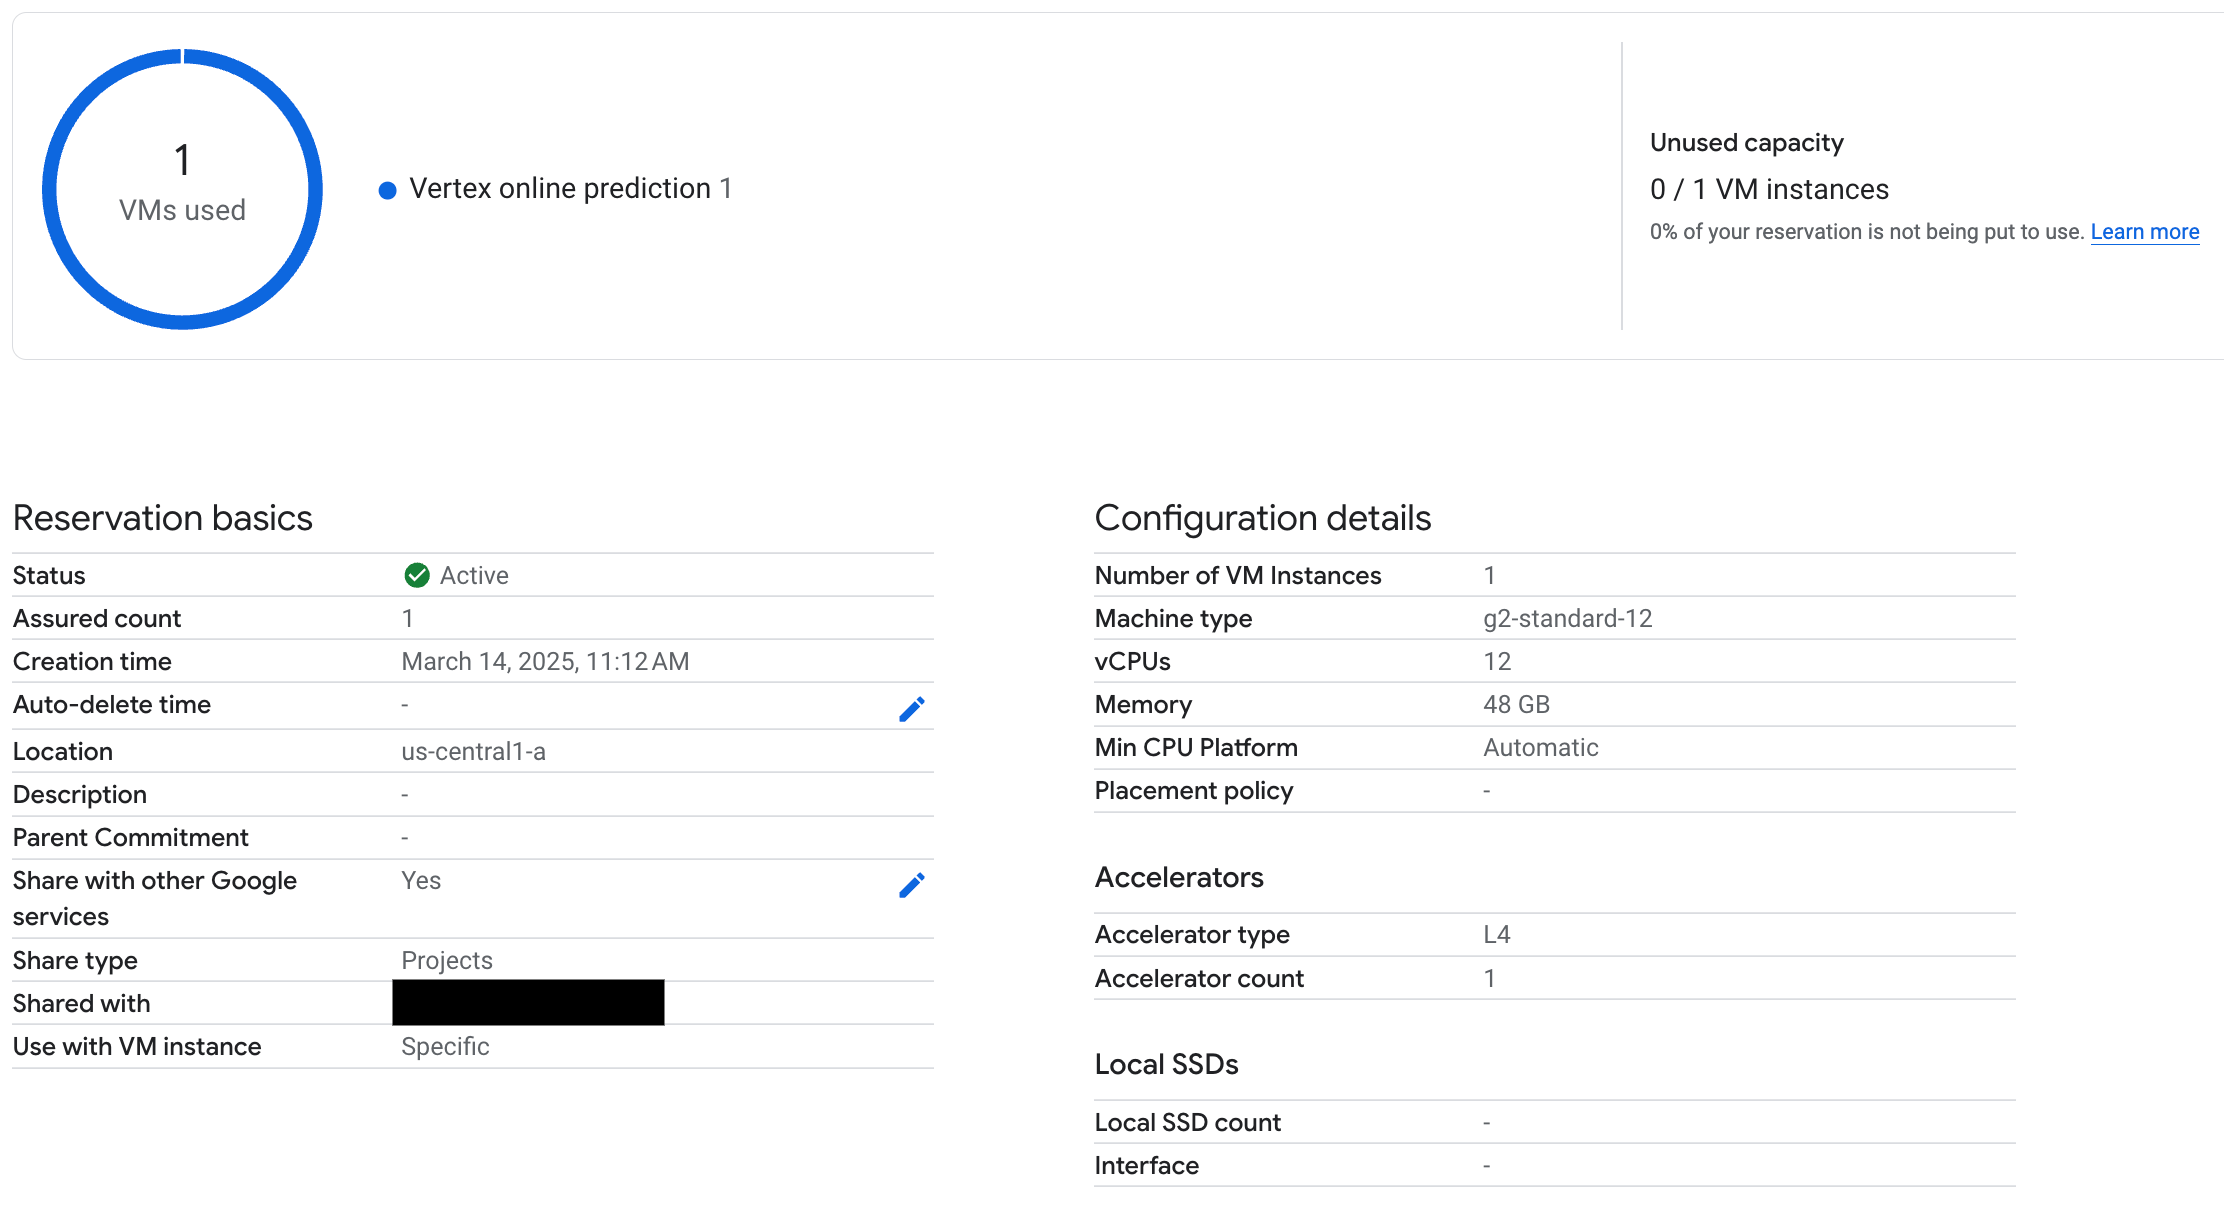 איור 3: בדיקת ההזמנה משמשת לחיזוי אונליין של Vertex
7. הסרת המשאבים
כדי להימנע מחיובים שוטפים, צריך למחוק את המודלים, נקודות הקצה ומקומות שמורים שנוצרו במהלך המדריך הזה. ב-נוטבוק של Colab יש קוד בקטע Clean Up (ניקוי) שמבצע את תהליך הניקוי הזה באופן אוטומטי.
פתרון בעיות
- שגיאות באסימון Hugging Face: צריך לוודא שלאסימון Hugging Face יש הרשאות
readוהוא מוגדר בצורה נכונה במחברת. - שגיאות שקשורות למכסה: צריך לוודא שיש לכם מספיק מכסת GPU באזור שבו אתם מבצעים פריסה. אם צריך, אפשר לבקש הגדלה של המכסה.
- התנגשויות בהזמנות: מוודאים שסוג המכונה והגדרות התאוצה של פריסת נקודת הקצה תואמים להגדרות ההזמנה. מוודאים שההזמנות מופעלות לשיתוף עם שירותי Google
השלבים הבאים
- אפשר לנסות וריאציות שונות של מודל Llama 3.
- מידע נוסף על הזמנות
- מידע נוסף על מכונות וירטואליות מסוג Spot זמין במאמר Spot VMs Overview.