

Questo tutorial ti guida attraverso il deployment del modello Meta-Llama-3.1-8B su Gemini Enterprise Agent Platform. Scoprirai come eseguire il deployment degli endpoint e ottimizzarli per le tue esigenze specifiche. Se hai workload a tolleranza di errore, puoi ottimizzare i costi utilizzando le VM spot. Se vuoi garantire la disponibilità, utilizza le prenotazioni di Compute Engine. Scoprirai come eseguire il deployment degli endpoint che utilizzano:
- VM spot: utilizza le istanze con provisioning spot per ottenere un notevole risparmio sui costi.
- Prenotazioni: garantisci la disponibilità delle risorse per prestazioni prevedibili, soprattutto per i workload di produzione. Questo tutorial mostra l'utilizzo di prenotazioni automatiche (
ANY_RESERVATION) e specifiche (SPECIFIC_RESERVATION).
Per ulteriori informazioni, consulta VM spot o Prenotazioni di risorse di Compute Engine.
Prerequisiti
Prima di iniziare, completa i seguenti prerequisiti:
- Un Cloud de Confiance by S3NS progetto con la fatturazione abilitata.
- Le API Gemini Enterprise Agent Platform e Compute Engine abilitate.
- Quota sufficiente per il tipo di macchina e l'acceleratore che intendi utilizzare, ad esempio le GPU NVIDIA L4. Per controllare le quote, consulta Quote e limiti di sistema nella Cloud de Confiance console.
- Un account Hugging Face e un token di accesso utente con accesso in lettura.
- Se utilizzi prenotazioni condivise, concedi le autorizzazioni IAM tra i progetti. Queste autorizzazioni sono tutte trattate nel notebook.
Esegui il deployment sulle VM spot
Le sezioni seguenti ti guideranno attraverso la configurazione del tuo Cloud de Confiance by S3NS progetto, la configurazione dell'autenticazione di Hugging Face, il deployment del modello Llama-3.1 utilizzando VM spot o prenotazioni e il test del deployment.
1. Configura il tuo Cloud de Confiance by S3NS progetto e la prenotazione condivisa
Apri il notebook di Colab Enterprise.
Nella prima sezione, imposta le variabili PROJECT_ID, SHARED_PROJECT_ID (se applicabile), BUCKET_URI e REGION nel notebook di Colab.
Il notebook concede il ruolo compute.viewer al account di servizio di entrambi i progetti.
Se intendi utilizzare una prenotazione creata in un progetto diverso all'interno della stessa organizzazione, assicurati di concedere il ruolo compute.viewer al P4SA (Principal Service Account) di entrambi i progetti. Il codice del notebook automatizzerà questa operazione, ma assicurati che SHARED_PROJECT_ID sia impostato correttamente. Questa autorizzazione tra progetti consente all'endpoint di Gemini Enterprise Agent Platform nel progetto principale di visualizzare e utilizzare la capacità di prenotazione nel progetto condiviso.
2. Configura l'autenticazione di Hugging Face
Per scaricare il modello Llama-3.1, devi fornire il token di accesso utente di Hugging Face nella variabile HF_TOKEN all'interno del notebook di Colab. Se non ne fornisci uno, viene visualizzato il seguente errore: Cannot access gated repository for URL.
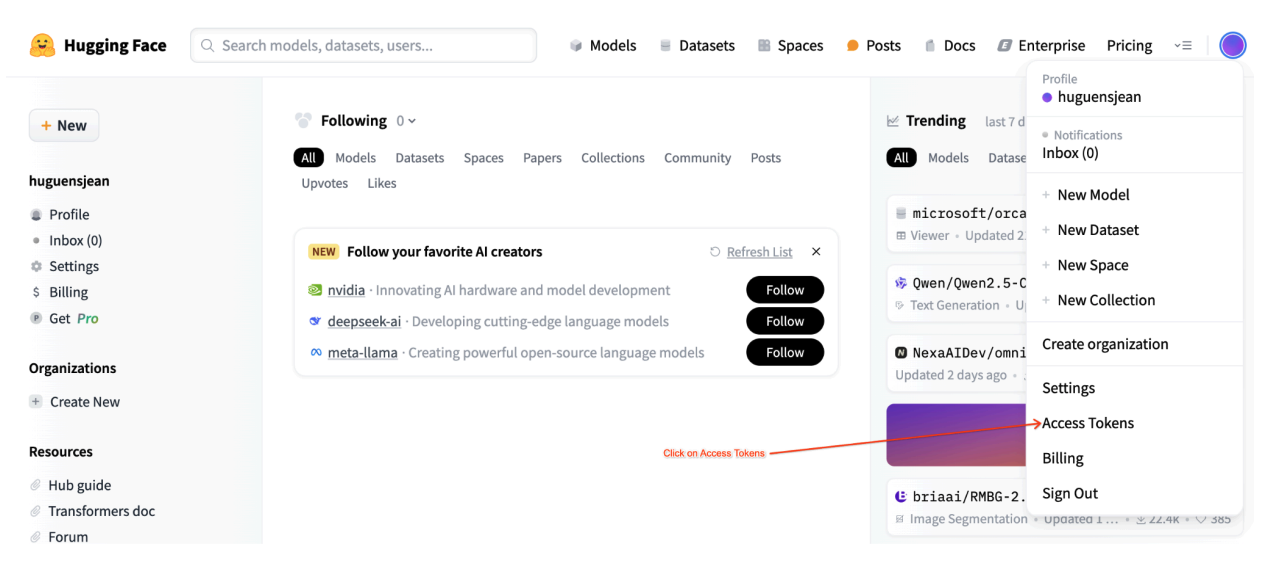 Figura 1: Impostazioni del token di accesso a Hugging Face
3. Esegui il deployment con la VM spot
Per eseguire il deployment del modello Llama su una VM spot, vai alla sezione "Spot VM Gemini Enterprise Agent Platform Endpoint Deployment" (Deployment dell'endpoint di Gemini Enterprise Agent Platform della VM spot) nel notebook di Colab e imposta is_spot=True.
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = "meta-llama/" + base_model_name

if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
    max_loras = 5
else:
    raise ValueError(
        f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}."
    )

common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)

gpu_memory_utilization = 0.95
max_model_len = 8192

models["vllm_gpu_spotvm"], endpoints["vllm_gpu_spotvm"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix="llama3_1-serve-spotvm"),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=False,
    model_type="llama3.1",
    is_spot=True,
)
Esegui il deployment sulle istanze di prenotazione condivisa
Le sezioni seguenti ti guideranno attraverso la creazione di una prenotazione condivisa, la configurazione delle impostazioni di prenotazione, il deployment del modello Llama-3.1 utilizzando ANY_RESERVATION o SPECIFIC_RESERVATION e il test del deployment.
1. Crea una prenotazione condivisa
Per configurare le prenotazioni, vai alla sezione "Set Up Reservations for Gemini Enterprise Agent Platform Predictions" (Configura le prenotazioni per le previsioni di Gemini Enterprise Agent Platform) del notebook. Imposta le variabili richieste per la prenotazione, ad esempio RES_ZONE, RESERVATION_NAME, RES_MACHINE_TYPE, RES_ACCELERATOR_TYPE e RES_ACCELERATOR_COUNT.
Devi impostare RES_ZONE su {REGION}-{availability_zone}
RES_ZONE = "a"
RES_ZONE = f"{REGION}-{RES_ZONE}"

RESERVATION_NAME = "shared-reservation-1"
RESERVATION_NAME = f"{PROJECT_ID}-{RESERVATION_NAME}"
RES_MACHINE_TYPE = "g2-standard-12"
RES_ACCELERATOR_TYPE = "nvidia-l4"
RES_ACCELERATOR_COUNT = 1
rev_names.append(RESERVATION_NAME)

create_reservation(
    res_project_id=PROJECT_ID,
    res_zone=RES_ZONE,
    res_name=RESERVATION_NAME,
    res_machine_type=RES_MACHINE_TYPE,
    res_accelerator_type=RES_ACCELERATOR_TYPE,
    res_accelerator_count=RES_ACCELERATOR_COUNT,
    shared_project_id=SHARED_PROJECT_ID,
)
2. Condividi le prenotazioni
Esistono due tipi di prenotazioni: le prenotazioni per un singolo progetto (impostazione predefinita) e le prenotazioni condivise. Le prenotazioni per un singolo progetto possono essere utilizzate solo dalle VM all'interno dello stesso progetto della prenotazione stessa. Le prenotazioni condivise, d'altra parte, possono essere utilizzate dalle VM nel progetto in cui si trova la prenotazione, nonché dalle VM in qualsiasi altro progetto con cui la prenotazione è stata condivisa. L'utilizzo delle prenotazioni condivise può migliorare l'utilizzo delle risorse riservate e ridurre il numero complessivo di prenotazioni che devi creare e gestire. Questo tutorial è incentrato sulle prenotazioni condivise. Per ulteriori informazioni, consulta Come funzionano le prenotazioni condivise.
Prima di procedere, assicurati di "Condividi con altri servizi Google" dalla Cloud de Confiance by S3NS console, come mostrato nella figura:
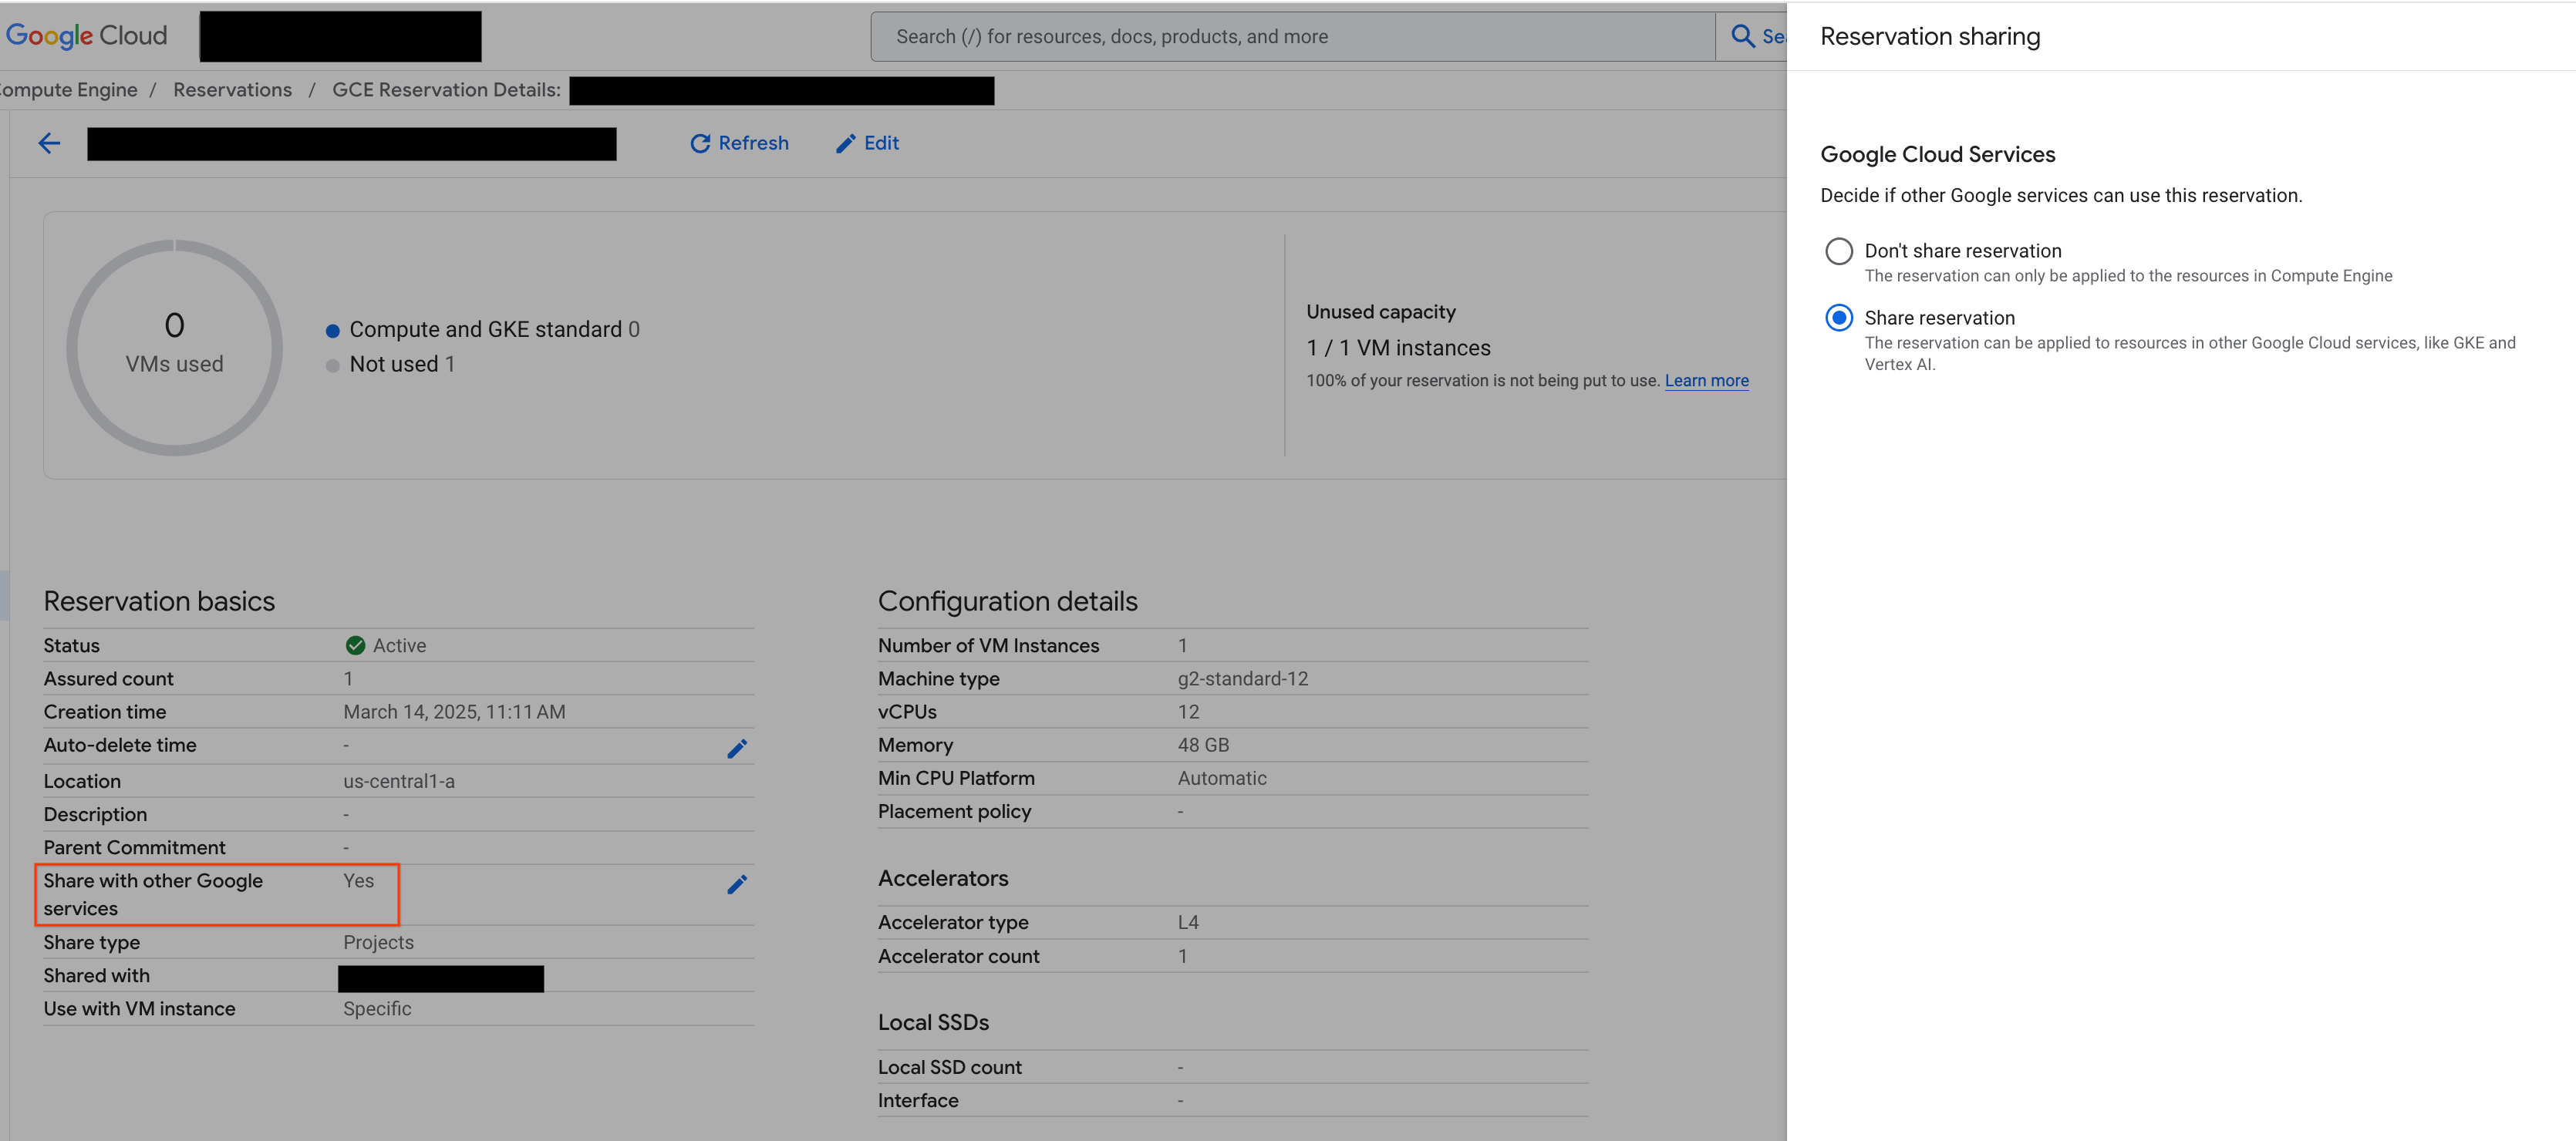 Figura 2: Condividi la prenotazione con altri servizi Google
3. Esegui il deployment con ANY_RESERVATION
Per eseguire il deployment dell'endpoint utilizzando ANY_RESERVATION, vai alla sezione "Deploy Llama-3.1 Endpoint with ANY_RESERVATION" (Esegui il deployment dell'endpoint Llama-3.1 con ANY_RESERVATION) del notebook. Specifica le impostazioni di deployment e poi imposta reservation_affinity_type="ANY_RESERVATION". Quindi, esegui la cella per eseguire il deployment dell'endpoint.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

models["vllm_gpu_any_reserve"], endpoints["vllm_gpu_any_reserve"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-any-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_affinity_type="ANY_RESERVATION",
)
4. Testa l'endpoint ANY_RESERVATION
Dopo aver eseguito il deployment dell'endpoint, assicurati di testare alcuni prompt per verificare che sia stato eseguito correttamente.
5. Esegui il deployment con SPECIFIC_RESERVATION
Per eseguire il deployment dell'endpoint utilizzando SPECIFIC_RESERVATION, vai alla sezione "Deploy Llama-3.1 Endpoint with SPECIFIC_RESERVATION" (Esegui il deployment dell'endpoint Llama-3.1 con SPECIFIC_RESERVATION) del notebook. Specifica i seguenti parametri: reservation_name, reservation_affinity_type="SPECIFIC_RESERVATION", reservation_project e reservation_zone. Quindi, esegui la cella per eseguire il deployment dell'endpoint.
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

MACHINE_TYPE = "g2-standard-12"
ACCELERATOR_TYPE = "NVIDIA_L4"
ACCELERATOR_COUNT = 1

(
    models["vllm_gpu_specific_reserve"],
    endpoints["vllm_gpu_specific_reserve"],
) = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-specific-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_name=RESERVATION_NAME,
    reservation_affinity_type="SPECIFIC_RESERVATION",
    reservation_project=PROJECT_ID,
    reservation_zone=RES_ZONE,
)
6. Testa l'endpoint SPECIFIC_RESERVATION
Dopo aver eseguito il deployment dell'endpoint, verifica che la prenotazione venga utilizzata dalla previsione online di Gemini Enterprise Agent Platform e assicurati di testare alcuni prompt per verificare che sia stato eseguito correttamente.
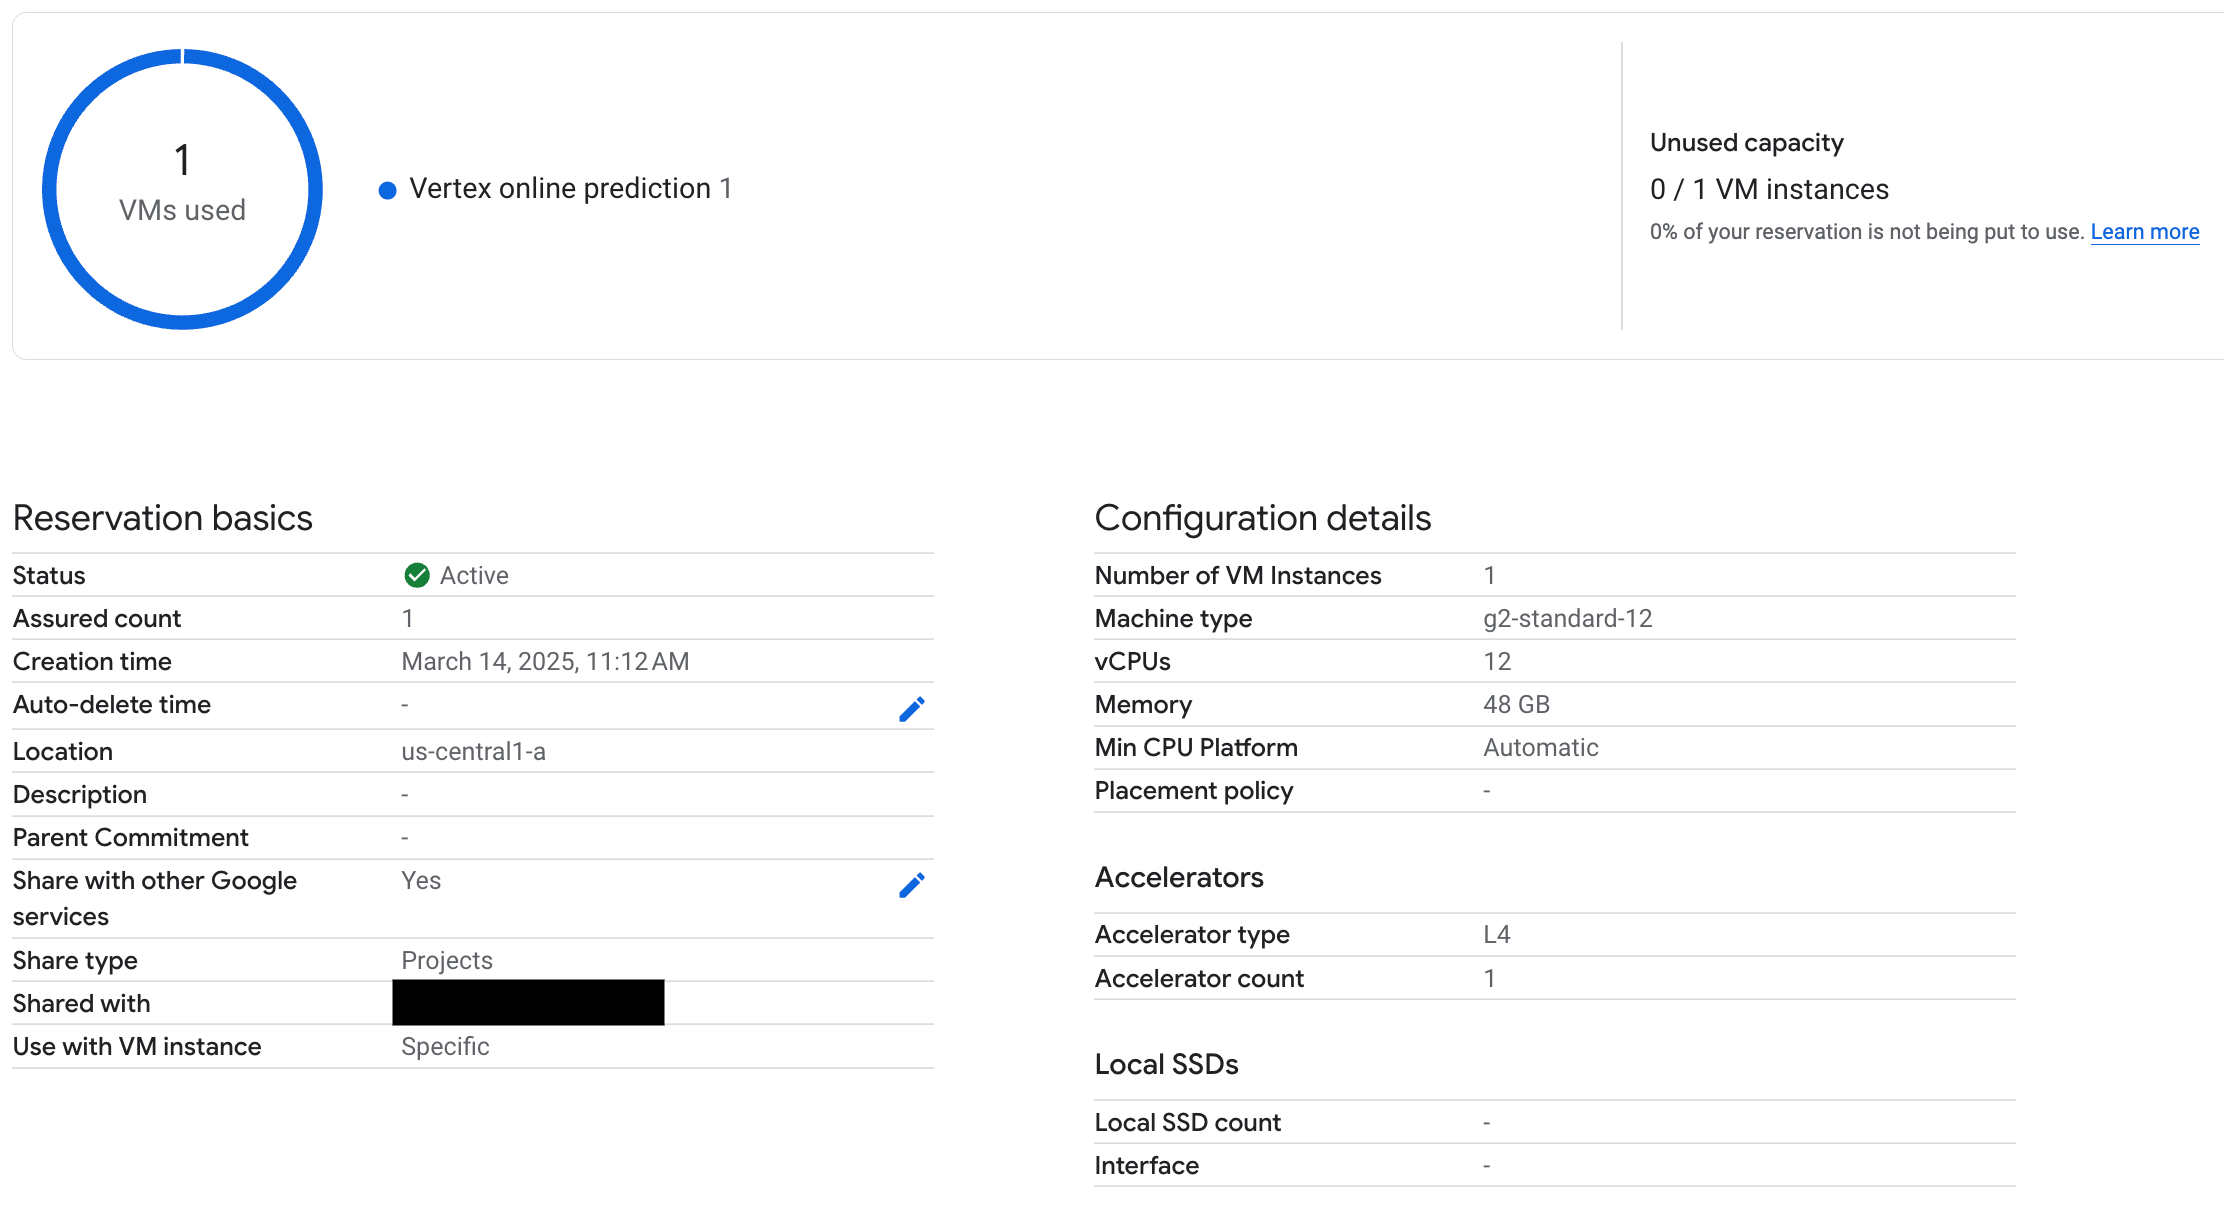 Figura 3: Verifica che la prenotazione venga utilizzata dalla previsione online di Vertex
7. Libera spazio
Per evitare addebiti continui, elimina i modelli, gli endpoint e le prenotazioni creati durante questo tutorial. Il notebook di Colab fornisce il codice nella sezione "Clean Up" (Esegui la pulizia) per automatizzare questo processo.
Risoluzione dei problemi
- Errori del token di Hugging Face: controlla che il token di Hugging Face disponga delle autorizzazioni
reade che sia impostato correttamente nel notebook. - Errori di quota: verifica di disporre di una quota GPU sufficiente nella regione in cui stai eseguendo il deployment. Se necessario, richiedi un aumento della quota.
- Conflitti di prenotazione: assicurati che la configurazione del tipo di macchina e dell'acceleratore del deployment dell'endpoint corrisponda alle impostazioni della prenotazione. Assicurati che le prenotazioni siano abilitate per essere condivise con i servizi Google.
Passaggi successivi
- Esplora le diverse varianti del modello Llama 3.
- Scopri di più sulle prenotazioni con questa panoramica delle prenotazioni di Compute Engine.
- Scopri di più sulle VM spot con questa panoramica delle VM spot.