

本教學課程會逐步引導您在 Gemini Enterprise Agent Platform 部署 Meta-Llama-3.1-8B 模型。您將瞭解如何部署端點,並根據特定需求進行最佳化。如果您有容錯工作負載,可以使用 Spot VM 節省成本。如要確保可用性,請使用 Compute Engine 預留項目。您將瞭解如何部署使用下列項目的端點:
- Spot VM:使用 Spot 佈建的執行個體,大幅節省成本。
- 預留:保證資源可用性,確保效能可預測,特別是針對正式版工作負載。本教學課程示範如何使用自動 (
ANY_RESERVATION) 和特定 (SPECIFIC_RESERVATION) 預留資源。
詳情請參閱「Spot VM」或「Compute Engine 資源預留項目」。
必要條件
開始之前,請先完成下列必要條件:
- 已啟用計費功能的 Cloud de Confiance by S3NS 專案。
- 已啟用 Gemini Enterprise Agent Platform 和 Compute Engine API。
- 您打算使用的機型和加速器 (例如 NVIDIA L4 GPU) 有足夠配額。如要查看配額,請參閱 Cloud de Confiance 控制台中的配額和系統限制。
- Hugging Face 帳戶和具備讀取權限的使用者存取權杖。
- 如果您使用共用預留項目,請在專案之間授予 IAM 權限。這些權限都包含在筆記本中。
在 Spot VM 上部署
以下各節將逐步引導您設定 Cloud de Confiance by S3NS 專案、設定 Hugging Face 驗證、使用 Spot VM 或預留項目部署 Llama-3.1 模型,以及測試部署作業。
1. 設定 Cloud de Confiance by S3NS 專案和共用預留項目
在第一個部分中,於 Colab 筆記本中設定 PROJECT_ID、SHARED_PROJECT_ID (如適用)、BUCKET_URI 和 REGION 變數。
筆記本會將 compute.viewer 角色授予這兩個專案的服務帳戶。
如要在同一個機構內使用不同專案中建立的預留資源,請務必將 compute.viewer 角色授予這兩個專案的 P4SA (主體服務帳戶)。筆記本程式碼會自動執行這項操作,但請確保 SHARED_PROJECT_ID 設定正確。這項跨專案權限可讓主要專案中的 Gemini Enterprise Agent Platform 端點查看及使用共用專案中的預訂容量。
2. 設定 Hugging Face 驗證
如要下載 Llama-3.1 模型,請在 Colab 筆記本的 HF_TOKEN 變數中提供 Hugging Face 使用者存取權杖。如未提供,您會收到下列錯誤訊息:Cannot access gated repository for URL。
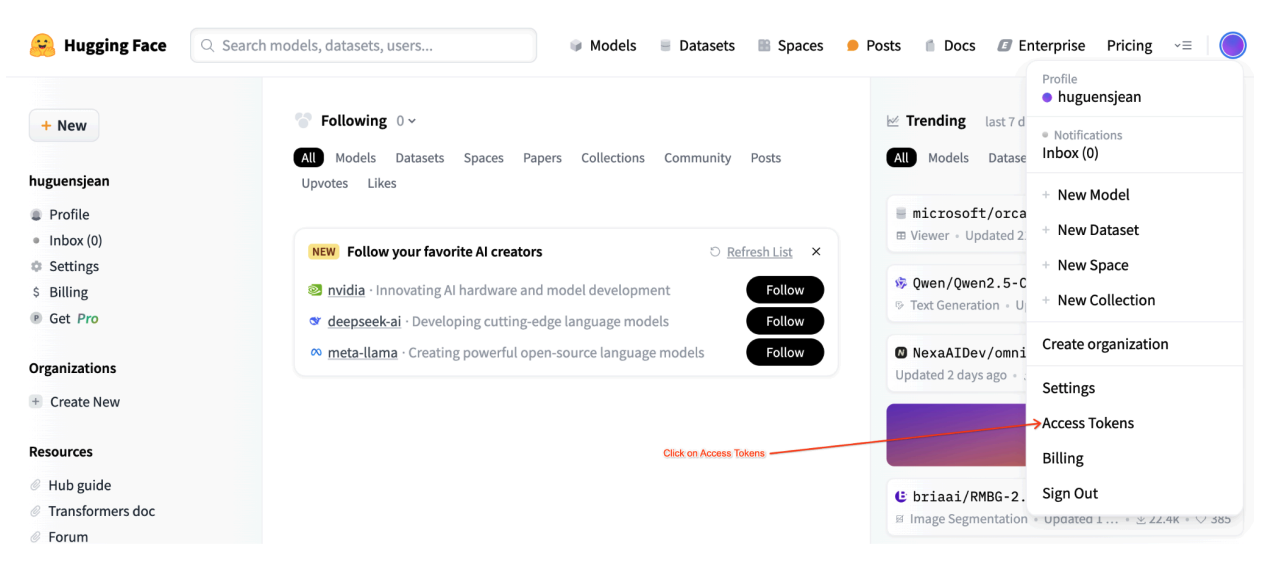 圖 1:Hugging Face 存取權杖設定
3. 使用 Spot VM 部署
如要將 Llama 模型部署至 Spot VM,請前往 Colab 筆記本中的「Spot VM Gemini Enterprise Agent Platform Endpoint Deployment」部分,然後設定 is_spot=True。
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = "meta-llama/" + base_model_name

if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
    max_loras = 5
else:
    raise ValueError(
        f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}."
    )

common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)

gpu_memory_utilization = 0.95
max_model_len = 8192

models["vllm_gpu_spotvm"], endpoints["vllm_gpu_spotvm"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix="llama3_1-serve-spotvm"),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=False,
    model_type="llama3.1",
    is_spot=True,
)
在共用預留項目執行個體上部署
以下章節將逐步引導您建立共用預留空間、設定預留空間設定、使用 ANY_RESERVATION 或 SPECIFIC_RESERVATION 部署 Llama-3.1 模型,以及測試部署作業。
1. 建立共用預留項目
如要設定預訂,請前往筆記本的「Set Up Reservations for Gemini Enterprise Agent Platform Predictions」部分。設定預訂所需的變數,例如 RES_ZONE、RESERVATION_NAME、RES_MACHINE_TYPE、RES_ACCELERATOR_TYPE 和 RES_ACCELERATOR_COUNT。
您必須將 RES_ZONE 設為 {REGION}-{availability_zone}
RES_ZONE = "a"
RES_ZONE = f"{REGION}-{RES_ZONE}"

RESERVATION_NAME = "shared-reservation-1"
RESERVATION_NAME = f"{PROJECT_ID}-{RESERVATION_NAME}"
RES_MACHINE_TYPE = "g2-standard-12"
RES_ACCELERATOR_TYPE = "nvidia-l4"
RES_ACCELERATOR_COUNT = 1
rev_names.append(RESERVATION_NAME)

create_reservation(
    res_project_id=PROJECT_ID,
    res_zone=RES_ZONE,
    res_name=RESERVATION_NAME,
    res_machine_type=RES_MACHINE_TYPE,
    res_accelerator_type=RES_ACCELERATOR_TYPE,
    res_accelerator_count=RES_ACCELERATOR_COUNT,
    shared_project_id=SHARED_PROJECT_ID,
)
2. 分享預訂資訊
預留項目有兩種:單一專案預留項目 (預設) 和共用預留項目。單一專案預留項目只能供與預留項目位於同一專案的 VM 使用。另一方面,共用預留項目可供預留項目所在專案的 VM 使用,也可供預留項目共用的任何其他專案的 VM 使用。使用共用預留項目可提高預留資源的使用率,並減少需要建立及管理的預留項目總數。本教學課程著重於共用預留項目。詳情請參閱「共用預留項目的運作方式」。
繼續操作前,請務必從 Cloud de Confiance by S3NS 控制台「與其他 Google 服務共用」,如圖所示:
 圖 2:與其他 Google 服務共用預訂資訊
3. 使用 ANY_RESERVATION 部署
如要使用 ANY_RESERVATION 部署端點,請前往筆記本的「Deploy Llama-3.1 Endpoint with ANY_RESERVATION」一節。指定部署設定,然後設定 reservation_affinity_type="ANY_RESERVATION"。接著執行儲存格,部署端點。
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

models["vllm_gpu_any_reserve"], endpoints["vllm_gpu_any_reserve"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-any-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_affinity_type="ANY_RESERVATION",
)
4. 測試 ANY_RESERVATION 端點
部署端點後,請務必測試幾個提示,確保端點部署正確無誤。
5. 使用 SPECIFIC_RESERVATION 部署
如要使用 SPECIFIC_RESERVATION 部署端點,請前往筆記本的「Deploy Llama-3.1 Endpoint with SPECIFIC_RESERVATION」一節。指定下列參數:reservation_name、reservation_affinity_type="SPECIFIC_RESERVATION"、reservation_project 和 reservation_zone。然後執行儲存格,部署端點。
hf_model_id = "meta-llama/Meta-Llama-3.1-8B"

MACHINE_TYPE = "g2-standard-12"
ACCELERATOR_TYPE = "NVIDIA_L4"
ACCELERATOR_COUNT = 1

(
    models["vllm_gpu_specific_reserve"],
    endpoints["vllm_gpu_specific_reserve"],
) = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(
        prefix=f"llama3_1-serve-specific-{RESERVATION_NAME}"
    ),
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=MACHINE_TYPE,
    accelerator_type=ACCELERATOR_TYPE,
    accelerator_count=ACCELERATOR_COUNT,
    model_type="llama3.1",
    reservation_name=RESERVATION_NAME,
    reservation_affinity_type="SPECIFIC_RESERVATION",
    reservation_project=PROJECT_ID,
    reservation_zone=RES_ZONE,
)
6. 測試 SPECIFIC_RESERVATION 端點
部署端點後,請確認 Gemini Enterprise Agent Platform 線上預測功能使用預留空間,並測試幾個提示,確保部署作業正確無誤。
 圖 3:確認 Vertex 線上預測使用預留項目
7. 清除所用資源
為避免產生持續性費用,請刪除在本教學課程中建立的模型、端點和預留項目。Colab 筆記本的「清除」部分提供程式碼,可自動執行這項清除程序。
疑難排解
- Hugging Face 權杖錯誤:請仔細檢查 Hugging Face 權杖是否具備
read權限,並在筆記本中正確設定。 - 配額錯誤:確認您在部署的區域有足夠的 GPU 配額。如有需要,請申請提高配額。
- 預留項目衝突:請確認端點部署的機型和加速器設定與預留項目的設定相符。確認預訂項目已啟用與 Google 服務共用功能
後續步驟
- 探索不同的 Llama 3 模型變體。
- 如要進一步瞭解預留項目,請參閱 Compute Engine 預留項目總覽。
- 如要進一步瞭解 Spot VM,請參閱這篇 Spot VM 總覽。