

סיכום
במדריך הזה נסביר איך לפרוס מודלים של Llama 3.1 ו-3.2 ולמלא בקשות באמצעות vLLM בפלטפורמת הסוכנים של Gemini Enterprise. הוא מיועד לשימוש בשילוב עם שני מחברות נפרדות: Serve Llama 3.1 with vLLM לפריסת מודלים של Llama 3.1 שמטפלים רק בטקסט, ו-Serve Multimodal Llama 3.2 with vLLM לפריסת מודלים מרובי-מודלים של Llama 3.2 שמטפלים בקלט של טקסט ותמונות. השלבים שמתוארים בדף הזה מראים איך לטפל ביעילות בהסקת מסקנות של מודלים ב-GPU, ולהתאים אישית מודלים למגוון רחב של אפליקציות. כך תוכלו לשלב מודלים מתקדמים של שפה בפרויקטים שלכם.
בסוף המדריך הזה תבינו איך:
- הורדה של מודלים מוכנים מראש של Llama מ-Hugging Face עם קונטיינר vLLM.
- אפשר להשתמש ב-vLLM כדי לפרוס את המודלים האלה במופעי GPU בתוך Cloud de Confiance by S3NS Gemini Enterprise Agent Platform Model Garden.
- הצגת מודלים בצורה יעילה כדי לטפל בבקשות הסקה בקנה מידה גדול.
- להריץ הסקה על בקשות של טקסט בלבד ועל בקשות של טקסט ותמונה.
- ניקוי נתונים.
- ניפוי באגים בפריסה.
תכונות עיקריות של vLLM
| התכונה | תיאור |
|---|---|
| PagedAttention | מנגנון תשומת לב שעבר אופטימיזציה ומנהל את הזיכרון ביעילות במהלך ההסקה. המודל תומך ביצירת טקסט עם תפוקה גבוהה על ידי הקצאה דינמית של משאבי זיכרון, מה שמאפשר הרחבה למספר בקשות בו-זמניות. |
| קיבוץ רציף של נתונים | הוא מאחד כמה בקשות קלט לאצווה אחת לעיבוד מקבילי, כדי למקסם את השימוש ב-GPU ואת קצב העברת הנתונים. |
| סטרימינג של טוקנים | ההגדרה הזו מאפשרת פלט של טוקנים בזמן אמת במהלך יצירת טקסט. האפשרות הזו מתאימה לאפליקציות שדורשות זמן אחזור קצר, כמו צ'אטבוטים או מערכות AI אינטראקטיביות. |
| תאימות המודל | תמיכה במגוון רחב של מודלים שעברו אימון מראש במסגרות פופולריות כמו Hugging Face Transformers. כך קל יותר לשלב מודלים שונים של LLM ולהתנסות בהם. |
| שימוש בכמה יחידות GPU וכמה מארחים | התכונה מאפשרת פרסום מודלים יעיל על ידי חלוקת עומס העבודה בין כמה יחידות GPU במכונה אחת ובין כמה מכונות באשכול, וכך מגדילה באופן משמעותי את התפוקה ואת המדרגיות. |
| פריסה יעילה | השילוב עם ממשקי API, כמו השלמות צ'אט של OpenAI, הוא חלק, ולכן קל לפרוס את המודל לתרחישי שימוש בייצור. |
| שילוב חלק עם מודלים של Hugging Face | vLLM תואם לפורמט של ארטיפקטים של מודלים של Hugging Face ותומך בטעינה מ-HF, כך שקל לפרוס מודלים של Llama לצד מודלים פופולריים אחרים כמו Gemma, Phi ו-Qwen בהגדרה אופטימלית. |
| פרויקט קוד פתוח שמבוסס על הקהילה | vLLM הוא קוד פתוח, והוא מעודד הצעות תוכן מהקהילה, כדי לשפר באופן מתמשך את היעילות של מודלים שפה גדולים. |
Google Gemini Enterprise Agent Platform vLLM Customizations: שיפור הביצועים והשילוב
ההטמעה של vLLM ב-Model Garden של Google Gemini Enterprise Agent Platform לא מתבצעת באמצעות שילוב ישיר של ספריית הקוד הפתוח. Gemini Enterprise Agent Platform כוללת גרסה מותאמת וממוטבת של vLLM שמותאמת במיוחד לשיפור הביצועים, האמינות והשילוב החלק בתוך Cloud de Confiance by S3NS.
- אופטימיזציות של ביצועים:
- הורדה מקבילה מ-Cloud Storage: מאפשרת אחזור נתונים מקביל מ-Cloud Storage, וכך מקצרת את זמני הטעינה והפריסה של המודל, מפחיתה את זמן האחזור ומשפרת את מהירות ההפעלה.
- שיפורים בתכונות:
- LoRA דינמי עם שמירת נתונים במטמון משופרת ותמיכה ב-Cloud Storage: הרחבה של היכולות של LoRA דינמי עם מנגנונים לשמירת נתונים במטמון בדיסק מקומי וטיפול בשגיאות חזק, לצד תמיכה בטעינה של משקלי LoRA ישירות מנתיבי Cloud Storage ומכתובות URL חתומות. כך אפשר לפשט את הניהול והפריסה של מודלים מותאמים אישית.
- ניתוח של קריאות לפונקציות ב-Llama 3.1/3.2: הטמעה של ניתוח מיוחד לקריאות לפונקציות ב-Llama 3.1/3.2, לשיפור החוסן בניתוח.
- שמירת מטמון של קידומת זיכרון המארח: מודל ה-vLLM החיצוני תומך רק בשמירת מטמון של קידומת זיכרון ה-GPU.
- פענוח ספקולטיבי: זו תכונה קיימת ב-vLLM, אבל פלטפורמת Gemini Enterprise Agent ערכה ניסויים כדי למצוא הגדרות מודל שמניבות ביצועים גבוהים.
ההתאמות האישיות האלה, שספציפיות ל-Gemini Enterprise Agent Platform, מאפשרות לכם למקסם את הביצועים והיעילות של פריסות Llama 3.1 ב-Model Garden של Gemini Enterprise Agent Platform. ברוב המקרים, המשתמשים לא מודעים להתאמות האלה.
- שילוב של Gemini Enterprise Agent Platform עם מערכות אקולוגיות:
- תמיכה בפורמטים של קלט/פלט לחיזוי ב-Gemini Enterprise Agent Platform: המערכת מבטיחה תאימות חלקה לפורמטים של קלט ופלט לחיזוי ב-Gemini Enterprise Agent Platform, ומפשטת את הטיפול בנתונים ואת השילוב עם שירותים אחרים של Gemini Enterprise Agent Platform.
- המודעות למשתני הסביבה של Vertex: המודל מכבד את משתני הסביבה של Gemini Enterprise Agent Platform (
AIP_*) ומשתמש בהם לצורך הגדרה וניהול משאבים, מה שמייעל את הפריסה ומבטיח התנהגות עקבית בסביבת Gemini Enterprise Agent Platform. - טיפול משופר בשגיאות ועמידות: הטמעה של טיפול מקיף בשגיאות, אימות של קלט/פלט ומנגנונים לסיום פעולה של שרתים, כדי להבטיח יציבות, אמינות ופעולה חלקה בסביבה המנוהלת של פלטפורמת הסוכנים של Gemini Enterprise.
- שרת Nginx ליכולת: משלב שרת Nginx על גבי שרת vLLM, ומאפשר פריסה של כמה עותקים משוכפלים ושיפור של יכולת ההתאמה וזמינות גבוהה של תשתית ההגשה.
היתרונות הנוספים של vLLM
- השוואת ביצועים: הביצועים של vLLM תחרותיים בהשוואה למערכות אחרות להצגת מודלים, כמו text-generation-inference של Hugging Face ו-FasterTransformer של NVIDIA, מבחינת קצב העברת נתונים וזמן אחזור.
- קלות השימוש: הספרייה מספקת API פשוט לשילוב עם תהליכי עבודה קיימים, ומאפשרת לפרוס את מודלי Llama 3.1 ו-3.2 עם הגדרה מינימלית.
- תכונות מתקדמות: vLLM תומך בפלט סטרימינג (יצירת תשובות טוקן אחר טוקן) ומטפל ביעילות בהנחיות באורך משתנה, מה שמשפר את האינטראקטיביות והרספונסיביות באפליקציות.
סקירה כללית על מערכת vLLM זמינה במאמר.
מודלים נתמכים
vLLM תומך במגוון רחב של מודלים מתקדמים, ומאפשר לכם לבחור את המודל שהכי מתאים לצרכים שלכם. בטבלה הבאה מוצגים מבחר מהמודלים האלה. עם זאת, כדי לגשת לרשימה מקיפה של מודלים נתמכים, כולל מודלים להסקת מסקנות טקסטואלית בלבד ומודלים להסקת מסקנות מולטימודאלית, אפשר לעיין באתר הרשמי של vLLM.
| קטגוריה | מודלים |
|---|---|
| Meta AI | Llama 3.3, Llama 3.2, Llama 3.1, Llama 3, Llama 2, Code Llama |
| Mistral AI | Mistral 7B, Mixtral 8x7B, Mixtral 8x22B והווריאציות שלהם (Instruct, Chat), Mistral-tiny, Mistral-small, Mistral-medium |
| DeepSeek AI | DeepSeek-V3, DeepSeek-R1, DeepSeek-R1-Distill-Qwen-1.5B, DeepSeek-R1-Distill-Qwen-7B, DeepSeek-R1-Distill-Llama-8B, DeepSeek-R1-Distill-Qwen-14B, DeepSeek-R1-Distill-Qwen-32B, DeepSeek-R1-Distill-Llama-70B, Deepseek-vl2-tiny, Deepseek-vl2-small, Deepseek-vl2 |
| MosaicML | MPT (7B, 30B) וגרסאות (Instruct, Chat), MPT-7B-StoryWriter-65k |
| OpenAI | GPT-2, GPT-3, GPT-4, GPT-NeoX |
| Together AI | RedPajama, Pythia |
| Stability AI | StableLM (3B, 7B), StableLM-Alpha-3B, StableLM-Base-Alpha-7B, StableLM-Instruct-Alpha-7B |
| TII (Technology Innovation Institute) | Falcon 7B, Falcon 40B ווריאנטים (Instruct, Chat), Falcon-RW-1B, Falcon-RW-7B |
| BigScience | BLOOM, BLOOMZ |
| FLAN-T5, UL2, Gemma (2B, 7B), PaLM 2, | |
| Salesforce | CodeT5, CodeT5+ |
| LightOn | Persimmon-8B-base, Persimmon-8B-chat |
| EleutherAI | GPT-Neo, Pythia |
| AI21 Labs | Jamba |
| Cerebras | Cerebras-GPT |
| Intel | Intel-NeuralChat-7B |
| מודלים בולטים אחרים | StarCoder, OPT, Baichuan, Aquila, Qwen, InternLM, XGen, OpenLLaMA, Phi-2, Yi, OpenCodeInterpreter, Nous-Hermes, Gemma-it, Mistral-Instruct-v0.2-7B-Zeus |
תחילת העבודה ב-Model Garden
קונטיינר ההצגה של מעבדים גרפיים ל-Cloud של vLLM משולב ב-Model Garden, בסביבת המשחקים, בפריסה בלחיצה אחת ובדוגמאות של מחברות Colab Enterprise. במדריך הזה נתמקד במשפחת מודלים Llama מבית מטא AI כדוגמה.
שימוש ב-notebook של Colab Enterprise
אפשר גם להשתמש בסביבת הפיתוח ובפריסות בלחיצה אחת, אבל הם לא מוסברים במדריך הזה.
- עוברים אל דף כרטיס המודל ולוחצים על פתיחת מחברת.
- בוחרים את מסמך ה-notebook של Vertex Serving. מסמך ה-notebook ייפתח ב-Colab Enterprise.
- מריצים את ה-notebook כדי לפרוס מודל באמצעות vLLM ושולחים בקשות לחיזוי לנקודת הקצה.
הגדרה ודרישות
בקטע הזה מפורטים השלבים הנדרשים להגדרת פרויקט Cloud de Confiance by S3NSולוודא שיש לכם את המשאבים הדרושים לפריסה ולהצגה של מודלים של vLLM.
1. חיוב
- הפעלת החיוב: מוודאים שהחיוב מופעל בפרויקט. אפשר לעיין במאמר הפעלה, השבתה ושינוי של חיוב בפרויקט.
2. זמינות ומכסות של GPU
- כדי להריץ תחזיות באמצעות יחידות GPU בעלות ביצועים גבוהים (NVIDIA A100 80GB או H100 80GB), חשוב לבדוק את המכסות של יחידות ה-GPU האלה באזור שבחרתם:
| סוג המכונה | סוג המאיץ | אזורים מומלצים |
|---|---|---|
| a2-ultragpu-1g | 1 NVIDIA_A100_80GB | us-central1, us-east4, europe-west4, asia-southeast1 |
| a3-highgpu-8g | 8 NVIDIA_H100_80GB | us-central1, us-west1, europe-west4, asia-southeast1 |
3. הגדרת Cloud de Confiance by S3NS פרויקט
מריצים את דוגמת הקוד הבאה כדי לוודא שהסביבה שלכם מוגדרת בצורה נכונה. בשלב הזה מותקנות ספריות Python נדרשות ומוגדרת גישה למשאבי Cloud de Confiance by S3NS . הפעולות כוללות: Cloud de Confiance by S3NS
- התקנה: שדרוג הספרייה
google-cloud-aiplatformושיבוט המאגר שמכיל פונקציות עזר. - הגדרת סביבה: הגדרת משתנים ל Cloud de Confiance by S3NS מזהה הפרויקט, לאזור ולמאגר ייחודי ב-Cloud Storage לאחסון ארטיפקטים של המודל.
- הפעלת ממשקי API: מפעילים את ממשקי ה-API של Gemini Enterprise Agent Platform ו-Compute Engine, שהם חיוניים לפריסה ולניהול של מודלים של AI.
- הגדרת קטגוריה של Cloud Storage: יוצרים קטגוריה חדשה של Cloud Storage או בודקים קטגוריה קיימת כדי לוודא שהיא נמצאת באזור הנכון.
- אתחול של Gemini Enterprise Agent Platform: מאתחלים את ספריית הלקוח של Gemini Enterprise Agent Platform עם הגדרות הפרויקט, המיקום וה-staging bucket.
- הגדרת חשבון שירות: צריך לזהות את חשבון השירות שמוגדר כברירת מחדל להרצת משימות ב-Gemini Enterprise Agent Platform ולהעניק לו את ההרשאות הנדרשות.
BUCKET_URI = "gs://"

REGION = ""

! pip3 install --upgrade --quiet 'google-cloud-aiplatform>=1.64.0'
! git clone https://github.com/GoogleCloudPlatform/vertex-ai-samples.git

import datetime
import importlib
import os
import uuid
from typing import Tuple

import requests
from google.cloud import aiplatform

common_util = importlib.import_module(
    "vertex-ai-samples.community-content.vertex_model_garden.model_oss.notebook_util.common_util"
)

models, endpoints = {}, {}

PROJECT_ID = os.environ["GOOGLE_CLOUD_PROJECT"]

if not REGION:
    REGION = os.environ["GOOGLE_CLOUD_REGION"]

print("Enabling Agent Platform API and Compute Engine API.")
! gcloud services enable aiplatform.googleapis.com compute.googleapis.com

now = datetime.datetime.now().strftime("%Y%m%d%H%M%S")
BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])

if BUCKET_URI is None or BUCKET_URI.strip() == "" or BUCKET_URI == "gs://":
    BUCKET_URI = f"gs://{PROJECT_ID}-tmp-{now}-{str(uuid.uuid4())[:4]}"
    BUCKET_NAME = "/".join(BUCKET_URI.split("/")[:3])
    ! gsutil mb -l {REGION} {BUCKET_URI}
else:
    assert BUCKET_URI.startswith("gs://"), "BUCKET_URI must start with `gs://`."
    shell_output = ! gsutil ls -Lb {BUCKET_NAME} | grep "Location constraint:" | sed "s/Location constraint://"
    bucket_region = shell_output[0].strip().lower()
    if bucket_region != REGION:
        raise ValueError(
            "Bucket region %s is different from notebook region %s"
            % (bucket_region, REGION)
        )
print(f"Using this Bucket: {BUCKET_URI}")

STAGING_BUCKET = os.path.join(BUCKET_URI, "temporal")
MODEL_BUCKET = os.path.join(BUCKET_URI, "llama3_1")

print("Initializing Agent Platform API.")
aiplatform.init(project=PROJECT_ID, location=REGION, staging_bucket=STAGING_BUCKET)

shell_output = ! gcloud projects describe $PROJECT_ID
project_number = shell_output[-1].split(":")[1].strip().replace("'", "")
SERVICE_ACCOUNT = "your service account email"
print("Using this default Service Account:", SERVICE_ACCOUNT)

! gsutil iam ch serviceAccount:{SERVICE_ACCOUNT}:roles/storage.admin $BUCKET_NAME

! gcloud config set project $PROJECT_ID
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/storage.admin"
! gcloud projects add-iam-policy-binding --no-user-output-enabled {PROJECT_ID} --member=serviceAccount:{SERVICE_ACCOUNT} --role="roles/aiplatform.user"
שימוש ב-Hugging Face עם Meta Llama 3.1, 3.2 ו-vLLM
אוספי Llama 3.1 ו-3.2 של Meta מספקים מגוון של מודלים גדולים של שפה (LLM) רב-לשוניים, שנועדו ליצור טקסט באיכות גבוהה במגוון תרחישי שימוש. המודלים האלה עוברים אימון מראש וכוונון לפי הוראות, והם מצטיינים במשימות כמו דיאלוג רב-לשוני, סיכום ואחזור נתונים באמצעות סוכנים. לפני שמשתמשים במודלים Llama 3.1 ו-3.2, צריך להסכים לתנאי השימוש שלהם, כמו שמוצג בצילום המסך. ספריית vLLM מציעה סביבת שרת יעילה בקוד פתוח עם אופטימיזציות לזמן אחזור, ליעילות הזיכרון ולמדרגיות.
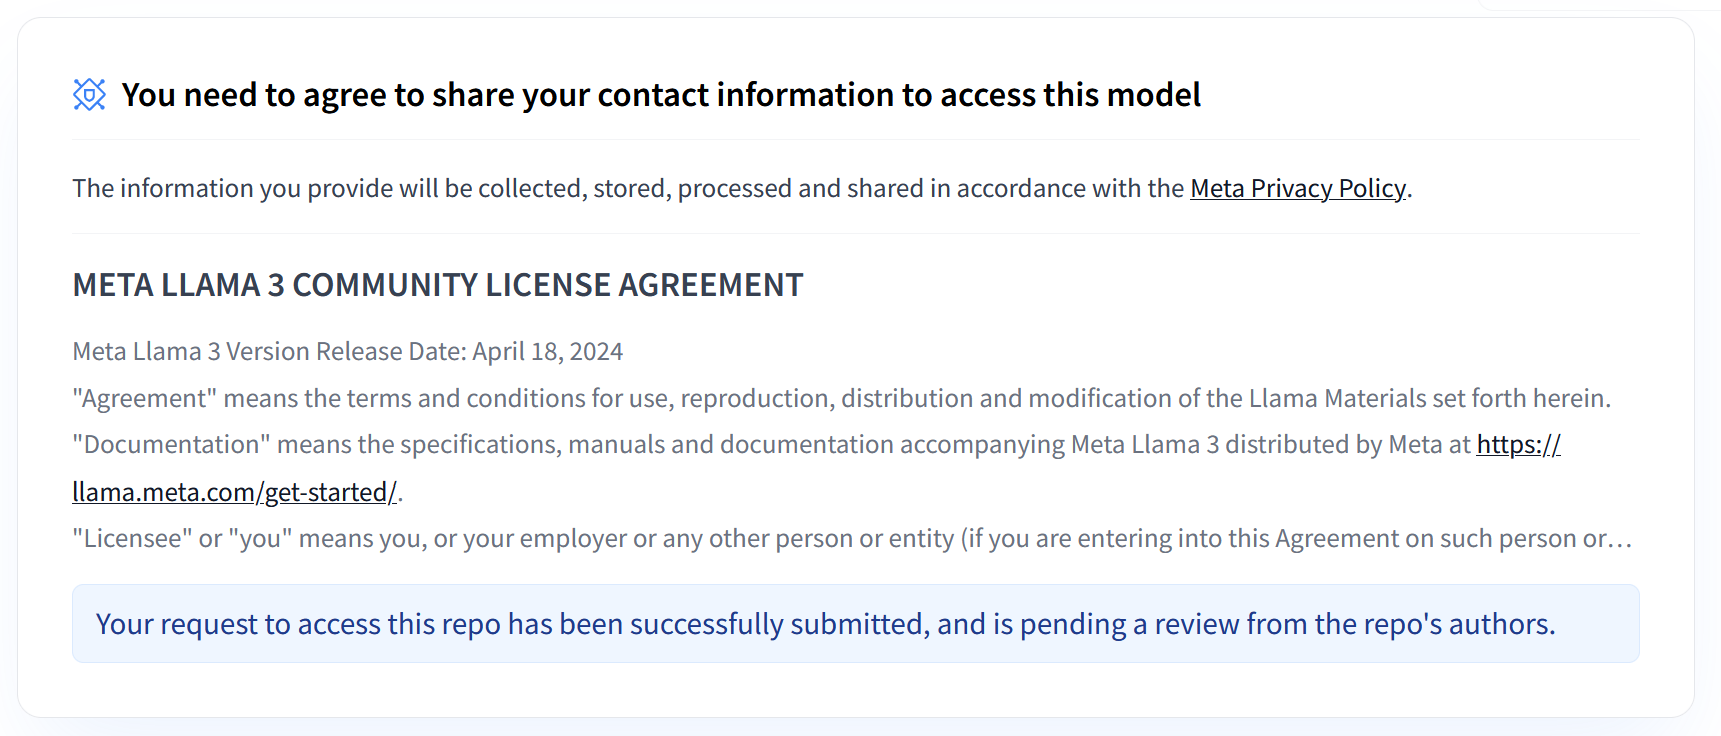 איור 1: הסכם הרישיון של קהילת Meta LLama 3
סקירה כללית של אוספים של Meta Llama 3.1 ו-3.2
כל אחת מהקולקציות Llama 3.1 ו-Llama 3.2 מיועדת למשימות פריסה שונות ולגדלים שונים של מודלים, ומספקת לכם אפשרויות גמישות למשימות של דיאלוג רב-לשוני ועוד. מידע נוסף זמין בדף הסקירה הכללית של Llama.
- טקסט בלבד: אוסף Llama 3.2 של מודלים גדולים של שפה (LLM) רב-לשוניים הוא אוסף של מודלים גנרטיביים שעברו אימון מראש וכוונון לפי הוראות, בגדלים של מיליארד ו-3 מיליארד פרמטרים (טקסט כקלט, טקסט כפלט).
- Vision ו-Vision Instruct: אוסף Llama 3.2-Vision של מודלים גדולים של שפה (LLM) מרובי-מוֹדָלִים הוא אוסף של מודלים גנרטיביים שעברו אימון מראש ואימון על הנחיות, לניתוח תמונות בגדלים של 11B ו-90B (טקסט + תמונות כקלט, טקסט כפלט). אופטימיזציה: כמו Llama 3.1, מודלים 3.2 מותאמים לדיאלוג רב-לשוני ומניבים ביצועים טובים במשימות של אחזור וסיכום, עם התוצאות הכי טובות במבחני ביצועים סטנדרטיים.
- ארכיטקטורת המודל: Llama 3.2 כולל גם מסגרת טרנספורמציה אוטומטית רגרסיבית, עם SFT ו-RLHF שמוחלים כדי להתאים את המודלים לשימושיות ולאבטחה.
טוקנים של גישת משתמש ב-Hugging Face
כדי לגשת למשאבים הנדרשים במדריך הזה, צריך אסימון גישת קריאה מ-Hugging Face Hub. כדי להגדיר את האימות, פועלים לפי השלבים הבאים:
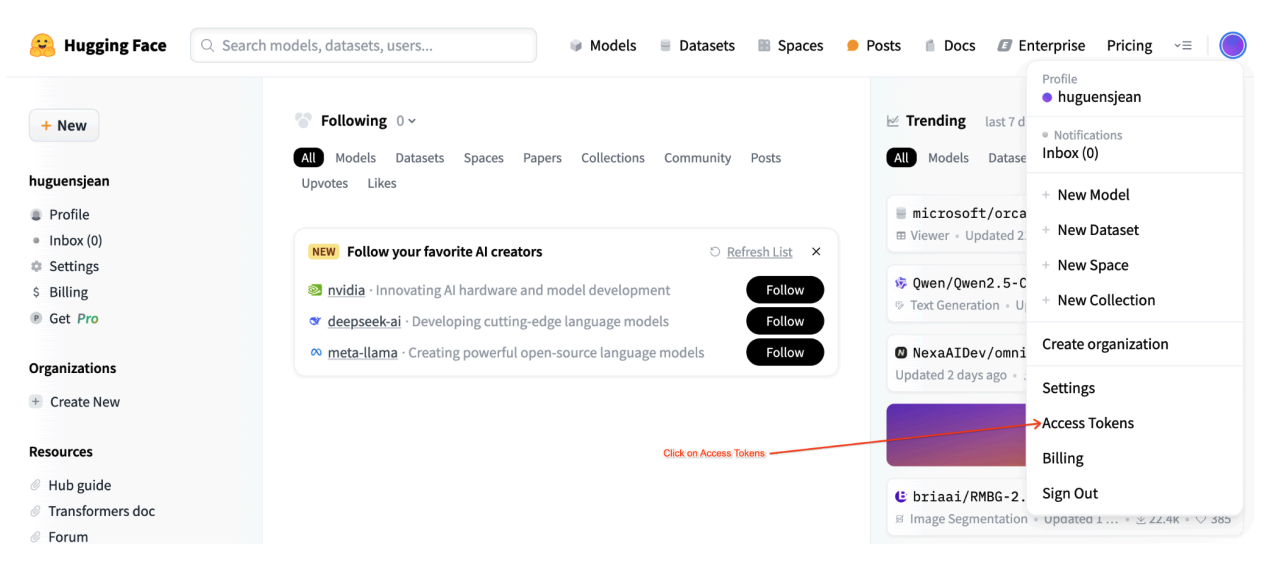 איור 2: הגדרות של טוקן גישה ב-Hugging Face
כדי ליצור אסימון גישה לקריאה:
- עוברים אל ההגדרות של חשבון Hugging Face.
- יוצרים טוקן חדש, מקצים לו את תפקיד הקריאה ושומרים את הטוקן בצורה מאובטחת.
שימוש בטוקן:
- משתמשים באסימון שנוצר כדי לבצע אימות ולגשת למאגרי מידע ציבוריים או פרטיים לפי הצורך במדריך.
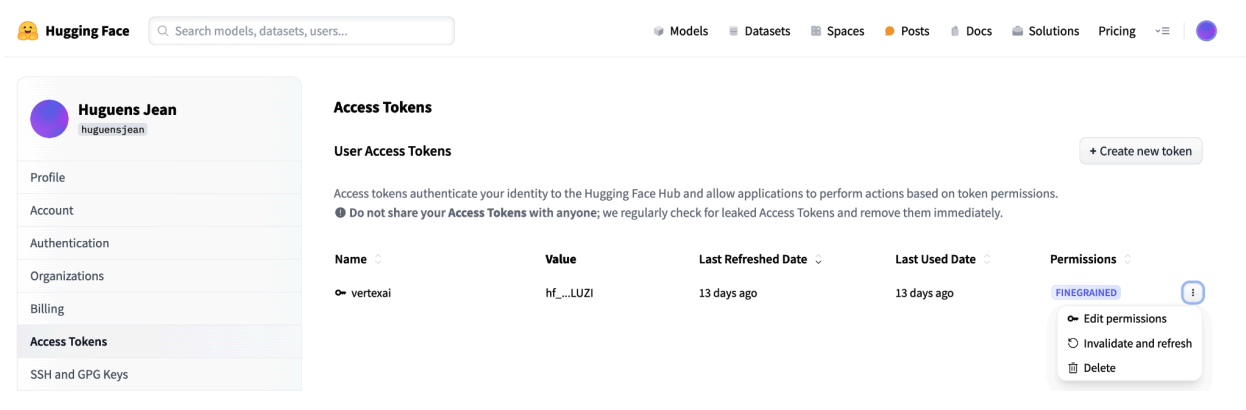 איור 3: ניהול אסימון הגישה של Hugging Face
ההגדרה הזו מבטיחה שתהיה לכם רמת הגישה המתאימה בלי הרשאות מיותרות. השיטות האלה משפרות את האבטחה ומונעות חשיפה מקרית של טוקנים. מידע נוסף על הגדרת אסימוני גישה זמין בדף בנושא אסימוני גישה ב-Hugging Face.
חשוב להימנע משיתוף האסימון או מחשיפתו באופן ציבורי או באינטרנט. כשמגדירים את האסימון כמשתנה סביבה במהלך ה-Deployment (פריסה), הוא נשאר פרטי לפרויקט. Gemini Enterprise Agent Platform מבטיחה את האבטחה שלו על ידי מניעת גישה של משתמשים אחרים למודלים ולנקודות הקצה שלכם.
מידע נוסף על הגנה על אסימון הגישה זמין במאמר Hugging Face Access Tokens - Best Practices.
פריסת מודלים של Llama 3.1 עם vLLM
לפריסה של מודלים גדולים של שפה ברמת הייצור, vLLM מספק פתרון יעיל לפרסום המודל שמאפשר לייעל את השימוש בזיכרון, להקטין את זמן האחזור ולהגדיל את קצב העברת הנתונים. לכן הוא מתאים במיוחד לטיפול במודלים הגדולים יותר של Llama 3.1 וגם במודלים המולטי-מודאליים של Llama 3.2.
שלב 1: בוחרים מודל לפריסה
בוחרים את וריאציית המודל Llama 3.1 לפריסה. האפשרויות הזמינות כוללות גדלים שונים וגרסאות שעברו כוונון להוראות:
base_model_name = "Meta-Llama-3.1-8B"  # @param ["Meta-Llama-3.1-8B", "Meta-Llama-3.1-8B-Instruct", "Meta-Llama-3.1-70B", "Meta-Llama-3.1-70B-Instruct", "Meta-Llama-3.1-405B-FP8", "Meta-Llama-3.1-405B-Instruct-FP8"]
hf_model_id = "meta-Llama/" + base_model_name
שלב 2: בדיקת הציוד והמכסה של הפריסה
הפונקציה deploy מגדירה את ה-GPU המתאים ואת סוג המכונה על סמך גודל המודל, ובודקת את המכסה באזור הזה עבור פרויקט מסוים:
if "8b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-12"
    accelerator_count = 1
elif "70b" in base_model_name.lower():
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-96"
    accelerator_count = 8
elif "405b" in base_model_name.lower():
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")
מוודאים שמכסת ה-GPU זמינה באזור שצוין:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
שלב 3: בודקים את המודל באמצעות vLLM
הפונקציה הבאה מעלה את המודל ל-Gemini Enterprise Agent Platform, מגדירה את הגדרות הפריסה ופורסת אותו לנקודת קצה באמצעות vLLM.
- קובץ אימג' של Docker: הפריסה משתמשת בקובץ אימג' של vLLM Docker שנבנה מראש כדי להפעיל את המודל בצורה יעילה.
- הגדרה: הגדרה של ניצול הזיכרון, אורך המודל והגדרות אחרות של vLLM. מידע נוסף על הארגומנטים הנתמכים על ידי השרת זמין בדף התיעוד הרשמי של vLLM.
- משתני סביבה: הגדרת משתני סביבה לאימות ולמקור הפריסה.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 256,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if "8b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-12"
        accelerator_count = 1
    elif "70b" in base_model_name.lower():
        accelerator_type = "NVIDIA_L4"
        machine_type = "g2-standard-96"
        accelerator_count = 8
    elif "405b" in base_model_name.lower():
        accelerator_type = "NVIDIA_H100_80GB"
        machine_type = "a3-highgpu-8g"
        accelerator_count = 8
    else:
        raise ValueError(f"Recommended GPU setting not found for: {accelerator_type} and {base_model_name}.")

    common_util.check_quota(
        project_id=PROJECT_ID,
        region=REGION,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        is_for_training=False,
    )

    vllm_args = [
        "python", "-m", "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}", f"--dtype={dtype}",
        f"--max-loras={max_loras}", f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}", "--disable-log-stats"
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": model_id,
        "DEPLOY_SOURCE": "notebook",
        "HF_TOKEN": HF_TOKEN
    }

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
שלב 4: הפעלת הפריסה
מריצים את פונקציית הפריסה עם המודל וההגדרה שנבחרו. בשלב הזה המודל נפרס ומוחזרים המודל ומופעי נקודת הקצה:
HF_TOKEN = ""

VLLM_DOCKER_URI = "us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241001_0916_RC00"

model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
gpu_memory_utilization = 0.9
max_model_len = 4096
max_loras = 1

models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve"),
    model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    max_loras=max_loras,
    enforce_eager=True,
    enable_lora=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
)
אחרי שמריצים את דוגמת הקוד הזו, מודל Llama 3.1 נפרס ב-Gemini Enterprise Agent Platform וניתן לגשת אליו דרך נקודת הקצה שצוינה. אתם יכולים ליצור איתו אינטראקציה כדי לבצע משימות הסקה כמו יצירת טקסט, סיכום ודיאלוג. הפריסה של מודל חדש עשויה להימשך עד שעה, בהתאם לגודל המודל. אפשר לבדוק את ההתקדמות בתחזית אונליין.
 איור 4: נקודת פריסה של Llama 3.1 בלוח הבקרה של Vertex
חיזויים באמצעות Llama 3.1 ב-Gemini Enterprise Agent Platform
אחרי שפורסים בהצלחה את מודל Llama 3.1 ב-Gemini Enterprise Agent Platform, אפשר להתחיל ליצור תחזיות על ידי שליחת הנחיות טקסט לנקודת הקצה. בקטע הזה מופיעה דוגמה ליצירת תשובות עם פרמטרים שונים שאפשר להתאים אישית כדי לשלוט בפלט.
שלב 1: מגדירים את ההנחיה והפרמטרים
מתחילים בהגדרת הנחייה טקסטואלית ופרמטרי הדגימה כדי להנחות את התגובה של המודל. אלה הפרמטרים העיקריים:
-
prompt: טקסט הקלט שעבורו רוצים שהמודל ייצור תגובה. לדוגמה, prompt = "What is a car?". -
max_tokens: מספר הטוקנים המקסימלי בפלט שנוצר. הקטנת הערך הזה יכולה לעזור למנוע בעיות שקשורות לפסק זמן. -
temperature: שולט באקראיות של התחזיות. ערכים גבוהים יותר (לדוגמה, 1.0) מגדילים את המגוון, בעוד שערכים נמוכים יותר (לדוגמה, 0.5) הופכים את הפלט לממוקד יותר. -
top_p: מגביל את מאגר הדגימה להסתברות המצטברת הגבוהה ביותר. לדוגמה, אם מגדירים top_p = 0.9, המערכת תתייחס רק לטוקנים ב-90% העליונים של הסתברות המסה. -
top_k: מגביל את הדגימה ל-k הטוקנים המובילים שהכי סביר שיופיעו. לדוגמה, אם מגדירים top_k = 50, הדגימה תתבצע רק מ-50 הטוקנים המובילים. -
raw_response: אם הערך הוא True, הפונקציה מחזירה את פלט המודל הגולמי. אם הערך הוא False, הפונקציה מחילה עיצוב נוסף עם המבנה 'הנחיה:\n{prompt}\nפלט:\n{output}'. -
lora_id(אופציונלי): הנתיב לקובצי המשקלים של LoRA להחלת משקלים של Low-Rank Adaptation (LoRA). יכול להיות שזה יהיה קטגוריה של Cloud Storage או כתובת URL של מאגר Hugging Face. שימו לב שהאפשרות הזו פועלת רק אם--enable-loraמוגדר בארגומנטים של הפריסה. לא אפשרי להשתמש ב-LoRA דינמי במודלים מולטי-מודאליים.
prompt = "What is a car?"
max_tokens = 50
temperature = 1.0
top_p = 1.0
top_k = 1
raw_response = False
lora_id = ""
שלב 2: שליחת בקשת החיזוי
אחרי שהגדרתם את המופע, אתם יכולים לשלוח את בקשת החיזוי לנקודת הקצה של Gemini Enterprise Agent Platform שפרסתם. בדוגמה הזו מוצג איך ליצור חיזוי ולהדפיס את התוצאה:
response = endpoints["vllm_gpu"].predict(
    instances=instances, use_dedicated_endpoint=use_dedicated_endpoint
)

for prediction in response.predictions:
    print(prediction)
פלט לדוגמה
דוגמה לאופן שבו המודל עשוי להגיב להנחיה 'מהי מכונית?':
Human: What is a car?
Assistant: A car, or a motor car, is a road-connected human-transportation system
used to move people or goods from one place to another.
הערות נוספות
- מודרציה: כדי לוודא שהתוכן בטוח, אתם יכולים לבצע מודרציה של הטקסט שנוצר באמצעות יכולות המודרציה של טקסטים של Agent Platform.
- טיפול בפסק זמן (timeout): אם נתקלים בבעיות כמו
ServiceUnavailable:
503
, כדאי לנסות להקטין את הפרמטרmax_tokens.
הגישה הזו מספקת דרך גמישה לאינטראקציה עם מודל Llama 3.1 באמצעות טכניקות דגימה שונות ומתאמי LoRA, ולכן היא מתאימה למגוון תרחישי שימוש, החל מיצירת טקסט למטרות כלליות ועד לתשובות שמתמקדות במשימה ספציפית.
פריסת מודלים מרובי-מוֹדָל של Llama 3.2 באמצעות vLLM
בקטע הזה נסביר איך להעלות מודלים מוכנים מראש של Llama 3.2 למרשם המודלים ולפרוס אותם לנקודת קצה של Gemini Enterprise Agent Platform. זמן הפריסה יכול להימשך עד שעה, בהתאם לגודל המודל. מודלים של Llama 3.2 זמינים בגרסאות מולטי-מודאליות שתומכות בקלט של טקסט ותמונות. vLLM תומך ב:
- פורמט טקסט בלבד
- תמונה יחידה + פורמט טקסט
הפורמטים האלה הופכים את Llama 3.2 למתאים לאפליקציות שדורשות עיבוד של תמונות וטקסט.
שלב 1: בוחרים מודל לפריסה
מציינים את הווריאציה של מודל Llama 3.2 שרוצים לפרוס. בדוגמה הבאה נעשה שימוש במודל Llama-3.2-11B-Vision, אבל אתם יכולים לבחור מבין האפשרויות האחרות שזמינות בהתאם לדרישות שלכם.
base_model_name = "Llama-3.2-11B-Vision"  # @param ["Llama-3.2-1B", "Llama-3.2-1B-Instruct", "Llama-3.2-3B", "Llama-3.2-3B-Instruct", "Llama-3.2-11B-Vision", "Llama-3.2-11B-Vision-Instruct", "Llama-3.2-90B-Vision", "Llama-3.2-90B-Vision-Instruct"]
hf_model_id = "meta-Llama/" + base_model_name
שלב 2: הגדרת הציוד והמשאבים
בוחרים חומרה מתאימה לגודל המודל. vLLM יכול להשתמש במעבדים גרפיים שונים בהתאם לצרכים החישוביים של המודל:
- מודלים של 1B ו-3B: שימוש במעבדי GPU של NVIDIA L4.
- מודלים של 11B: צריך להשתמש במעבדי GPU של NVIDIA A100.
- מודלים של 90B: צריך להשתמש במעבדי GPU של NVIDIA H100.
בדוגמה הזו, הפריסה מוגדרת על סמך בחירת המודל:
if "3.2-1B" in base_model_name or "3.2-3B" in base_model_name:
    accelerator_type = "NVIDIA_L4"
    machine_type = "g2-standard-8"
    accelerator_count = 1
elif "3.2-11B" in base_model_name:
    accelerator_type = "NVIDIA_TESLA_A100"
    machine_type = "a2-highgpu-1g"
    accelerator_count = 1
elif "3.2-90B" in base_model_name:
    accelerator_type = "NVIDIA_H100_80GB"
    machine_type = "a3-highgpu-8g"
    accelerator_count = 8
else:
    raise ValueError(f"Recommended GPU setting not found for: {base_model_name}.")
מוודאים שיש לכם את מכסת ה-GPU הנדרשת:
common_util.check_quota(
    project_id=PROJECT_ID,
    region=REGION,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    is_for_training=False,
)
שלב 3: פריסת המודל באמצעות vLLM
הפונקציה הבאה מטפלת בפריסה של מודל Llama 3.2 בפלטפורמת הסוכנים של Gemini Enterprise. היא מגדירה את הסביבה של המודל, את ניצול הזיכרון ואת הגדרות vLLM כדי למלא בקשות ביעילות.
def deploy_model_vllm(
    model_name: str,
    model_id: str,
    service_account: str,
    base_model_id: str = None,
    machine_type: str = "g2-standard-8",
    accelerator_type: str = "NVIDIA_L4",
    accelerator_count: int = 1,
    gpu_memory_utilization: float = 0.9,
    max_model_len: int = 4096,
    dtype: str = "auto",
    enable_trust_remote_code: bool = False,
    enforce_eager: bool = False,
    enable_lora: bool = False,
    max_loras: int = 1,
    max_cpu_loras: int = 8,
    use_dedicated_endpoint: bool = False,
    max_num_seqs: int = 12,
    model_type: str = None,
) -> Tuple[aiplatform.Model, aiplatform.Endpoint]:
    """Deploys trained models with vLLM into Agent Platform."""
    endpoint = aiplatform.Endpoint.create(
        display_name=f"{model_name}-endpoint",
        dedicated_endpoint_enabled=use_dedicated_endpoint,
    )

    if not base_model_id:
        base_model_id = model_id

    vllm_args = [
        "python",
        "-m",
        "vllm.entrypoints.api_server",
        "--host=0.0.0.0",
        "--port=8080",
        f"--model={model_id}",
        f"--tensor-parallel-size={accelerator_count}",
        "--swap-space=16",
        f"--gpu-memory-utilization={gpu_memory_utilization}",
        f"--max-model-len={max_model_len}",
        f"--dtype={dtype}",
        f"--max-loras={max_loras}",
        f"--max-cpu-loras={max_cpu_loras}",
        f"--max-num-seqs={max_num_seqs}",
        "--disable-log-stats",
    ]

    if enable_trust_remote_code:
        vllm_args.append("--trust-remote-code")
    if enforce_eager:
        vllm_args.append("--enforce-eager")
    if enable_lora:
        vllm_args.append("--enable-lora")
    if model_type:
        vllm_args.append(f"--model-type={model_type}")

    env_vars = {
        "MODEL_ID": base_model_id,
        "DEPLOY_SOURCE": "notebook",
    }

    # HF_TOKEN is not a compulsory field and may not be defined.
    try:
        if HF_TOKEN:
            env_vars["HF_TOKEN"] = HF_TOKEN
    except NameError:
        pass

    model = aiplatform.Model.upload(
        display_name=model_name,
        serving_container_image_uri=VLLM_DOCKER_URI,
        serving_container_args=vllm_args,
        serving_container_ports=[8080],
        serving_container_predict_route="/generate",
        serving_container_health_route="/ping",
        serving_container_environment_variables=env_vars,
        serving_container_shared_memory_size_mb=(16 * 1024),
        serving_container_deployment_timeout=7200,
    )
    print(f"Deploying {model_name} on {machine_type} with {accelerator_count} {accelerator_type} GPU(s).")

    model.deploy(
        endpoint=endpoint,
        machine_type=machine_type,
        accelerator_type=accelerator_type,
        accelerator_count=accelerator_count,
        deploy_request_timeout=1800,
        service_account=service_account,
    )
    print("endpoint_name:", endpoint.name)

    return model, endpoint
שלב 4: הפעלת הפריסה
מריצים את פונקציית הפריסה עם המודל וההגדרות שהוגדרו. הפונקציה תחזיר את המודל ואת מופעי נקודת הקצה, שאפשר להשתמש בהם להסקת מסקנות.
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
models["vllm_gpu"], endpoints["vllm_gpu"] = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type=machine_type,
    accelerator_type=accelerator_type,
    accelerator_count=accelerator_count,
    gpu_memory_utilization=gpu_memory_utilization,
    max_model_len=max_model_len,
    enforce_eager=True,
    use_dedicated_endpoint=use_dedicated_endpoint,
    max_num_seqs=max_num_seqs,
)
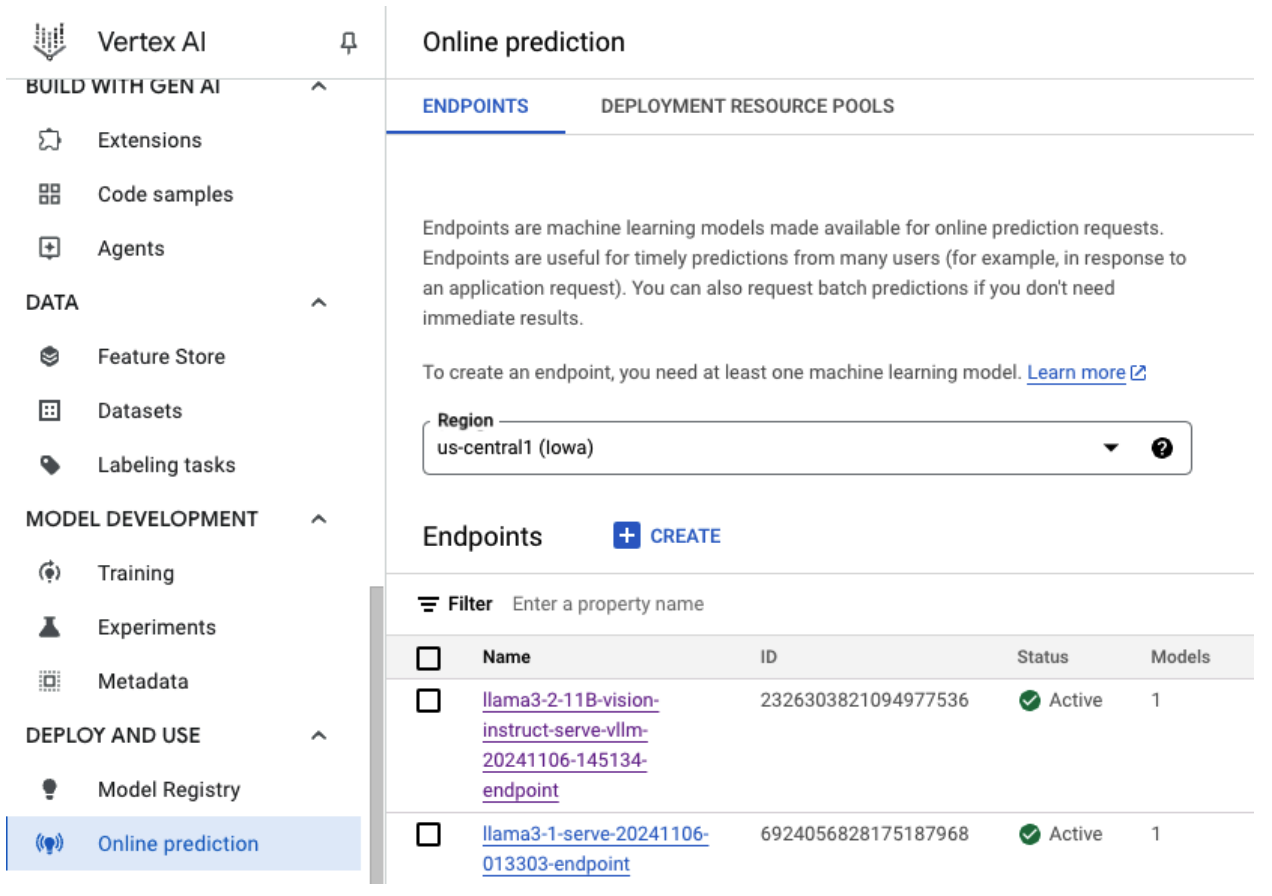 איור 5: נקודת פריסה של Llama 3.2 בלוח הבקרה של Vertex
בהתאם לגודל המודל, פריסת מודל חדש יכולה להימשך עד שעה. אפשר לבדוק את ההתקדמות שלו בחיזוי אונליין.
הסקת מסקנות באמצעות vLLM ב-Gemini Enterprise Agent Platform באמצעות נתיב חיזוי ברירת המחדל
בקטע הזה נסביר איך להגדיר הסקה למודל Llama 3.2 Vision בפלטפורמת הסוכנים של Gemini Enterprise באמצעות נתיב החיזוי שמוגדר כברירת מחדל. תשתמשו בספריית vLLM כדי להפעיל את המודל בצורה יעילה, ותשלחו לו הנחיה ויזואלית בשילוב עם טקסט כדי ליצור אינטראקציה איתו.
כדי להתחיל, מוודאים שנקודת הקצה של המודל פרוסה ומוכנה לחיזויים.
שלב 1: מגדירים את ההנחיה והפרמטרים
בדוגמה הזו מופיעות כתובת URL של תמונה והנחייה טקסטואלית, שהמודל יעבד כדי ליצור תשובה.
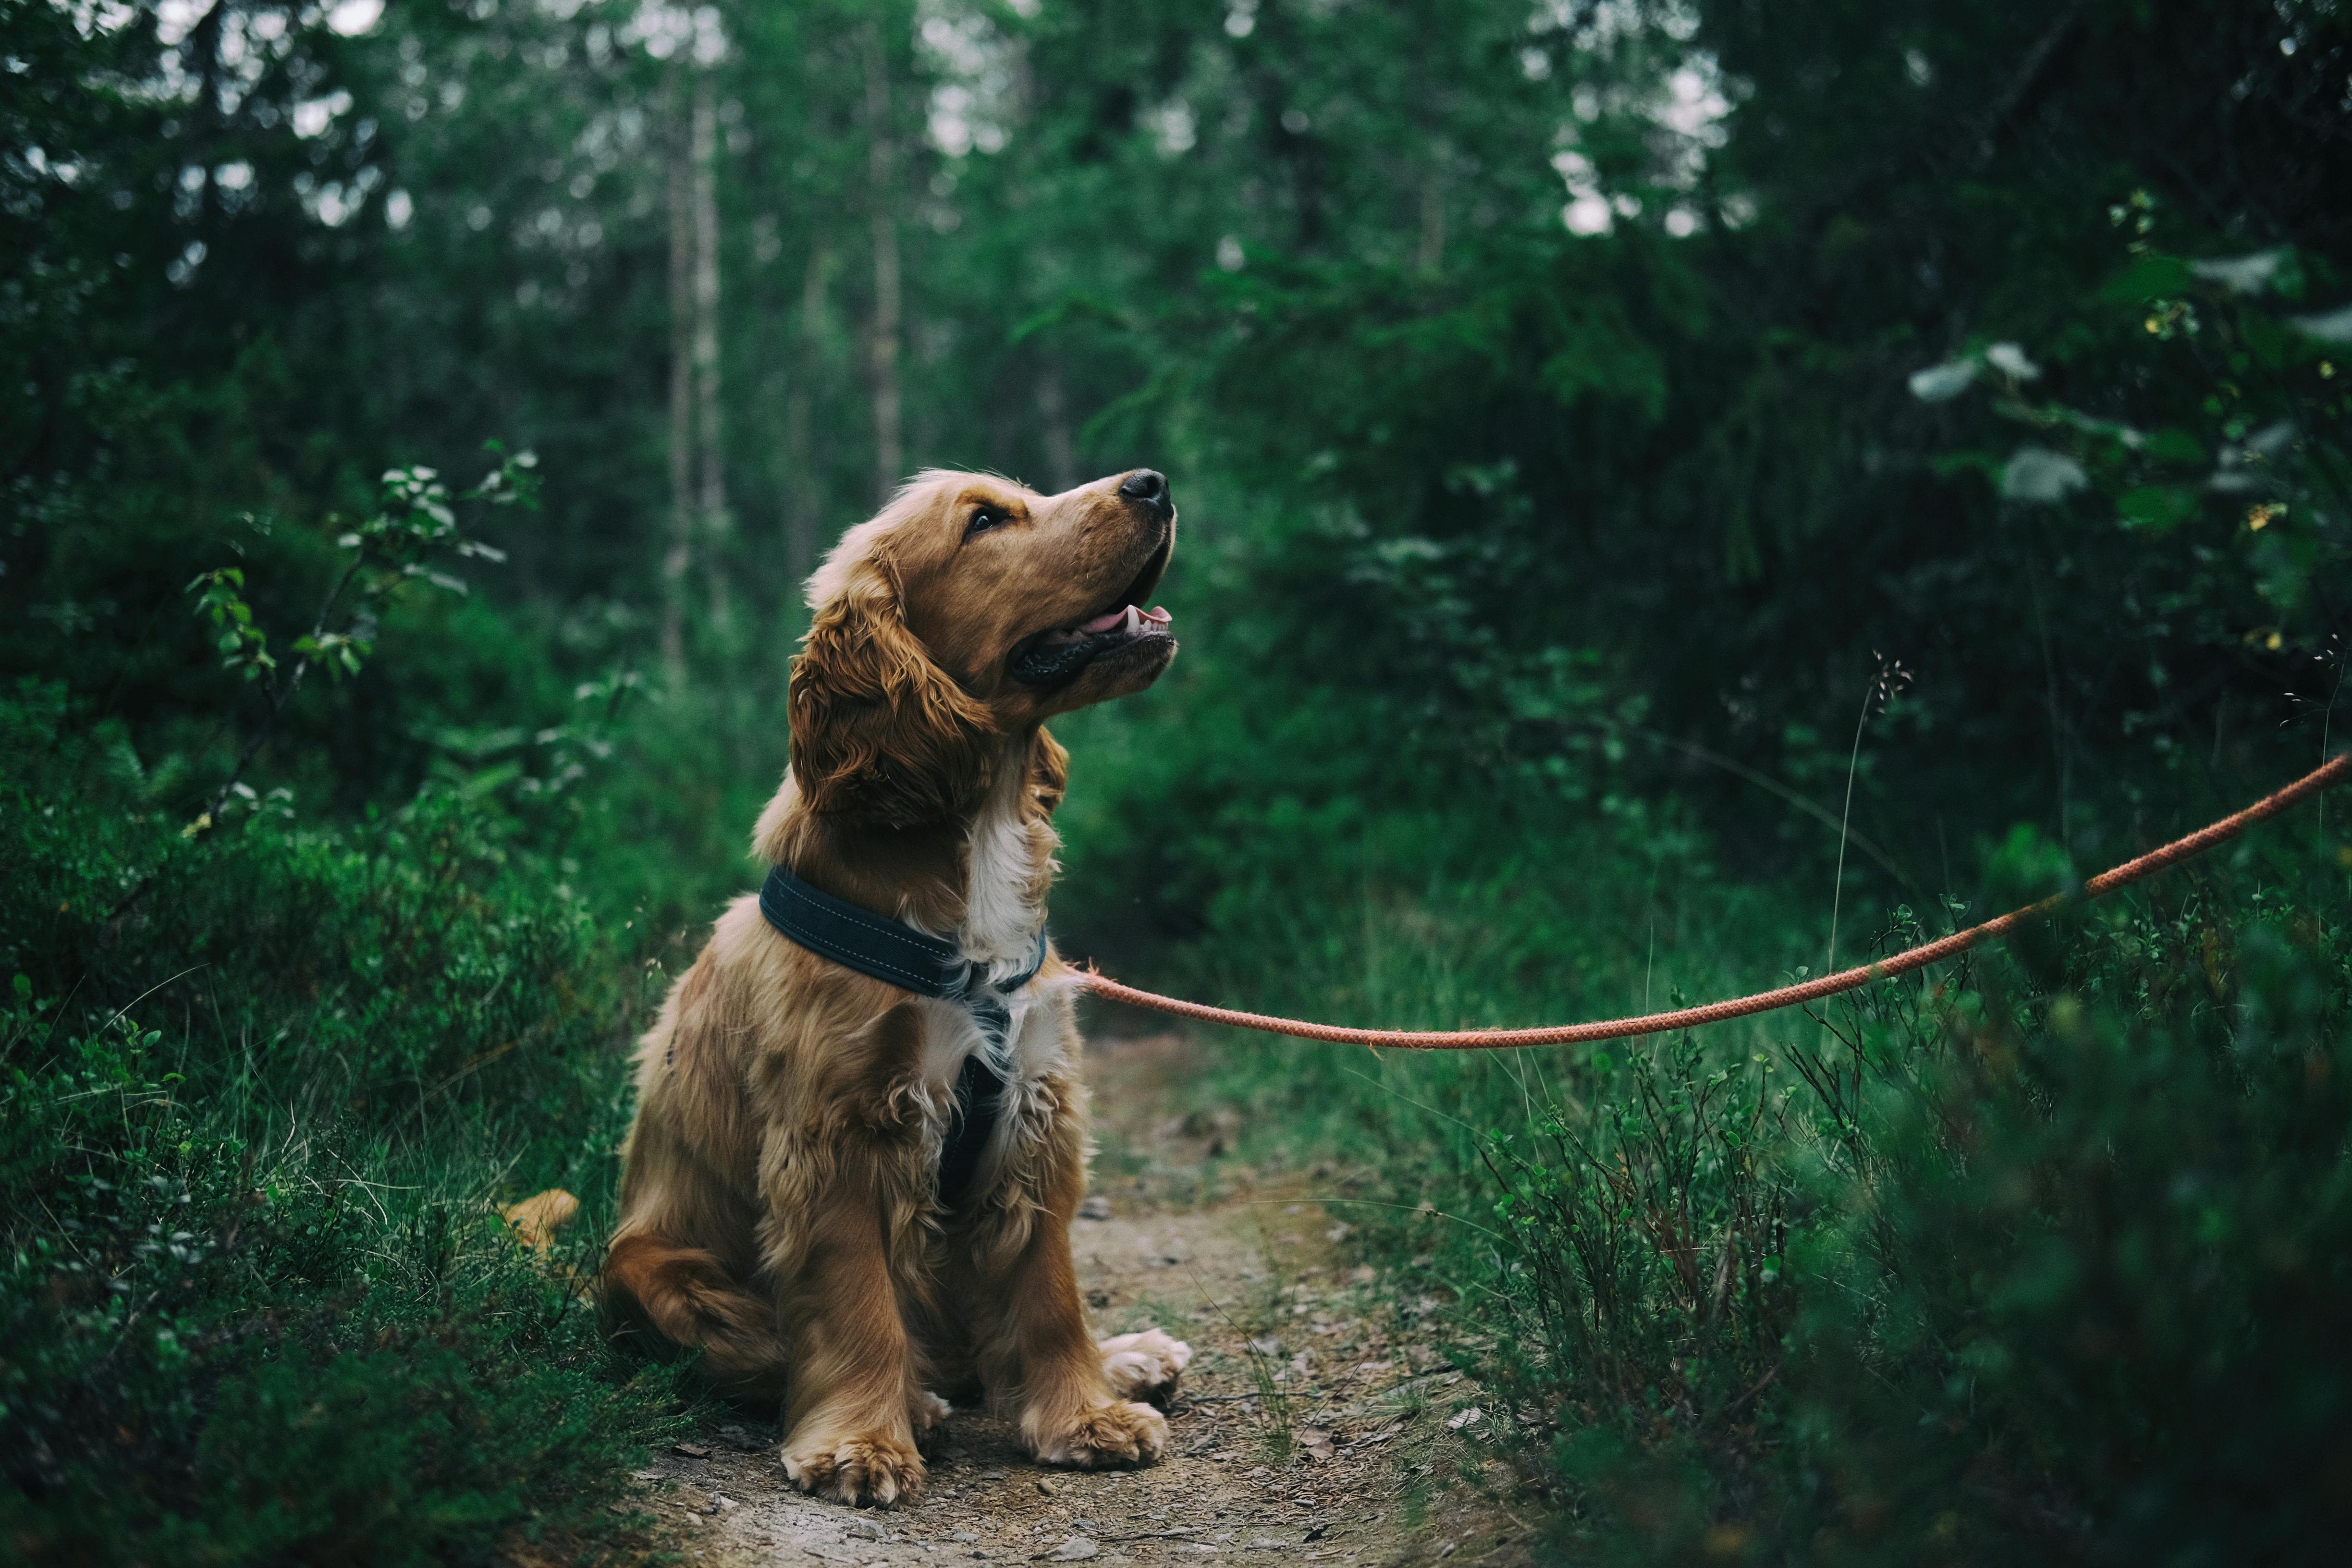 איור 6: דוגמה לקלט של תמונה להנחיית Llama 3.2
image_url = "https://images.pexels.com/photos/1254140/pexels-photo-1254140.jpeg"

raw_prompt = "This is a picture of"

# Reference prompt formatting guidelines here: https://www.Llama.com/docs/model-cards-and-prompt-formats/Llama3_2/#-base-model-prompt
prompt = f"<|begin_of_text|><|image|>{raw_prompt}"
שלב 2: הגדרת פרמטרים של חיזוי
כדי לשלוט בתשובה של המודל, משנים את הפרמטרים הבאים:
max_tokens = 64

temperature = 0.5

top_p = 0.95
שלב 3: הכנת בקשת החיזוי
מגדירים את בקשת החיזוי עם כתובת ה-URL של התמונה, ההנחיה ופרמטרים אחרים.
instances = [
    {
        "prompt": prompt,
        "multi_modal_data": {"image": image_url},
        "max_tokens": max_tokens,
        "temperature": temperature,
        "top_p": top_p,
    },
]
שלב 4: יצירת התחזית
שולחים את הבקשה לנקודת הקצה של Gemini Enterprise Agent Platform ומעבדים את התשובה:
response = endpoints["vllm_gpu"].predict(instances=instances)

for raw_prediction in response.predictions:
    prediction = raw_prediction.split("Output:")
    print(prediction[1])
אם נתקלתם בבעיית זמן קצוב לתפוגה (לדוגמה, ServiceUnavailable: 503 Took too
long to respond when processing), נסו להקטין את הערך של max_tokens למספר נמוך יותר, כמו 20, כדי לקצר את זמן התגובה.
הסקת מסקנות באמצעות vLLM ב-Gemini Enterprise Agent Platform באמצעות OpenAI Chat Completion
בקטע הזה מוסבר איך לבצע הסקת מסקנות במודלים של Llama 3.2 Vision באמצעות OpenAI Chat Completions API ב-Gemini Enterprise Agent Platform. הגישה הזו מאפשרת לכם להשתמש ביכולות מולטי-מודאליות על ידי שליחת הנחיות של תמונות וטקסט למודל, כדי לקבל תשובות אינטראקטיביות יותר.
שלב 1: הפעלת הפריסה של מודל Llama 3.2 Vision Instruct
מריצים את פונקציית הפריסה עם המודל וההגדרות שהוגדרו. הפונקציה תחזיר את המודל ואת מופעי נקודת הקצה, שאפשר להשתמש בהם להסקת מסקנות.
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
model_name = common_util.get_job_name_with_datetime(prefix=f"{base_model_name}-serve-vllm")
model, endpoint = deploy_model_vllm(
    model_name=model_name
    model_id=hf_model_id,
    base_model_id=hf_model_id,
    service_account=SERVICE_ACCOUNT,
    machine_type="a2-highgpu-1g",
    accelerator_type="NVIDIA_TESLA_A100",
    accelerator_count=1,
    gpu_memory_utilization=0.9,
    max_model_len=4096,
    enforce_eager=True,
    max_num_seqs=12,
)
שלב 2: הגדרת משאב של נקודת קצה
מתחילים בהגדרת שם משאב נקודת הקצה לפריסת Gemini Enterprise Agent Platform.
ENDPOINT_RESOURCE_NAME = "projects/{}/locations/{}/endpoints/{}".format(
    PROJECT_ID, REGION, endpoint.name
)
שלב 3: מתקינים את OpenAI SDK ואת ספריות האימות
כדי לשלוח בקשות באמצעות ה-SDK של OpenAI, צריך לוודא שהספריות הנדרשות מותקנות:
!pip install -qU openai google-auth requests
שלב 4: הגדרת פרמטרים של קלט להשלמת צ'אט
מגדירים את כתובת ה-URL של התמונה ואת ההנחייה הטקסטואלית שיישלחו למודל. משנים את הערכים של max_tokens ושל temperature כדי לשלוט באורך התשובה וברמת הרנדומיזציה שלה, בהתאמה.
user_image = "https://images.freeimages.com/images/large-previews/ab3/puppy-2-1404644.jpg"
user_message = "Describe this image?"
max_tokens = 50
temperature = 1.0
שלב 5: הגדרת אימות וכתובת URL בסיסית
מאחזרים את פרטי הכניסה ומגדירים את כתובת ה-URL הבסיסית לבקשות API.
import google.auth
import openai

creds, project = google.auth.default()
auth_req = google.auth.transport.requests.Request()
creds.refresh(auth_req)

BASE_URL = (
    f"https://{REGION}-aiplatform.googleapis.com/v1beta1/{ENDPOINT_RESOURCE_NAME}"
)
try:
    if use_dedicated_endpoint:
        BASE_URL = f"https://{DEDICATED_ENDPOINT_DNS}/v1beta1/{ENDPOINT_RESOURCE_NAME}"
except NameError:
    pass
שלב 6: שליחת בקשת השלמה של צ'אט
משתמשים ב-Chat Completions API של OpenAI כדי לשלוח את התמונה ואת הנחייה טקסטואלית לנקודת הקצה של Gemini Enterprise Agent Platform:
client = openai.OpenAI(base_url=BASE_URL, api_key=creds.token)

model_response = client.chat.completions.create(
    model="",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "image_url", "image_url": {"url": user_image}},
                {"type": "text", "text": user_message},
            ],
        }
    ],
    temperature=temperature,
    max_tokens=max_tokens,
)

print(model_response)
(אופציונלי) שלב 7: חיבור מחדש לנקודת קצה קיימת
כדי להתחבר מחדש לנקודת קצה שנוצרה בעבר, משתמשים במזהה נקודת הקצה. השלב הזה שימושי אם רוצים לעשות שימוש חוזר בנקודת קצה במקום ליצור נקודת קצה חדשה.
endpoint_name = ""
aip_endpoint_name = (
     f"projects/{PROJECT_ID}/locations/{REGION}/endpoints/{endpoint_name}"
)
endpoint = aiplatform.Endpoint(aip_endpoint_name)
ההגדרה הזו מאפשרת גמישות במעבר בין נקודות קצה חדשות לבין נקודות קצה קיימות לפי הצורך, וכך אפשר לבצע בדיקות ופריסה בצורה יעילה.
הסרת המשאבים
כדי להימנע מחיובים שוטפים ולפנות משאבים, חשוב למחוק את המודלים, נקודות הקצה ואת קטגוריית האחסון שבה השתמשתם בניסוי הזה (אם השתמשתם בה).
שלב 1: מחיקת נקודות קצה ומודלים
הקוד הבא יבטל את הפריסה של כל מודל וימחק את נקודות הקצה המשויכות:
# Undeploy model and delete endpoint
for endpoint in endpoints.values():
    endpoint.delete(force=True)

# Delete models
for model in models.values():
    model.delete()
שלב 2: (אופציונלי) מחיקה של קטגוריית אחסון ב-Cloud Storage
אם יצרתם קטגוריה של Cloud Storage במיוחד בשביל הניסוי הזה, אתם יכולים למחוק אותה על ידי הגדרת delete_bucket כ-True. השלב הזה הוא אופציונלי, אבל מומלץ אם אין יותר צורך בדלי.
delete_bucket = False
if delete_bucket:
    ! gsutil -m rm -r $BUCKET_NAME
השלבים האלה יעזרו לכם לוודא שכל המשאבים שבהם השתמשתם במדריך הזה יוסרו, וכך תצמצמו את העלויות המיותרות שקשורות לניסוי.
ניפוי באגים בבעיות נפוצות
בקטע הזה מפורטת הדרכה לזיהוי ולפתרון של בעיות נפוצות שמתרחשות במהלך פריסה של מודל vLLM והסקת מסקנות ב-Gemini Enterprise Agent Platform.
בדיקת היומנים
בודקים את היומנים כדי לזהות את שורש הבעיה של כשלים בהטמעה או התנהגות לא צפויה:
- כדי לעבור אל Gemini Enterprise Agent Platform Prediction Console: עוברים אל Gemini Enterprise Agent Platform Prediction Console במסוף Cloud de Confiance .
- בחירת נקודת הקצה: לוחצים על נקודת הקצה שבה יש בעיות. הסטטוס אמור להצביע על כך שהפריסה נכשלה.
- הצגת יומנים: לוחצים על נקודת הקצה ועוברים לכרטיסייה Logs או לוחצים על View logs. כך תועברו ל-Cloud Logging, עם סינון שיציג יומנים שספציפיים לנקודת הקצה ולפריסת המודל. אפשר גם לגשת ליומנים ישירות דרך שירות Cloud Logging.
- ניתוח היומנים: בודקים את הרשומות ביומן כדי למצוא הודעות שגיאה, אזהרות ומידע רלוונטי אחר. אפשר לראות את חותמות הזמן כדי לקשר בין רשומות ביומן לבין פעולות ספציפיות. כדאי לחפש בעיות שקשורות למגבלות משאבים (זיכרון ומעבד), בעיות באימות או שגיאות בהגדרות.
בעיה נפוצה 1: שגיאת CUDA Out of Memory (OOM) במהלך הפריסה
שגיאות CUDA Out of Memory (OOM) מתרחשות כששימוש הזיכרון של המודל חורג מהקיבולת הזמינה של ה-GPU.
במקרה של מודל הטקסט בלבד, השתמשנו בארגומנטים הבאים של המנוע:
base_model_name = "Meta-Llama-3.1-8B"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 256
במקרה של המודל המולטי-מודאלי, השתמשנו בארגומנטים הבאים של המנוע:
base_model_name = "Llama-3.2-11B-Vision-Instruct"
hf_model_id = f"meta-llama/{base_model_name}"
accelerator_type = "NVIDIA_L4"
accelerator_count = 1
machine_type = "g2-standard-12"
accelerator_count: int = 1
gpu_memory_utilization = 0.9
max_model_len = 4096
dtype = "auto"
max_num_seqs = 12
פריסת המודל הרב-אופני עם max_num_seqs = 256, כמו שעשינו במקרה של מודל טקסט בלבד, עלולה לגרום לשגיאה הבאה:
[rank0]: torch.OutOfMemoryError: CUDA out of memory. Tried to allocate 3.91 GiB. GPU 0 has a total capacity of 39.38 GiB of which 3.76 GiB is free. Including non-PyTorch memory, this process has 0 bytes memory in use. Of the allocated memory 34.94 GiB is allocated by PyTorch, and 175.15 MiB is reserved by PyTorch but unallocated. If reserved but unallocated memory is large try setting PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True to avoid fragmentation. See documentation for Memory Management (https://pytorch.org/docs/stable/notes/cuda.html#environment-variables)
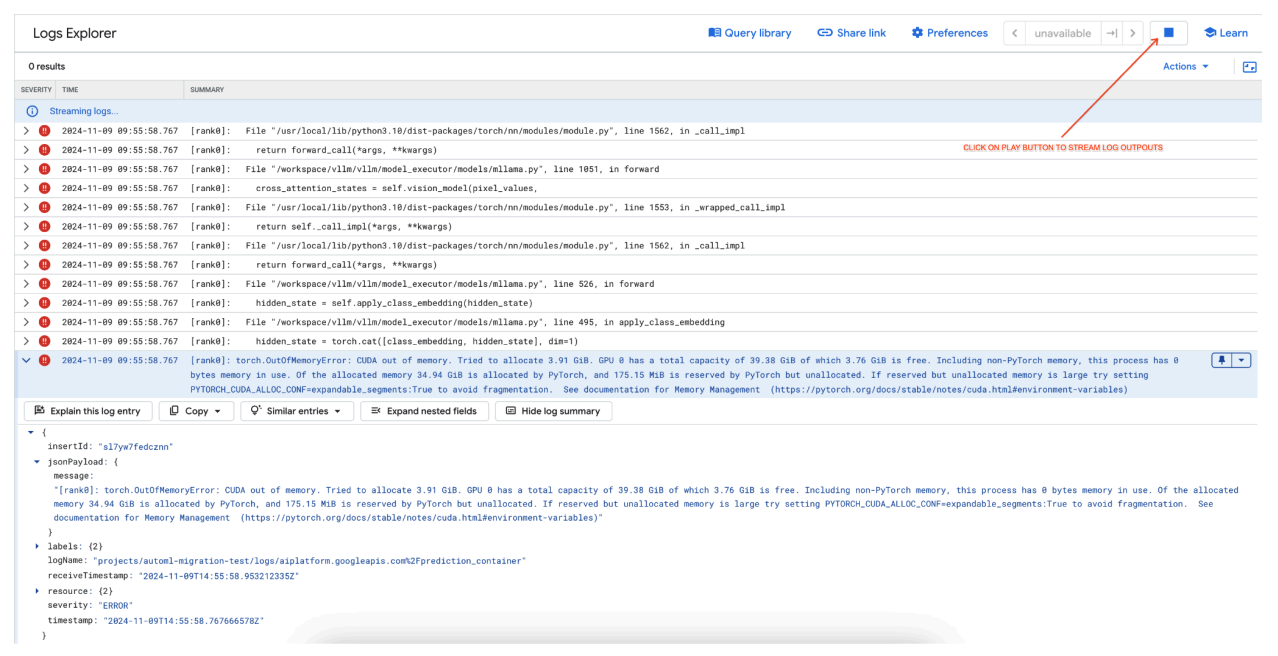 איור 7: יומן שגיאות של GPU שנגרמו בגלל חוסר זיכרון (OOM)
הסבר על max_num_seqs וזיכרון GPU:
- הפרמטר
max_num_seqsמגדיר את המספר המקסימלי של בקשות בו-זמניות שהמודל יכול לטפל בהן. - כל רצף שעובר עיבוד על ידי המודל צורך זיכרון GPU. השימוש הכולל בזיכרון פרופורציונלי ל-
max_num_seqsכפול הזיכרון לכל רצף. - מודלים של טקסט בלבד (כמו Meta-Llama-3.1-8B) צורכים בדרך כלל פחות זיכרון לכל רצף מאשר מודלים מולטי-מודאליים (כמו Llama-3.2-11B-Vision-Instruct), שמבצעים עיבוד של טקסט ותמונות.
בודקים את יומן השגיאות (איור 8):
- בקטע היומן מופיע
torch.OutOfMemoryErrorכשמנסים להקצות זיכרון ב-GPU. - השגיאה מתרחשת כי השימוש בזיכרון של המודל חורג מהקיבולת הזמינה של ה-GPU. ל-GPU NVIDIA L4 יש 24GB, והגדרת הפרמטר
max_num_seqsבגובה גבוה מדי עבור המודל המולטי-מודאלי גורמת להצפה. - היומן מצביע על הגדרה של
PYTORCH_CUDA_ALLOC_CONF=expandable_segments:Trueכדי לשפר את ניהול הזיכרון, אבל הבעיה העיקרית כאן היא שימוש גבוה בזיכרון.
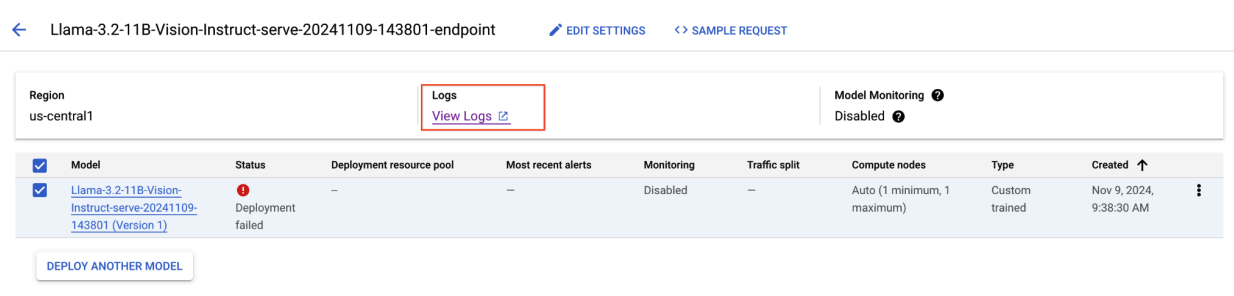 איור 8: פריסה שנכשלה של Llama 3.2
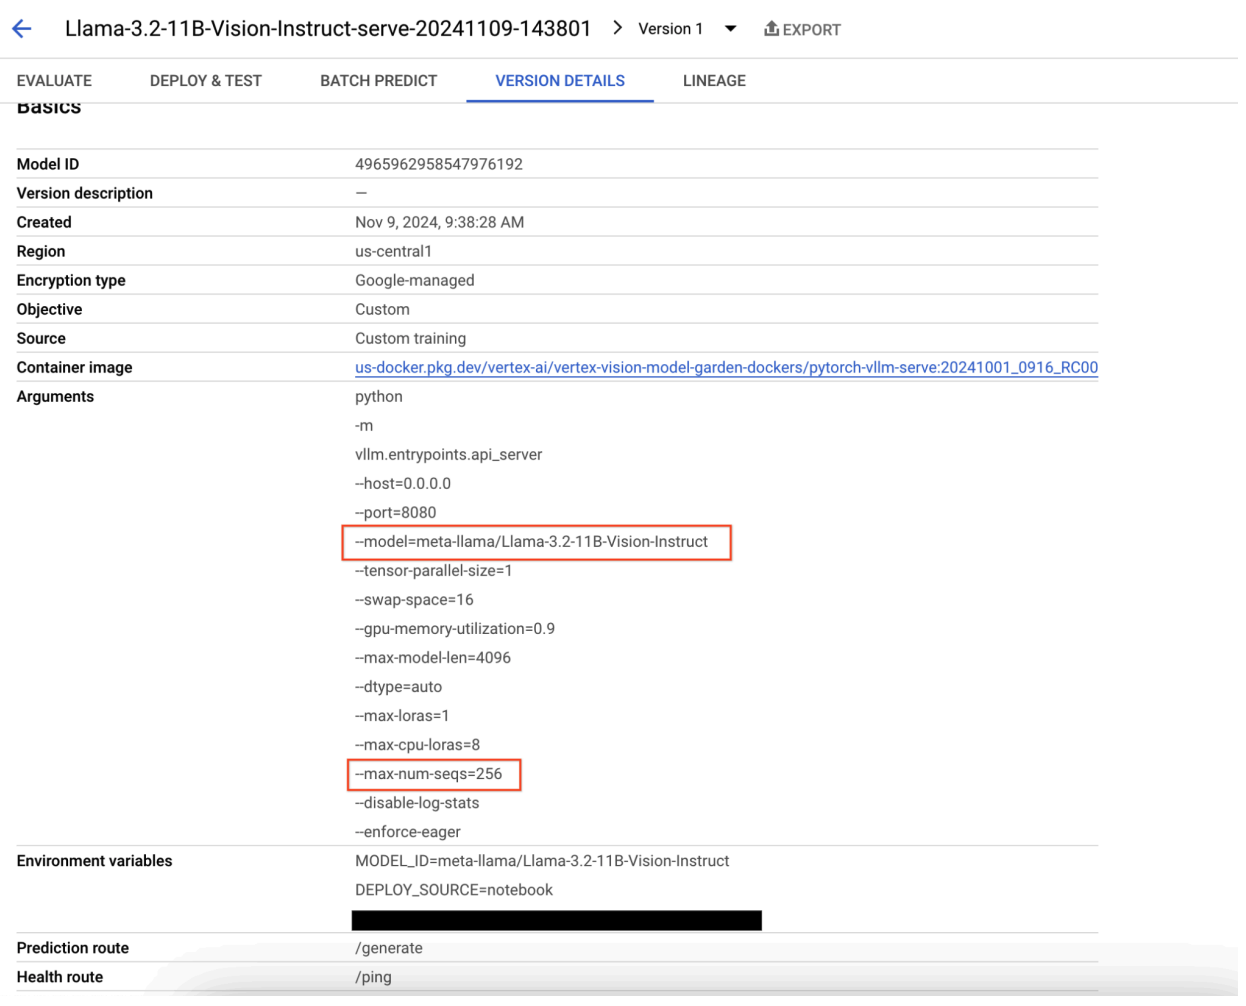 איור 9: חלונית הפרטים של גרסת המודל
כדי לפתור את הבעיה, עוברים אל מסוף התחזיות של Gemini Enterprise Agent Platform ולוחצים על נקודת הקצה. הסטטוס אמור לציין שהפריסה נכשלה. לוחצים כדי לראות את היומנים. מוודאים ש-max-num-seqs = 256. הערך הזה גבוה מדי עבור Llama-3.2-11B-Vision-Instruct. ערך מתאים יותר הוא 12.
בעיה נפוצה 2: נדרש טוקן של Hugging Face
שגיאות באסימון של Hugging Face מתרחשות כשהמודל מוגבל ונדרשים פרטי אימות מתאימים כדי לגשת אליו.
בצילום המסך הבא מוצגת רשומה ביומן בכלי Log Explorer של Google Cloud, שבה מוצגת הודעת שגיאה שקשורה לגישה למודל Meta LLaMA-3.2-11B-Vision שמתארח ב-Hugging Face. השגיאה מציינת שהגישה למודל מוגבלת, ונדרש אימות כדי להמשיך. בהודעה מצוין במפורש "Cannot access gated repository for URL" (אי אפשר לגשת למאגר עם גישה מוגבלת בכתובת ה-URL), ומוסבר שהגישה למודל מוגבלת ונדרשים אישורי אימות מתאימים כדי לגשת אליו. רשומת היומן הזו יכולה לעזור בפתרון בעיות שקשורות לאימות כשעובדים עם משאבים מוגבלים במאגרים חיצוניים.
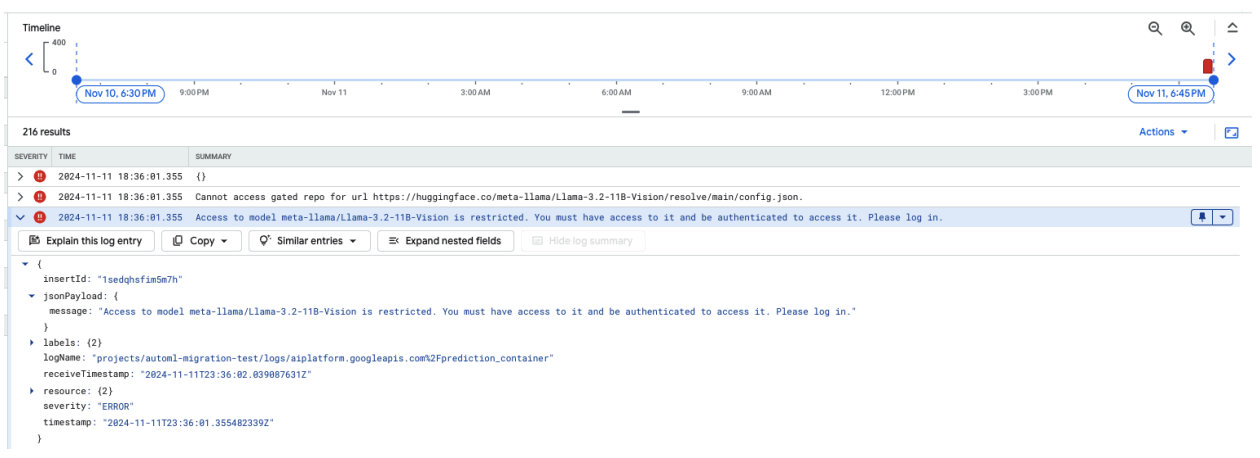 איור 10: שגיאה באסימון של Hugging Face
כדי לפתור את הבעיה, צריך לאמת את ההרשאות של אסימון הגישה של Hugging Face. מעתיקים את הטוקן האחרון ומפעילים נקודת קצה חדשה.
בעיה נפוצה 3: נדרשת תבנית לצ'אט
שגיאות בתבנית של הצ'אט מתרחשות כשתבנית הצ'אט שמוגדרת כברירת מחדל כבר לא מותרת, וצריך לספק תבנית צ'אט בהתאמה אישית אם הטוקנייזר לא מגדיר תבנית כזו.
צילום המסך הזה מציג רשומה ביומן בכלי Log Explorer של Google Cloud, שבה מתרחשת שגיאת ValueError בגלל תבנית חסרה של צ'אט בספריית ה-transformers בגרסה 4.44. הודעת השגיאה מציינת שאסור יותר להשתמש בתבנית ברירת המחדל של הצ'אט, וצריך לספק תבנית צ'אט בהתאמה אישית אם הטוקנייזר לא מגדיר תבנית כזו. השגיאה הזו מצביעה על שינוי שבוצע לאחרונה בספרייה, שדורש הגדרה מפורשת של תבנית צ'אט. היא שימושית לניפוי באגים בבעיות שמתרחשות כשפורסים אפליקציות מבוססות צ'אט.
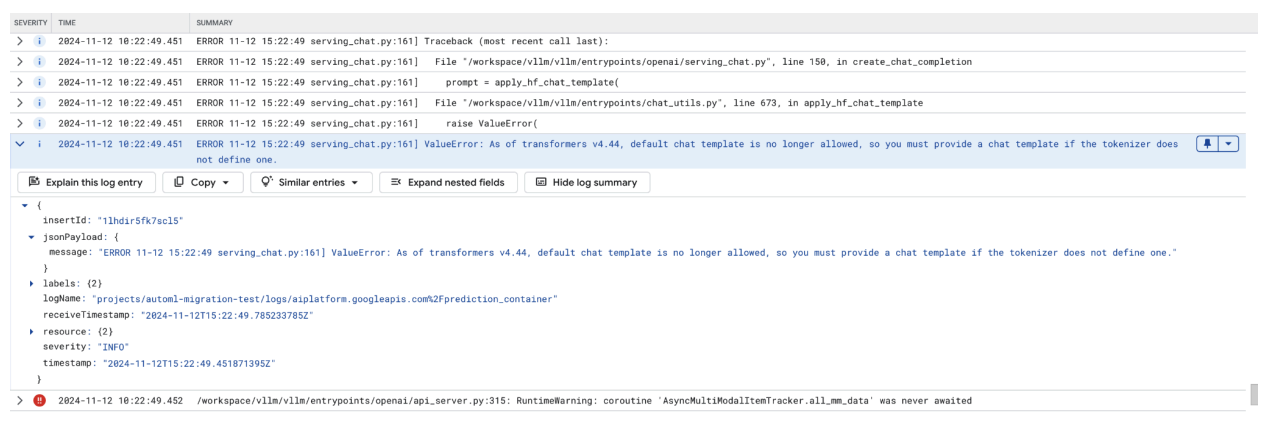 איור 11: נדרשת תבנית צ'אט
כדי לעקוף את זה, צריך לוודא שמספקים תבנית צ'אט במהלך הפריסה באמצעות הארגומנט --chat-template input. תבניות לדוגמה אפשר למצוא במאגר vLLM examples.
בעיה נפוצה 4: Model Max Seq Len (אורך הרצף המקסימלי של המודל)
שגיאות של אורך רצף מקסימלי של המודל מתרחשות כשאורך הרצף המקסימלי של המודל (4096) גדול ממספר הטוקנים המקסימלי שאפשר לאחסן במטמון KV (2256).
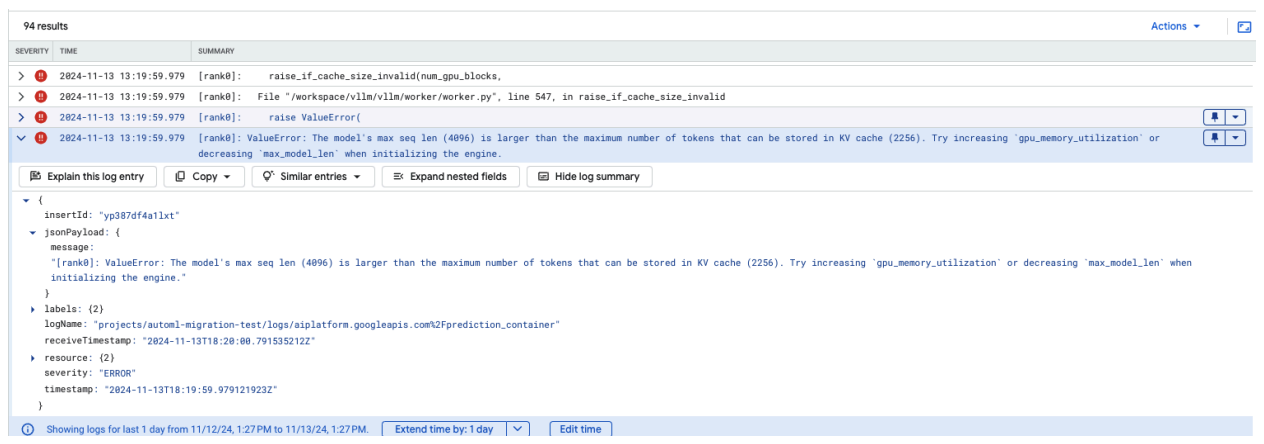 איור 12: האורך המקסימלי של הרצף גדול מדי
ValueError: The model's max seq len (4096) is larger than the maximum number of
tokens that can be stored in KV cache (2256). אפשר לנסות להגדיל את gpu_memory_utilization או להקטין את max_model_len כשמפעילים את המנוע.
כדי לפתור את הבעיה, צריך להגדיר את הערך של max_model_len ל-2048, שהוא קטן מ-2256. פתרון נוסף לבעיה הזו הוא להשתמש ביותר יחידות GPU או ביחידות GPU גדולות יותר. אם בוחרים להשתמש ביותר יחידות GPU, צריך להגדיר את tensor-parallel-size בהתאם.
נתוני גרסאות של קונטיינר vLLM ב-Model Garden
גרסאות ראשיות
Standard vLLM
תאריך השקה |
ארכיטקטורה |
גרסת vLLM |
Container URI |
|---|---|---|---|
| Jul 17, 2025 | ARM |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250717_0916_arm_RC01 |
| 10 ביולי 2025 | x86 |
v0.9.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250710_0916_RC01 |
| 20 ביוני 2025 | x86 |
Past v0.9.1, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250620_0916_RC01 |
| 11 ביוני 2025 | x86 |
v0.9.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250611_0916_RC01 |
| 2 ביוני 2025 | x86 |
v0.9.0 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250601_0916_RC01 |
| 6 במאי 2025 | x86 |
v0.8.5.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250506_0916_RC01 |
| Apr 29, 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250429_0916_RC01, 20250430_0916_RC00_maas |
| 17 באפריל 2025 | x86 |
v0.8.4 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250417_0916_RC01 |
| 10 באפריל 2025 | x86 |
גרסה v0.8.3 ומגרסאות קודמות, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250410_0917_RC01 |
| 7 באפריל 2025 | x86 |
v0.8.3 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250407_0917_RC01, 20250407_0917_RC0120250429_0916_RC00_maas |
| 7 באפריל 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250404_0916_RC01 |
| 5 באפריל 2025 | x86 |
גרסה קודמת v0.8.2, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250405_1205_RC01 |
| 31 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250401_0916_RC01 |
| 26 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250327_0916_RC01 |
| 23 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250324_0916_RC01 |
| 21 במרץ 2025 | x86 |
v0.8.1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250321_0916_RC01 |
| 11 במרץ 2025 | x86 |
גרסה v0.7.3 ומעלה, commit |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250312_0916_RC01 |
| 3 במרץ 2025 | x86 |
v0.7.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250304_0916_RC01 |
| 14 בינואר 2025 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20250114_0916_RC00_maas |
| Dec 2, 2024 | x86 |
v0.6.4.post1 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241202_0916_RC00_maas |
| Nov 12, 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241112_0916_RC00_maas |
| 16 באוקטובר 2024 | x86 |
v0.6.2 |
us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:20241016_0916_RC00_maas |
מודל vLLM שעבר אופטימיזציה
תאריך השקה |
ארכיטקטורה |
Container URI |
|---|---|---|
| 21 בינואר 2025 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20250121_0835_RC00 |
| 29 באוקטובר 2024 | x86 |
us-docker.pkg.dev/vertex-ai-restricted/vertex-vision-model-garden-dockers/pytorch-vllm-optimized-serve:20241029_0835_RC00 |
פריטי תוכן נוספים
הרשימה המלאה של מהדורות קונטיינר סטנדרטיות של vLLM ב-VMG זמינה בדף Artifact Registry.
גרסאות של vLLM-TPU בסטטוס ניסיוני מתויגות ב-<yyyymmdd_hhmm_tpu_experimental_RC00>.