

El aprendizaje por refuerzo es una técnica poderosa para adaptar modelos de lenguaje grandes (LLMs) y maximizar las recompensas de comentarios proporcionadas por una función de recompensa definida por el usuario. El modelo explora muchas respuestas posibles, observa una recompensa numérica para cada una y, gradualmente, cambia su comportamiento para que las respuestas con recompensas altas sean más probables y las respuestas con recompensas bajas sean menos probables. Este enfoque se destaca en situaciones que requieren razonamiento de varios pasos, toma de decisiones complejas o comprensión de matices sutiles en las instrucciones.
La optimización con aprendizaje por refuerzo para Gemini te permite optimizar Gemini con tus propias instrucciones y funciones de recompensa definidas por ti mismo. Puedes usarlo para mejorar la capacidad de razonamiento y la calidad del resultado de los modelos de Gemini para tus propios casos de uso y flujos de trabajo de agentes.
Cómo funciona
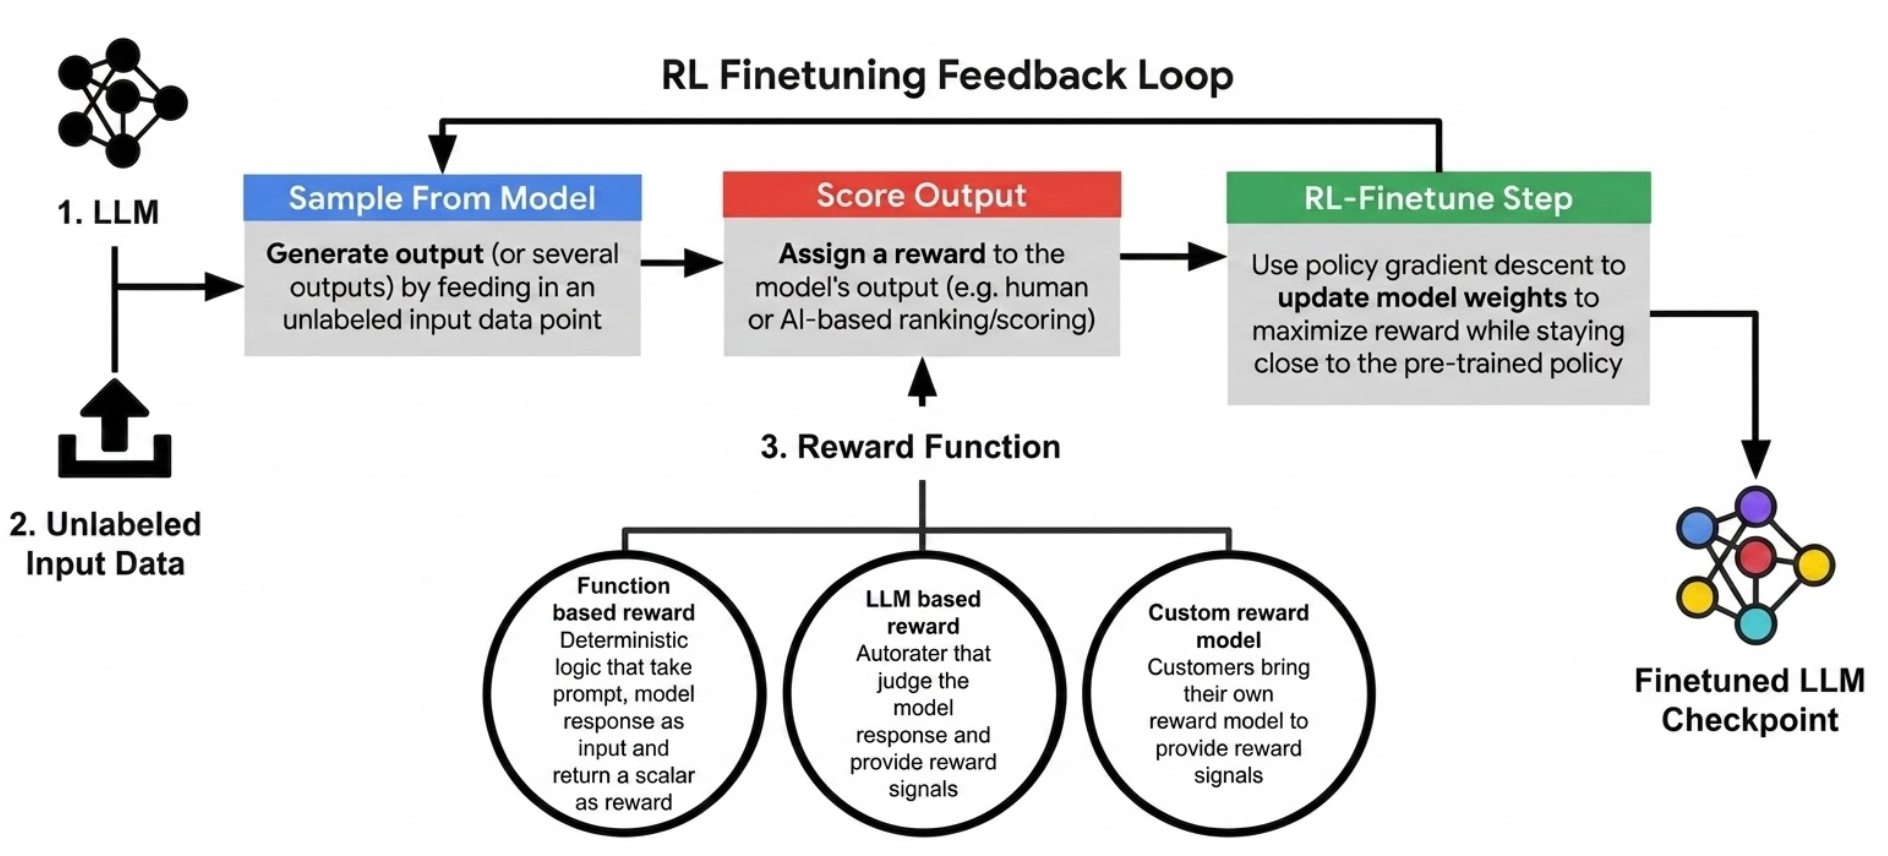
El ajuste del aprendizaje por refuerzo opera de forma iterativa para refinar el comportamiento del LLM. Durante cada iteración, el modelo genera respuestas a un conjunto de instrucciones. Luego, un usuario evalúa estas respuestas con una función de recompensa definida por el usuario, que cuantifica la calidad del resultado generado según los criterios deseados. El servicio usa este indicador de recompensa para actualizar los parámetros del modelo a través de algoritmos de aprendizaje por refuerzo, con el objetivo de fomentar los comportamientos que generan recompensas más altas. Este proceso iterativo de generación, evaluación y actualización permite que el modelo aprenda y se adapte a tus casos de uso específicos.
En el siguiente diagrama, se muestra el flujo de trabajo general del ajuste de aprendizaje por refuerzo:
Características clave
Funciones de recompensa personalizables: Define tus propias funciones de recompensa para optimizar con precisión una amplia variedad de casos de uso personalizados y alinear el comportamiento del modelo con objetivos específicos. Para obtener detalles sobre los tipos de recompensas admitidos, consulta la página Funciones de recompensa.
Adaptadores para un ajuste eficiente: El ajuste del aprendizaje por refuerzo usa adaptadores, lo que permite una adaptación eficaz y, al mismo tiempo, reutiliza la infraestructura de servicio existente.
Múltiples niveles de razonamiento: El servicio admite el ajuste en dos niveles de razonamiento,
MINIMALyHIGH(razonamiento dinámico), por lo que puedes elegir el enfoque que mejor se adapte a los objetivos de aprendizaje de tu modelo y a los patrones de generación de respuestas deseados. Para obtener más información, consulta la página Hiperparámetros.Ajuste continuo: Refina aún más un modelo ajustado previamente incorporando ejemplos o épocas de entrenamiento adicionales. Usar un modelo o un punto de control existente y ajustado como base permite un proceso más eficiente para la experimentación del ajuste. Para obtener más información, consulta la página Ajuste continuo.
Conjuntos de datos multimodales: Admite modalidades de datos de texto, imagen, video (solo Gemini 3.5 Flash) y audio.
Cuándo usar el ajuste del aprendizaje por refuerzo
Se prefiere el ajuste del aprendizaje por refuerzo para ajustar los LLM en situaciones en las que las estrategias óptimas no son obvias a través del aprendizaje supervisado. Esto incluye tareas en las que el objetivo es optimizar métricas específicas sin etiquetas de verdad fundamental disponibles, en las que la alineación con las preferencias humanas es fundamental (y existe un método de juicio) y para tareas que requieren mucho razonamiento y se benefician de la mejora y la exploración iterativas.
A continuación, se incluyen algunas situaciones en las que se prefiere el ajuste del aprendizaje por refuerzo:
Seguimiento de instrucciones complejas: Cuando el modelo necesita seguir instrucciones complejas en las que el resultado "correcto" no es una sola respuesta, sino que requiere un conjunto de verificaciones. El aprendizaje por refuerzo puede ayudar al modelo a aprender a navegar por estos conjuntos de instrucciones complejos.
Generación de contenido creativo: Para tareas como la generación de escritura creativa, poesía o código altamente especializado, en las que es difícil definir métricas objetivas. El aprendizaje por refuerzo, con una función de recompensa bien diseñada (que puede incluir comentarios humanos o evaluaciones de expertos), puede guiar al modelo hacia resultados más deseables e innovadores.
Tareas de razonamiento: Para las tareas que requieren un razonamiento complejo, como resolver acertijos o problemas matemáticos, el aprendizaje por refuerzo puede incentivar al modelo a explorar diferentes secuencias de "pensamiento" para aprender qué patrones de razonamiento son más eficaces para resolver problemas.
Modelos y regiones compatibles
Los siguientes modelos de Gemini admiten la optimización con aprendizaje por refuerzo:
Gemini 3.5 Flash
| Especificación | Valor |
|---|---|
| Extremos compatibles con el ajuste de modelos |
|
| Extremos compatibles para la entrega de modelos ajustados |
|
| Versión de API | Solo v1beta1 |
Gemini 3.1 Flash-Lite
| Especificación | Valor |
|---|---|
| Extremos compatibles con el ajuste de modelos |
|
| Extremos compatibles para la entrega de modelos ajustados |
|
| Versión de API | Solo v1beta1 |
Modalidades de ajuste admitidas
El ajuste del aprendizaje por refuerzo admite las siguientes modalidades de datos en tus conjuntos de datos de ajuste:
- Texto
- Audio
- Imagen
- Video (solo se admite en Gemini 3.5 Flash)
Para conocer los límites de los conjuntos de datos por modalidad (como la cantidad máxima de archivos por instrucción, el tamaño máximo de los archivos y la longitud total máxima), consulta la página Conjunto de datos de ajuste.
Ajuste continuo
Puedes usar el resultado de un trabajo de ajuste anterior como base para un nuevo trabajo de ajuste con aprendizaje por refuerzo. Se admiten los siguientes patrones de ajuste continuo:
- Ajuste supervisado → Ajuste del aprendizaje por refuerzo
- Ajuste del aprendizaje por refuerzo → Ajuste del aprendizaje por refuerzo
Para obtener detalles sobre la configuración, consulta la página Ajuste continuo.
Entrega el modelo ajustado
Después de un trabajo de ajuste con aprendizaje por refuerzo exitoso en el modelo base de Gemini, se implementa un modelo ajustado basado en el último punto de control en un extremo de tu proyecto. Los modelos ajustados usan la misma estrategia de extremo de servicio que el modelo base. Por ejemplo, si ejecutas un trabajo de ajuste en us-central1, el modelo ajustado se implementa en un extremo multirregional (mREP) de us.
Para recuperar el endpoint del modelo ajustado implementado y ejecutar la inferencia en él, consulta la guía de inicio rápido de la consola deCloud de Confiance o la guía de inicio rápido de la API.
Precios
Precios de ajuste
El ajuste del aprendizaje por refuerzo para Gemini genera tokens en dos fases: una de muestreo y otra de entrenamiento. Los tokens generados durante la fase de entrenamiento se cobran según la sección “Ajuste del modelo” de la página de precios de Gemini Enterprise Agent Platform.
Precios de inferencia
Después del ajuste, se siguen aplicando los costos de inferencia (solicitud de predicción) para el modelo ajustado. Para la inferencia del modelo a partir de Gemini 3, el precio de predicción del extremo del modelo ajustado es 1.5 veces el precio del modelo base. Para obtener más información, consulta Versiones disponibles del modelo estable de Gemini.
Si configuras el Gen AI Evaluation Service para que se ejecute automáticamente durante el ajuste, las evaluaciones se cobrarán como trabajos de predicción por lotes. Para obtener más información, consulta la sección "Ajuste del modelo" de la página de precios de Gemini Enterprise Agent Platform.
¿Qué sigue?
- Sigue la Cloud de Confiance guía de inicio rápido de la consola o la guía de inicio rápido de la API para crear tu primer trabajo de ajuste de aprendizaje por refuerzo.
- Aprende a preparar un conjunto de datos de ajuste y a configurar funciones de recompensa.
- Obtén información para implementar un modelo de Gemini ajustado.