

O aprendizado por reforço é uma técnica eficiente para adaptar modelos de linguagem grandes (LLMs) e maximizar as recompensas de feedback fornecidas por uma função de recompensa definida pelo usuário. O modelo explora muitas respostas possíveis, observa uma recompensa numérica para cada uma e muda gradualmente o comportamento para que as respostas de alta recompensa se tornem mais prováveis e as de baixa recompensa, menos prováveis. Essa abordagem é excelente em cenários que exigem raciocínio em várias etapas, tomada de decisões complexas ou compreensão de nuances sutis em comandos.
Com o ajuste fino de aprendizado por reforço para o Gemini, você pode ajustar o Gemini usando seus próprios comandos e funções de recompensa autodefinidas. É possível usar o Gemini Pro para aumentar a capacidade de raciocínio e a qualidade da saída dos modelos do Gemini nos seus casos de uso e fluxos de trabalho agênticos.
Como funciona
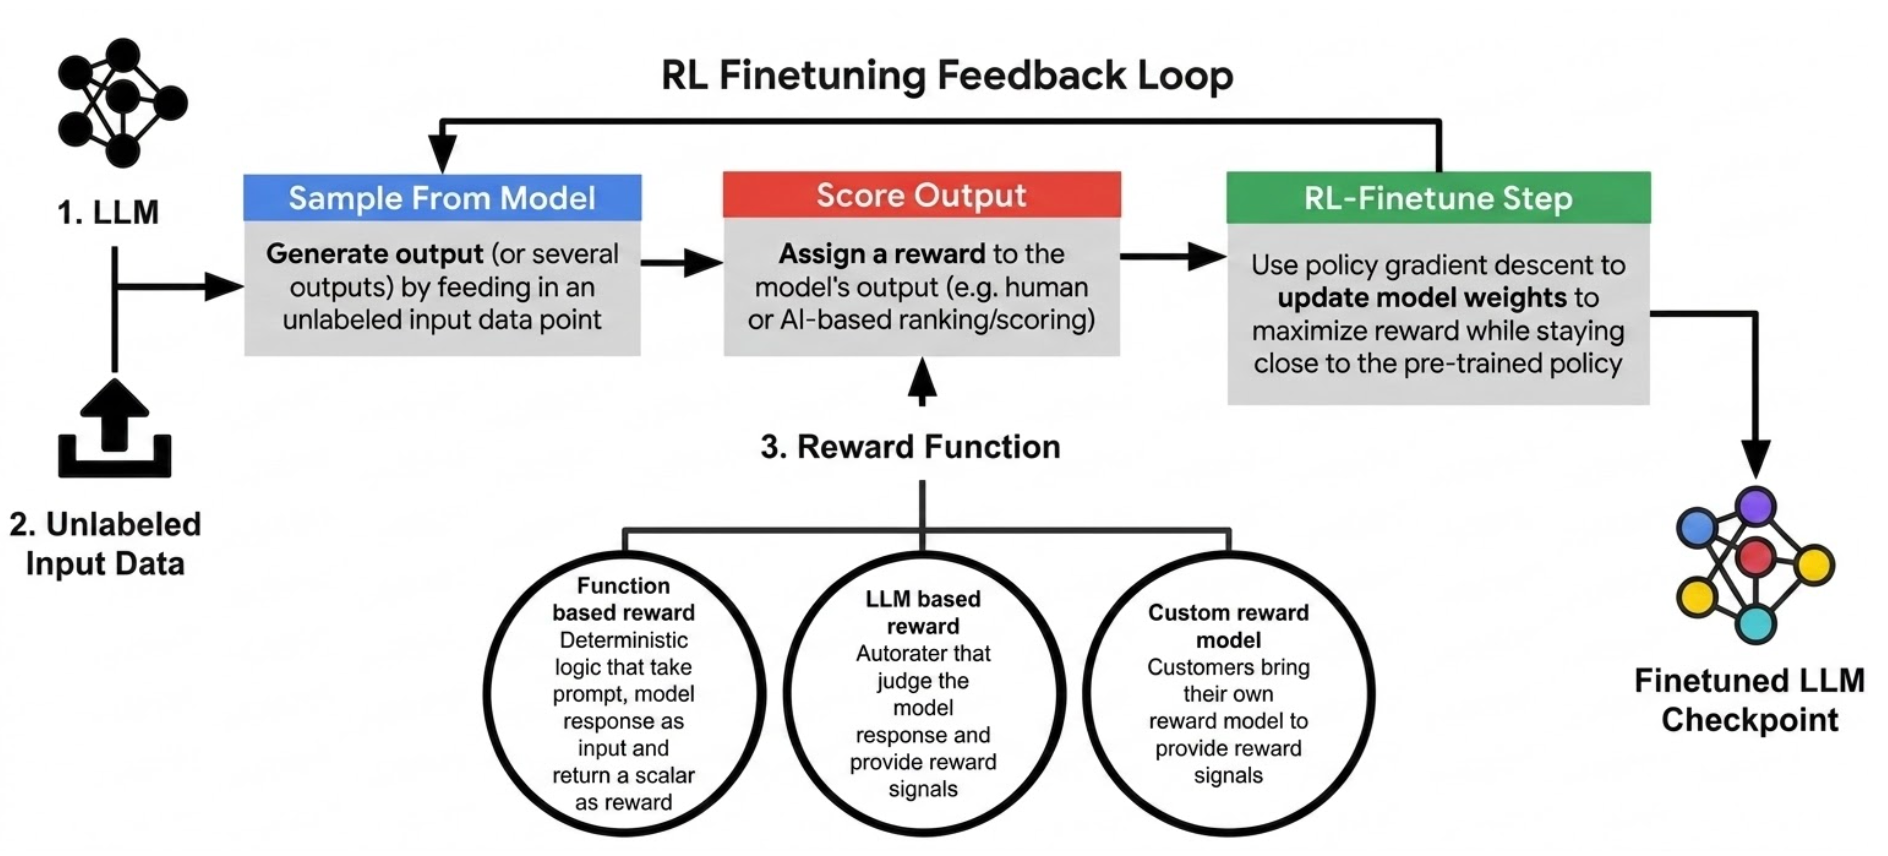
O ajuste do aprendizado por reforço opera de maneira iterativa para refinar o comportamento do LLM. Durante cada iteração, o modelo gera respostas para um conjunto de comandos. Essas respostas são avaliadas por uma função de recompensa definida pelo usuário, que quantifica a qualidade da saída gerada com base nos critérios desejados. O serviço usa esse indicador de recompensa para atualizar os parâmetros do modelo com algoritmos de aprendizado por reforço, incentivando comportamentos que levam a recompensas maiores. Esse processo iterativo de geração, avaliação e atualização permite que o modelo aprenda e se adapte aos seus casos de uso específicos.
O diagrama a seguir mostra o fluxo de trabalho geral de ajuste fino do aprendizado por reforço:
Principais recursos
Funções de recompensa personalizáveis:defina suas próprias funções de recompensa para otimizar com precisão uma ampla variedade de casos de uso personalizados e alinhar o comportamento do modelo a objetivos específicos. Para detalhes sobre os tipos de recompensa compatíveis, consulte a página Funções de recompensa.
Adaptadores para ajuste eficiente:o ajuste do aprendizado por reforço usa adaptadores, que permitem uma adaptação eficaz e reutilizam a infraestrutura de serviço atual.
Vários níveis de raciocínio:o serviço oferece suporte ao ajuste em dois níveis de raciocínio,
MINIMALeHIGH(raciocínio dinâmico), para que você possa escolher a abordagem mais adequada aos objetivos de aprendizado do seu modelo e aos padrões de geração de respostas desejados. Para mais detalhes, consulte a página Hiperparâmetros.Ajuste contínuo:refine ainda mais um modelo ajustado anteriormente incorporando mais exemplos ou épocas de treinamento. Usar um modelo ou ponto de verificação ajustado como base permite um processo mais eficiente para o ajuste de experimentos. Para mais detalhes, consulte a página Ajuste contínuo.
Conjuntos de dados multimodais:aceita modalidades de dados de texto, imagem, vídeo (somente Gemini 3.5 Flash) e áudio.
Quando usar o ajuste do aprendizado por reforço
O ajuste do aprendizado por reforço é preferível para ajustar LLMs em situações em que as estratégias ideais não são óbvias pelo aprendizado supervisionado. Isso inclui tarefas em que o objetivo é otimizar métricas específicas sem rótulos de informações empíricas disponíveis, em que o alinhamento com as preferências humanas é crucial (e existe um método de julgamento) e para tarefas que exigem muito raciocínio e se beneficiam de melhorias e explorações iterativas.
Confira alguns cenários em que o ajuste do aprendizado por reforço é preferível:
Seguir instruções complexas:quando o modelo precisa seguir instruções intrincadas em que a saída "correta" não é uma única resposta, mas requer um conjunto de verificações. O aprendizado por reforço pode ajudar o modelo a aprender a navegar nesses conjuntos de instruções complexos.
Geração de conteúdo criativo:para tarefas como gerar textos criativos, poesia ou código altamente especializado, em que é difícil definir métricas objetivas. O aprendizado por reforço, com uma função de recompensa bem projetada (que pode envolver feedback humano ou avaliação de especialistas), pode orientar o modelo para resultados mais desejáveis e inovadores.
Tarefas de raciocínio:para tarefas que exigem muito raciocínio, como resolver quebra-cabeças de palavras ou problemas matemáticos, o aprendizado por reforço pode incentivar o modelo a explorar diferentes sequências de "pensamento" para aprender quais padrões de raciocínio são mais eficazes na resolução de problemas.
Modelos e regiões compatíveis
Os seguintes modelos do Gemini são compatíveis com o ajuste fino de aprendizado por reforço:
Gemini 3.5 Flash
| Especificação | Valor |
|---|---|
| Endpoints compatíveis para ajuste de modelos |
|
| Endpoints compatíveis para veiculação de modelos ajustados |
|
| Versão da API | Somente no v1beta1 |
Gemini 3.1 Flash-Lite
| Especificação | Valor |
|---|---|
| Endpoints compatíveis para ajuste de modelos |
|
| Endpoints compatíveis para veiculação de modelos ajustados |
|
| Versão da API | Somente no v1beta1 |
Modalidades de ajuste aceitas
O ajuste do aprendizado por reforço é compatível com as seguintes modalidades de dados nos conjuntos de dados de ajuste:
- Texto
- Áudio
- Imagem
- Vídeo (compatível apenas com o Gemini 3.5 Flash)
Para ver os limites de conjunto de dados por modalidade (como número máximo de arquivos por solicitação, tamanho máximo do arquivo e comprimento total máximo), consulte a página Conjunto de dados de ajuste.
Ajuste contínuo
É possível usar a saída de um job de ajuste anterior como base para um novo job de ajuste de detalhes de aprendizado por reforço. Os seguintes padrões de ajuste contínuo são compatíveis:
- Ajuste supervisionado → Ajuste do aprendizado por reforço
- Ajuste do aprendizado por reforço → Ajuste do aprendizado por reforço
Para detalhes da configuração, consulte a página Ajuste contínuo.
Disponibilizar o modelo ajustado
Depois de um job de ajuste fino de aprendizado por reforço bem-sucedido no modelo
de base do Gemini, um modelo ajustado com base no último checkpoint é implantado
em um endpoint no seu projeto. Os modelos ajustados usam a mesma estratégia de endpoint de serviço que o modelo de base. Por exemplo, se você executar um job de ajuste em
us-central1, o modelo ajustado será implantado em um endpoint multirregional us
(mREP).
Para recuperar o endpoint do modelo ajustado implantado e executar a inferência nele, consulte o guia de início rápido do console doCloud de Confiance ou o guia de início rápido da API.
Preços
Preços de ajuste
O ajuste do aprendizado por reforço para o Gemini gera tokens em duas fases: amostragem e treinamento. Os tokens gerados durante a fase de treinamento são cobrados de acordo com a seção "Ajuste de modelo" da página de preços da Gemini Enterprise Agent Platform.
Preços de inferência
Após o ajuste, os custos de inferência (solicitação de previsão) para o modelo ajustado ainda se aplicam. Para inferência de modelo a partir do Gemini 3, o preço de previsão do endpoint do modelo ajustado é 1,5 vez o preço do modelo de base. Para mais informações, consulte Versões de modelo estáveis do Gemini disponíveis.
Se você configurar o serviço de avaliação de IA generativa para ser executado automaticamente durante o ajuste, as avaliações serão cobradas como jobs de previsão em lote. Para mais informações, consulte a seção "Ajuste de modelo" na página de preços da Gemini Enterprise Agent Platform.
A seguir
- Siga o início rápido do consoleCloud de Confiance ou o início rápido da API para criar seu primeiro job de ajuste refinado de aprendizado por reforço.
- Saiba como preparar um conjunto de dados de ajuste e configurar funções de recompensa.
- Saiba como implantar um modelo do Gemini ajustado.