

增強學習是一種強大的技術,可讓大型語言模型 (LLM) 適應使用者定義的獎勵函式,盡可能獲得回饋獎勵。模型會探索許多可能的答案,觀察每個答案的數值獎勵,並逐步調整行為,提高高獎勵答案的出現機率,降低低獎勵答案的出現機率。這種做法非常適合需要多步驟推論、複雜決策或瞭解提示中細微差異的案例。
透過 Gemini 的強化學習微調功能,您可以使用自己的提示和自行定義的獎勵函數,微調 Gemini。您可以運用這項功能,提升 Gemini 模型在您專屬用途和代理工作流程中的推理能力和輸出品質。
運作方式
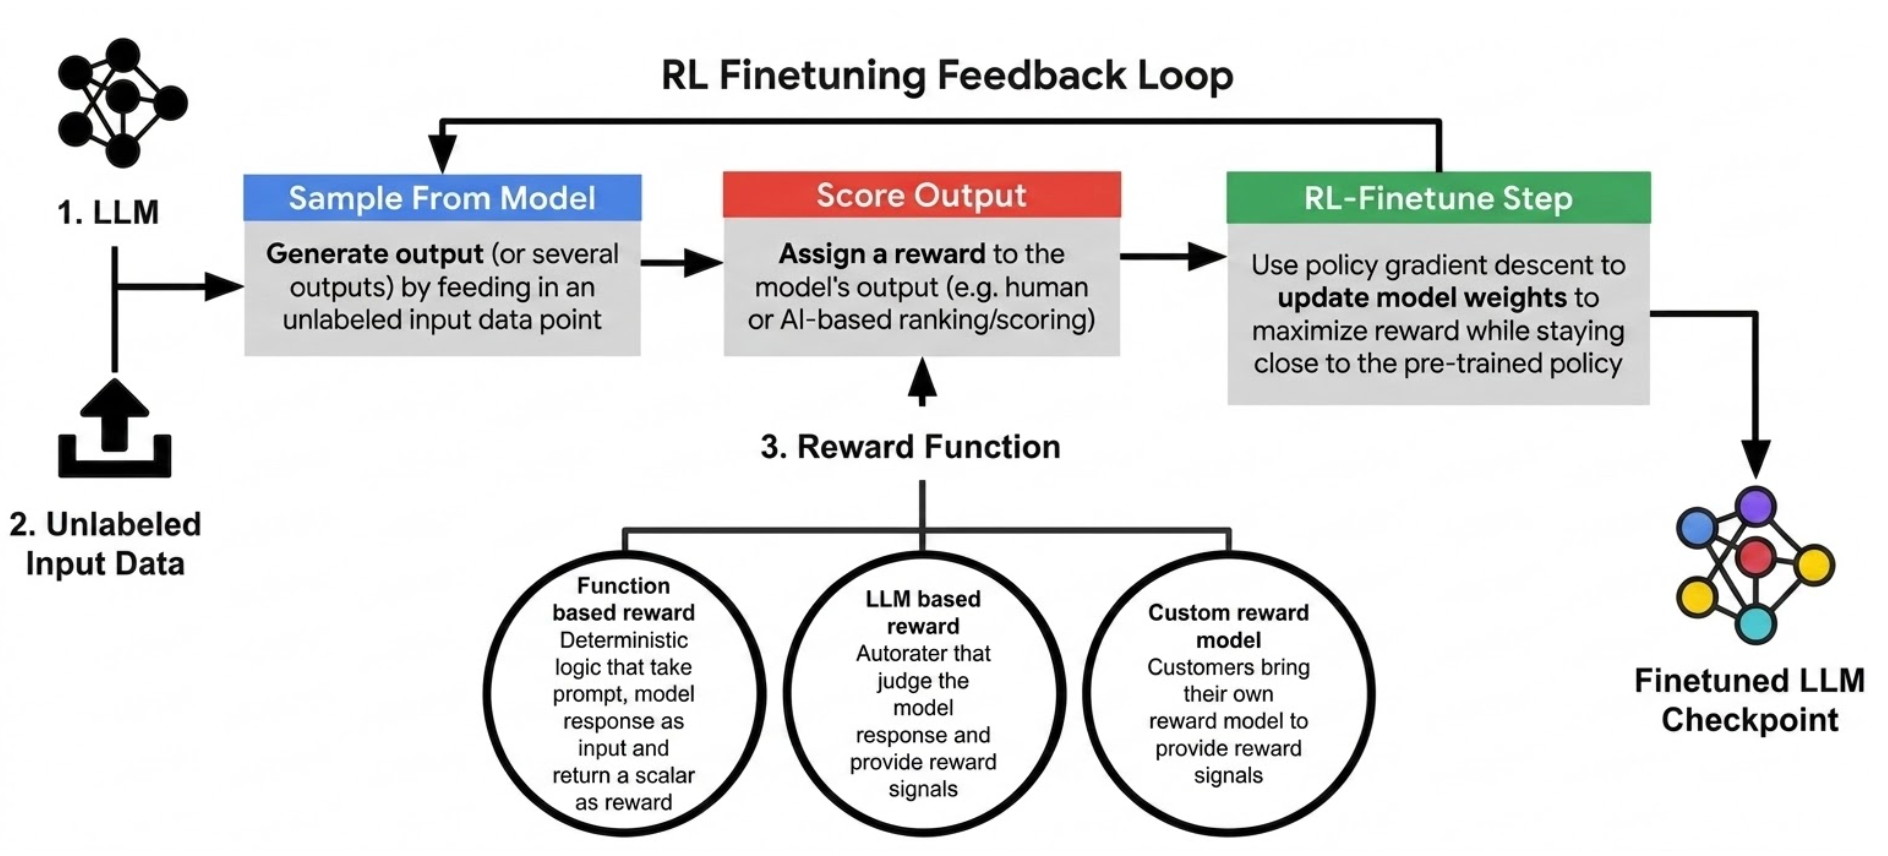
強化學習微調會以疊代方式運作,以改善 LLM 的行為。在每次疊代期間,模型會針對一組提示生成回覆。接著,系統會根據您定義的獎勵函式評估這些回覆,並根據您期望的條件量化生成內容的品質。這項服務會使用這項獎勵信號,透過強化學習演算法更新模型的參數,鼓勵可獲得更高獎勵的行為。透過反覆生成、評估及更新的程序,模型可以學習並適應您的特定用途。
下圖顯示強化學習微調的整體工作流程:
主要功能與特色
可自訂的獎勵函式:定義專屬的獎勵函式,針對各種自訂用途精確進行最佳化,並根據特定目標調整模型行為。如要瞭解支援的獎勵類型,請參閱「獎勵函式」頁面。
適應器可有效率地進行調整:強化學習微調會使用適應器,在重複使用現有服務基礎架構的同時,有效進行調整。
多種思考程度:這項服務支援兩種思考程度的微調:
MINIMAL和HIGH(動態思考),因此您可以選擇最符合模型學習目標和所需回覆生成模式的方法。詳情請參閱「超參數」頁面。持續微調:納入更多訓練範例或週期,進一步微調先前調整過的模型。以現有的微調模型或檢查點做為基礎,可更有效率地進行微調實驗。詳情請參閱「持續調整」頁面。
多模態資料集:支援文字、圖片、影片 (僅限 Gemini 3.5 Flash) 和音訊資料模態。
強化學習微調的使用時機
如果無法透過監督式學習找出最佳策略,建議採用強化學習微調來微調 LLM。包括目標是最佳化特定指標,但沒有現成可用的實際資料標籤的任務;與人類偏好設定一致至關重要 (且有判斷方法) 的任務;以及可透過反覆改良和探索來提升成效的推理密集型任務。
在下列情況下,建議使用強化學習微調:
複雜的指令遵循:模型需要遵循複雜的指令,且「正確」輸出內容並非單一答案,而是需要進行一連串檢查。強化學習可協助模型學習如何處理這些複雜的指令集。
生成創意內容:生成創意寫作、詩歌或高度專業的程式碼等工作,難以定義客觀指標。透過增強學習和設計完善的獎勵函數 (可能涉及人類回饋或專家評估),可以引導模型產生更理想且創新的輸出內容。
推理工作:對於需要大量推理的工作 (例如解決字謎或數學問題),強化學習可激勵模型探索不同的「思考」序列,瞭解哪些推理模式最能有效解決問題。
支援的機型和地區
下列 Gemini 模型支援強化學習微調:
Gemini 3.5 Flash
| 規格 | 值 |
|---|---|
| 支援模型微調的端點 |
|
| 支援的微調模型服務端點 |
|
| API 版本 | 僅限 v1beta1 |
Gemini 3.1 Flash-Lite
| 規格 | 值 |
|---|---|
| 支援模型微調的端點 |
|
| 支援的微調模型服務端點 |
|
| API 版本 | 僅限 v1beta1 |
支援的調整模式
強化學習微調支援微調資料集中的下列資料模態:
- 文字
- 音訊
- 圖片
- 影片 (僅支援 Gemini 3.5 Flash)
如要瞭解各模態的資料集限制 (例如每個提示的檔案數量上限、檔案大小上限和總長度上限),請參閱「微調資料集」頁面。
持續調整
您可以將先前微調工作的輸出內容做為新強化學習微調工作的基礎。系統支援下列連續微調模式:
- 監督式微調 → 強化學習微調
- 強化學習微調 → 強化學習微調
如需設定詳細資料,請參閱「持續調整」頁面。
提供微調後的模型
在基礎 Gemini 模型上成功完成強化學習微調作業後,系統會根據最後一個檢查點,將調整後的模型部署至專案中的端點。微調模型與基礎模型使用相同的服務端點策略。舉例來說,如果您在 us-central1 中執行微調工作,微調後的模型會部署至 us 多地區端點 (mREP)。
如要擷取已部署的微調模型端點,並對其執行推論,請參閱Cloud de Confiance 控制台快速入門導覽課程或 API 快速入門導覽課程。
定價
微調價格
Gemini 的強化學習微調功能會分兩個階段生成權杖:取樣階段和訓練階段。訓練階段產生的權杖會根據 Gemini Enterprise Agent Platform 定價頁面的「模型微調」部分收費。
推論定價
調整後,系統仍會針對調整過的模型收取推論 (預測要求) 費用。從 Gemini 3 開始,微調模型端點的預測價格是基礎模型的 1.5 倍。詳情請參閱「可用的 Gemini 穩定模型版本」。
如果您將 Gen AI Evaluation Service 設為在微調期間自動執行,系統會將評估作業視為批次預測工作收費。詳情請參閱 Gemini Enterprise Agent Platform 定價頁面的「模型微調」一節。
後續步驟
- 請按照Cloud de Confiance 控制台快速入門或 API 快速入門的說明,建立第一個強化學習微調作業。
- 瞭解如何準備微調資料集,以及設定獎勵函式。
- 瞭解如何部署已調整的 Gemini 模型。