

Wenn Sie einen Managed Service for Apache Spark-Job einreichen, erfasst Managed Service for Apache Spark automatisch die Jobausgabe und stellt sie Ihnen zur Verfügung. So können Sie die Jobausgabe schnell prüfen, ohne eine Verbindung zum Cluster aufrechterhalten zu müssen, während Ihre Jobs ausgeführt werden, oder komplizierte Logdateien durchsuchen zu müssen.
Spark-Logs
Es gibt zwei Arten von Spark-Logs: Spark-Treiberlogs und Spark-Executor-Logs.
Spark-Treiberlogs enthalten die Jobausgabe. Spark-Executor-Logs enthalten die Ausgabe der ausführbaren Jobdatei oder des Launchers, z. B. die Meldung spark-submit „Submitted application ...“, und können bei der Fehlerbehebung von Jobfehlern hilfreich sein.
Der Jobtreiber von Managed Service for Apache Spark, der sich vom Spark-Treiber unterscheidet, ist ein Launcher für viele Jobtypen. Beim Starten von Spark-Jobs wird es als Wrapper für die zugrunde liegende ausführbare spark-submit-Datei ausgeführt, die den Spark-Treiber startet. Der Spark-Treiber führt den Job im Managed Service for Apache Spark-Cluster im Spark-Modus client oder cluster aus:
client-Modus: Der Spark-Treiber führt den Job imspark-submit-Prozess aus und Spark-Logs werden an den Jobtreiber von Managed Service for Apache Spark gesendet.cluster-Modus: Der Spark-Treiber führt den Job in einem YARN-Container aus. Spark-Treiberlogs sind für den Jobtreiber von Managed Service for Apache Spark nicht verfügbar.
Übersicht über Managed Service for Apache Spark und Spark-Jobattribute
| Attribut | Wert | Default | Beschreibung |
|---|---|---|---|
dataproc:dataproc.logging.stackdriver.job.driver.enable |
"true" oder "false" | falsch | Muss beim Erstellen des Clusters festgelegt werden. Wenn true, befindet sich die Jobtreiberausgabe in Logging und ist mit der Jobressource verknüpft. Wenn false, befindet sich die Jobtreiberausgabe nicht in Logging.Hinweis: Die folgenden Clusterattributeinstellungen sind ebenfalls erforderlich, um Jobtreiberlogs in Logging zu aktivieren. Sie werden standardmäßig festgelegt, wenn ein Cluster erstellt wird: dataproc:dataproc.logging.stackdriver.enable=true und dataproc:jobs.file-backed-output.enable=true.
|
dataproc:dataproc.logging.stackdriver.job.yarn.container.enable |
"true" oder "false" | falsch | Muss beim Erstellen des Clusters festgelegt werden.
Wenn true, werden die YARN-Containerlogs des Jobs mit der Jobressource verknüpft. Wenn false, werden die YARN-Containerlogs des Jobs mit der Clusterressource verknüpft. |
spark:spark.submit.deployMode |
Client oder Cluster | Client | Steuert den Spark-Modus client oder cluster. |
Spark-Jobs, die über die Managed Service for Apache Spark jobs API gesendet wurden
In den Tabellen in diesem Abschnitt wird die Auswirkung verschiedener Attributeinstellungen auf das Ziel der Managed Service for Apache Spark-Jobtreiberausgabe aufgeführt, wenn Jobs über die Managed Service for Apache Spark jobs API gesendet werden. Dazu gehört auch das Senden von Jobs über dieCloud de Confiance Console, die gcloud CLI und die Cloud-Clientbibliotheken.
Die aufgeführten Managed Service for Apache Spark- und Spark-Attribute können beim Erstellen eines Clusters mit dem Flag --properties festgelegt werden und gelten für alle Spark-Jobs, die auf dem Cluster ausgeführt werden. Spark-Attribute können auch mit dem Flag --properties (ohne das Präfix „spark:“) festgelegt werden, wenn ein Job an die Managed Service for Apache Spark-jobs-API gesendet wird, und gelten nur für den Job.
Ausgabe des Managed Service for Apache Spark-Jobtreibers
In den folgenden Tabellen sind die Auswirkungen verschiedener Attributeinstellungen auf das Ziel der Ausgabe des Managed Service for Apache Spark-Jobtreibers aufgeführt.
dataproc: |
Ausgabe |
|---|---|
| false (Standardeinstellung) |
|
| wahr |
|
Spark-Treiberlogs
In den folgenden Tabellen sind die Auswirkungen verschiedener Attributeinstellungen auf das Ziel von Spark-Treiberlogs aufgeführt.
spark: |
dataproc: |
dataproc: |
Treiber-Ausgabe |
|---|---|---|---|
| Client | false (Standardeinstellung) | "true" oder "false" |
|
| Client | wahr | "true" oder "false" |
|
| Cluster | false (Standardeinstellung) | falsch |
|
| Cluster | wahr | wahr |
|
Spark-Executor-Logs
In den folgenden Tabellen sind die Auswirkungen verschiedener Attributeinstellungen auf das Ziel von Spark-Executor-Logs aufgeführt.
dataproc: |
Executor-Log |
|---|---|
| false (Standardeinstellung) | In Logging: yarn-userlogs unter der Clusterressource |
| wahr | In Logging dataproc.job.yarn.container unter der Jobressource |
Spark-Jobs, die ohne die Managed Service for Apache Spark jobs API gesendet wurden
In diesem Abschnitt werden die Auswirkungen verschiedener Attributeinstellungen auf das Ziel von Spark-Joblogs aufgeführt, wenn Jobs ohne die Managed Service for Apache Spark jobs API gesendet werden, z. B. wenn ein Job direkt auf einem Clusterknoten mit spark-submit oder mit einem Jupyter- oder Zeppelin-Notebook gesendet wird. Diese Jobs haben keine Managed Service for Apache Spark-Job-IDs oder ‑Treiber.
Spark-Treiberlogs
In den folgenden Tabellen wird die Auswirkung verschiedener Attributeinstellungen auf das Ziel von Spark-Treiberlogs für Jobs aufgeführt, die nicht über die Managed Service for Apache Spark jobs API gesendet wurden.
spark: |
Treiber-Ausgabe |
|---|---|
| Client |
|
| Cluster |
|
Spark-Executor-Logs
Wenn Spark-Jobs nicht über die Managed Service for Apache Spark jobs API gesendet werden, befinden sich die Executor-Logs in Logging yarn-userlogs unter der Clusterressource.
Jobausgabe ansehen
Sie können auf die Ausgabe von Managed Service for Apache Spark-Jobs in der Cloud de Confiance Console, der gcloud CLI, Cloud Storage oder Logging zugreifen.
Console
Wenn Sie die Jobausgabe aufrufen möchten, rufen Sie in Ihrem Projekt den Bereich Jobs von Managed Service for Apache Spark auf und klicken Sie dann auf die Job-ID.
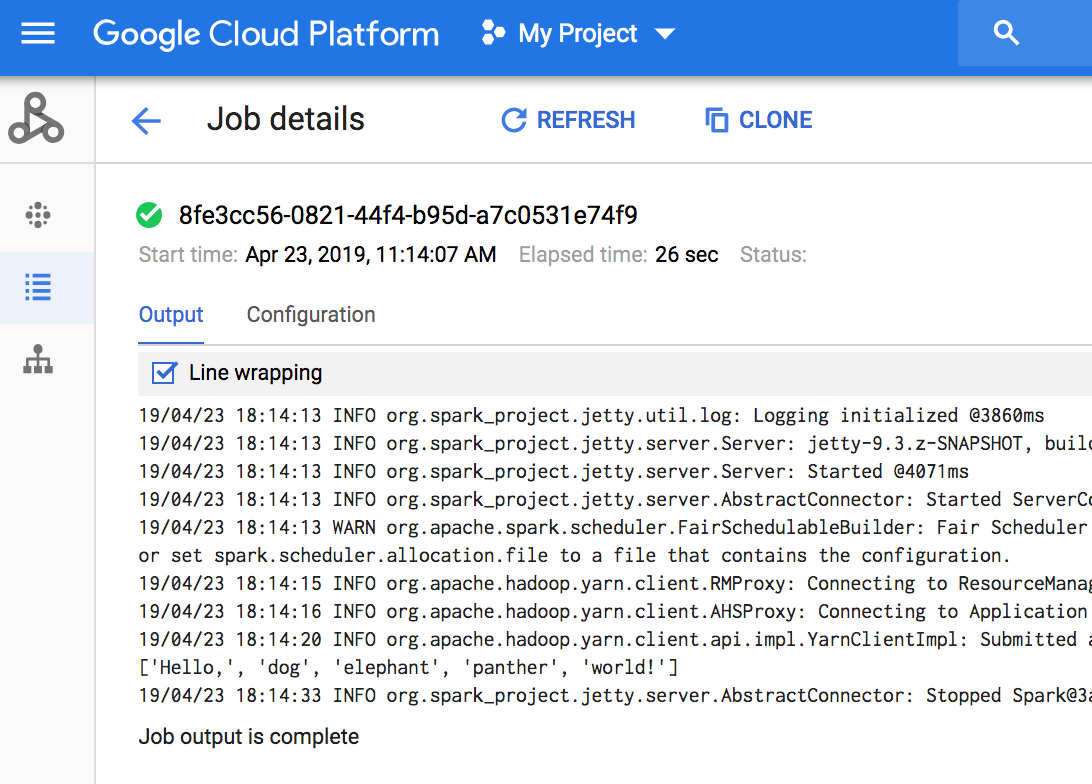
Wenn der Job ausgeführt wird, wird die Jobausgabe regelmäßig mit neuen Inhalten aktualisiert.
gcloud-Befehl
Wenn Sie einen Job mit dem Befehl gcloud dataproc jobs submit senden, wird die Jobausgabe in der Console angezeigt. Sie können die Ausgabe zu einem späteren Zeitpunkt, auf einem anderen Computer oder in einem neuen Fenster wieder aufrufen, indem Sie die Job-ID an den Befehl gcloud dataproc jobs wait übergeben. Die Job-ID ist eine GUID wie z. B. 5c1754a5-34f7-4553-b667-8a1199cb9cab . Hier ein Beispiel:
gcloud dataproc jobs wait 5c1754a5-34f7-4553-b667-8a1199cb9cab \
    --project my-project-id --region my-cluster-region
Waiting for job output...
... INFO gcs.GoogleHadoopFileSystemBase: GHFS version: 1.4.2-hadoop2
... 16:47:45 INFO client.RMProxy: Connecting to ResourceManager at my-test-cluster-m/
...
Cloud Storage
Die Jobausgabe wird in Cloud Storage entweder im Staging-Bucket oder im Bucket gespeichert, den Sie beim Erstellen des Clusters angegeben haben. Ein Link zur Jobausgabe in Cloud Storage wird im Feld Job.driverOutputResourceUri bereitgestellt, das von folgenden Elementen zurückgegeben wird:
- Eine API-Anfrage des Typs jobs.get
- den Befehl gcloud dataproc jobs describe job-id.
$ gcloud dataproc jobs describe spark-pi
...
driverOutputResourceUri: gs://dataproc-nnn/jobs/spark-pi/driveroutput
...