

Job- und Clusterlogs von Managed Service for Apache Spark können in Cloud Logging aufgerufen, durchsucht, gefiltert und archiviert werden.
Informationen zu den Kosten finden Sie unter Google Cloud Observability – Preise.
Unter Aufbewahrungsdauer von Logs finden Sie Informationen zur Logging-Aufbewahrung.
Unter Logausschlüsse finden Sie Informationen zum Deaktivieren aller Logs oder Ausschließen von Logs vom Logging.
Unter Übersicht: Routing und Speicher erfahren Sie, wie Sie Logs von Logging an Cloud Storage, BigQuery oder Pub/Sub weiterleiten.
Logging-Ebenen für Komponenten
Legen Sie die Logging-Ebenen für Spark, Hadoop, Flink und andere Managed Service for Apache Spark-Komponenten mit komponentenspezifischen Cluster-Properties für log4j fest, z. B. hadoop-log4j, wenn Sie einen Cluster erstellen. Clusterbasierte Komponenten-Logging-Ebenen gelten für Dienst-Daemons wie den YARN ResourceManager und für Jobs, die im Cluster ausgeführt werden.
Wenn log4j-Attribute für eine Komponente wie die Presto-Komponente nicht unterstützt werden, schreiben Sie eine Initialisierungsaktion, die die Datei log4j.properties oder log4j2.properties der Komponente bearbeitet.
Jobspezifische Komponenten-Logging-Ebenen: Sie können Komponenten-Logging-Ebenen auch festlegen, wenn Sie einen Job einreichen. Diese Logging-Ebenen werden auf den Job angewendet und haben Vorrang vor den Logging-Ebenen, die Sie beim Erstellen des Clusters festgelegt haben. Weitere Informationen finden Sie unter Cluster- und Jobattribute.
Logging-Ebenen für Spark- und Hive-Komponentenversionen:
Die Komponenten Spark 3.3.X und Hive 3.X verwenden log4j2-Attribute, während frühere Versionen dieser Komponenten log4j-Attribute verwenden (siehe Apache Log4j2).
Verwenden Sie das Präfix spark-log4j:, um Spark-Logging-Ebenen für einen Cluster festzulegen.
Beispiel: Managed Service for Apache Spark-Image-Version 2.0 mit Spark 3.1 zum Festlegen von
log4j.logger.org.apache.spark:gcloud dataproc clusters create ... \ --properties spark-log4j:log4j.logger.org.apache.spark=DEBUG
Beispiel: Managed Service for Apache Spark-Image-Version 2.1 mit Spark 3.3 zum Festlegen von
logger.sparkRoot.level:gcloud dataproc clusters create ...\ --properties spark-log4j:logger.sparkRoot.level=debug
Logging-Ebenen für Jobtreiber
Managed Service for Apache Spark verwendet für Jobtreiberprogramme die Standard-Logging-Ebene INFO. Sie können diese Einstellung für ein oder mehrere Pakete mit dem Flag --driver-log-levels von gcloud dataproc jobs submit ändern.
Beispiel:
Legen Sie die Logging-Ebene DEBUG fest, wenn Sie einen Spark-Job senden, der Cloud Storage-Dateien liest.
gcloud dataproc jobs submit spark ...\
    --driver-log-levels org.apache.spark=DEBUG,com.google.cloud.hadoop.gcsio=DEBUG
Beispiel:
Legen Sie die Logger-Ebene root auf WARN und die Logger-Ebene com.example auf INFO fest.
gcloud dataproc jobs submit hadoop ...\
    --driver-log-levels root=WARN,com.example=INFO
Logging-Stufen für Spark-Executors
So konfigurieren Sie die Logging-Ebenen für Spark-Executors:
Bereiten Sie eine log4j-Konfigurationsdatei vor und laden Sie sie in Cloud Storage hoch.
Verweisen Sie beim Senden des Jobs auf Ihre Konfigurationsdatei.
Beispiel:
gcloud dataproc jobs submit spark ...\
    --file gs://my-bucket/path/spark-log4j.properties \
    --properties spark.executor.extraJavaOptions=-Dlog4j.configuration=file:spark-log4j.properties
Spark lädt die Cloud Storage-Attributdatei in das lokale Arbeitsverzeichnis des Jobs herunter, auf das in -Dlog4j.configuration als file:<name> verwiesen wird.
Managed Service for Apache Spark-Joblogs in Logging
Informationen zum Aktivieren von Managed Service for Apache Spark-Jobtreiberlogs in Logging finden Sie unter Managed Service for Apache Spark-Jobausgabe und ‑Logs.
Auf Joblogs in Logging zugreifen
Sie können über den Log-Explorer, den Befehl gcloud logging oder die Logging API auf die Joblogs von Managed Service for Apache Spark zugreifen.
Console
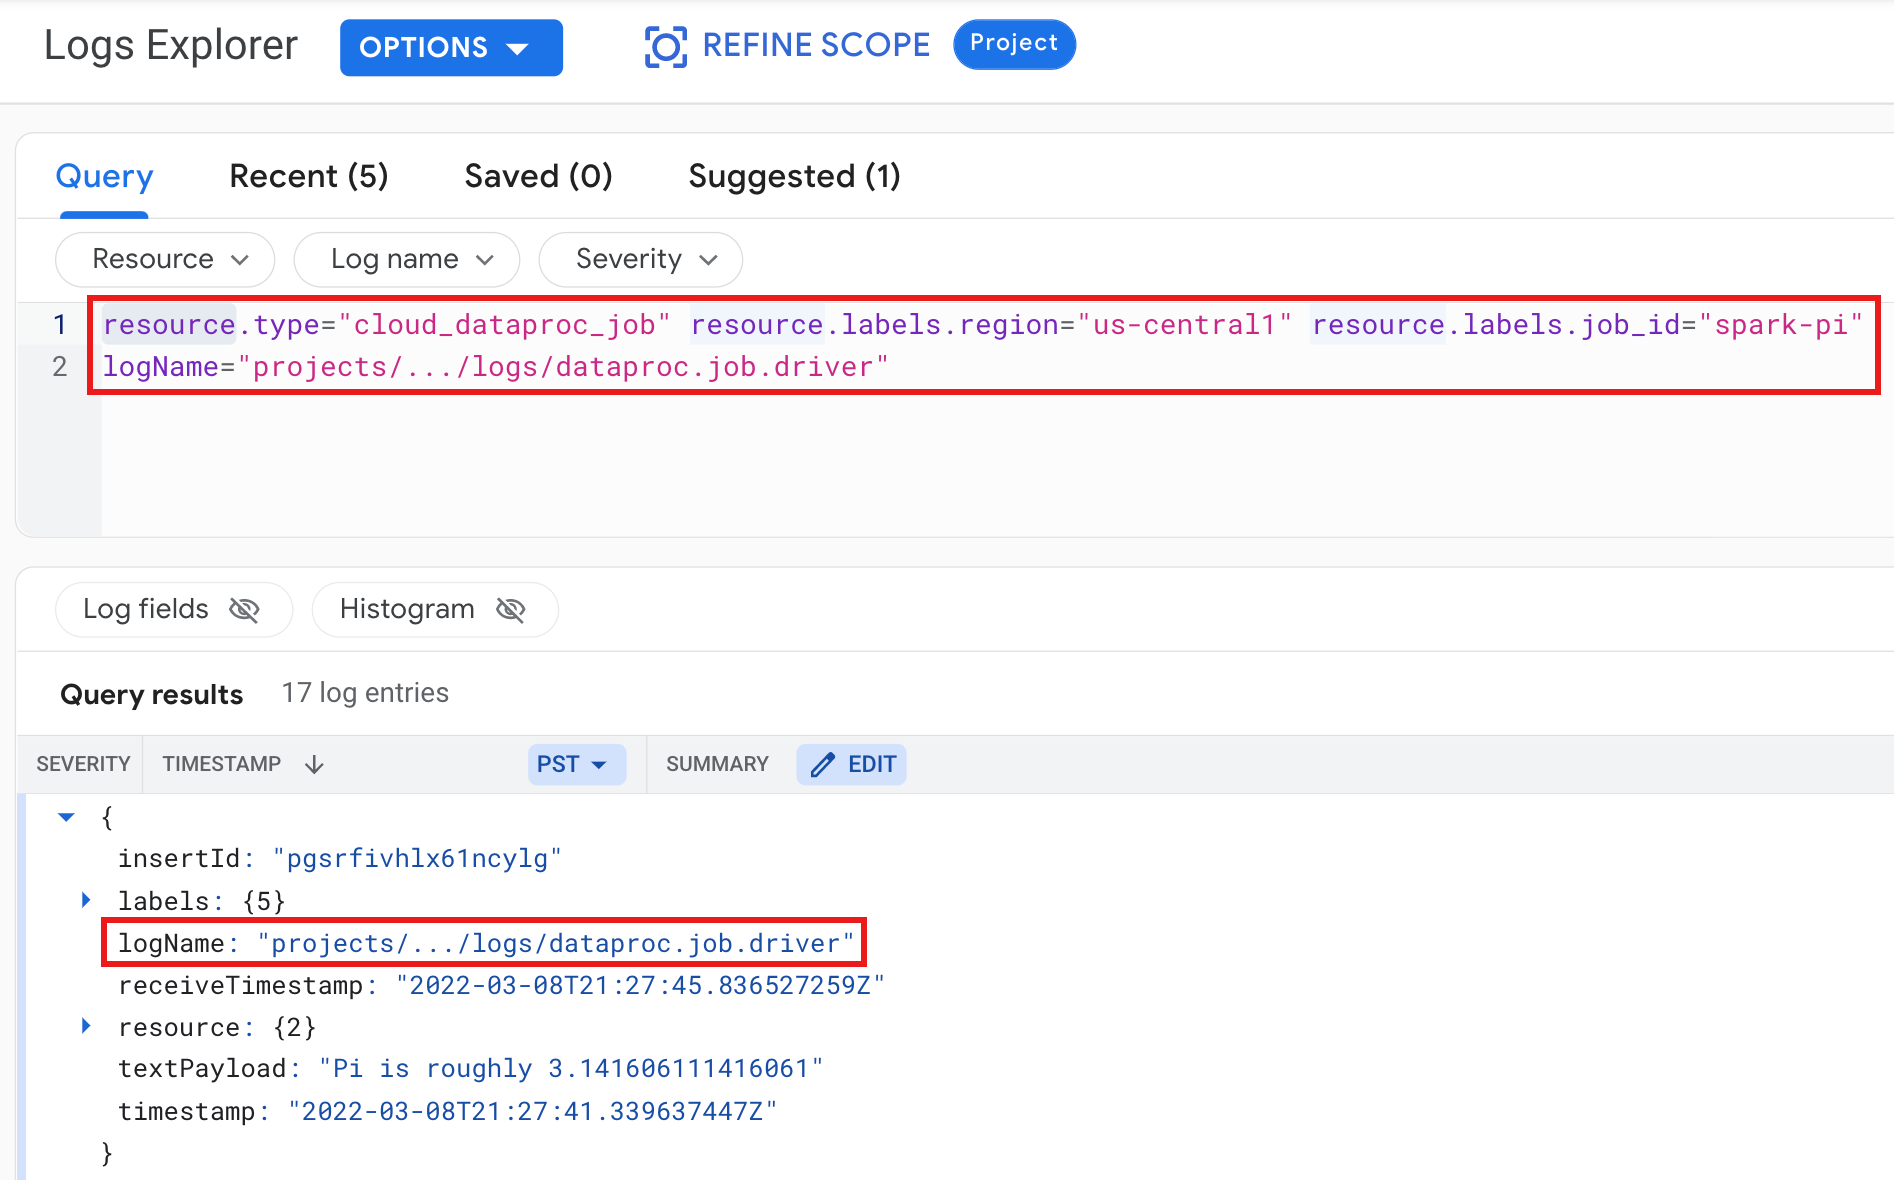
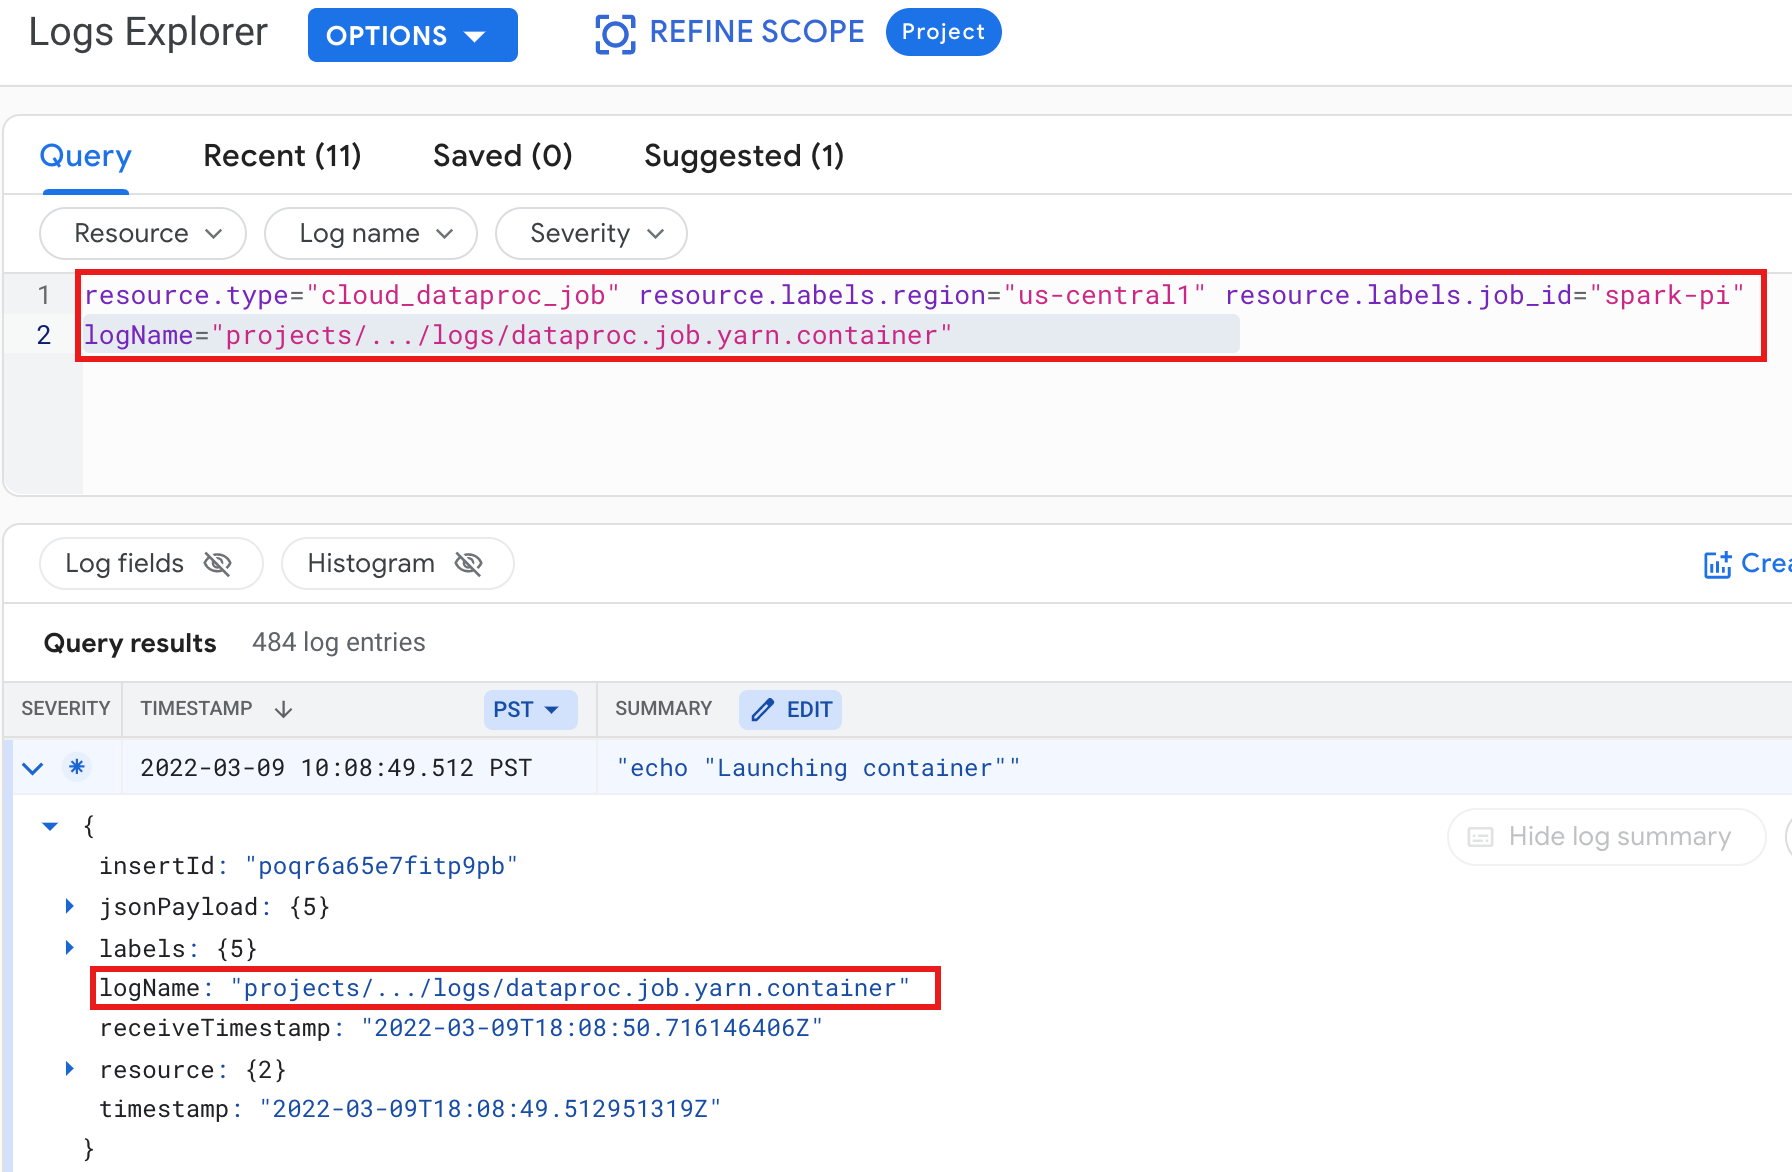
Logs für Managed Service for Apache Spark-Jobtreiber und YARN-Container werden unter der Ressource Cloud Managed Service for Apache Spark-Job aufgeführt.
Beispiel: Jobtreiber-Log nach dem Ausführen einer Log-Explorer-Abfrage mit den folgenden Auswahlen:
- Ressource:
Cloud Dataproc Job - Log name:
dataproc.job.driver
Beispiel: YARN-Container-Log nach dem Ausführen einer Log-Explorer-Abfrage mit den folgenden Auswahlen:
- Ressource:
Cloud Dataproc Job - Log name:
dataproc.job.yarn.container
gcloud
Sie können Joblogeinträge mit dem Befehl gcloud logging read lesen. Die Ressourcenargumente müssen in Anführungszeichen gesetzt werden („...”). Mit dem folgenden Befehl werden Clusterlabels verwendet, um die zurückgegebenen Logeinträge zu filtern.
gcloud logging read \
    "resource.type=cloud_dataproc_job \
    resource.labels.region=cluster-region \
    resource.labels.job_id=my-job-id"
Beispielausgabe (unvollständig):
jsonPayload:
  class: org.apache.hadoop.hdfs.StateChange
  filename: hadoop-hdfs-namenode-test-dataproc-resize-cluster-20190410-38an-m-0.log
  ,,,
logName: projects/project-id/logs/hadoop-hdfs-namenode
---
jsonPayload:
  class: SecurityLogger.org.apache.hadoop.security.authorize.ServiceAuthorizationManager
  filename: cluster-name-dataproc-resize-cluster-20190410-38an-m-0.log
  ...
logName: projects/google.com:hadoop-cloud-dev/logs/hadoop-hdfs-namenode
REST API
Sie können mit der Logging REST API Logeinträge auflisten (siehe entries.list).
Managed Service for Apache Spark-Clusterlogs in Logging
Managed Service for Apache Spark exportiert die folgenden Apache Hadoop-, Spark-, Hive-, Zookeeper- und anderen Managed Service for Apache Spark-Clusterlogs nach Cloud Logging.
| Logtyp | Logname | Beschreibung | Hinweise |
|---|---|---|---|
| Master-Daemon-Logs | hadoop-hdfs hadoop-hdfs-namenode hadoop-hdfs-secondarynamenode hadoop-hdfs-zkfc hadoop-yarn-resourcemanager hadoop-yarn-timelineserver hive-metastore hive-server2 hadoop-mapred-historyserver zookeeper |
Journal-Knoten HDFS-NameNode Sekundärer HDFS-NameNode Zookeeper-Failover-Controller YARN-Ressourcenmanager YARN-Zeitachsenserver Hive-Metastore Hive-Server2 MapReduce-Jobverlaufsserver Zookeeper-Server |
|
| Worker-Daemon-Logs |
hadoop-hdfs-datanode hadoop-yarn-nodemanager |
HDFS DataNode YARN NodeManager |
|
| Systemprotokolle |
autoscaler google.dataproc.agent google.dataproc.startup |
Managed Service for Apache Spark-Autoscaling-Log Managed Service for Apache Spark-Agent-Log Managed Service for Apache Spark-Startskript-Log + Log für Initialisierungsaktionen |
|
| Erweiterte (zusätzliche) Logs |
knox gateway-audit zeppelin ranger-usersync jupyter_notebook jupyter_kernel_gateway spark-history-server |
Alle Logs in /var/log/-Unterverzeichnissen, die Folgendem entsprechen:knox (einschließlich gateway-audit.log) zeppelin ranger-usersync jupyter_notebook jupyter_kernel_gateway spark-history-server |
Wenn Sie das Attribut
dataproc:dataproc.logging.extended.enabled=false festlegen, wird die Erfassung erweiterter Logs im Cluster deaktiviert.
|
| VM-Syslogs |
syslog |
Syslogs von den Master- und Worker-Knoten des Clusters |
Wenn Sie das Attribut
dataproc:dataproc.logging.syslog.enabled=false festlegen, wird die Erfassung von VM-Syslogs im Cluster deaktiviert.
|
Auf Clusterlogs in Cloud Logging zugreifen
Sie können auf die Logs von Managed Service for Apache Spark-Clustern über den Log-Explorer, den Befehl gcloud logging oder die Logging API zugreifen.
Console
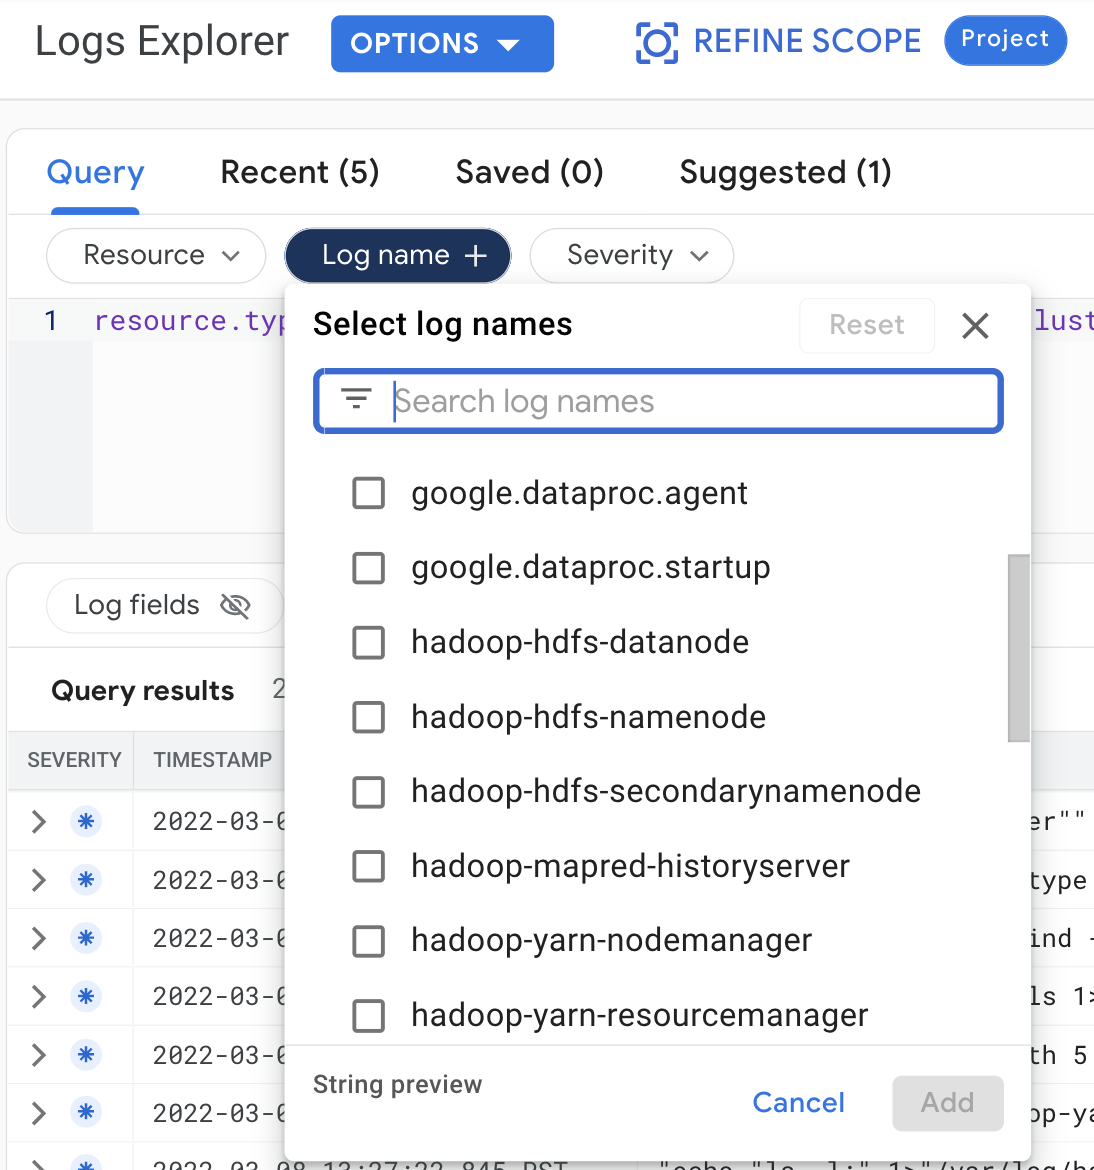
Treffen Sie die folgende Abfrageauswahl, um Clusterlogs im Log-Explorer aufzurufen:
- Ressource:
Cloud Dataproc Cluster - Log name: log name
gcloud
Sie können Cluster-Logeinträge mit dem Befehl gcloud logging read lesen. Die Ressourcenargumente müssen in Anführungszeichen gesetzt werden („...”). Mit dem folgenden Befehl werden Clusterlabels verwendet, um die zurückgegebenen Logeinträge zu filtern.
gcloud logging read <<'EOF'
    "resource.type=cloud_dataproc_cluster
    resource.labels.region=cluster-region
    resource.labels.cluster_name=cluster-name
    resource.labels.cluster_uuid=cluster-uuid"
EOF
Beispielausgabe (unvollständig):
jsonPayload:
  class: org.apache.hadoop.yarn.server.resourcemanager.ResourceTrackerService
  filename: hadoop-yarn-resourcemanager-cluster-name-m.log
  ...
logName: projects/project-id/logs/hadoop-yarn-resourcemanager
---
jsonPayload:
  class: org.apache.hadoop.yarn.server.resourcemanager.ResourceTrackerService
  filename: hadoop-yarn-resourcemanager-component-gateway-cluster-m.log
  ...
logName: projects/project-id/logs/hadoop-yarn-resourcemanager
REST API
Sie können mit der Logging REST API Logeinträge auflisten (siehe entries.list).
Berechtigungen
Damit Logs in Logging geschrieben werden können, muss das VM-Dienstkonto von Managed Service for Apache Spark die IAM-Rolle logging.logWriter haben. Das Standarddienstkonto für Managed Service for Apache Spark hat diese Rolle. Wenn Sie ein benutzerdefiniertes Dienstkonto verwenden, müssen Sie dem Dienstkonto diese Rolle zuweisen.
Logs schützen
Standardmäßig werden Logs in Logging im Ruhezustand verschlüsselt. Sie können kundenverwaltete Verschlüsselungsschlüssel (CMEK) aktivieren, um die Logs zu verschlüsseln. Weitere Informationen zur CMEK-Unterstützung finden Sie unter Schlüssel verwalten, die Log Router-Daten schützen und Schlüssel verwalten, die Logging-Speicherdaten schützen.
Nächste Schritte
- Google Cloud Observability entdecken.