

Eine Managed Service for Apache Spark-NodeGroup-Ressource ist eine Gruppe von Managed Service for Apache Spark-Clusterknoten, die eine zugewiesene Rolle ausführen. Auf dieser Seite wird die Treiberknotengruppe beschrieben. Dies ist eine Gruppe von Compute Engine-VMs, denen die Rolle Driver zugewiesen ist, um Jobtreiber im Managed Service for Apache Spark-Cluster auszuführen.
Wann sollten Treiberknotengruppen verwendet werden?
- Verwenden Sie Treiberknotengruppen nur, wenn Sie viele gleichzeitige Jobs in einem freigegebenen Cluster ausführen müssen.
- Erhöhen Sie die Ressourcen des Masterknotens, bevor Sie Treiberknotengruppen verwenden, um Einschränkungen für Treiberknotengruppen zu vermeiden.
Wie Treiberknoten Ihnen helfen, gleichzeitige Jobs auszuführen
Managed Service for Apache Spark startet für jeden Job einen Jobtreiberprozess auf einem Clustermaster des Managed Service for Apache Spark-Clusters. Der Treiberprozess wiederum führt einen Anwendungstreiber wie spark-submit als untergeordneten Prozess aus.
Die Anzahl der gleichzeitigen Jobs, die auf dem Master ausgeführt werden, ist jedoch durch die auf dem Masterknoten verfügbaren Ressourcen begrenzt. Da die Masterknoten von Managed Service for Apache Spark nicht skaliert werden können, kann ein Job fehlschlagen oder gedrosselt werden, wenn die Ressourcen des Masterknotens nicht ausreichen, um einen Job auszuführen.
Treiberknotengruppen sind spezielle Knotengruppen, die von YARN verwaltet werden. Daher wird die Job-Nebenläufigkeit nicht durch die Ressourcen des Masterknotens eingeschränkt. In Clustern mit einer Treiberknotengruppe werden Anwendungstreiber auf Treiberknoten ausgeführt. Auf jedem Treiberknoten können mehrere Anwendungstreiber ausgeführt werden, wenn der Knoten über genügend Ressourcen verfügt.
Vorteile
Wenn Sie einen Managed Service for Apache Spark-Cluster mit einer Treiberknotengruppe verwenden, können Sie:
- Jobtreiberressourcen horizontal skalieren, um mehr gleichzeitige Jobs auszuführen
- Treiberressourcen separat von Worker-Ressourcen skalieren
- Schnelleres Herunterskalieren auf Managed Service for Apache Spark 2.0+- und späteren Image-Clustern. In diesen Clustern wird der App-Master in einem Spark-Treiber in einer Treiberknotengruppe ausgeführt.
spark.yarn.unmanagedAM.enabledist standardmäßig auftruefestgelegt. - Start des Treiberknotens anpassen Sie können
{ROLE} == 'Driver'in einem Initialisierungsskript hinzufügen, damit das Skript Aktionen für eine Treiberknotengruppe in der Knotenauswahl ausführt.
Beschränkungen
- Knotengruppen werden in Managed Service for Apache Spark-Workflowvorlagen nicht unterstützt.
- Knotengruppencluster können nicht beendet, neu gestartet oder automatisch skaliert werden.
- Der MapReduce-App-Master wird auf Worker-Knoten ausgeführt. Das Herunterskalieren von Worker-Knoten kann langsam sein, wenn Sie die ordnungsgemäße Außerbetriebnahme aktivieren.
- Die Nebenläufigkeit von Jobs wird durch die Cluster-Property
dataproc:agent.process.threads.job.maxbeeinflusst. Wenn Sie beispielsweise drei Master haben und dieses Attribut auf den Standardwert100festgelegt ist, beträgt die maximale Job-Nebenläufigkeit auf Clusterebene300.
Treiberknotengruppe im Vergleich zum Spark-Clustermodus
| Funktion | Spark-Clustermodus | Treiberknotengruppe |
|---|---|---|
| Worker-Knoten herunterskalieren | Langlebige Treiber werden auf denselben Worker-Knoten wie kurzlebige Container ausgeführt. Dadurch wird das Herunterskalieren von Workern mit ordnungsgemäßer Außerbetriebnahme verlangsamt. | Worker-Knoten werden schneller herunterskaliert, wenn Treiber auf Knotengruppen ausgeführt werden. |
| Gestreamte Treiberausgabe | Erfordert die Suche in YARN-Logs, um den Knoten zu finden, auf dem der Treiber geplant wurde. | Die Treiberausgabe wird an Cloud Storage gestreamt und kann nach Abschluss eines Jobs in der Cloud de Confiance Console und in der Ausgabe des Befehls gcloud dataproc jobs wait aufgerufen werden. |
IAM-Berechtigungen für die Treiberknotengruppe
Die folgenden IAM-Berechtigungen sind mit den Aktionen für die Knotengruppe von Managed Service for Apache Spark verknüpft.
| Berechtigung | Aktion |
|---|---|
dataproc.nodeGroups.create
|
Managed Service for Apache Spark-Knotengruppen erstellen. Wenn ein Nutzer dataproc.clusters.create im Projekt hat, wird diese Berechtigung gewährt. |
dataproc.nodeGroups.get |
Details zu einer Knotengruppe von Managed Service for Apache Spark abrufen. |
dataproc.nodeGroups.update |
Größe einer Managed Service for Apache Spark-Knotengruppe anpassen |
Vorgänge für Treiberknotengruppen
Mit der gcloud CLI und der Managed Service for Apache Spark API können Sie eine Managed Service for Apache Spark-Treiberknotengruppe erstellen, abrufen, in der Größe anpassen, löschen und einen Job an sie senden.
Cluster mit Treiberknotengruppe erstellen
Eine Treiberknotengruppe ist mit einem Managed Service for Apache Spark-Cluster verknüpft. Sie erstellen eine Knotengruppe im Rahmen der Erstellung eines Managed Service for Apache Spark-Clusters. Sie können die gcloud CLI oder die Managed Service for Apache Spark REST API verwenden, um einen Managed Service for Apache Spark-Cluster mit einer Treiberknotengruppe zu erstellen.
gcloud
gcloud dataproc clusters create CLUSTER_NAME \
    --region=REGION \
    --driver-pool-size=SIZE \
    --driver-pool-id=NODE_GROUP_ID
Erforderliche Flags:
- CLUSTER_NAME: Der Clustername, der innerhalb eines Projekts eindeutig sein muss. Der Name muss mit einem Kleinbuchstaben beginnen und darf bis zu 51 Kleinbuchstaben, Ziffern und Bindestriche enthalten. Es darf nicht mit einem Bindestrich enden. Der Name eines gelöschten Clusters kann wiederverwendet werden.
- REGION: Die Region, in der sich der Cluster befindet.
- SIZE: Die Anzahl der Treiberknoten in der Knotengruppe. Die Anzahl der erforderlichen Knoten hängt von der Joblast und dem Maschinentyp des Treiberpools ab. Die Mindestanzahl der Treibergruppenknoten entspricht dem Gesamtarbeitsspeicher oder den vCPUs, die von Jobtreibern benötigt werden, geteilt durch den Arbeitsspeicher oder die vCPUs der Maschine des jeweiligen Treiberpools.
- NODE_GROUP_ID: Optional und empfohlen. Die ID muss innerhalb des Clusters eindeutig sein. Verwenden Sie diese ID, um die Treibergruppe bei zukünftigen Vorgängen zu identifizieren, z. B. beim Ändern der Größe der Knotengruppe. Wenn nicht angegeben, generiert Managed Service for Apache Spark die Knotengruppen-ID.
Empfohlenes Flag:
--enable-component-gateway: Fügen Sie dieses Flag hinzu, um das Managed Service for Apache Spark Component Gateway zu aktivieren, das Zugriff auf die YARN-Weboberfläche bietet. Auf den Seiten „Application“ und „Scheduler“ der YARN-Benutzeroberfläche werden der Cluster- und Jobstatus, der Speicher der Anwendungswarteschlange, die Kernkapazität und andere Messwerte angezeigt.
Zusätzliche Flags: Die folgenden optionalen driver-pool-Flags können dem Befehl gcloud dataproc clusters create hinzugefügt werden, um die Knotengruppe anzupassen.
| Flag | Standardwert |
|---|---|
--driver-pool-id |
Eine String-ID, die vom Dienst generiert wird, wenn sie nicht durch das Flag festgelegt wurde. Mit dieser ID kann die Knotengruppe bei zukünftigen Knotenpoolvorgängen identifiziert werden, z. B. beim Ändern der Größe der Knotengruppe. |
--driver-pool-machine-type |
n1-standard-4 |
--driver-pool-accelerator |
Kein Standardeinstellung Wenn Sie einen Beschleuniger angeben, ist der GPU-Typ erforderlich. Die Anzahl der GPUs ist optional. |
--num-driver-pool-local-ssds |
Kein Standard |
--driver-pool-local-ssd-interface |
Kein Standard |
--driver-pool-boot-disk-type |
pd-standard |
--driver-pool-boot-disk-size |
1000 GB |
--driver-pool-min-cpu-platform |
AUTOMATIC |
REST
Füllen Sie eine AuxiliaryNodeGroup als Teil einer Managed Service for Apache Spark API-Anfrage vom Typ cluster.create aus.
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: erforderlich. Google Cloud-Projekt-ID
- REGION: erforderlich. Region des Dataproc-Clusters.
- CLUSTER_NAME: erforderlich. Der Clustername, der innerhalb eines Projekts eindeutig sein muss. Der Name muss mit einem Kleinbuchstaben beginnen und kann bis zu 51 Kleinbuchstaben, Ziffern und Bindestriche enthalten. Sie darf nicht mit einem Bindestrich enden. Der Name eines gelöschten Clusters kann wiederverwendet werden.
- SIZE: erforderlich. Anzahl der Knoten in der Knotengruppe.
- NODE_GROUP_ID: Optional und empfohlen. Die ID muss innerhalb des Clusters eindeutig sein. Verwenden Sie diese ID, um die Treibergruppe in zukünftigen Vorgängen zu identifizieren, z. B. beim Ändern der Größe der Knotengruppe. Wenn nicht angegeben, generiert Managed Service for Apache Spark die Knotengruppen-ID.
Zusätzliche Optionen: Weitere Informationen finden Sie unter NodeGroup.
HTTP-Methode und URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters
JSON-Text anfordern:
{
  "clusterName":"CLUSTER_NAME",
  "config": {
    "softwareConfig": {
      "imageVersion":""
    },
    "endpointConfig": {
      "enableHttpPortAccess": true
    },
    "auxiliaryNodeGroups": [{
        "nodeGroup":{
            "roles":["DRIVER"],
            "nodeGroupConfig": {
                "numInstances": SIZE
             }
         },
        "nodeGroupId": "NODE_GROUP_ID"
    }]
  }
}
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten eine JSON-Antwort ähnlich wie diese erhalten:
{
  "projectId": "PROJECT_ID",
  "clusterName": "CLUSTER_NAME",
  "config": {
    ...
    "auxiliaryNodeGroups": [
      {
        "nodeGroup": {
"name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
          "roles": [
            "DRIVER"
          ],
          "nodeGroupConfig": {
            "numInstances": SIZE,
            "instanceNames": [
              "CLUSTER_NAME-np-q1gp",
              "CLUSTER_NAME-np-xfc0"
            ],
            "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
            "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
            "diskConfig": {
              "bootDiskSizeGb": 1000,
              "bootDiskType": "pd-standard"
            },
            "managedGroupConfig": {
              "instanceTemplateName": "dataproc-2a8224d2-...",
              "instanceGroupManagerName": "dataproc-2a8224d2-..."
            },
            "minCpuPlatform": "AUTOMATIC",
            "preemptibility": "NON_PREEMPTIBLE"
          }
        },
        "nodeGroupId": "NODE_GROUP_ID"
      }
    ]
  },
}
Clustermetadaten der Treiberknotengruppe abrufen
Sie können den Befehl gcloud dataproc node-groups describe oder die Managed Service for Apache Spark API verwenden, um Metadaten zur Treiberknotengruppe abzurufen.
gcloud
gcloud dataproc node-groups describe NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION
Erforderliche Flags:
- NODE_GROUP_ID: Sie können
gcloud dataproc clusters
describe CLUSTER_NAME
ausführen, um die Knotengruppen-ID aufzulisten. - CLUSTER_NAME: Der Clustername.
- REGION: Die Clusterregion.
REST
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: erforderlich. Google Cloud-Projekt-ID
- REGION: erforderlich. Die Clusterregion.
- CLUSTER_NAME: erforderlich. Der Name des Clusters.
- NODE_GROUP_ID: erforderlich. Sie können
gcloud dataproc clusters describe CLUSTER_NAMEausführen, um die Knotengruppen-ID aufzulisten.
HTTP-Methode und URL:
GET https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAMEnodeGroups/Node_GROUP_ID
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten eine JSON-Antwort ähnlich wie diese erhalten:
{
  "name": "projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/NODE_GROUP_ID",
  "roles": [
    "DRIVER"
  ],
  "nodeGroupConfig": {
    "numInstances": 5,
    "imageUri": "https://www.googleapis.com/compute/v1/projects/cloud-dataproc-ci/global/images/dataproc-2-0-deb10-...-rc01",
    "machineTypeUri": "https://www.googleapis.com/compute/v1/projects/PROJECT_ID/zones/REGION-a/machineTypes/n1-standard-4",
    "diskConfig": {
      "bootDiskSizeGb": 1000,
      "bootDiskType": "pd-standard"
    },
    "managedGroupConfig": {
      "instanceTemplateName": "dataproc-driver-pool-mcia3j656h2fy",
      "instanceGroupManagerName": "dataproc-driver-pool-mcia3j656h2fy"
    },
    "minCpuPlatform": "AUTOMATIC",
    "preemptibility": "NON_PREEMPTIBLE"
  }
}
Größe einer Treiberknotengruppe ändern
Sie können den Befehl gcloud dataproc node-groups resize oder die Managed Service for Apache Spark API verwenden, um Treiberknoten zu einer Treiberknotengruppe eines Clusters hinzuzufügen oder daraus zu entfernen.
gcloud
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=SIZE
Erforderliche Flags:
- NODE_GROUP_ID: Sie können
gcloud dataproc clusters
describe CLUSTER_NAME
ausführen, um die Knotengruppen-ID aufzulisten. - CLUSTER_NAME: Der Clustername.
- REGION: Die Clusterregion.
- SIZE: Geben Sie die neue Anzahl von Treiberknoten in der Knotengruppe an.
Optionales Flag:
--graceful-decommission-timeout=TIMEOUT_DURATION: Beim Herunterskalieren einer Knotengruppe können Sie dieses Flag hinzufügen, um eine ordnungsgemäße Außerbetriebnahme TIMEOUT_DURATION anzugeben und die sofortige Beendigung von Jobtreibern zu vermeiden. Empfehlung: Legen Sie eine Zeitüberschreitung fest, die mindestens der Dauer des längsten Jobs entspricht, der in der Knotengruppe ausgeführt wird. Die Wiederherstellung fehlgeschlagener Treiber wird nicht unterstützt.
Beispiel: gcloud CLI-Befehl zum Hochskalieren von NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=4
Beispiel: gcloud CLI-Befehl zum Herunterskalieren von NodeGroup:
gcloud dataproc node-groups resize NODE_GROUP_ID \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --size=1 \
    --graceful-decommission-timeout="100s"
REST
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: erforderlich. Google Cloud-Projekt-ID
- REGION: erforderlich. Die Clusterregion.
- NODE_GROUP_ID: erforderlich. Sie können
gcloud dataproc
    clusters describe CLUSTER_NAME
ausführen, um die Knotengruppen-ID aufzulisten. - SIZE: erforderlich. Neue Anzahl von Knoten in der Knotengruppe.
- TIMEOUT_DURATION: Optional. Wenn Sie eine Knotengruppe herunterskalieren, können Sie dem Anfragetext einen
gracefulDecommissionTimeouthinzufügen, um die sofortige Beendigung von Jobtreibern zu vermeiden. Empfehlung: Legen Sie eine Zeitüberschreitung fest, die mindestens der Dauer des längsten Jobs entspricht, der in der Knotengruppe ausgeführt wird. (Die Wiederherstellung fehlgeschlagener Treiber wird nicht unterstützt.)Beispiel:
{ "size": SIZE,
  "gracefulDecommissionTimeout": "TIMEOUT_DURATION"
}
HTTP-Methode und URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/clusters/CLUSTER_NAME/nodeGroups/Node_GROUP_ID:resize
JSON-Text anfordern:
{
  "size": SIZE,
}
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten eine JSON-Antwort ähnlich wie diese erhalten:
{
  "name": "projects/PROJECT_ID/regions/REGION/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.dataproc.v1.NodeGroupOperationMetadata",
    "nodeGroupId": "NODE_GROUP_ID",
    "clusterUuid": "CLUSTER_UUID",
    "status": {
      "state": "PENDING",
      "innerState": "PENDING",
      "stateStartTime": "2022-12-01T23:34:53.064308Z"
    },
    "operationType": "RESIZE",
    "description": "Scale "up or "down" a GCE node pool to SIZE nodes."
  }
}
Cluster mit Treiberknotengruppe löschen
Wenn Sie einen Managed Service for Apache Spark-Cluster löschen, werden die mit dem Cluster verknüpften Knotengruppen gelöscht.
Job senden
Sie können den Befehl gcloud dataproc jobs submit oder die Managed Service for Apache Spark API verwenden, um einen Job an einen Cluster mit einer Treiberknotengruppe zu senden.
gcloud
gcloud dataproc jobs submit JOB_COMMAND \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=DRIVER_MEMORY \
    --driver-required-vcores=DRIVER_VCORES \
    DATAPROC_FLAGS \
    -- JOB_ARGS
Erforderliche Flags:
- JOB_COMMAND: Geben Sie den Jobbefehl an.
- CLUSTER_NAME: Der Clustername.
- DRIVER_MEMORY: Menge des Arbeitsspeichers für Jobtreiber in MB, die zum Ausführen eines Jobs erforderlich ist (siehe Yarn-Arbeitsspeichersteuerung).
- DRIVER_VCORES: Die Anzahl der vCPUs, die zum Ausführen eines Jobs erforderlich sind.
Zusätzliche Flags:
- DATAPROC_FLAGS: Fügen Sie zusätzliche Flags für gcloud dataproc jobs submit hinzu, die sich auf den Jobtyp beziehen.
- JOB_ARGS: Fügen Sie alle Argumente (nach dem
--) hinzu, die an den Job übergeben werden sollen.
Beispiele: Sie können die folgenden Beispiele in einer SSH-Terminalsitzung auf einem Managed Service for Apache Spark-Cluster mit einer Treiberknotengruppe ausführen.
Spark-Job zum Schätzen des Werts von
pi:gcloud dataproc jobs submit spark \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ --class=org.apache.spark.examples.SparkPi \ --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \ -- 1000
Spark-Job zur Wortzählung:
gcloud dataproc jobs submit spark \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --class=org.apache.spark.examples.JavaWordCount \
    --jars=file:///usr/lib/spark/examples/jars/spark-examples.jar \
    -- 'gs://apache-beam-samples/shakespeare/macbeth.txt'
PySpark-Job zum Schätzen des Werts von
pi:gcloud dataproc jobs submit pyspark \ file:///usr/lib/spark/examples/src/main/python/pi.py \ --cluster=CLUSTER_NAME \ --region=REGION \ --driver-required-memory-mb=2048 \ --driver-required-vcores=2 \ -- 1000
Hadoop-TeraGen-MapReduce-Job:
gcloud dataproc jobs submit hadoop \
    --cluster=CLUSTER_NAME \
    --region=REGION \
    --driver-required-memory-mb=2048 \
    --driver-required-vcores=2 \
    --jar file:///usr/lib/hadoop-mapreduce/hadoop-mapreduce-examples.jar \
    -- teragen 1000 \
    hdfs:///gen1/test
REST
Ersetzen Sie diese Werte in den folgenden Anfragedaten:
- PROJECT_ID: erforderlich. Google Cloud-Projekt-ID
- REGION: erforderlich. Region des Dataproc-Clusters
- CLUSTER_NAME: erforderlich. Der Clustername, der innerhalb eines Projekts eindeutig sein muss. Der Name muss mit einem Kleinbuchstaben beginnen und kann bis zu 51 Kleinbuchstaben, Ziffern und Bindestriche enthalten. Sie darf nicht mit einem Bindestrich enden. Der Name eines gelöschten Clusters kann wiederverwendet werden.
- DRIVER_MEMORY: erforderlich. Größe des Arbeitsspeichers für Jobtreiber in MB, der zum Ausführen eines Jobs erforderlich ist (siehe Yarn-Arbeitsspeichersteuerung).
- DRIVER_VCORES: erforderlich. Die Anzahl der vCPUs, die zum Ausführen eines Jobs erforderlich sind.
pi schätzt.
HTTP-Methode und URL:
POST https://dataproc.googleapis.com/v1/projects/PROJECT_ID/regions/REGION/jobs:submit
JSON-Text anfordern:
{
  "job": {
    "placement": {
    "clusterName": "CLUSTER_NAME",
    },
    "driverSchedulingConfig": {
      "memoryMb]": DRIVER_MEMORY,
      "vcores": DRIVER_VCORES
    },
    "sparkJob": {
      "jarFileUris": "file:///usr/lib/spark/examples/jars/spark-examples.jar",
      "args": [
        "10000"
      ],
      "mainClass": "org.apache.spark.examples.SparkPi"
    }
  }
}
Wenn Sie die Anfrage senden möchten, maximieren Sie eine der folgenden Optionen:
Sie sollten eine JSON-Antwort ähnlich wie diese erhalten:
{
  "reference": {
    "projectId": "PROJECT_ID",
    "jobId": "job-id"
  },
  "placement": {
    "clusterName": "CLUSTER_NAME",
    "clusterUuid": "cluster-Uuid"
  },
  "sparkJob": {
    "mainClass": "org.apache.spark.examples.SparkPi",
    "args": [
      "1000"
    ],
    "jarFileUris": [
      "file:///usr/lib/spark/examples/jars/spark-examples.jar"
    ]
  },
  "status": {
    "state": "PENDING",
    "stateStartTime": "start-time"
  },
  "jobUuid": "job-Uuid"
}
Python
- Clientbibliothek installieren
- Standardanmeldedaten für Anwendungen einrichten
- Code ausführen
- Spark-Job zur Schätzung des Pi-Werts:
- PySpark-Job zum Ausgeben von „hello world“:
Joblogs ansehen
Wenn Sie den Jobstatus aufrufen und Fehler beheben möchten, können Sie Treiberlogs mit der gcloud CLI oder der Cloud de Confiance Console aufrufen.
gcloud
Jobtreiberlogs werden während der Jobausführung an die gcloud CLI-Ausgabe oder dieCloud de Confiance Console gestreamt. Treiberlogs werden im Staging-Bucket des Managed Service for Apache Spark-Clusters in Cloud Storage gespeichert.
Führen Sie den folgenden gcloud CLI-Befehl aus, um den Speicherort der Treiberlogs in Cloud Storage aufzulisten:
gcloud dataproc jobs describe JOB_ID \
    --region=REGION
Der Cloud Storage-Speicherort der Treiberlogs wird in der Befehlsausgabe im folgenden Format als driverOutputResourceUri aufgeführt:
driverOutputResourceUri: gs://CLUSTER_STAGING_BUCKET/google-cloud-dataproc-metainfo/CLUSTER_UUID/jobs/JOB_ID
Console
So rufen Sie Clusterlogs für Knotengruppen auf:
Sie können das folgende Abfrageformat im Log-Explorer verwenden, um Logs zu finden:
resource.type="cloud_dataproc_cluster"
resource.labels.project_id="PROJECT_ID"
resource.labels.cluster_name="CLUSTER_NAME"
log_name="projects/PROJECT_ID/logs/LOG_TYPE>"
- PROJECT_ID: Ihre Cloud de Confiance -Projekt-ID.
- CLUSTER_NAME: Der Clustername.
- LOG_TYPE:
- Yarn-Nutzerlogs:
yarn-userlogs - YARN-Ressourcenmanager-Logs:
hadoop-yarn-resourcemanager - YARN-Knotenmanager-Logs:
hadoop-yarn-nodemanager
- Yarn-Nutzerlogs:
Messwerte überwachen
Jobtreiber für Managed Service for Apache Spark-Knotengruppen werden in einer untergeordneten dataproc-driverpool-driver-queue-Warteschlange unter einer dataproc-driverpool-Partition ausgeführt.
Messwerte für Treiberknotengruppen
In der folgenden Tabelle sind die zugehörigen Treiber-Messwerte für Knotengruppen aufgeführt, die standardmäßig für Treiberknotengruppen erfasst werden.
| Messwert für Treiberknotengruppe | Beschreibung |
|---|---|
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMB |
Die Menge des verfügbaren Arbeitsspeichers in Mebibyte in dataproc-driverpool-driver-queue unter der Partition dataproc-driverpool.
|
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainers |
Die Anzahl der ausstehenden (in der Warteschlange befindlichen) Container in dataproc-driverpool-driver-queue unter der Partition dataproc-driverpool. |
Messwerte für untergeordnete Warteschlangen
In der folgenden Tabelle sind die Messwerte für untergeordnete Warteschlangen aufgeführt. Die Messwerte werden standardmäßig für Treiberknotengruppen erfasst und können für die Erfassung in allen Managed Service for Apache Spark-Clustern aktiviert werden.
| Messwert für untergeordnete Warteschlange | Beschreibung |
|---|---|
yarn:ResourceManager:ChildQueueMetrics:AvailableMB |
Die Menge des verfügbaren Arbeitsspeichers in Mebibyte in dieser Warteschlange unter der Standardpartition. |
yarn:ResourceManager:ChildQueueMetrics:PendingContainers |
Anzahl der ausstehenden (in der Warteschlange befindlichen) Container in dieser Warteschlange unter der Standardpartition. |
yarn:ResourceManager:ChildQueueMetrics:running_0 |
Die Anzahl der Jobs mit einer Laufzeit zwischen 0 und 60 Minuten in dieser Warteschlange unter allen Partitionen. |
yarn:ResourceManager:ChildQueueMetrics:running_60 |
Die Anzahl der Jobs mit einer Laufzeit zwischen 60 und 300 Minuten in dieser Warteschlange unter allen Partitionen. |
yarn:ResourceManager:ChildQueueMetrics:running_300 |
Die Anzahl der Jobs mit einer Laufzeit zwischen 300 und 1440 Minuten in dieser Warteschlange unter allen Partitionen. |
yarn:ResourceManager:ChildQueueMetrics:running_1440 |
Die Anzahl der Jobs mit einer Laufzeit von mehr als 1440 Minuten in dieser Warteschlange in allen Partitionen. |
yarn:ResourceManager:ChildQueueMetrics:AppsSubmitted |
Anzahl der Anwendungen, die in allen Partitionen an diese Warteschlange gesendet wurden. |
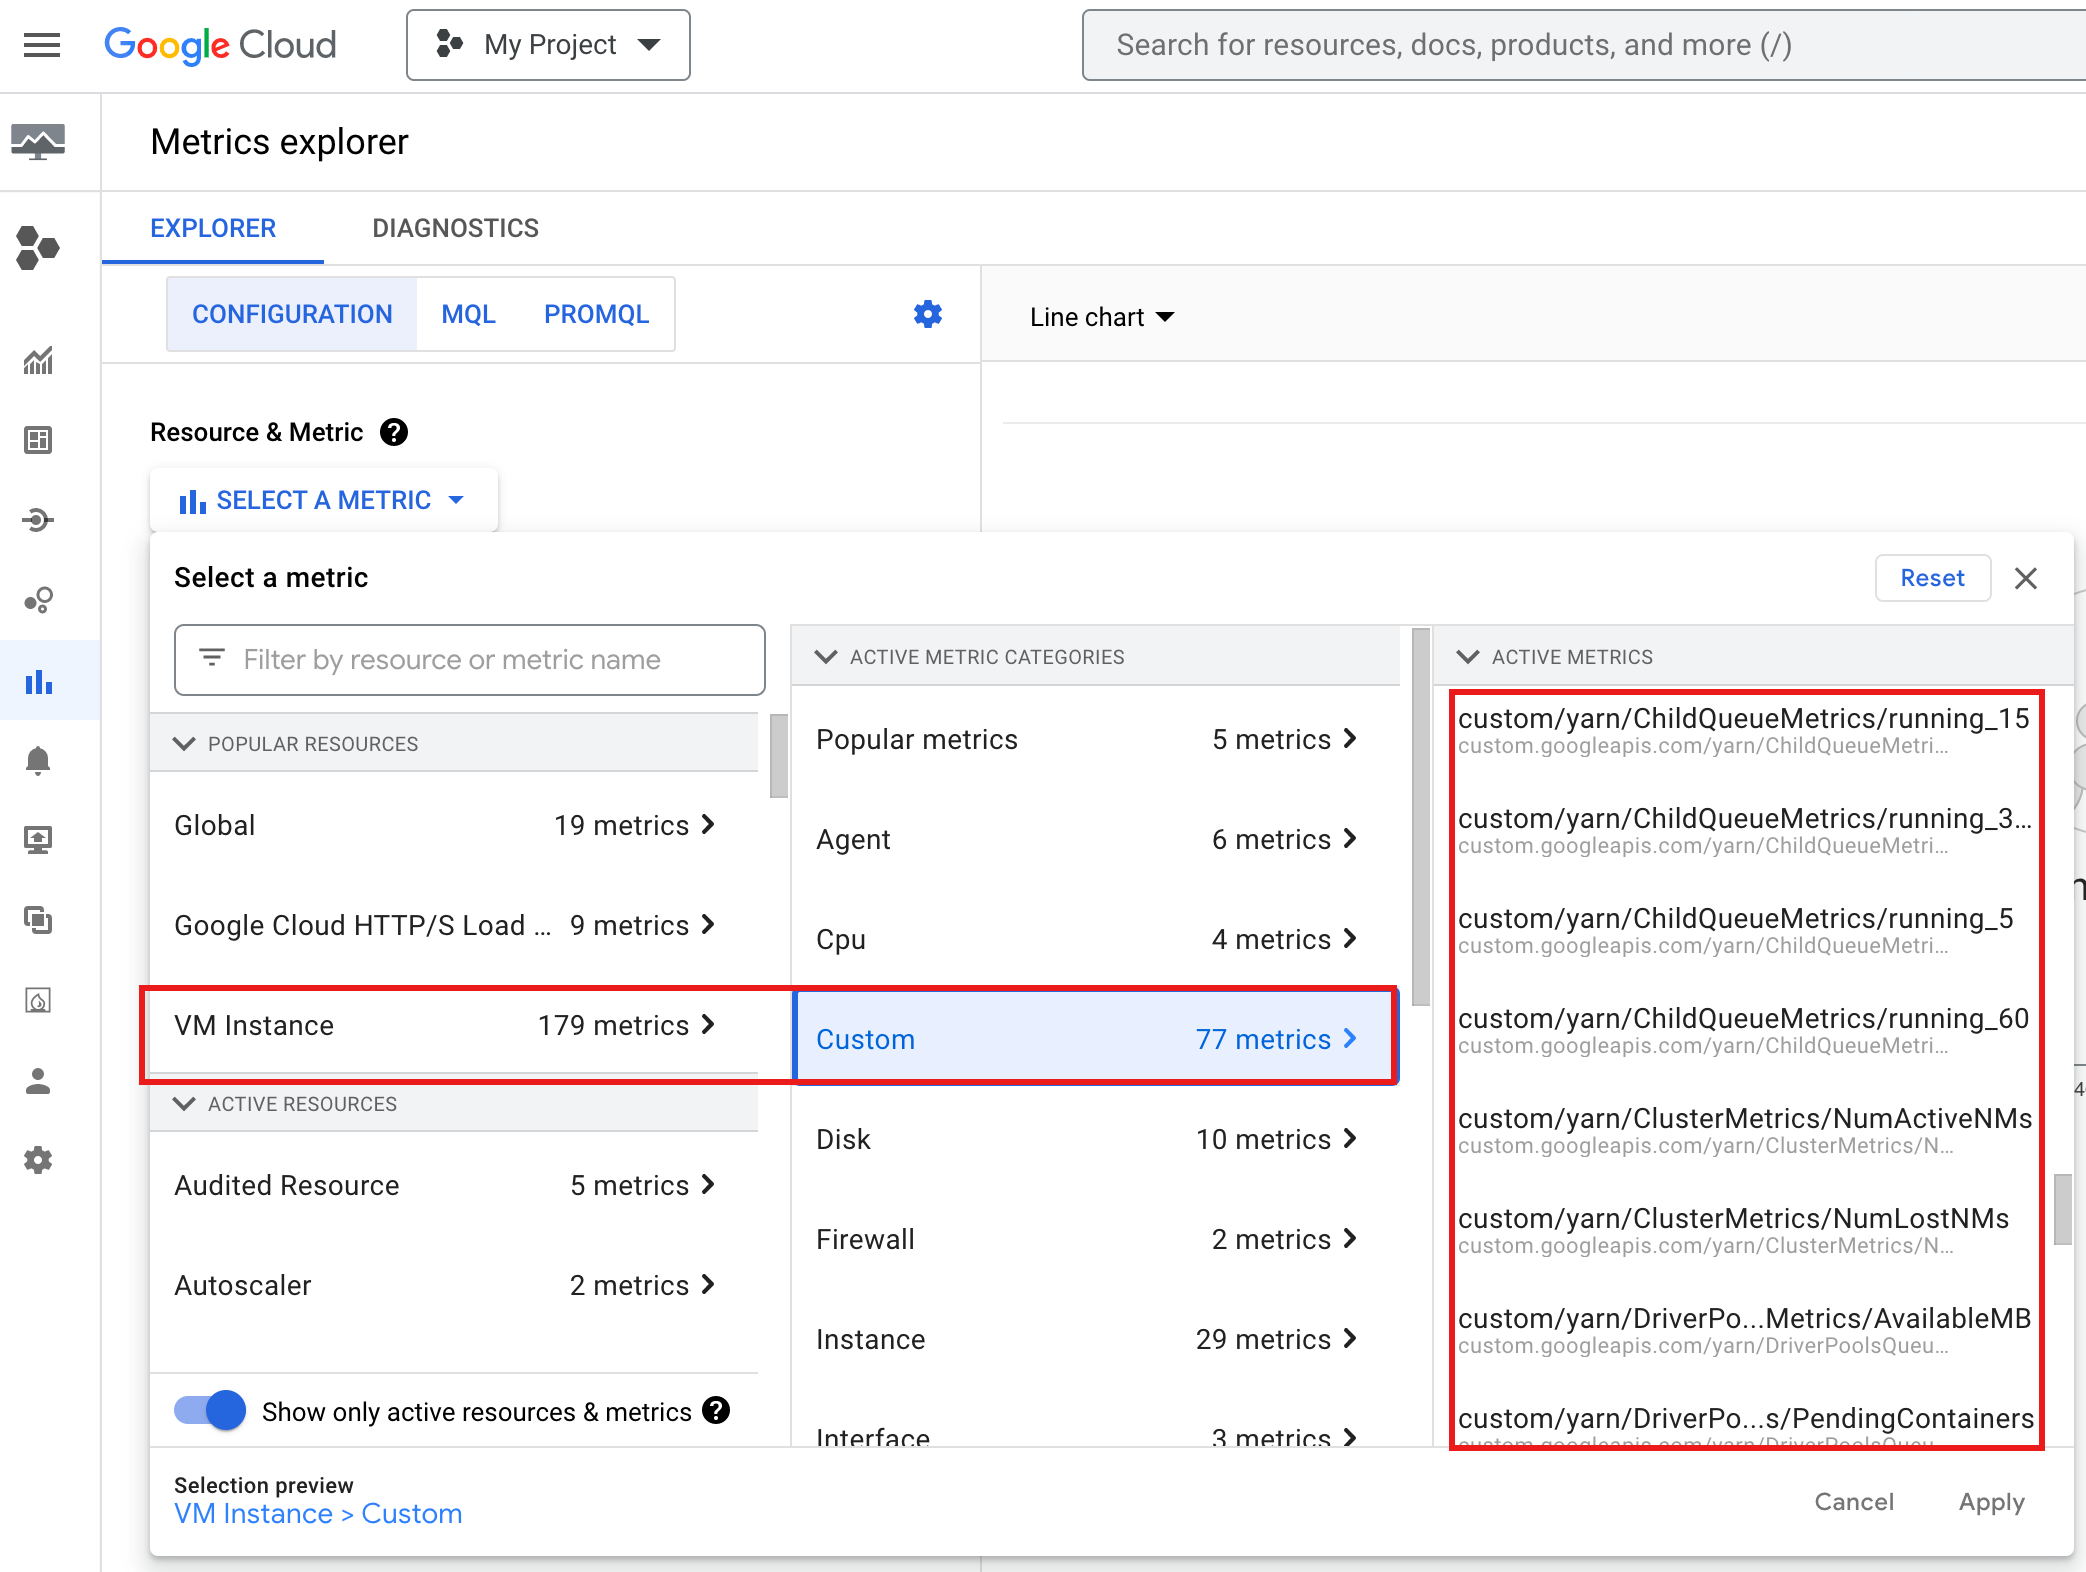
So rufen Sie YARN ChildQueueMetrics und DriverPoolsQueueMetrics in derCloud de Confiance Console auf:
Wählen Sie im Metrics Explorer die Ressourcen VM-Instanz → Benutzerdefiniert aus.
Jobtreiber für Knotengruppe debuggen
In diesem Abschnitt finden Sie Bedingungen und Fehler für Treiberknotengruppen sowie Empfehlungen zur Behebung der Bedingung oder des Fehlers.
Conditions
Bedingung:
yarn:ResourceManager:DriverPoolsQueueMetrics:AvailableMBnähert sich0. Dies weist darauf hin, dass der Speicher der Cluster-Treiberpool-Warteschlange knapp wird.Empfehlung: Erhöhen Sie die Größe des Fahrerpools.
Bedingung:
yarn:ResourceManager:DriverPoolsQueueMetrics:PendingContainersist größer als 0. Dies kann darauf hindeuten, dass der Arbeitsspeicher der Cluster-Treiberpools knapp wird und YARN Jobs in die Warteschlange stellt.Empfehlung: Erhöhen Sie die Größe des Fahrerpools.
Fehler
Fehler:
Cluster <var>CLUSTER_NAME</var> requires driver scheduling config to run
SPARK job because it contains a node pool with role DRIVER.
Positive values are required for all driver scheduling config values.
Empfehlung: Legen Sie für
driver-required-memory-mbunddriver-required-vcorespositive Zahlen fest.Fehler:
Container exited with a non-zero exit code 137.Empfehlung: Erhöhen Sie
driver-required-memory-mbauf die Speichernutzung des Jobs.