

Prever série temporal hierárquicas com um modelo univariado ARIMA_PLUS
Neste tutorial, ensinamos como usar um
modelo de série temporal univariada ARIMA_PLUS
para prever séries temporais hierárquicas. Ela prevê o valor futuro de uma determinada coluna com base nos valores históricos dela e também calcula os valores de resumo para essa coluna em uma ou mais dimensões de interesse.
Os valores previstos são calculados para cada ponto no tempo e para cada valor em uma ou mais colunas que especificam as dimensões de interesse. Por exemplo, se você quisesse prever incidentes de trânsito diários e especificasse uma coluna de dimensão com dados de estado, os dados previstos conteriam valores para cada dia do estado A, depois valores para cada dia do estado B e assim por diante. Por exemplo, se você quisesse prever incidentes de trânsito diários e especificasse colunas de dimensão com dados de estado e cidade, os dados previstos teriam valores para cada dia do estado A e da cidade A, depois valores para cada dia do estado A e da cidade B, e assim por diante. Em modelos de série temporal hierárquica, a reconciliação hierárquica é usada para resumir e reconciliar cada série temporal secundária com a principal. Por exemplo, a soma dos valores previstos para todas as cidades no estado A precisa ser igual ao valor previsto para o estado A.
Neste tutorial, você vai criar dois modelos de série temporal com os mesmos dados. Um deles usa previsão hierárquica e outro não. Isso permite comparar os resultados retornados pelos modelos.
Neste tutorial, usamos dados da tabela pública bigquery-public-data.iowa_liquor.sales.sales. Essa tabela contém informações de mais de 1 milhão de produtos de bebidas alcoólicas em
diferentes lojas usando dados públicos de vendas de bebidas alcoólicas de Iowa.
Antes de ler este tutorial, recomendamos que você leia Prever várias série temporal com um modelo univariado.
Permissões exigidas
Para criar o conjunto de dados, é preciso ter a permissão de IAM
bigquery.datasets.create.Para criar o modelo, você precisa das seguintes permissões:
bigquery.jobs.createbigquery.models.createbigquery.models.getDatabigquery.models.updateData
Para executar a inferência, você precisa das seguintes permissões:
bigquery.models.getDatabigquery.jobs.create
Para mais informações sobre os papéis e as permissões do IAM no BigQuery, consulte Introdução ao IAM.
Objetivos
Neste tutorial, você usará:
- Criar um modelo de série temporal múltipla e um modelo hierárquico de série temporal múltipla para prever valores de vendas de garrafas usando a instrução
CREATE MODEL. - Recuperar os valores previstos de vendas de garrafas dos modelos usando a
função
ML.FORECAST.
Custos
Neste tutorial, usamos componentes faturáveis do Cloud de Confiance by S3NS, incluindo:
- BigQuery
- BigQuery ML
Para mais informações sobre os custos do BigQuery, consulte a página de preços.
Para mais informações sobre os custos do BigQuery ML, consulte os preços do BigQuery ML.
-
In the Cloud de Confiance console, on the project selector page, select or create a Cloud de Confiance project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Cloud de Confiance project.
- O BigQuery é ativado automaticamente em novos projetos.
Para ativar o BigQuery em um projeto preexistente, acesse
Ative a API BigQuery, se ainda não tiver feito isso.
Funções necessárias para ativar APIs
Para ativar APIs, você precisa da permissão
serviceusage.services.enable. Se você criou o projeto, provavelmente já tem essa permissão com o papel de Proprietário (roles/owner). Caso contrário, é possível receber essa permissão com o papel de Administrador do Service Usage (roles/serviceusage.serviceUsageAdmin). Saiba como conceder papéis.
Criar um conjunto de dados
Para criar um conjunto de dados do BigQuery, selecione uma das seguintes opções:
Console
No console do Cloud de Confiance , acesse a página BigQuery.
No painel à esquerda, clique em Explorer:

Se o painel esquerdo não aparecer, clique em Expandir painel esquerdo para abrir.
Em Explorer, expanda seu projeto e clique em Conjuntos de dados.
Na página Conjuntos de dados, clique em Criar conjunto de dados.
No painel Criar conjunto de dados, faça o seguinte:
Para o código do conjunto de dados, insira
bqml_tutorial.Em Local dos dados, selecione US.
Não mude as outras configurações padrão.
Clique em Criar conjunto de dados.
bq
Para criar um conjunto de dados, use o
comando bq mk --dataset.
Crie um conjunto de dados chamado
bqml_tutorialcom o local dos dados definido comoUS:bq mk --dataset \ --location=US \ --description "BigQuery ML tutorial dataset." \ bqml_tutorial
Confirme se o conjunto de dados foi criado:
bq ls
API
Chame o método datasets.insert com um recurso de conjunto de dados definido:
{
  "datasetReference": {
     "datasetId": "bqml_tutorial"
  }
}
Criar um modelo de série temporal
Crie um modelo de série temporal usando os dados de vendas de bebidas alcoólicas de Iowa.
A consulta do GoogleSQL a seguir cria um modelo que prevê o total diário de garrafas vendidas em 2015 nos condados de Polk, Linn e Scott.
Na consulta a seguir, a cláusula
OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...)
indica que você está criando um
modelo de série temporal com base em
ARIMA. Use a opção TIME_SERIES_ID da instrução CREATE MODEL para especificar uma ou mais colunas nos dados de entrada para as quais você quer receber previsões. A opção auto_arima_max_order da instrução CREATE MODEL controla o espaço de pesquisa para ajuste de hiperparâmetros no algoritmo auto.ARIMA. A opção decompose_time_series da instrução CREATE MODEL tem como padrão TRUE. Assim, as informações sobre os dados de série temporal são retornadas quando você avalia o modelo na próxima etapa.
A cláusula OPTIONS(model_type='ARIMA_PLUS', time_series_timestamp_col='date', ...)
indica que você está criando um
modelo de série temporal com base em
ARIMA. Por padrão,
auto_arima=TRUE,
para que o algoritmo auto.ARIMA ajuste automaticamente os hiperparâmetros nos modelos
ARIMA_PLUS. O algoritmo se encaixa em dezenas de modelos candidatos e escolhe
o melhor, que é aquele com o menor
critério de informação de Akaike (AIC).
Definir a
opção holiday_region
como US permite uma modelagem mais precisa desses períodos de feriados nos Estados Unidos
se houver padrões de feriados nos Estados Unidos na série temporal.
Siga estas etapas para criar o modelo:
No console do Cloud de Confiance , acesse a página BigQuery.
No editor de consultas, cole a consulta a seguir e clique em Executar:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
A consulta leva cerca de 37 segundos para ser concluída. Depois disso, você pode acessar o modelo
liquor_forecast. Como a consulta usa uma instruçãoCREATE MODELpara criar um modelo, não há resultados de consulta.
Usar o modelo para prever dados
Preveja valores futuros de série temporal usando a função ML.FORECAST.
Na consulta a seguir, a
cláusula STRUCT(20 AS horizon, 0.8 AS confidence_level) indica que a
consulta prevê 20 períodos futuros e gera um intervalo de previsão
com um nível de confiança de 80%.
Siga estas etapas para prever dados com o modelo:
No console do Cloud de Confiance , acesse a página BigQuery.
No editor de consultas, cole a consulta a seguir e clique em Executar:
SELECT *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast`,
    STRUCT(20 AS horizon, 0.8 AS confidence_level))
ORDER BY store_number, county, city, zip_code, forecast_timestamp;
A resposta deve ficar assim:
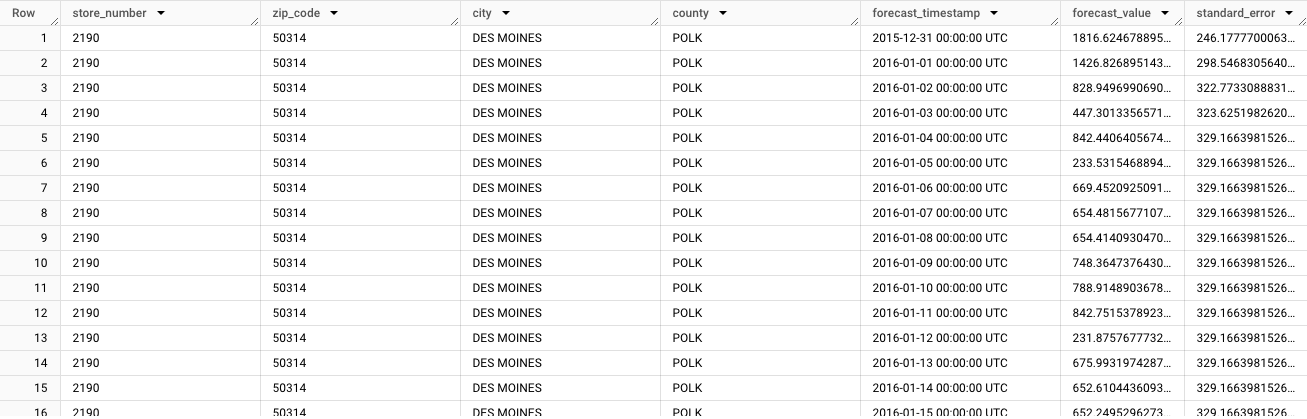
A saída começa com os dados previstos para a primeira série temporal:
store_number=2190,zip_code=50314,city=DES MOINES,county=POLK. À medida que você rola os dados, as previsões de cada série temporal única subsequente aparecem. Para gerar previsões que agregam totais de diferentes dimensões, como previsões para um condado específico, é preciso gerar uma previsão hierárquica.
Criar um modelo de série temporal hierárquica
Criar uma previsão de série temporal hierárquica usando os dados de vendas de bebidas alcoólicas de Iowa.
A consulta do GoogleSQL a seguir cria um modelo que gera previsões hierárquicas para o total diário de garrafas vendidas em 2015 nos condados de Polk, Linn e Scott.
Na consulta a seguir, a opção HIERARCHICAL_TIME_SERIES_COLS na instrução
CREATE MODEL indica que você está criando uma previsão hierárquica
com base em um conjunto de colunas especificado. Cada uma dessas colunas é agrupada e agregada. Por exemplo, na consulta anterior, isso significa que o valor da coluna store_number é acumulado para mostrar previsões para cada valor de county, city e zip_code. Separadamente, os valores de zip_code e store_number também são acumulados para mostrar previsões para cada valor de county e city.
A ordem das colunas é importante porque define a estrutura da hierarquia.
Siga estas etapas para criar o modelo:
No console do Cloud de Confiance , acesse a página BigQuery.
No editor de consultas, cole a consulta a seguir e clique em Executar:
CREATE OR REPLACE MODEL `bqml_tutorial.liquor_forecast_hierarchical`
  OPTIONS (
    MODEL_TYPE = 'ARIMA_PLUS',
    TIME_SERIES_TIMESTAMP_COL = 'date',
    TIME_SERIES_DATA_COL = 'total_bottles_sold',
    TIME_SERIES_ID_COL = ['store_number', 'zip_code', 'city', 'county'],
    HIERARCHICAL_TIME_SERIES_COLS = ['zip_code', 'store_number'],
    HOLIDAY_REGION = 'US')
AS
SELECT
  store_number,
  zip_code,
  city,
  county,
  date,
  SUM(bottles_sold) AS total_bottles_sold
FROM
  `bigquery-public-data.iowa_liquor_sales.sales`
WHERE
  date BETWEEN DATE('2015-01-01') AND DATE('2015-12-31')
  AND county IN ('POLK', 'LINN', 'SCOTT')
GROUP BY store_number, date, city, zip_code, county;
A consulta leva cerca de 45 segundos para ser concluída. Depois disso, o modelo
bqml_tutorial.liquor_forecast_hierarchicalpode ser acessado no painel Explorer. Como a consulta usa uma instruçãoCREATE MODELpara criar um modelo, não há resultados de consulta.
Usar o modelo hierárquico para prever dados
Recupere os dados de previsão hierárquica do modelo usando a função ML.FORECAST.
Siga estas etapas para prever dados com o modelo:
No console do Cloud de Confiance , acesse a página BigQuery.
No editor de consultas, cole a consulta a seguir e clique em Executar:
SELECT
  *
FROM
  ML.FORECAST(
    MODEL `bqml_tutorial.liquor_forecast_hierarchical`,
    STRUCT(30 AS horizon, 0.8 AS confidence_level))
WHERE city = 'LECLAIRE'
ORDER BY county, city, zip_code, store_number, forecast_timestamp;
A resposta deve ficar assim:
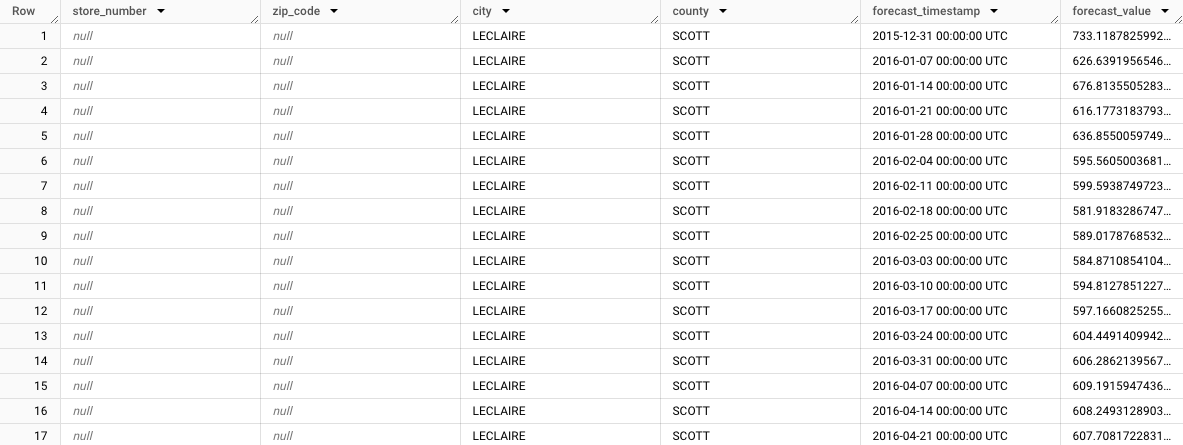
Observe como a previsão agregada é exibida para a cidade de LeClaire,
store_number=NULL,zip_code=NULL,city=LECLAIRE,county=SCOTT. Ao analisar o restante das linhas, observe as previsões para os outros subgrupos. Por exemplo, a imagem a seguir mostra as previsões agregadas para os CEPs52753,store_number=NULL,zip_code=52753,city=LECLAIREecounty=SCOTT: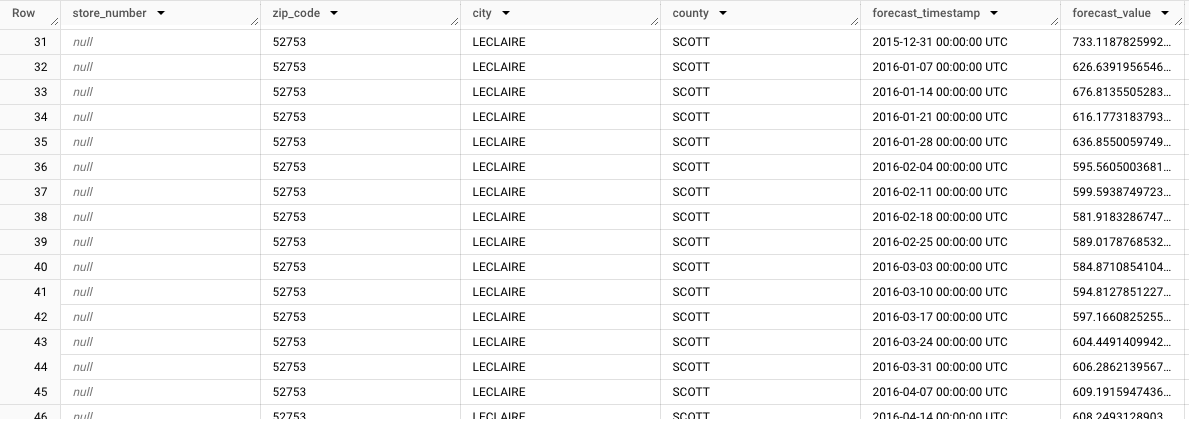
Limpar
Para evitar cobranças na sua conta do Cloud de Confiance by S3NS pelos recursos usados neste tutorial, exclua o projeto que contém os recursos ou mantenha o projeto e exclua os recursos individuais.
- exclua o projeto que você criou; ou
- Mantenha o projeto e exclua o conjunto de dados.
Excluir o conjunto de dados
A exclusão do seu projeto removerá todos os conjuntos de dados e tabelas no projeto. Caso prefira reutilizá-lo, exclua o conjunto de dados criado neste tutorial:
Se necessário, abra a página do BigQuery no console doCloud de Confiance .
Na navegação, clique no conjunto de dados bqml_tutorial criado.
Clique em Excluir conjunto de dados no lado direito da janela. Essa ação exclui o conjunto, a tabela e todos os dados.
Na caixa de diálogo Excluir conjunto de dados, confirme o comando de exclusão digitando o nome do seu conjunto de dados (
bqml_tutorial). Em seguida, clique em Excluir.
Excluir o projeto
Para excluir o projeto:
- No console Cloud de Confiance , acesse a página Gerenciar recursos.
- Na lista de projetos, selecione o projeto que você quer excluir e clique em Excluir .
- Na caixa de diálogo, digite o ID do projeto e clique em Encerrar para excluí-lo.
A seguir
- Saiba como prever uma única série temporal com um modelo univariado
- Aprenda a prever várias série temporal com um modelo univariado
- Aprenda a escalonar um modelo univariado ao prever várias série temporal em muitas linhas.
- Saiba como prever uma única série temporal com um modelo multivariável
- Para uma visão geral do BigQuery ML, consulte Introdução à IA e ao ML no BigQuery.