

שיטות מומלצות לניתוח מרחבי
כשמנתחים מאפיינים גיאו-מרחביים מורכבים ב-BigQuery, מערכי הנתונים יכולים להכיל אוספים גדולים של פוליגונים, צורות מרובות-פוליגונים ורצפי קווים שמייצגים מאפיינים מורכבים, כמו כבישים, חלקות קרקע ואזורי שיטפון. כל צורה יכולה להכיל אלפי נקודות. ברוב הפעולות המרחביות ב-BigQuery (לדוגמה, חישובי חיתוכים ומרחקים), האלגוריתם הבסיסי בדרך כלל עובר על רוב הנקודות בכל צורה כדי להפיק תוצאה. בפעולות מסוימות, האלגוריתם מבקר בכל הנקודות.
עיבוד צורות עם אלפי נקודות יכול להגדיל באופן משמעותי את עלויות השאילתה ואת משך הזמן שלה. כדי לשפר את הביצועים של שאילתות גיאוגרפיות-מרחביות ולצמצם את זמן האחזור, אתם יכולים ליישם שיטות מומלצות ספציפיות לניתוח מרחבי על מערכי הנתונים שלכם.
במאמר הזה אנחנו מניחים שהטבלאות הגיאוגרפיות שלכם ב-BigQuery מקובצות לפי עמודה גיאוגרפית.
פישוט צורות
שיטה מומלצת: השתמשו בפונקציות simplify ו-snap-to-grid כדי לאחסן גרסה פשוטה של קבוצת הנתונים המקורית כתצוגה מהותית.
אפשר לפשט הרבה צורות מורכבות עם מספר גדול של נקודות בלי לפגוע יותר מדי ברמת הדיוק. כדי לצמצם את מספר הנקודות בצורות מורכבות, אפשר להשתמש בפונקציות ST_SIMPLIFY ו-ST_SNAPTOGRID של BigQuery בנפרד או ביחד.
אפשר לשלב את הפונקציות האלה עם תצוגות מהותיות ב-BigQuery כדי לאחסן גרסה פשוטה של קבוצת הנתונים המקורי כתצוגה מהותית, שמתעדכנת באופן אוטומטי בהתאם למסד הנתונים הטבלאי.
פישוט צורות הוא שימושי במיוחד לשיפור העלות והביצועים של מערך נתונים בתרחישים הבאים:
- אתם צריכים לשמור על רמה גבוהה של דמיון לצורה האמיתית.
- אתם צריכים לבצע פעולות ברמת דיוק גבוהה.
- אתם רוצים להאיץ את ההמחשות החזותיות בלי לאבד פרטים גלויים בצורות.
דוגמת הקוד הבאה מראה איך להשתמש בפונקציה ST_SIMPLIFY במסד נתונים טבלאי עם עמודת GEOGRAPHY בשם geom. הקוד מפשט את הצורות ומסיר נקודות בלי לשנות את הקצוות של הצורה ביותר מטווח הסטייה המותר של מטר אחד.
CREATE MATERIALIZED VIEW project.dataset.base_mv
  CLUSTER BY geom
AS (
  SELECT
    * EXCEPT (geom),
    ST_SIMPLIFY(geom, 1.0) AS geom
  FROM base_table
)
דוגמת הקוד הבאה מראה איך להשתמש בפונקציה ST_SNAPTOGRID כדי להצמיד את הנקודות לרשת ברזולוציה של 0.00001 מעלות:
CREATE MATERIALIZED VIEW project.dataset.base_mv
  CLUSTER BY geom
AS (
  SELECT
    * EXCEPT (geom),
    ST_SNAPTOGRID(geom, -5) AS geom
  FROM base_table
)
הארגומנט grid_size בפונקציה הזו משמש כמעריך, כלומר 10e-5 = 0.00001. הרזולוציה הזו שווה ערך לכמטר אחד במקרה הגרוע ביותר, שמתרחש בקו המשווה.
אחרי שיוצרים את התצוגות האלה, שולחים שאילתה לתצוגה base_mv באמצעות אותה סמנטיקה של שאילתה שבה הייתם משתמשים כדי לשלוח שאילתה למסד הנתונים הטבלאי. אתם יכולים להשתמש בשיטה הזו כדי לזהות במהירות אוסף של צורות שצריך לנתח לעומק, ואז לבצע ניתוח מעמיק יותר במסד נתונים טבלאי. כדאי לבדוק את השאילתות כדי לראות אילו ערכי סף הכי מתאימים לנתונים שלכם.
בתרחישי שימוש של מדידה, צריך לקבוע את רמת הדיוק שנדרשת לתרחיש לדוגמה. כשמשתמשים בפונקציה ST_SIMPLIFY, מגדירים את הפרמטר threshold_meters לרמת הדיוק הנדרשת. כדי למדוד מרחקים בקנה מידה של עיר או יותר, מגדירים סף של 10 מטרים. בקנה מידה קטן יותר – לדוגמה, כשמודדים את המרחק בין בניין למאגר המים הקרוב ביותר – כדאי להשתמש בסף קטן יותר של מטר אחד או פחות. אם משתמשים בערכי סף קטנים יותר, פחות נקודות יוסרו מהצורה הנתונה.
כשמציגים שכבות במפה משירות אינטרנט, אפשר לחשב מראש תצוגות מהותיות לרמות זום שונות באמצעות פרויקט bigquery-geotools, שהוא מנהל התקן ל-Geoserver שמאפשר להציג שכבות מרחביות מ-BigQuery. הדרייבר הזה יוצר כמה תצוגות מהותיות עם פרמטרים שונים של סף ST_SIMPLIFY, כדי שיוצגו פחות פרטים ברמות זום גבוהות יותר.
שימוש בנקודות ובמלבנים
שיטה מומלצת: כדאי להקטין את הצורה לנקודה או למלבן כדי לייצג את המיקום שלה.
כדי לשפר את ביצועי השאילתה, אפשר לצמצם את הצורה לנקודה אחת או למלבן. השיטות בקטע הזה לא מייצגות במדויק את הפרטים והפרופורציות של הצורה, אלא מבצעות אופטימיזציה לייצוג המיקום של הצורה.
אתם יכולים להשתמש בנקודה המרכזית הגיאוגרפית של צורה (מרכז הכובד שלה) כדי לייצג את המיקום של הצורה כולה. משתמשים במלבן שמכיל את הצורה כדי ליצור את ההיקף של הצורה, שבו אפשר להשתמש כדי לייצג את מיקום הצורה ולשמור מידע על הגודל היחסי שלה.
השימוש בנקודות ובמלבנים הוא השימושי ביותר לשיפור העלות והביצועים של מערך נתונים כשצריך למדוד את המרחק בין שתי נקודות, כמו בין שתי ערים.
לדוגמה, נניח שאתם רוצים לטעון מסד נתונים של חלקות קרקע בארצות הברית לטבלה ב-BigQuery, ואז לקבוע מהו מקור המים הקרוב ביותר.
במקרה כזה, חישוב מראש של מרכזי החלקות באמצעות הפונקציה ST_CENTROID בשילוב עם השיטה שמתוארת בקטע פישוט צורות במסמך הזה, יכול להפחית את מספר ההשוואות שמבוצעות כשמשתמשים בפונקציות ST_DISTANCE או ST_DWITHIN. כשמשתמשים בפונקציה ST_CENTROID, צריך להביא בחשבון את מרכז הכובד של החלקה בחישוב. חישוב מראש של מרכזי החבילות בדרך הזו יכול גם להפחית את השונות בביצועים, כי צורות שונות של חבילות עשויות להכיל מספרים שונים של נקודות.
גרסה אחרת של השיטה הזו היא להשתמש בפונקציה ST_BOUNDINGBOX במקום בפונקציה ST_CENTROID כדי לחשב מעטפת מלבנית סביב צורת הקלט. השיטה הזו פחות יעילה משימוש בנקודה אחת, אבל היא יכולה לצמצם את ההתרחשות של מקרי קצה מסוימים. הגרסה הזו עדיין מציעה ביצועים טובים ועקביים, כי הפלט של הפונקציה ST_BOUNDINGBOX תמיד מכיל רק ארבע נקודות שצריך להביא בחשבון. התוצאה של התיבה התוחמת תהיה מסוג STRUCT, כלומר תצטרכו לחשב את המרחקים באופן ידני או להשתמש בשיטת אינדקס הווקטור שמתוארת בהמשך המאמר.
שימוש בקליפות
שיטה מומלצת: השתמשו במעטפת כדי לייצג את המיקום של צורה בצורה אופטימלית.
אם תדמיינו שאתם עוטפים צורה בניילון נצמד ומחשבים את הגבול של הניילון הנצמד, הגבול הזה נקרא מעטפת. במעטפת קמורה, כל הזוויות של הצורה שנוצרת הן קמורות. בדומה למידת ההיקף של צורה, קמור שומר מידע מסוים על הגודל והפרופורציות היחסיים של הצורה הבסיסית. עם זאת, השימוש במעטפת דורש אחסון ועיבוד של יותר נקודות בניתוחים הבאים.
אפשר להשתמש בפונקציה ST_CONVEXHULL כדי לבצע אופטימיזציה לייצוג המיקום של הצורה. השימוש בפונקציה הזו משפר את הדיוק, אבל פוגע בביצועים. הפונקציה ST_CONVEXHULL דומה לפונקציה ST_EXTENT, אבל צורת הפלט מכילה יותר נקודות, ומספר הנקודות משתנה בהתאם למורכבות של צורת הקלט. היתרון בביצועים כנראה זניח בקבוצות נתונים קטנות של צורות לא מורכבות, אבל בקבוצות נתונים גדולות מאוד עם צורות גדולות ומורכבות, הפונקציה ST_CONVEXHULL מציעה איזון טוב בין עלות, ביצועים ודיוק.
שימוש במערכות רשת
שיטה מומלצת: השתמשו במערכות רשת גיאוגרפיות כדי להשוות בין אזורים.
אם אתם צריכים לצבור נתונים באזורים מקומיים ולהשוות בין צבירות סטטיסטיות של האזורים האלה, כדאי להשתמש במערכת רשת סטנדרטית כדי להשוות בין אזורים שונים.
לדוגמה, קמעונאי יכול לנתח שינויים דמוגרפיים לאורך זמן באזורים שבהם נמצאות החנויות שלו, או באזורים שבהם הוא שוקל לפתוח חנות חדשה. או שחברת ביטוח רוצה להבין טוב יותר את הסיכונים לנכסים, ולכן היא מנתחת את הסיכונים הנפוצים של מפגעי טבע באזור מסוים.
שימוש במערכות רשת סטנדרטיות כמו S2 ו-H3 יכול להאיץ את הצבירות הסטטיסטיות והניתוחים המרחביים האלה. שימוש במערכות הרשת האלה יכול גם לפשט את פיתוח הניתוחים ולשפר את יעילות הפיתוח.
לדוגמה, השוואות שמשתמשות באזורים מוגדרים למפקד אוכלוסין בארצות הברית סובלות מחוסר עקביות בגודל, ולכן צריך להחיל גורמי תיקון כדי לבצע השוואות דומות בין אזורים מוגדרים למפקד אוכלוסין. בנוסף, אזורים מוגדרים למפקד אוכלוסין וגבולות מנהליים אחרים משתנים עם הזמן, וצריך להשקיע מאמץ כדי לתקן את השינויים האלה. שימוש במערכות רשת לניתוח מרחבי יכול לפתור אתגרים כאלה.
שימוש בחיפוש וקטורי ובאינדקסים וקטוריים
שיטה מומלצת: השתמשו בחיפוש וקטורי ובאינדקסים וקטוריים לשאילתות מרחביות של השכן הקרוב ביותר.
יכולות החיפוש הווקטורי נוספו ל-BigQuery כדי לאפשר תרחישים לדוגמה של למידת מכונה, כמו חיפוש סמנטי, זיהוי דמיון ו-RAG. המפתח להפעלת תרחישי השימוש האלה הוא שיטת הוספה לאינדקס שנקראת חיפוש משוער של השכן הקרוב ביותר. אתם יכולים להשתמש בחיפוש וקטורי כדי להאיץ ולפשט שאילתות גיאו-מרחביות של השכן הקרוב ביותר, על ידי השוואה בין וקטורים שמייצגים נקודות במרחב.
אתם יכולים להשתמש בחיפוש וקטורי כדי לחפש תכונות לפי רדיוס. קודם כול, מגדירים רדיוס לחיפוש. אתם יכולים לגלות את הרדיוס האופטימלי בקבוצת התוצאות של חיפוש השכן הקרוב ביותר. אחרי שמגדירים את הרדיוס, משתמשים בפונקציה ST_DWITHIN כדי לזהות מאפיינים קרובים.
לדוגמה, נניח שאתם רוצים למצוא את עשרת הבניינים הכי קרובים לבניין עוגן מסוים שכבר יש לכם את המיקום שלו. אתם יכולים לאחסן את נקודות המרכז של כל בניין כווקטור בטבלה חדשה, להוסיף את הטבלה לאינדקס ולחפש באמצעות חיפוש וקטורי.
בדוגמה הזו, אתם יכולים גם להשתמש בנתונים של Overture Maps ב-BigQuery כדי ליצור טבלה נפרדת של צורות מבנים שתואמות לאזור שמעניין אתכם, ווקטור שנקרא geom_vector. האזור שמעניין אותנו בדוגמה הזו הוא העיר נורפוק, וירג'יניה, ארצות הברית, שמיוצגת על ידי קוד FIPS 51710, כמו שמוצג בדוגמת הקוד הבאה:
CREATE TABLE vector_search.norfolk_buildings
AS (
  SELECT
    *,
    [
      ST_X(ST_CENTROID(building.geometry)),
      ST_Y(ST_CENTROID(building.geometry))] AS geom_vector
  FROM `bigquery-public-data.overture_maps.building` AS building
  INNER JOIN `bigquery-public-data.geo_us_boundaries.counties` AS county
    ON (st_intersects(county.county_geom, building.geometry))
  WHERE county.county_fips_code = '51710'
)
דוגמת הקוד הבאה מראה איך ליצור אינדקס וקטורי בטבלה:
CREATE
  vector index building_vector_index
ON
  vector_search.norfolk_buildings(geom_vector)
  OPTIONS (index_type = 'IVF')
השאילתה הזו מזהה את 10 המבנים הכי קרובים למבנה עוגן מסוים:
SELECT base.*
FROM
  VECTOR_SEARCH(
    TABLE vector_search.norfolk_buildings,
    'geom_vector',
    (
      SELECT
        geom_vector
      FROM
        vector_search.norfolk_buildings
      WHERE id = '56873794-9873-4fe1-871a-5987bb3a0efb'
    ),
    top_k => 10,
    distance_type => 'EUCLIDEAN',
    options => '{"fraction_lists_to_search":0.1}')
בחלונית Query results, לוחצים על הכרטיסייה Visualization. במפה מוצגת קבוצה של צורות של מבנים שקרובים למבנה העוגן:
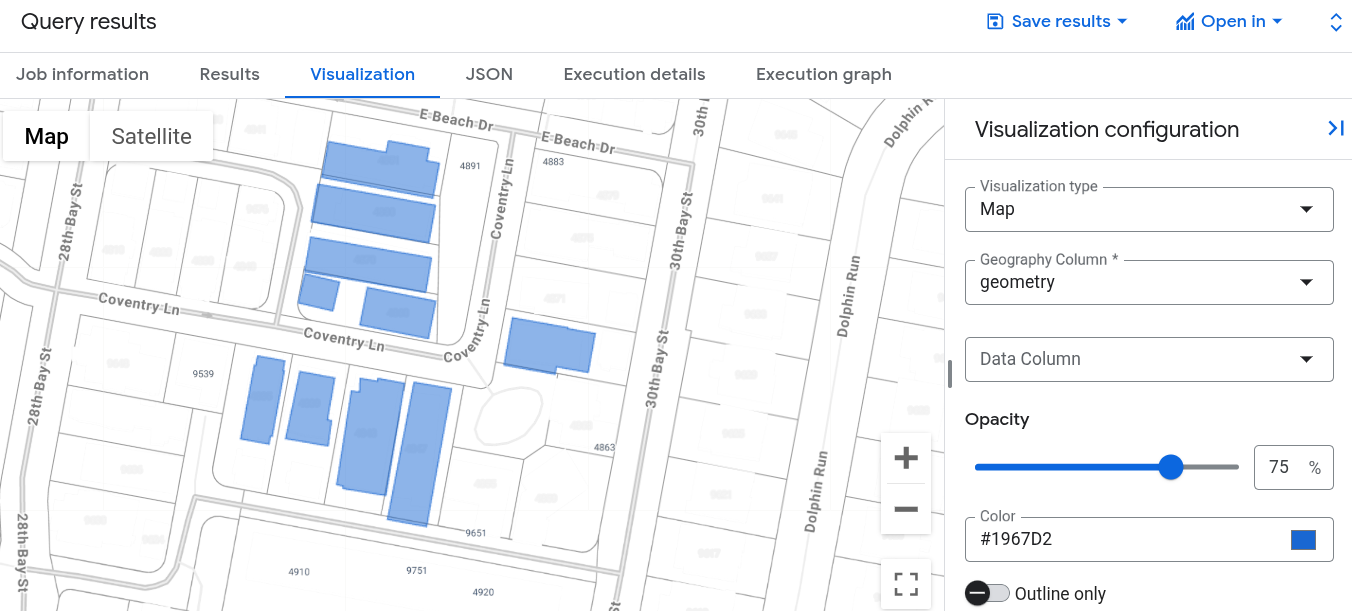
כשמריצים את השאילתה הזו במסוף Cloud de Confiance , לוחצים על Job Information ומוודאים שהערך של Vector Index Usage Mode הוא FULLY_USED. זה מציין שהשאילתה משתמשת באינדקס הווקטורי building_vector_index שיצרתם קודם.
חלוקת צורות גדולות
שיטה מומלצת: מחלקים צורות גדולות באמצעות הפונקציה ST_SUBDIVIDE.
משתמשים בפונקציה ST_SUBDIVIDE כדי לפצל צורות גדולות או מחרוזות של קווים ארוכים לצורות קטנות יותר.
המאמרים הבאים
- איך משתמשים במערכות רשת לניתוח מרחבי
- מידע נוסף על פונקציות גיאוגרפיות ב-BigQuery
- איך מנהלים אינדקסים וקטוריים
- מידע נוסף על שיטות מומלצות להוספה לאינדקס מרחבי ולאשכולות ב-BigQuery
- במאמר תחילת העבודה עם ניתוח נתונים גיאו-מרחביים תוכלו לקרוא מידע נוסף על ניתוח נתונים גיאו-מרחביים והצגתם ב-BigQuery.