

Anda dapat menjelajahi hasil kueri menggunakan sel SQL atau sel kode di notebook BigQuery Colab Enterprise.
Dalam tutorial ini, Anda akan mengkueri data dari set data publik BigQuery dan menjelajahi hasil kueri di notebook.
Tujuan
- Membuat dan menjalankan kueri di BigQuery.
- Menjelajahi hasil kueri di notebook menggunakan sel SQL dan sel kode.
Biaya
Tutorial ini menggunakan set data yang tersedia melalui Cloud de Confiance by S3NS Program Set Data Publik. Google membayar penyimpanan set data ini dan memberikan akses publik ke data tersebut. Anda akan dikenai biaya untuk kueri yang Anda lakukan pada data. Untuk informasi selengkapnya, lihat harga BigQuery.
Sebelum memulai
-
Di konsol Cloud de Confiance , pada halaman pemilih project, pilih atau buat project Cloud de Confiance .
Peran yang diperlukan untuk memilih atau membuat project
- Memilih project: Memilih project tidak memerlukan peran IAM tertentu—Anda dapat memilih project apa pun yang perannya telah diberikan kepada Anda.
-
Membuat project: Untuk membuat project, Anda memerlukan peran Project Creator
(
roles/resourcemanager.projectCreator), yang berisi izinresourcemanager.projects.create. Pelajari cara memberikan peran.
-
Pastikan penagihan diaktifkan untuk project Cloud de Confiance Anda.
-
Aktifkan BigQuery API, jika belum diaktifkan.
Peran yang diperlukan untuk mengaktifkan API
Untuk mengaktifkan API, Anda memerlukan izin
serviceusage.services.enable. Jika Anda membuat project, kemungkinan Anda sudah memiliki izin ini melalui peran Pemilik (roles/owner). Jika tidak, Anda bisa mendapatkan izin ini melalui peran Service Usage Admin (roles/serviceusage.serviceUsageAdmin). Pelajari cara memberikan peran.Untuk project baru, BigQuery diaktifkan secara otomatis.
Menetapkan region default untuk aset kode
Semua aset kode baru di project Cloud de Confiance Anda menggunakan region default. Setelah aset dibuat, Anda tidak dapat mengubah regionnya.
Untuk menetapkan region default bagi aset kode baru, lakukan hal berikut:
Buka halaman BigQuery.
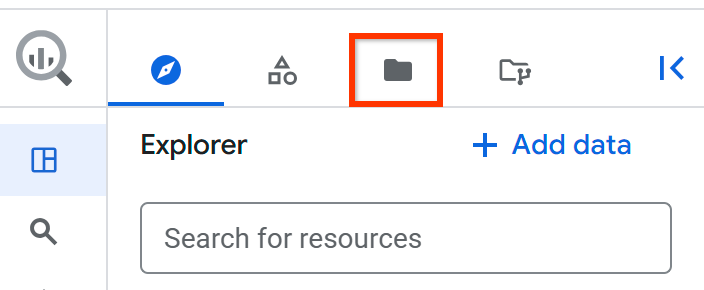
Di panel kiri, klik Files untuk membuka file browser:
Di samping nama project, klik View files panel actions > Switch code region.
Pilih wilayah kode yang ingin Anda gunakan sebagai default.
Klik Simpan.
Untuk mengetahui daftar region yang didukung, lihat Lokasi BigQuery Studio.
Izin yang diperlukan
Untuk membuat dan menjalankan notebook, Anda memerlukan peran Identity and Access Management (IAM) berikut:
- Pengguna BigQuery (
roles/bigquery.user) - Pengguna Runtime Notebook (
roles/aiplatform.notebookRuntimeUser) - Pembuat Kode (
roles/dataform.codeCreator)
Membuka hasil kueri di notebook
Anda dapat menjalankan kueri SQL, lalu menggunakan notebook untuk menjelajahi data. Pendekatan ini berguna jika Anda ingin mengubah data di BigQuery sebelum menanganinya, atau jika Anda hanya memerlukan subset kolom dalam tabel.
Di konsol Cloud de Confiance , buka halaman BigQuery.
Di panel kiri, klik Explorer.
Buka project
bigquery-public-data, klik Toggle node untuk meluaskannya, lalu klik Datasets. Tab baru akan terbuka di panel detail yang menampilkan daftar semua set data dalam project.Di kotak Filter , pilih Dataset ID dan masukkan ml_datasets.
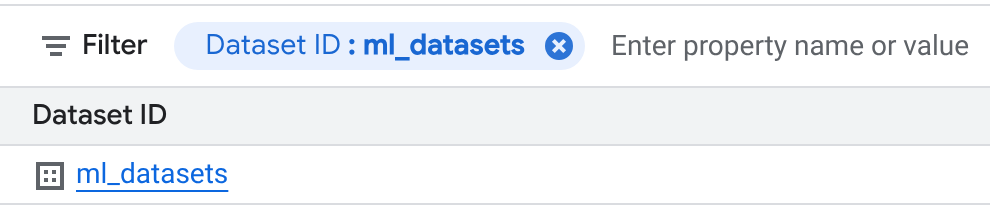
Di halaman Datasets, klik ml_datasets > penguins.
Klik Query.
Tambahkan tanda bintang (
*) untuk pemilihan kolom ke kueri yang dihasilkan, sehingga terlihat seperti contoh berikut:SELECT * FROM `bigquery-public-data.ml_datasets.penguins` LIMIT 1000;
Klik Run.
Di bagian Query results, klik Open in, lalu klik Notebook.
Menyiapkan notebook untuk digunakan
Siapkan notebook untuk digunakan dengan menghubungkan ke runtime dan menetapkan nilai default aplikasi.
Di header notebook, klik Connect untuk terhubung ke runtime default.
Di blok kode Setup, klik Run cell.
Menjelajahi data
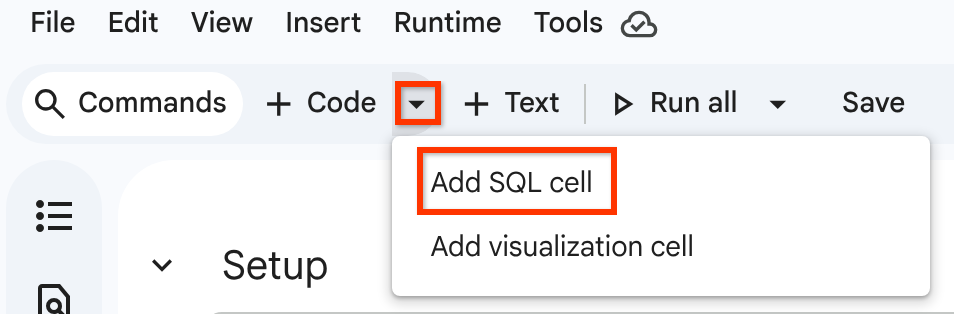
Klik Insert code cell options > Add SQL cell.
Masukkan kueri berikut di sel SQL:
SELECT * FROM `bigquery-public-data.ml_datasets.penguins` LIMIT 1000;Klik Run cell.
Hasil kueri ditampilkan dalam DataFrame BigQuery.
Atau, untuk memuat hasil kueri ke dalam DataFrame BigQuery menggunakan tugas kueri yang sebelumnya Anda jalankan di editor kueri, ikuti langkah-langkah berikut:
Buka bagian Result set loaded from BigQuery job as a DataFrame.
Di blok kode, klik Run cell.
Hasil kueri ditampilkan dalam BigQuery DataFrame.
Untuk mendapatkan metrik deskriptif untuk data, ikuti langkah-langkah berikut:
Buka bagian Show descriptive statistics using describe().
Di blok kode, klik Run cell.
Hasilnya ditampilkan dalam BigQuery DataFrame.
Opsional: Gunakan fungsi atau paket Python lainnya untuk mengeksplorasi dan menganalisis data.
Contoh berikut menggunakan
bigframes.pandas
untuk menganalisis data, dan bigframes.ml
untuk membuat model regresi linear dari data penguins di
BigQuery DataFrame. Contoh ini menghitung skor R2 model dan menampilkannya sebagai tabel metrik statistik. Tindakan ini tidak akan membuat diagram.
Pembersihan
Agar tidak perlu membayar biaya pada akun Google Cloud Anda untuk resource yang digunakan dalam tutorial ini, hapus project yang berisi resource tersebut, atau simpan project dan hapus setiap resource.
Cara termudah untuk menghilangkan penagihan adalah dengan menghapus project Cloud de Confiance yang Anda buat untuk tutorial ini.
- Di konsol Cloud de Confiance , buka halaman Manage resources.
- Pada daftar project, pilih project yang ingin Anda hapus, lalu klik Delete.
- Pada dialog, ketik project ID, lalu klik Shut down untuk menghapus project.
Langkah berikutnya
- Pelajari lebih lanjut cara membuat notebook di BigQuery.
- Pelajari lebih lanjut cara mengeksplorasi data dengan BigQuery DataFrames.