

Puoi esplorare i risultati delle query utilizzando le celle SQL o le celle di codice nei notebook di BigQuery Colab Enterprise.
In questo tutorial, eseguirai query sui dati di un set di dati pubblico BigQuery ed esplorerai i risultati delle query in un notebook.
Obiettivi
- Crea ed esegui una query in BigQuery.
- Esplora i risultati delle query in un notebook utilizzando celle SQL e celle di codice.
Costi
Questo tutorial utilizza un set di dati disponibile tramite il programma per i set di dati pubblici diCloud de Confiance by S3NS . Google paga per l'archiviazione di questi set di dati e fornisce l'accesso pubblico ai dati. Ti vengono addebitati i costi per le query che esegui sui dati. Per ulteriori informazioni, consulta i prezzi di BigQuery.
Prima di iniziare
-
Nella console Cloud de Confiance , nella pagina di selezione del progetto, seleziona o crea un progetto Cloud de Confiance .
Ruoli richiesti per selezionare o creare un progetto
- Seleziona un progetto: la selezione di un progetto non richiede un ruolo IAM specifico. Puoi selezionare qualsiasi progetto per cui ti è stato concesso un ruolo.
-
Crea un progetto: per creare un progetto, devi disporre del ruolo Autore progetto (
roles/resourcemanager.projectCreator), che contiene l'autorizzazioneresourcemanager.projects.create. Scopri come concedere i ruoli.
-
Verifica che la fatturazione sia attivata per il tuo progetto Cloud de Confiance .
-
Abilita l'API BigQuery, se non è già abilitata.
Ruoli richiesti per abilitare le API
Per abilitare le API, devi disporre dell'autorizzazione
serviceusage.services.enable. Se hai creato il progetto, probabilmente disponi già di questa autorizzazione tramite il ruolo Proprietario (roles/owner). In caso contrario, puoi ottenere questa autorizzazione tramite il ruolo Amministratore Service Usage (roles/serviceusage.serviceUsageAdmin). Scopri come concedere i ruoli.Per i nuovi progetti, BigQuery viene abilitato automaticamente.
Imposta la regione predefinita per gli asset di codice
Tutti i nuovi asset di codice nel tuo progetto Cloud de Confiance utilizzano una regione predefinita. Dopo la creazione dell'asset, non puoi modificarne la regione.
Per impostare la regione predefinita per i nuovi asset di codice, segui questi passaggi:
Vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su File per aprire il browser di file:
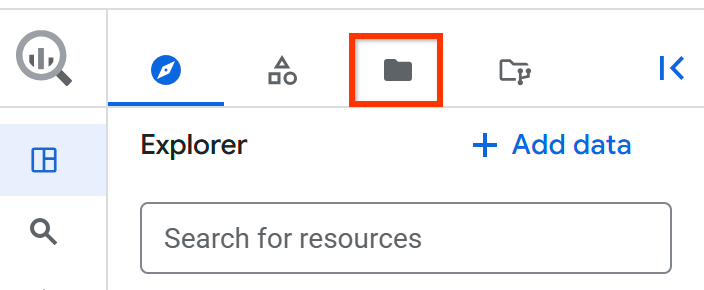
Accanto al nome del progetto, fai clic su Visualizza azioni del riquadro dei file > Cambia regione del codice.
Seleziona la regione del codice che vuoi utilizzare come predefinita.
Fai clic su Salva.
Per un elenco delle regioni supportate, consulta Località di BigQuery Studio.
Autorizzazioni obbligatorie
Per creare ed eseguire i blocchi note, devi disporre dei seguenti ruoli IAM (Identity and Access Management):
- BigQuery User (
roles/bigquery.user) - Notebook Runtime User (
roles/aiplatform.notebookRuntimeUser) - Code Creator (
roles/dataform.codeCreator)
Apri i risultati della query in un notebook
Puoi eseguire una query SQL e poi utilizzare un notebook per esplorare i dati. Questo approccio è utile se vuoi modificare i dati in BigQuery prima di utilizzarli o se hai bisogno solo di un sottoinsieme dei campi della tabella.
Nella console Cloud de Confiance , vai alla pagina BigQuery.
Nel riquadro a sinistra, fai clic su Explorer.
Vai al progetto
bigquery-public-data, fai clic su Attiva/disattiva nodo per espanderlo, quindi fai clic su Set di dati. Nel riquadro dei dettagli si apre una nuova scheda che mostra un elenco di tutti i set di dati del progetto.Nella casella Filtro, scegli ID set di dati e inserisci ml_datasets.
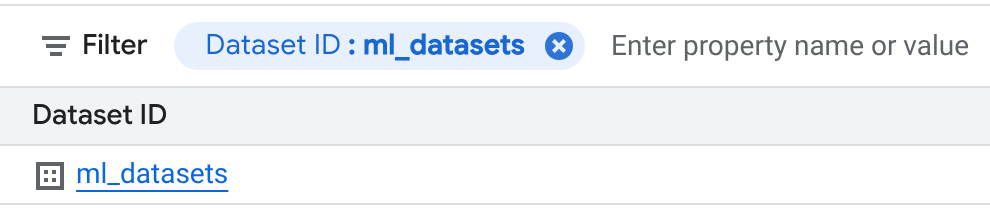
Nella pagina Set di dati, fai clic su ml_datasets > penguins.
Fai clic su Query.
Aggiungi un asterisco (
*) per la selezione dei campi alla query generata, in modo che assomigli al seguente esempio:SELECT * FROM `bigquery-public-data.ml_datasets.penguins` LIMIT 1000;
Fai clic su Esegui.
Nella sezione Risultati delle query, fai clic su Apri in e poi su Notebook.
Prepara il notebook per l'uso
Prepara il notebook per l'utilizzo connettendoti a un runtime e impostando i valori predefiniti dell'applicazione.
Nell'intestazione del notebook, fai clic su Connetti per connetterti al runtime predefinito.
Nel blocco di codice Setup, fai clic su Esegui cella.
esplora i dati
Fai clic su Opzioni di inserimento cella di codice > Aggiungi cella SQL.
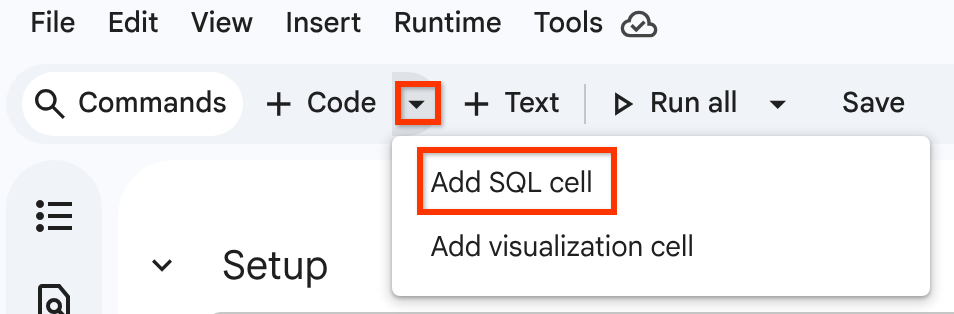
Inserisci la seguente query nella cella SQL:
SELECT * FROM `bigquery-public-data.ml_datasets.penguins` LIMIT 1000;Fai clic su Esegui cella.
I risultati della query vengono visualizzati in un DataFrame BigQuery.
In alternativa, per caricare i risultati della query in un DataFrame BigQuery utilizzando il job di query eseguito in precedenza nell'editor di query, segui questi passaggi:
Vai alla sezione Result set loaded from BigQuery job as a DataFrame.
Nel blocco di codice, fai clic su Esegui cella.
I risultati della query vengono visualizzati in un DataFrame BigQuery.
Per ottenere metriche descrittive per i dati, segui questi passaggi:
Vai alla sezione Mostra le statistiche descrittive utilizzando describe().
Nel blocco di codice, fai clic su Esegui cella.
I risultati vengono visualizzati in un DataFrame BigQuery.
(Facoltativo) Utilizza altre funzioni o pacchetti Python per esplorare e analizzare i dati.
L'esempio seguente utilizza
bigframes.pandas
per analizzare i dati e bigframes.ml
per creare un modello di regressione lineare dai dati penguins in un
BigQuery DataFrame. Questo esempio calcola il punteggio R2 del modello e lo restituisce come tabella di metriche statistiche. Non genera un grafico.
Esegui la pulizia
Per evitare che al tuo account Google Cloud vengano addebitati costi relativi alle risorse utilizzate in questo tutorial, elimina il progetto che contiene le risorse oppure mantieni il progetto ed elimina le singole risorse.
Il modo più semplice per eliminare la fatturazione è eliminare il progetto Cloud de Confiance che hai creato per questo tutorial.
- Nella console Cloud de Confiance , vai alla pagina Gestisci risorse.
- Nell'elenco dei progetti, seleziona il progetto che vuoi eliminare, quindi fai clic su Elimina.
- Nella finestra di dialogo, digita l'ID progetto, quindi fai clic su Chiudi per eliminare il progetto.
Passaggi successivi
- Scopri di più sulla creazione di notebook in BigQuery.
- Scopri di più sull'esplorazione dei dati con BigQuery DataFrames.