

Planifica una migración con el linaje de migración
Puedes usar el servicio de linaje de migración para visualizar el flujo de datos y las conexiones en tu base de datos de origen cuando planificas una migración de almacén de datos de BigQuery.
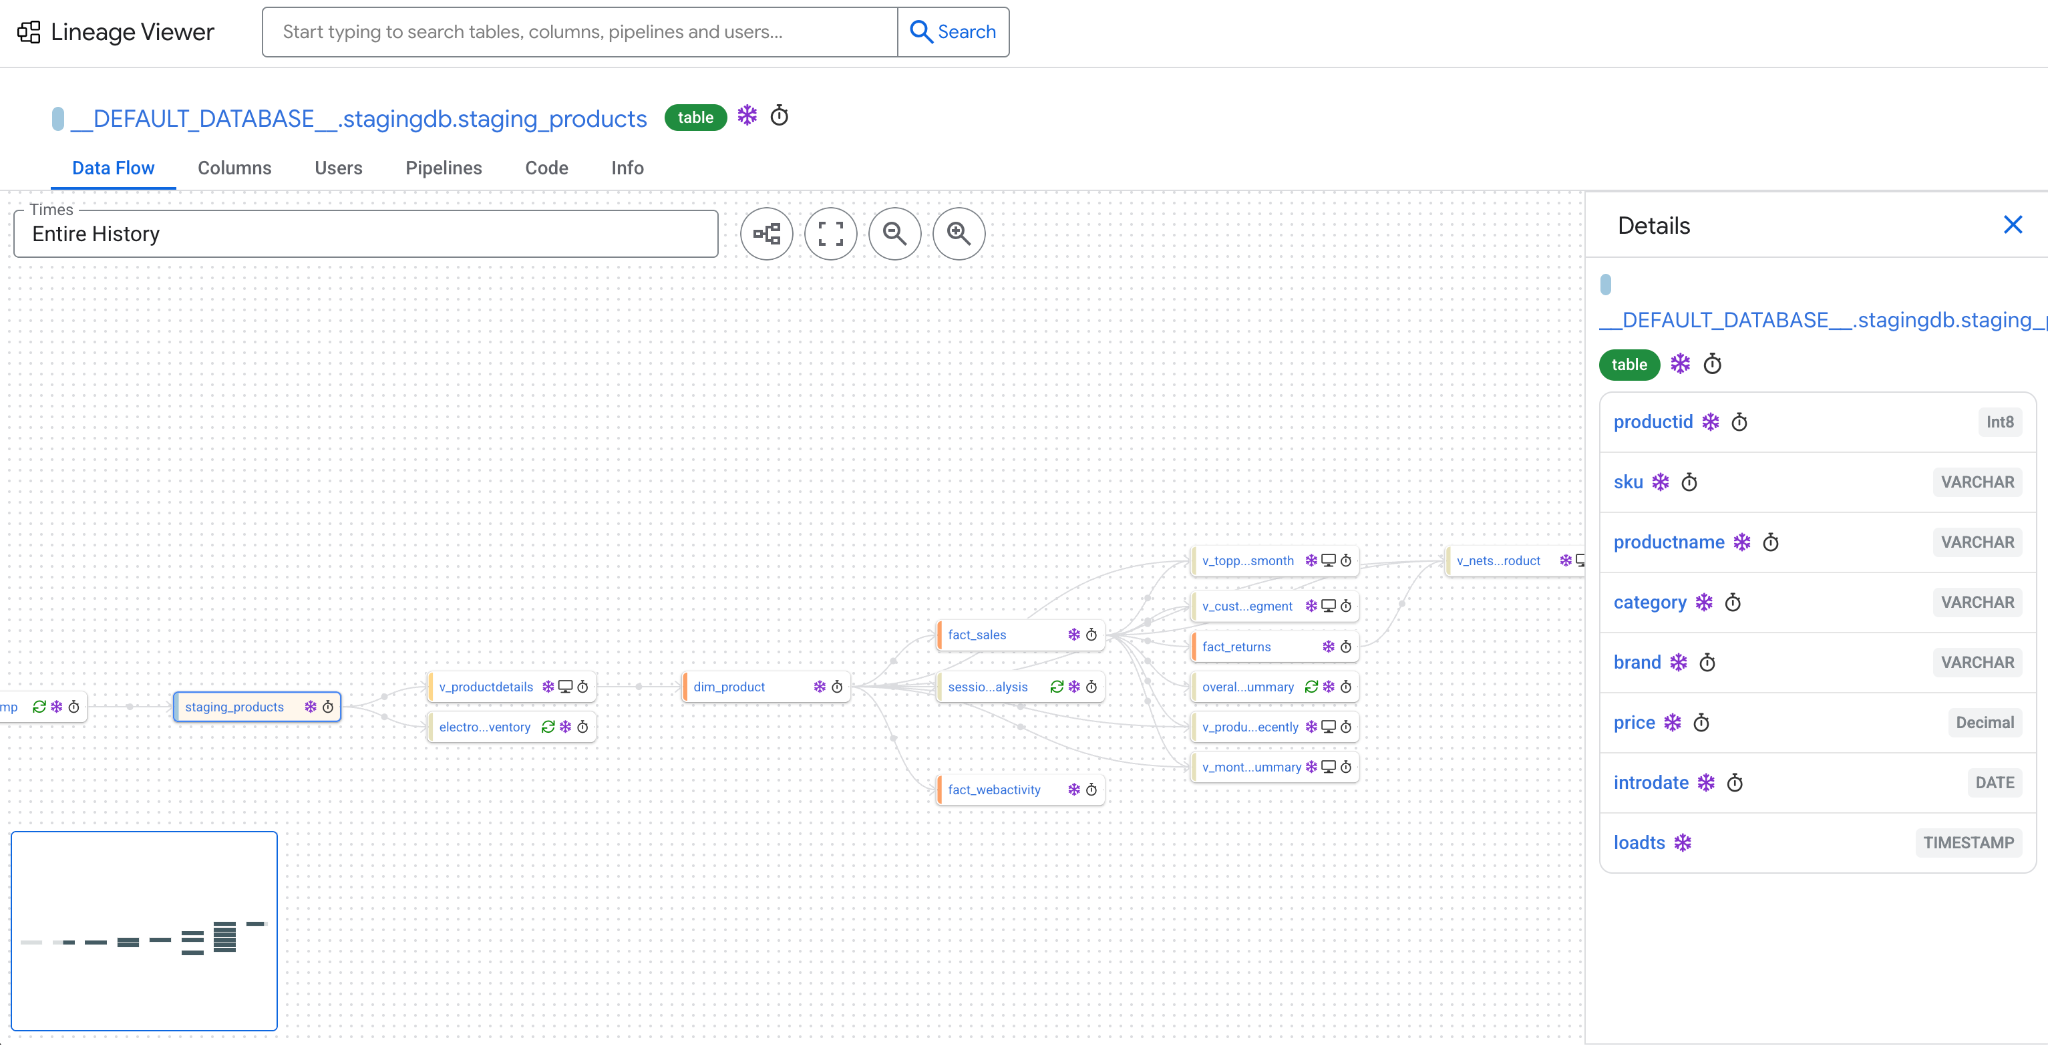
Cuando creas un linaje de migración, el servicio de linaje proporciona un gráfico que visualiza cómo se mueven los datos a través de tu sistema de origen y cómo se conecta cada tabla o vista en tu sistema de origen, como se muestra en el siguiente diagrama:
El servicio de linaje de migración admite los siguientes dialectos de SQL:
- SQL de Amazon Redshift
- SQL de Snowflake
- SQL de Teradata
- GoogleSQL (BigQuery)
Limitaciones
El servicio de linaje procesa los primeros 5 GB de los registros más antiguos de tu base de datos de origen.
Ubicaciones admitidas
El servicio de linaje de migración está disponible en ubicaciones seleccionadas. Para obtener más información, consulta Ubicaciones del servicio de linaje y traductor de SQL de BigQuery.
Permisos necesarios
Para obtener los permisos que
necesitas para usar el servicio de linaje de migración,
pídele a tu administrador que te otorgue el rol de IAM de
editor de MigrationWorkflow (roles/bigquerymigration.editor) en el proyecto.
Para obtener más información sobre cómo otorgar roles, consulta Administra el acceso a proyectos, carpetas y organizaciones.
Este rol predefinido contiene los permisos necesarios para usar el servicio de linaje de migración. Para ver los permisos exactos que son necesarios, expande la sección Permisos requeridos:
Permisos necesarios
Se requieren los siguientes permisos para usar el servicio de linaje de migración:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.lineageDbs.query
También puedes obtener estos permisos con roles personalizados o con otros roles predefinidos.
Para obtener más información sobre los roles y los permisos de IAM en BigQuery, consulta Roles y permisos de IAM de BigQuery.
Realiza un seguimiento del linaje de una migración
Para hacer un seguimiento del linaje de una migración, primero ejecuta la herramienta dwh-migration-dumper para
generar archivos de registro de SQL de entrada de origen que subes a Cloud Storage.
Después de subir los archivos de entrada a Cloud Storage, puedes hacer un seguimiento del
linaje de migración con la consola de Cloud de Confiance o la API de BigQuery Migration.
Ejecuta la herramienta dwh-migration-dumper
Selecciona una de las siguientes opciones:
Amazon Redshift
Para rastrear y ver un linaje de migración en una base de datos de Amazon Redshift, haz lo siguiente:
- Ejecuta la herramienta
dwh-migration-dumperpara generar un volcado de los archivos del sistema de origen. - Sube los registros de consultas a Cloud Storage.
Snowflake
Para hacer un seguimiento y ver un linaje de migración en una base de datos de Snowflake, haz lo siguiente:
- Ejecuta la herramienta
dwh-migration-dumperpara generar un volcado de los archivos del sistema de origen. - Sube los registros de consultas a Cloud Storage.
Teradata
Para hacer un seguimiento y ver un linaje de migración en una base de datos de Teradata, haz lo siguiente:
- Ejecuta la herramienta
dwh-migration-dumperpara generar un volcado de los archivos del sistema de origen. - Sube los registros de consultas a Cloud Storage.
BigQuery
Para rastrear y ver un linaje de migración en una base de datos de BigQuery, haz lo siguiente:
- Otorga a la cuenta o cuenta de servicio los siguientes roles:
- Visualizador de metadatos de BigQuery (
roles/bigquery.metadataViewer) - Visualizador de Data Catalog (
roles/datacatalog.viewer)
- Visualizador de metadatos de BigQuery (
- Instala la herramienta de
dwh-migration-dumper. Para generar metadatos y registros de consultas, ejecuta la herramienta de
dwh-migration-dumper. Estos metadatos y registros de consultas se encuentran en uno o más archivos ZIP.dwh-migration-dumper --connector bigquery dwh-migration-dumper --connector bigquery-logs
Sube los archivos ZIP a un bucket de Cloud Storage. Para obtener más información sobre la creación de buckets y la carga de archivos a Cloud Storage, consulta Crea un bucket y Sube objetos desde un sistema de archivos.
Seguir el linaje
Después de subir los archivos ZIP que contienen los metadatos y los registros de consultas a Cloud Storage, puedes hacer un seguimiento del linaje. Selecciona una de las siguientes opciones:
Console
Ve a la página Tus servicios de migración.
En Seguir el linaje, haz clic en Seguir traducción.
En Configuración del linaje, ingresa lo siguiente:
- En Nombre visible, especifica un nombre para el trabajo de linaje. El nombre puede contener letras, números o guiones bajos.
- En Ubicación de procesamiento, selecciona la ubicación en la que deseas que se ejecute el trabajo de linaje.
En Editar ubicación del directorio de entrada, especifica la ruta de acceso a la carpeta de Cloud Storage que contiene los archivos ZIP de registro que subiste antes. Puedes escribir la ruta en el formato
bucket_name/folder_name/o hacer clic en Explorar. También puedes asignar un nombre al subdirectorio de tus archivos de salida en el campo Nombre del subdirectorio de salida.Para agregar más archivos de entrada, haz clic en Agregar una ubicación del directorio de entrada.
Haz clic en Seguimiento.
El trabajo de linaje ya se está ejecutando. El trabajo puede tardar varias horas en completarse según el tamaño de la entrada. Una vez que se completa el trabajo, la herramienta proporciona un vínculo al linaje de migración rastreado.
API
Para hacer un seguimiento de un trabajo de linaje, ejecuta el siguiente comando de curl:
  curl -d "{
    \"tasks\": {
      \"TASK_NAME\": {
        \"type\": \"Experimental_Lineage\",
        \"translation_details\": {
          \"target_base_uri\": \"BUCKET_PATH\",
          \"source_target_mapping\": {
            \"source_spec\": {
              \"base_uri\": \"BUCKET_PATH\"
            }
          },
          \"target_types\": \"LINEAGE\"
        }
      }
    }
  }
  " \
    -H "Content-Type:application/json" \
    -H "Authorization: Bearer TOKEN" -X POST https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows
Reemplaza lo siguiente:
TASK_NAME: Es un nombre para identificar este trabajo de linaje.BUCKET_PATH: Es la ruta de acceso al bucket de Cloud Storage que contiene tus archivos ZIP de entrada.PROJECT_ID: Es el ID del proyecto de Cloud de Confiance .LOCATION: Es una ubicación de procesamiento. Este valor debe sereuous.
Esta llamada devuelve un mensaje similar al siguiente:
  {
    "name": "projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID",
    "tasks": {
      "task_name": { /*...*/ }
    },
    "state": "RUNNING"
  }
El trabajo de linaje ya se está ejecutando. El trabajo puede tardar varias horas en
completarse según el tamaño de la entrada. Para verificar el estado del trabajo de linaje,
ejecuta el siguiente comando de curl con el ID del flujo de trabajo:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Una vez que se completa el trabajo, la herramienta proporciona un vínculo a la vista de linaje rastreado.
Abre el linaje de migración
Después de trazar un linaje de migración, puedes abrirlo con una de las siguientes opciones:
Console
Ve a la página Tus servicios de migración.
En Seguimiento del linaje, haz clic en Ver recientes.
En la página Linaje de migración, haz clic en el nombre del trabajo para seleccionar el trabajo de linaje completo.
En la página Detalles de la traducción, haz clic en Linaje de datos.
API
Para abrir un linaje de migración completado, ejecuta el siguiente comando de curl con
la API de BigQuery Migration:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
Reemplaza lo siguiente:
PROJECT_ID: Es el ID del proyecto de Cloud de Confiance .LOCATION: Es una ubicación de procesamiento. Este valor debe sereuous.WORKFLOW_ID: Es el ID del flujo de trabajo del linaje registrado.
Navega al vínculo incluido en el campo taskResult.translationTaskResult.consoleUri del mensaje de salida.
Trabaja con el linaje de migración
En las siguientes secciones, se describen las formas en que puedes usar el linaje de migración para trabajar con tus datos y base de datos de origen.
Comprende los términos del linaje de migración
Los siguientes términos se usan en un linaje de migración:
| Condiciones | Descripción |
|---|---|
| Secuencias de comandos | Secuencias de comandos de SQL y otros programas que son visibles en los registros de la base de datos transferidos durante la compilación del linaje. Las secuencias de comandos se componen de instrucciones, que, por lo general, son instrucciones de SQL individuales. |
| Nodos | Son los vértices del gráfico de linaje. Estas consisten en tablas y columnas. |
| Tablas | También se denominan relaciones, incluidas las tablas comunes, las vistas, los archivos estructurados y otros recursos similares a tablas. |
| Columnas | También se denominan atributos, incluidas las columnas de tablas, las proyecciones de vistas, las seudocolumnas, los campos similares a columnas en archivos y otros recursos, y las subcolumnas, como los campos de structs. |
| Conexiones de integración | Son conexiones entre nodos de linaje que indican interacciones debido a que una canalización ejecuta una secuencia de comandos que leyó o escribió esos nodos. Los bordes se anotan con marcas de tiempo, predicados y otros metadatos de cuando se derivó el borde. Un nodo que es adyacente a otro nodo con un borde se denomina conexión directa; una ruta de bordes entre dos nodos se denomina conexión indirecta. |
| Bordes de linaje | Son bordes direccionales que indican que el nodo de origen
se incluyó en una cláusula, como FROM,
WHERE o GROUP BY, que influyó en los
datos del nodo de destino. |
| Usuarios y canalizaciones | Son las etiquetas de metadatos que proporciona la base de datos de origen sobre quién y qué ejecutó las secuencias de comandos. No tienen un significado inherente para el motor de linaje, pero se usan para agrupar secuencias de comandos por origen. |
En las siguientes secciones, se describen las diferentes páginas de un linaje de migración.
Revisa la página de destino
En la página de destino del linaje de migración, se muestra el ID del trabajo de linaje, un campo de búsqueda para ubicar objetos de linaje por nombre y una lista de sugerencias en la que se destacan algunos objetos de linaje que podrían ser de interés. En la página, también se incluyen los recuentos totales de tablas, canalizaciones y usuarios en todo el linaje de migración.
Para navegar a una tabla, vista o columna en particular, busca el objeto en el campo de búsqueda o haz clic en uno de los objetos sugeridos en la página de destino.
Revisa la página del nodo
Para revisar los nodos en tu linaje de migración, haz clic en una de las siguientes pestañas.
Pestaña Flujo de datos
En la pestaña Flujo de datos, se muestra una representación visual de una parte del gráfico de linaje. Es la página predeterminada cuando ves una tabla o columna por primera vez en el servicio de linaje. En el gráfico, se visualiza cómo se mueven los datos a través del sistema de origen. Los nodos de este gráfico representan tablas o vistas, mientras que los bordes entre los nodos representan los datos que fluyen de los nodos de la izquierda hacia los nodos de la derecha.
Cada tabla del gráfico Flujo de datos muestra su nombre no calificado. Para ver el nombre completamente calificado de una tabla con el prefijo de la base de datos y del esquema, mantén el puntero sobre el nodo para mostrar su información sobre la herramienta. Cada tabla indica su esquema, como lo indica la barra vertical en el nodo. Todos los esquemas del linaje se ordenan alfabéticamente y se les asigna un color, por lo que las tablas del mismo esquema tienen las mismas barras de color, y las tablas de esquemas con nombres similares tienen barras de color similares.
Cada nodo muestra un ícono que indica sus propiedades:
- monitor: Es una vista, no una tabla.
- cached: Es una tabla que siempre se actualiza por completo (se trunca y, luego, se vuelve a escribir). Haz clic en el ícono para ver las secuencias de comandos adyacentes a esta tabla.
- cached: Es una tabla que no siempre se actualiza por completo (se trunca y, luego, se vuelve a escribir). Haz clic en el ícono para ver las secuencias de comandos adyacentes a esta tabla.
- timer: Es una tabla que duró poco tiempo. Mantén el puntero sobre el ícono para ver la duración de la tabla.
- copo de nieve: Es una tabla que se escribió por última vez hace más de siete días, lo que sugiere una tabla con datos estáticos o que se escriben con poca frecuencia.
Para revisar los objetos en el gráfico Flujo de datos, haz lo siguiente:
- Para ver una lista de las columnas de una tabla, haz clic en ella. Esta vista incluye el nombre de cada columna y su tipo de datos, según se determina a partir de un volcado de metadatos proporcionado o se deduce del SQL que se ve en los registros de consultas.
- Para ver el gráfico de linaje a nivel de columna de una columna, haz clic en ella. En el gráfico de linaje a nivel de columna, las aristas representan los flujos de datos que afectan a la columna de destino.
Para ver los detalles de una arista, haz clic en ella en el gráfico. Esta vista incluye vínculos a las secuencias de comandos de SQL que indujeron el borde.
Se genera un perímetro desde un nodo de origen hasta un nodo de destino cuando una instrucción de SQL hace referencia al nodo de origen mientras la sentencia calcula los datos que se insertan en el nodo de destino. Por lo general, esto implica la transferencia de datos desde el origen hasta el destino, pero la pestaña Flujo de datos también muestra un perímetro cuando el nodo de origen se usa en una cláusula
WHEREoGROUP BYque afecta al destino. Para filtrar solo las transferencias de datos, activa o desactiva el botón Mostrar bordes que no son de datos en la barra de herramientas.
Pestaña Conexiones (Connections)
En la pestaña Conexiones de un nodo de linaje, se muestra una lista de los nodos cercanos en el gráfico de linaje. De forma predeterminada, los nodos conectados se ordenan según la distancia de la ruta más corta desde el nodo actual; los nodos que requieren menos bordes para llegar desde el nodo actual se enumeran primero. Puedes cambiar el orden con la opción Ordenar.
La lista de conexiones incluye los nodos ascendentes (productor) y descendentes (consumidor) del nodo actual de forma predeterminada. Puedes cambiar este filtro con el control Tipo. En la columna Distancia, los nodos que están upstream del nodo actual se muestran con una flecha que apunta hacia arriba con la distancia de la ruta de datos de regreso más corta a ese nodo desde el nodo actual. Del mismo modo, los nodos que están downstream del nodo actual se muestran con una flecha que apunta hacia abajo con la distancia de la ruta de datos de ida más corta a ese nodo desde el nodo actual. Un nodo puede ser ascendente y descendente del nodo actual si forma parte de un ciclo.
Para descargar un archivo que contenga todos los nodos que se muestran, haz clic en Descargar CSV.
Pestaña Usuarios
En la pestaña Usuarios de un nodo, se muestran los usuarios que ejecutaron secuencias de comandos que leyeron o escribieron el nodo o los nodos que están upstream o downstream de él. De forma predeterminada, el usuario que realizó la mayor cantidad de acciones independientes aparece primero. Puedes cambiar el orden con la opción Ordenar.
Para descargar un archivo que contenga todos los usuarios que se muestran, haz clic en Descargar CSV.
Pestaña Canalizaciones
En la pestaña Canalizaciones de un nodo, se muestran las canalizaciones que ejecutaron secuencias de comandos que leyeron o escribieron el nodo o los nodos que están upstream o downstream de él. De forma predeterminada, la canalización que realizó la mayor cantidad de acciones independientes aparece primero. Puedes cambiar la clasificación con la opción Ordenar.
Para descargar un archivo que contenga todas las canalizaciones que se muestran, haz clic en Descargar CSV.
Pestaña Código
En la pestaña Código de un nodo, se muestran todas las secuencias de comandos de SQL que se ven en los archivos de entrada que leyeron o escribieron datos en ese nodo. Las menciones del nodo se destacan en el texto de SQL. Haz clic en un guion para expandir el texto completo. Puedes cambiar la configuración del filtro para filtrar la lista de secuencias de comandos que se muestran.
Para descargar un archivo que contenga todas las secuencias de comandos que se muestran, haz clic en descargar CSV.
Revisa la página de Edge
Para revisar los bordes de los nodos en tu gráfico de linaje, haz clic en una de las siguientes pestañas.
Pestaña Detalles (Details)
En la pestaña Detalles de una arista, se muestran los predicados y las categorías, que describen las operaciones que realizan las secuencias de comandos que indujeron la arista.
Los predicados se indican como códigos de tres partes separados por guiones. La primera parte
es r, que indica que la fuente de la arista es una relación, o a,
que indica que la fuente de la arista es un atributo. La segunda parte es una
de las siguientes abreviaturas que indica la forma en que el nodo de origen influyó
en los datos del nodo de destino:
has: La relación de origen contiene el atributo de destino.dat: la fuente copia o transfiere datos al destino.res: El origen filtra o restringe la cardinalidad del destino en una cláusula comoWHERE,HAVINGoJOIN ON.grp: La fuente se usa en una cláusulaGROUP BYque afecta al destino.
La tercera parte también es r o a, lo que indica si el destino de la
arista es una relación o un atributo.
Las categorías de Edge pueden incluir lo siguiente:
- Predicados de
dat:AGGREGATE: La fuente se usó en un cálculo agregado que escribió el destino.EXACT_COPY: Los datos de la fuente se copiaron en su totalidad en el destino.FUNCTION: la fuente se usó para calcular el objetivo.IDENTITY_COPY: No se calculó el objetivo. El destino era una copia literal del origen sin conversiones ni conversiones de tipos.PARTITION_PROMOTION: El destino contiene datos del origen como resultado de la promoción de una partición del origen al destino.WEAK_COPY: Los datos del origen se copiaron, al menos, de forma parcial en el destino.
- Predicados de
res:FILTER: La fuente se usó en una comparación que escribió el destino.KEY: Los datos de la fuente se usaron como clave en una comparación de unión que escribió el destino.
- Predicados de
grp:GROUP: Los datos de la fuente se usaron como clave en una cláusulaGROUP BYque afecta al destino.
Pestaña Código
La pestaña Código de un borde muestra las secuencias de comandos de SQL que indujeron ese borde. Los nodos de origen y destino del perímetro se destacan donde se mencionan en el texto de SQL.
¿Qué sigue?
- Ejecuta una evaluación de migración para analizar la viabilidad y los posibles beneficios de migrar tu almacén de datos a BigQuery.
- Usa el servicio de traducción de SQL, como el traductor de SQL interactivo, la API de Translation y el traductor de SQL por lotes para automatizar la conversión de tus consultas en SQL a GoogleSQL, incluida la personalización de SQL mejorada con Gemini.