

תכנון העברה באמצעות שושלת העברה
אתם יכולים להשתמש בשירות שושלת היוחסין של ההעברה כדי להציג את זרימת הנתונים ואת החיבורים במסד הנתונים של המקור כשאתם מתכננים העברה של מחסן נתונים ב-BigQuery.
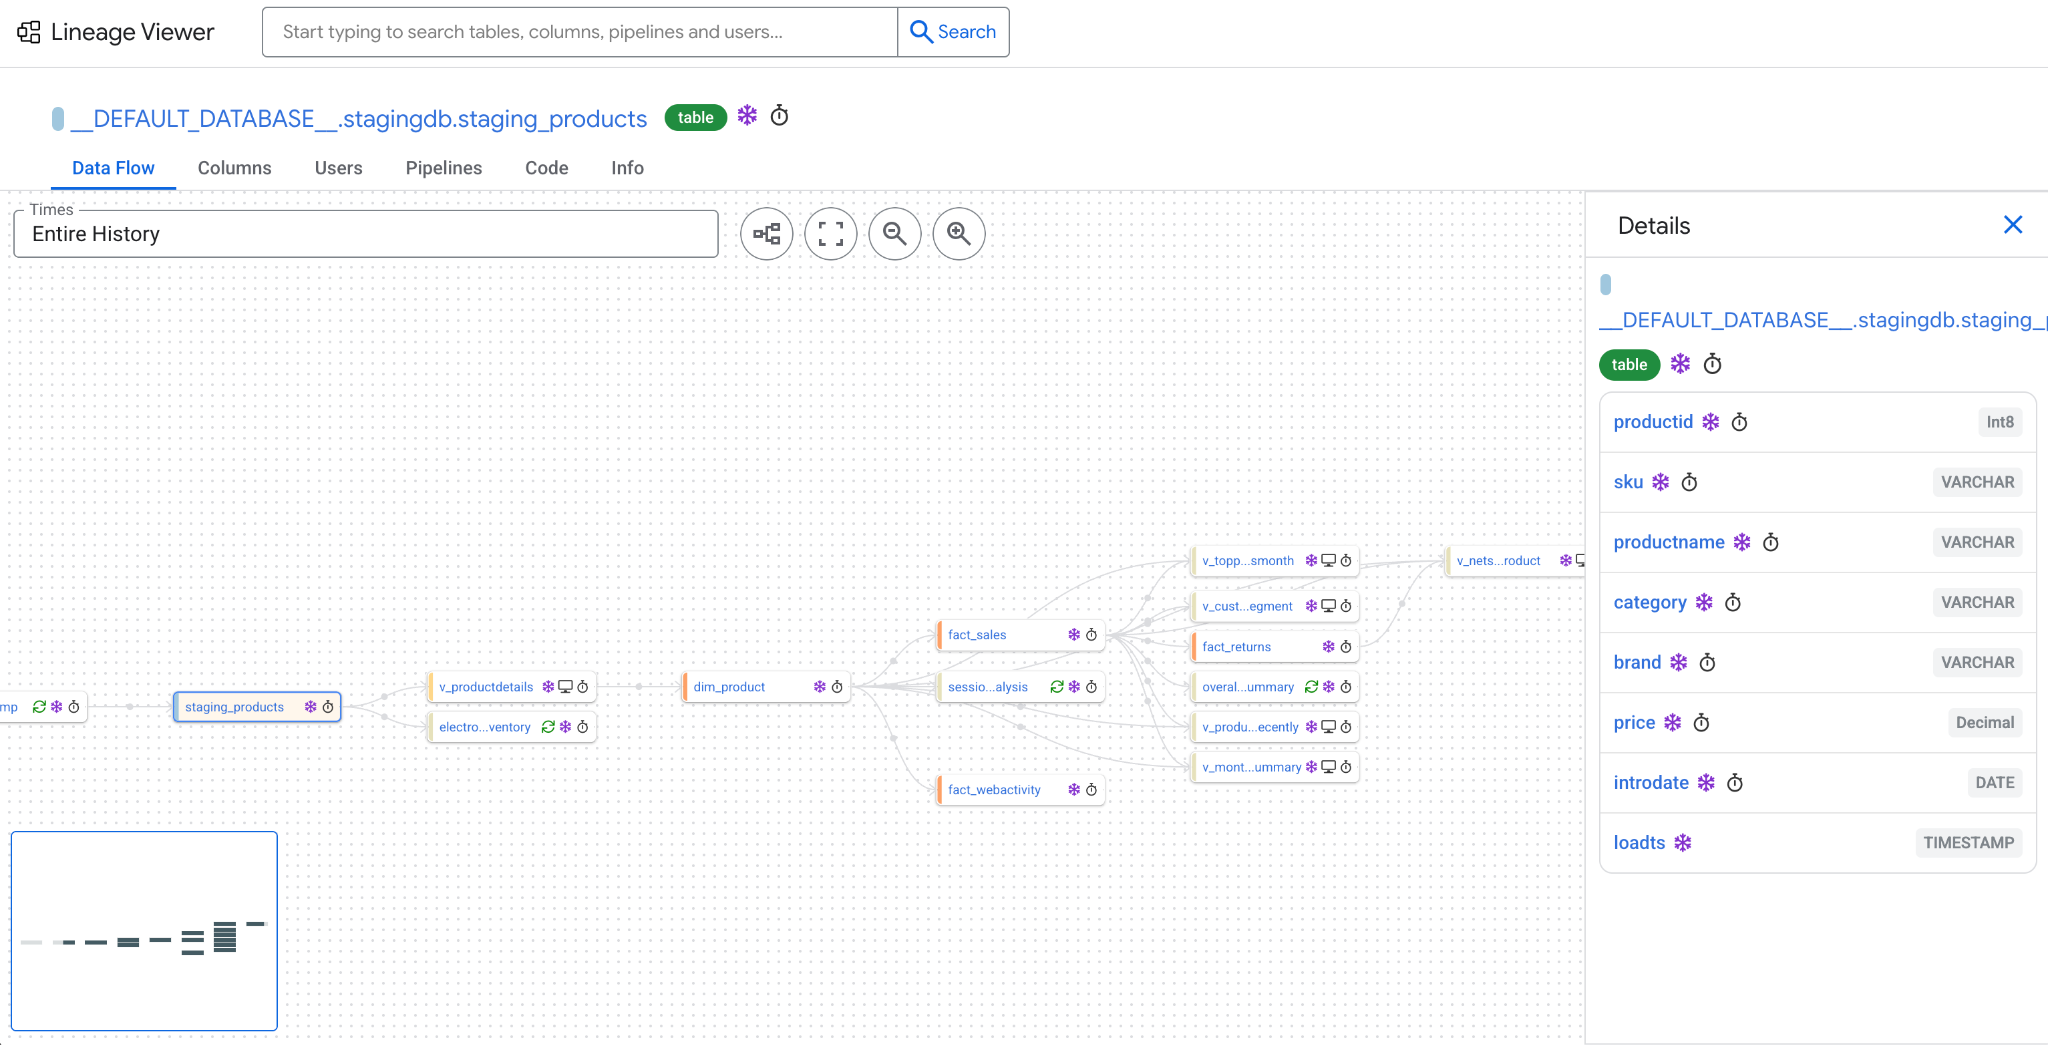
כשיוצרים שושלת נתונים של מיגרציה, שירות שושלת הנתונים מספק תרשים שממחיש איך הנתונים עוברים במערכת המקור, ואיך כל טבלה או תצוגה במערכת המקור מחוברת, כמו שמוצג בתרשים הבא:
שירות שושלת היוחסין של ההעברה תומך בדיאלקטים הבאים של SQL:
- Amazon Redshift SQL
- Snowflake SQL
- Teradata SQL
- GoogleSQL (BigQuery)
מגבלות
שירות שושלת היוחסין מעבד את 5GB הראשונים של היומנים הכי ישנים ממסד הנתונים של המקור.
מיקומים נתמכים
שירות שושלת היוחסין של ההעברה זמין במיקומים נבחרים. למידע נוסף, קראו את המאמר מיקומי השירות של מתרגם SQL ושושלת היוחסין ב-BigQuery.
ההרשאות הנדרשות
כדי לקבל את ההרשאות שנדרשות לשימוש בשירות שושלת היוחסין של ההעברה, צריך לבקש מהאדמין להקצות לכם את התפקיד עריכת תהליך ההעברה (roles/bigquerymigration.editor) ב-IAM בפרויקט.
כדי לקרוא הסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
זהו תפקיד שמוגדר מראש וכולל את ההרשאות שנדרשות כדי להשתמש בשירות שושלת היוחסין של ההעברה. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי להשתמש בשירות שושלת הנתונים של ההעברה, נדרשות ההרשאות הבאות:
-
bigquerymigration.workflows.create -
bigquerymigration.workflows.get -
bigquerymigration.lineageDbs.query
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
למידע נוסף על תפקידים והרשאות של IAM ב-BigQuery, קראו את המאמר תפקידים והרשאות של IAM ב-BigQuery.
מעקב אחרי שושלת העברת נתונים
כדי לעקוב אחרי שושלת ההעברה, קודם מריצים את הכלי dwh-migration-dumper כדי ליצור קובצי יומן SQL של קלט המקור, ואז מעלים אותם ל-Cloud Storage.
אחרי שמעלים את קובצי הקלט ל-Cloud Storage, אפשר לעקוב אחרי שושלת היוחסין של ההעברה באמצעות מסוף Cloud de Confiance או BigQuery Migration API.
הפעלת הכלי dwh-migration-dumper
בוחרים באחת מהאפשרויות הבאות:
Amazon Redshift
כדי לעקוב אחרי שושלת היוחסין של ההעברה במסד נתונים של Amazon Redshift ולצפות בה:
- מריצים את הכלי
dwh-migration-dumperכדי ליצור קובץ dump של קובצי המערכת במקור. - מעלים את יומני השאילתות ל-Cloud Storage.
פתית שלג
כדי לעקוב אחרי שושלת היוחסין של ההעברה במסד נתונים של Snowflake ולראות אותה:
- מריצים את הכלי
dwh-migration-dumperכדי ליצור קובץ dump של קובצי המערכת במקור. - מעלים את יומני השאילתות ל-Cloud Storage.
Teradata
כדי לעקוב אחרי שושלת היוחסין של ההעברה במסד נתונים של Teradata ולראות אותה:
- מריצים את הכלי
dwh-migration-dumperכדי ליצור קובץ dump של קובצי המערכת במקור. - מעלים את יומני השאילתות ל-Cloud Storage.
BigQuery
כדי לעקוב אחרי שושלת היוחסין של ההעברה במסד נתונים ב-BigQuery ולצפות בה:
- מקצים לחשבון או לחשבון השירות את התפקידים הבאים:
- BigQuery Metadata Viewer (
roles/bigquery.metadataViewer) - צפייה ב-Data Catalog (
roles/datacatalog.viewer)
- BigQuery Metadata Viewer (
- מתקינים את הכלי
dwh-migration-dumper. כדי ליצור מטא-נתונים ויומני שאילתות, מריצים את הכלי
dwh-migration-dumper. המטא-נתונים ויומני השאילתות האלה כלולים בקובץ ZIP אחד או יותר.dwh-migration-dumper --connector bigquery dwh-migration-dumper --connector bigquery-logs
מעלים את קובצי ה-ZIP לקטגוריה של Cloud Storage. מידע נוסף על יצירת קטגוריות והעלאת קבצים ל-Cloud Storage זמין במאמרים יצירת קטגוריה והעלאת אובייקטים ממערכת קבצים.
מעקב אחרי שושלת הנתונים
אחרי שמעלים ל-Cloud Storage את קובצי ה-ZIP שמכילים את המטא-נתונים ואת יומני השאילתות, אפשר לעקוב אחרי שושלת היוחסין. בוחרים באחת מהאפשרויות הבאות:
המסוף
עוברים לדף שירותי ההעברה שלך.
בקטע Trace Lineage, לוחצים על Trace translation.
בקטע Lineage configuration, מזינים את הפרטים הבאים:
- בשדה השם המוצג, מציינים שם למשימת שושלת הנתונים. השם יכול להכיל אותיות, מספרים או קווים תחתונים.
- בקטע Processing Location, בוחרים את המיקום שבו רוצים להריץ את משימת שושלת היוחסין.
בשדה Edit input directory location, מציינים את הנתיב לתיקייה ב-Cloud Storage שמכילה את קובצי ה-ZIP של היומנים שהעליתם קודם. אפשר להקליד את הנתיב בפורמט
bucket_name/folder_name/או ללחוץ על עיון. בשדה Output subdirectory name אפשר גם לתת שם לספריית המשנה של קובצי הפלט.כדי להוסיף עוד קובצי קלט, לוחצים על הוספת מיקום של ספריית קלט.
לוחצים על מעקב.
משימת שושלת היוחסין פועלת עכשיו. התהליך יכול להימשך כמה שעות, בהתאם לגודל הקלט. בסיום העבודה, הכלי מספק קישור לשושלת היוחסין של ההעברה.
API
כדי לעקוב אחרי משימת שושלת, מריצים את הפקודה הבאה של curl:
  curl -d "{
    \"tasks\": {
      \"TASK_NAME\": {
        \"type\": \"Experimental_Lineage\",
        \"translation_details\": {
          \"target_base_uri\": \"BUCKET_PATH\",
          \"source_target_mapping\": {
            \"source_spec\": {
              \"base_uri\": \"BUCKET_PATH\"
            }
          },
          \"target_types\": \"LINEAGE\"
        }
      }
    }
  }
  " \
    -H "Content-Type:application/json" \
    -H "Authorization: Bearer TOKEN" -X POST https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows
מחליפים את מה שכתוב בשדות הבאים:
-
TASK_NAME: שם לזיהוי משימת שושלת הנתונים הזו. -
BUCKET_PATH: הנתיב לקטגוריה של Cloud Storage שמכילה את קובצי ה-ZIP של הקלט. -
PROJECT_ID: מזהה הפרויקט ב-Cloud de Confiance . -
LOCATION: מיקום העיבוד. הערך הזה חייב להיותeuאוus.
הקריאה הזו מחזירה הודעה שדומה לזו:
  {
    "name": "projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID",
    "tasks": {
      "task_name": { /*...*/ }
    },
    "state": "RUNNING"
  }
משימת שושלת היוחסין פועלת עכשיו. התהליך יכול להימשך כמה שעות, בהתאם לגודל הקלט. כדי לבדוק את הסטטוס של משימת שושלת היוחסין, מריצים את הפקודה הבאה של curl עם מזהה תהליך העבודה:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
בסיום העבודה, הכלי מספק קישור לתצוגת שושלת היוחסין שאותרה.
פתיחת שושלת ההעברה
אחרי שאתם מאתרים את שושלת היוחסין של ההעברה, אתם יכולים לפתוח אותה באחת מהדרכים הבאות:
המסוף
עוברים לדף שירותי ההעברה שלך.
בקטע Trace Lineage, לוחצים על View recent.
בדף Migration Lineage, לוחצים על שם המשימה כדי לבחור את משימת שושלת היוחסין המלאה.
בדף Translation details, לוחצים על Data lineage.
API
כדי לפתוח שושלת של העברה שהושלמה, מריצים את הפקודה הבאה של curl באמצעות BigQuery Migration API:
  curl \
  -H "Content-Type:application/json" \
  -H "Authorization:Bearer " -X GET https://bigquerymigration.googleapis.com/v2/projects/PROJECT_ID/locations/LOCATION/workflows/WORKFLOW_ID
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_ID: מזהה הפרויקט ב-Cloud de Confiance . -
LOCATION: מיקום העיבוד. הערך הזה חייב להיותeuאוus. -
WORKFLOW_ID: מזהה תהליך העבודה של שושלת היוחסין שאחריה עוקבים.
עוברים לקישור שמופיע בשדה taskResult.translationTaskResult.consoleUri של הודעת הפלט.
עבודה עם שושלת היוחסין של ההעברה
בקטעים הבאים מתוארות דרכים שבהן אפשר להשתמש בשושלת הנתונים של ההעברה כדי לעבוד עם מסד הנתונים ונתוני המקור.
הסבר על המונחים שקשורים לשושלת הנתונים בהעברה
המונחים הבאים משמשים בשושלת היוחסין של ההעברה:
| תנאים | תיאור |
|---|---|
| סקריפטים | סקריפטים של SQL ותוכנות אחרות שמופיעים ביומני מסד הנתונים שנטמעו במהלך יצירת שושלת היוחסין. סקריפטים מורכבים מהצהרות, שהן בדרך כלל הצהרות SQL בודדות. |
| צמתים | הקודקודים של תרשים שושלת היוחסין. הם מורכבים מטבלאות ועמודות. |
| Tables | נקראות גם יחסים, כולל טבלאות רגילות, תצוגות, קבצים מובְנים ומשאבים אחרים דמויי טבלה. |
| Columns | נקראים גם מאפיינים, כולל עמודות בטבלה, תצוגות, עמודות פסאודו, שדות דמויי עמודות בקבצים ובמשאבים אחרים, ועמודות משנה כמו שדות של מבנים. |
| קצוות | חיבורים בין צומתי שושלת שמציינים אינטראקציות שנובעות מצינור עיבוד נתונים שמריץ סקריפט שקרא או כתב את הצמתים האלה. הקצוות מסומנים בחותמות זמן, בפרדיקטים ובמטא-נתונים אחרים מהמועד שבו הקצה נוצר. צומת שסמוך לצומת אחר עם קשת נקרא חיבור ישיר. נתיב של קשתות בין שני צמתים נקרא חיבור עקיף. |
| קצוות של שושלת יוחסין | קצוות כיווניים שמציינים שצומת המקור נכלל בסעיף כמו FROM, WHERE או GROUP BY שהשפיע על הנתונים של צומת היעד. |
| משתמשים וצינורות עיבוד נתונים | תוויות מטא-נתונים שסופקו על ידי מסד הנתונים של המקור לגבי מי ומה הריצו סקריפטים. אין להם משמעות מובנית במנוע השושלת, אבל הם משמשים לקיבוץ סקריפטים לפי המקור שלהם. |
בקטעים הבאים מתוארים הדפים השונים בשושלת היוחסין של ההעברה.
בדיקת דף הנחיתה
בדף הנחיתה של שושלת היוחסין של ההעברה מוצגים המזהה של משימת שושלת היוחסין, שדה חיפוש לאיתור אובייקטים של שושלת היוחסין לפי שם, ורשימת הצעות שמדגישה כמה אובייקטים של שושלת היוחסין שעשויים לעניין אתכם. הדף כולל גם את המספר הכולל של הטבלאות, צינורות עיבוד הנתונים והמשתמשים בשושלת ההעברה.
כדי לעבור לטבלה, לתצוגה או לעמודה מסוימת, מחפשים את האובייקט בשדה החיפוש או לוחצים על אחד מהאובייקטים המוצעים בדף הנחיתה.
בדיקת דף הצומת
כדי לבדוק את הצמתים בשושלת ההעברה, לוחצים על אחת מהכרטיסיות הבאות.
הכרטיסייה "זרימת נתונים"
בכרטיסייה Data Flow מוצג ייצוג חזותי של חלק מתרשים השושלת. זהו דף ברירת המחדל כשמציגים טבלה או עמודה בפעם הראשונה בשירות שושלת היוחסין. התרשים ממחיש איך הנתונים עוברים במערכת המקור. הצמתים בתרשים מייצגים טבלאות או תצוגות, והקצוות בין הצמתים מייצגים את זרימת הנתונים מהצמתים שמשמאל לצמתים שמימין.
כל טבלה בתרשים Data Flow מציגה את השם הלא מלא שלה. כדי לראות את השם המלא של הטבלה עם הקידומת של מסד הנתונים והסכימה, מעבירים את הסמן מעל הצומת כדי להציג את ההסבר הקצר שלו. כל טבלה מציינת את הסכימה שלה, כפי שמצוין על ידי הפס האנכי בצומת. כל הסכימות בשושלת ממוינות לפי סדר אלפביתי ומוקצה להן צבע, כך שלטבלאות באותה סכימה יש פסים באותו צבע, ולטבלאות בסכימות עם שמות דומים יש פסים בצבעים דומים.
בכל צומת מוצג סמל שמציין את מאפייני הצומת:
- monitor: תצוגה, לא טבלה.
- cached: טבלה שתמיד עוברת רענון מלא (נחתכת ואז נכתבת מחדש). לוחצים על הסמל כדי לראות את הסקריפטים שצמודים לטבלה הזו.
- cached: טבלה שלא תמיד מתרעננת באופן מלא (נחתכת ואז נכתבת מחדש). לוחצים על הסמל כדי לראות את הסקריפטים לצד הטבלה הזו.
- timer: טבלה שהייתה קצרת מועד. כדי לראות כמה זמן הטבלה הייתה קיימת, מעבירים את הסמן מעל הסמל.
- snowflake: טבלה שהכתיבה האחרונה בה הייתה לפני יותר משבעה ימים, מה שמרמז על טבלה עם נתונים סטטיים או נתונים שנכתבים לעיתים רחוקות.
כדי לבדוק את האובייקטים בתרשים Data Flow:
- כדי לראות רשימה של עמודות בטבלה, לוחצים על טבלה. התצוגה הזו כוללת את השם של כל עמודה ואת סוג הנתונים שלה, כפי שנקבעו מ-dump של מטא-נתונים שסופק או כפי שהוסקו מה-SQL שמופיע ביומני השאילתות.
- כדי לראות את תרשים השושלת ברמת העמודה, לוחצים על העמודה. בתרשים שושלת היוחסין ברמת העמודה, הקצוות מייצגים את זרימת הנתונים שמשפיעה על עמודת היעד.
כדי לראות פרטים על קצה, לוחצים על קצה בתרשים. התצוגה הזו כוללת קישורים לסקריפטים של SQL שיצרו את הקצה.
קצה נוצר מצומת מקור לצומת יעד כשהצהרת SQL מפנה לצומת המקור בזמן שההצהרה מחשבת נתונים שמוכנסים לצומת היעד. בדרך כלל, זה כולל העברת נתונים מהמקור ליעד, אבל בכרטיסייה Data Flow מוצגת גם קשת כשהצומת של המקור משמש בסעיף
WHEREאוGROUP BYשמשפיע על היעד. כדי לסנן רק העברות נתונים, לוחצים על הלחצן Show non-data edges בסרגל הכלים.
הכרטיסייה "חיבורים"
בכרטיסייה Connections של צומת שושלת מוצגת רשימה של צמתים קרובים בתרשים השושלת. כברירת מחדל, הצמתים המקושרים ממוינים לפי המרחק של הנתיב הקצר ביותר מהצומת הנוכחי – צמתים שדורשים פחות קצוות כדי להגיע מהצומת הנוכחי מופיעים קודם. אתם יכולים לשנות את המיון באמצעות האפשרות מיון.
רשימת החיבורים כוללת כברירת מחדל גם צמתים במעלה הזרם (יצרן) וגם צמתים במורד הזרם (צרכן) של הצומת הנוכחי. אפשר לשנות את המסנן הזה באמצעות הפקד Type. בעמודה Distance, צמתים שנמצאים במעלה הזרם של הצומת הנוכחי מוצגים עם חץ שפונה למעלה, עם המרחק של נתיב החזרה הקצר ביותר לצומת הזה מהצומת הנוכחי. באופן דומה, צמתים שנמצאים במורד הזרם של הצומת הנוכחי מוצגים עם חץ שפונה למטה, עם המרחק של נתיב ההעברה הקצר ביותר לצומת הזה מהצומת הנוכחי. צומת יכול להיות גם במעלה הזרם וגם במורד הזרם של הצומת הנוכחי אם הוא חלק ממחזור.
כדי להוריד קובץ שמכיל את כל הצמתים שמוצגים, לוחצים על download CSV.
הכרטיסייה "משתמשים"
בכרטיסייה Users של צומת מוצגים משתמשים שהריצו סקריפטים שקראו או כתבו את הצומת, או צמתים שנמצאים במעלה הזרם או במורד הזרם שלו. כברירת מחדל, המשתמש שביצע הכי הרבה פעולות נפרדות מופיע ראשון. אפשר לשנות את המיון באמצעות האפשרות מיון.
כדי להוריד קובץ שמכיל את כל המשתמשים שמוצגים, לוחצים על הורדת קובץ CSV.
הכרטיסייה "צינורות נתונים"
בכרטיסייה Pipelines של צומת מוצגים צינורות עיבוד הנתונים שהריצו סקריפטים שקראו או כתבו את הצומת או הצמתים שנמצאים במעלה הזרם או במורד הזרם שלו. כברירת מחדל, הצינור שביצע הכי הרבה פעולות נפרדות מופיע ראשון. אפשר לשנות את המיון באמצעות האפשרות מיון.
כדי להוריד קובץ שמכיל את כל צינורות עיבוד הנתונים שמוצגים, לוחצים על download CSV.
הכרטיסייה "קוד"
בכרטיסייה Code של צומת מוצגים כל הסקריפטים של SQL שמופיעים בקובצי הקלט שקראו נתונים מהצומת הזה או כתבו נתונים לצומת הזה. האזכורים של הצומת מודגשים בטקסט ה-SQL. לוחצים על תסריט כדי להרחיב את הטקסט המלא. אתם יכולים לשנות את הגדרות הסינון כדי לסנן את רשימת הסקריפטים שמוצגים.
כדי להוריד קובץ שמכיל את כל הסקריפטים שמוצגים, לוחצים על download CSV.
בדיקת הדף של Edge
כדי לבדוק את קצוות הצמתים בתרשים השושלת, לוחצים על אחת מהכרטיסיות הבאות.
הכרטיסייה "פרטים"
בכרטיסייה Details של קצה מוצגות קטגוריות ופרדיקטים שמתארים את הפעולות שבוצעו על ידי הסקריפטים שהובילו לקצה.
הפרדיקטים מסומנים כקודים בני שלושה חלקים שמופרדים במקפים. החלק הראשון הוא r, שמציין שהמקור של הקשת הוא קשר, או a, שמציין שהמקור של הקשת הוא מאפיין. החלק השני הוא אחד מהקיצורים הבאים, שמציין את האופן שבו צומת המקור השפיע על הנתונים בצומת היעד:
-
has: הקשר של המקור מכיל את המאפיין של היעד. -
dat: המקור מעתיק או מעביר נתונים ליעד. -
res: המקור מסנן או מגביל את עוצמת הקבוצה של היעד בסעיף כמוWHERE,HAVINGאוJOIN ON. -
grp: המקור משמש בסעיףGROUP BYשמשפיע על היעד.
החלק השלישי הוא גם r או a, ומציין אם היעד של הקצה הוא קשר או מאפיין.
הקטגוריות של Edge יכולות לכלול את האפשרויות הבאות:
datפרדיקטים:-
AGGREGATE: המקור שימש בחישוב מצטבר שכתב את היעד. -
EXACT_COPY: הנתונים מהמקור הועתקו במלואם ליעד. -
FUNCTION: המקור שימש לחישוב היעד. -
IDENTITY_COPY: היעד לא חושב. היעד היה עותק מילולי של המקור ללא המרות או המרות סוג. -
PARTITION_PROMOTION: היעד מכיל נתונים מהמקור כתוצאה מקידום מחיצה של המקור ליעד. -
WEAK_COPY: הנתונים מהמקור הועתקו לפחות באופן חלקי ליעד.
-
resפרדיקטים:-
FILTER: המקור שימש בהשוואה שכתבה את היעד. -
KEY: הנתונים מהמקור שימשו כמפתח בהשוואת איחוד שכתבה את היעד.
-
grpפרדיקטים:-
GROUP: הנתונים מהמקור שימשו כמפתח בסעיףGROUP BYשמשפיע על היעד.
-
הכרטיסייה "קוד"
בכרטיסייה Code של קצה מוצגים הסקריפטים של SQL שגרמו לקצה הזה. צומתי המקור והיעד של הקצה מודגשים במקום שבו הם מוזכרים בטקסט של ה-SQL.
המאמרים הבאים
- מריצים הערכת העברה כדי לבדוק את ההיתכנות ואת היתרונות הפוטנציאליים של העברת מחסן הנתונים ל-BigQuery.
- משתמשים בשירות לתרגום SQL, כמו הכלי האינטראקטיבי לתרגום SQL, Translation API והכלי לתרגום SQL באצווה, כדי להפוך את ההמרה של שאילתות SQL ל-GoogleSQL לאוטומטית, כולל התאמה אישית של SQL באמצעות Gemini.